






























































































































A군(원래 버전)과 B군(바꾼 버전) 각각의 방문 수와 전환 수를 입력하세요. 그룹별 전환율과 차이, 상대 리프트와 함께 두 비율 z검정으로 z값과 p값을 구하고, 고른 유의수준에서 ‘유의함 / 유의하지 않음’을 판정합니다.
이 페이지에서 할 수 있는 것
- A군·B군 각각의 방문 수(클릭 수·세션 수도 가능)와 전환 수만 넣으면 그룹별 전환율, 전환율의 차이, 상대 리프트를 한꺼번에 계산합니다
- ‘B의 전환율이 높아 보이지만 우연한 변동은 아닐까?’를 두 비율 z검정으로 판정합니다(z값, 양측·단측 p값, 유의수준 5%·1%·10%에서의 판정)
- 전환율 차이의 신뢰구간(95% 등)과, 유의 기준선에 대해 z값이 얼마나 여유가 있는지(모자라는지)도 알 수 있습니다
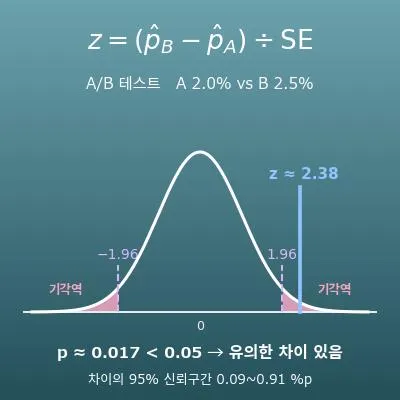
- 표준정규분포 그래프에 이번 z값의 위치와 기각역(여기에 들어가면 유의)을 칠해서 보여 줍니다
- 공식의 쉬운 해설과 Excel·Google 스프레드시트·Python용으로 복사해 쓰는 수식도 이 페이지에 정리되어 있습니다
이 계산은 어디에 쓰일까요?
‘버튼 색을 바꾼 B안으로 전환율이 2.0%에서 2.5%로 올랐다’. 이 차이가 우연이 아닌지 확인하는 것이 A/B 테스트의 유의성 판정으로, 온라인 마케팅 현장에서 날마다 합니다. 각각 10,000회 방문이라면 양측 p값은 약 0.017로 ‘5% 수준에서 유의’하지만, 같은 정도의 전환율이라도 각각 500회 방문(전환 10건 대 12~13건)이라면 p값은 약 0.5~0.7로 ‘우연일 수 있다’고밖에 말할 수 없습니다.
‘B가 좋아 보인다’는 이유로 바꿨다가 다음 달에 원래대로 돌아가는 일이 자주 있습니다. 방문 수를 먼저 정하고 유의수준으로 판정하면 이를 막을 수 있습니다(방문자를 무작위로 나눈다는 전제).
같은 이메일을 제목만 두 가지로 바꿔 절반씩 보내고 오픈율 48%와 52%를 비교합니다. 이것도 두 비율의 차이를 검정하는 문제입니다. 각각 5,000통이라면 4%p 차이의 z값은 약 4로, 우연으로는 설명하기 어려운 차이입니다.
오픈율처럼 큰 비율은 전환율처럼 작은 비율보다 같은 발송 수로도 판정하기 쉽습니다(표준오차에 비해 차이가 크게 나오기 쉽기 때문). 이 공식을 알면 비교하는 지표에 따라 필요한 발송 수가 어떻게 달라지는지 감을 잡을 수 있습니다.
‘기존 치료법은 60%, 새 치료법은 70%가 개선’처럼 두 그룹의 개선율을 비교하는 것은 임상 연구의 기본적인 검정입니다(실제 연구는 무작위 배정이나 눈가림 같은 엄격한 설계로 진행합니다).
약의 승인이나 진료 지침의 근거가 되는 논문에는 반드시 p값과 신뢰구간이 실립니다. 이 공식을 이해하면 ‘유의’라는 한마디에 휘둘리지 않고 ‘차이가 얼마나 큰가’, ‘환자 수는 충분했는가’까지 읽을 수 있습니다.
새 공정 B로 불량률이 1.5%에서 1.0%로 내려간 것 같을 때, 각각 2,000개라면 ‘우연의 범위’, 각각 20,000개라면 ‘유의한 개선’으로 생산량에 따라 판정이 달라집니다. 이 계산은 설비나 공정 변경의 판단이 적은 표본의 우연에 휘둘리지 않게 해 줍니다.
불량률처럼 작은 비율은 기대 불량 수(개수 × 불량률)가 5 미만이 되면 정규근사가 거칠어지므로, 이항분포를 직접 쓰는 정확검정(피셔의 정확검정 등)을 대신 고릅니다.
‘새 교재를 쓴 반의 합격률 75%, 기존 교재의 반 65%’ 같은 비교에도 같은 검정을 쓸 수 있습니다. 다만 반 단위로 교재를 정하면 학생을 무작위로 나눈 것이 아니므로, 교사나 학생의 차이가 결과에 섞여 들어갑니다.
교육·사회과학 연구에서는 이 공식으로 유의성을 확인하는 것과 함께 ‘무작위로 나누었는가’, ‘결과를 보고 나서 비교 방법을 바꾸지 않았는가’ 같은 설계가 중요합니다. 공식의 전제를 알아 두는 것이 숫자에 속지 않는 힘이 됩니다.
공식
용어·기호 해설
기호
| \(n_A,\ n_B\) | 엔 에이, 엔 비 | A군·B군의 방문 수(클릭 수·세션 수)입니다. \(n\)은 number(수)의 머리글자로, 통계에서 표본 크기를 나타낼 때 관례적으로 쓰는 문자입니다. |
| \(x_A,\ x_B\) | 엑스 에이, 엑스 비 | A군·B군의 전환 수입니다. ‘성공한 횟수’를 \(x\)로 나타내는 것은 이항분포의 관례입니다. |
| \(\hat{p}_A,\ \hat{p}_B\) | 피 햇 에이, 피 햇 비 | A군·B군의 전환율(표본에서 구한 비율)입니다. \(p\)는 proportion(비율) 또는 probability(확률)의 머리글자이고, 위의 ‘\(\hat{}\)’(햇)은 실제 값 \(p\)를 표본으로 추정한 값이라는 표시입니다. |
| \(\hat{p}\) | 피 햇 | 합동 전환율입니다. ‘차이가 없다’고 가정하고 두 그룹의 데이터를 합쳐 구한 하나의 전환율 추정값으로, \(\hat{p} = (x_A + x_B) \div (n_A + n_B)\)입니다. |
| \(d\) | 디 | 전환율 차이(\(\hat{p}_B - \hat{p}_A\))입니다. \(d\)는 difference(차이)의 머리글자입니다. 이 페이지에서는 100배 해서 %p로 표시합니다. |
| \(L\) | 엘 | 상대 리프트(%)입니다. \(L\)은 lift(들어 올리다)의 머리글자로, A의 전환율에 비해 B의 전환율이 몇 % 늘었는지를 나타냅니다. |
| \(\mathrm{SE}\) | 에스이 | 표준오차(Standard Error)입니다. 표본에서 구한 값(여기서는 전환율 차이)이 우연히 얼마나 흔들리는지의 기준으로, 그 값의 표준편차입니다. 검정에서는 합동 전환율로 구하고, 신뢰구간에서는 그룹별 전환율로 구한 \(\mathrm{SE}_d\)를 씁니다. |
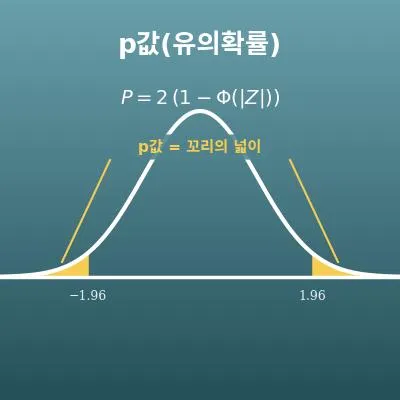
| \(z\) | 제트 | z값(검정통계량)입니다. 차이를 표준오차로 나눈 값으로, 차이가 우연한 흔들림의 몇 배인지를 나타냅니다. 차이가 없을 때는 표준정규분포(평균 0, 표준편차 1)를 따르므로, 그 크기에서 p값을 구합니다. |
| \(|z|\) | 제트의 절댓값 | z값에서 부호를 뗀 크기입니다. 양측검정에서는 ‘어느 방향의 차이인가’를 묻지 않으므로 절댓값을 씁니다. |
| \(\Phi\) | 파이(대문자) | 표준정규분포의 누적분포함수입니다. \(\Phi(z)\)는 표준정규분포를 따르는 값이 \(z\) 이하가 될 확률, 즉 종 모양 곡선 아래 \(z\)보다 왼쪽의 넓이입니다. 그리스 문자 대문자 파이로, 누적분포함수를 나타낼 때 관례적으로 씁니다. |
| \(p_2,\ p_1\) | 피 투, 피 원 | 양측 p값과 단측 p값입니다. 아래 첨자 2·1은 ‘꼬리가 2개(양측)’, ‘꼬리가 1개(단측)’를 나타내는 이 페이지만의 구분이며, 통계 책에서는 그냥 \(p\)라고 씁니다. |
| \(\alpha\) | 알파 | 유의수준입니다. ‘p값이 이보다 작으면 귀무가설을 버린다’고 미리 정해 두는 경계로, 5%(0.05)를 많이 씁니다. 그리스 문자 알파로, 제1종 오류(차이가 없는데 ‘있다’고 판정하는 잘못)의 확률에 해당합니다. |
| \(z_{\alpha/2}\) | 제트 알파 2분의 1 | 양쪽 꼬리에 합쳐서 \(\alpha\)의 확률을 남길 때의 경계 z값(임계값)입니다. 95% 신뢰구간(\(\alpha = 0.05\))이라면 1.96, 99%라면 2.576입니다. 단측에서는 \(z_\alpha\)(5%라면 1.645)가 됩니다. |
| \(d_L,\ d_U\) | 디 엘, 디 유 | 차이의 신뢰구간의 하한(Lower)과 상한(Upper)입니다. 실제 차이가 이 범위에 있을 것 같다는 구간의 양 끝입니다. |
용어
| A/B 테스트 | 원래 버전(A)과 바꾼 버전(B)을 같은 기간에 방문자에게 무작위로 나누어 보여 주고 성과를 비교하는 실험입니다. 웹사이트, 광고, 이메일 등에서 널리 씁니다. 무작위로 나누면 버전 이외의 조건(요일, 유입 경로 등)이 두 그룹에서 같아집니다. |
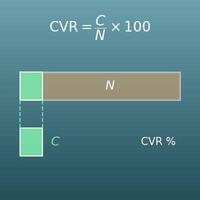
| 전환율 (CVR) | 방문(클릭) 가운데 구매, 신청 등의 성과(전환)로 이어진 비율입니다. 전환율 하나만 계산하거나 역산하려면 전환율 계산기 페이지를 보세요. |
| 귀무가설 | ‘A와 B의 전환율에 실제로는 차이가 없다(\(p_A = p_B\))’는, 검정에서 부정하고 싶은 쪽의 가설입니다. ‘무로 돌리고 싶은 가설’이라는 뜻의 이름입니다. 검정에서는 이것이 옳다면 관측된 차이가 얼마나 일어나기 어려운지를 조사합니다. |
| 대립가설 | 귀무가설과 대립하는, 보여 주고 싶은 쪽의 가설입니다. 양측검정에서는 ‘A와 B에 차이가 있다(\(p_A \neq p_B\))’, 단측검정에서는 ‘B가 A보다 높다(\(p_B > p_A\))’입니다. |
| 유의수준 | ‘p값이 이보다 작으면 귀무가설을 버린다’고 테스트 전에 정해 두는 경계입니다. 5%가 일반적이며, 엄격하게 하려면 1%를 씁니다. ‘5% 수준에서 유의’는 ‘실제로 차이가 없는데 이만큼의 차이가 나올 확률이 5% 미만’이라는 뜻입니다. |
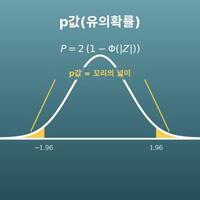
| p값 (유의확률) | 귀무가설(차이가 없다)이 옳다고 가정했을 때 이번 이상의 차이가 우연히 나올 확률입니다. 작을수록 우연으로 설명하기 어렵습니다. ‘B가 더 좋을 확률’이 아니라는 점에 주의하세요(흔한 오해입니다). |
| 유의미한 차이 (유의차) | p값이 유의수준보다 작아 ‘우연한 변동으로는 설명하기 어려운 차이’로 판단된 것입니다. 차이가 크다거나 효과가 확실하다는 것을 보장하지는 않으며, 방문 수가 매우 많으면 아주 작은 차이도 유의해집니다. |
| 검정통계량 | 검정을 위해 데이터로 계산하는 하나의 수치입니다. 이 페이지에서는 z값이 그것이며 ‘차이 ÷ 표준오차’로 구합니다. 이 값이 얼마나 극단적인지로 p값이 정해집니다. |
| 두 비율 z검정 | 두 그룹의 비율(전환율 등)에 차이가 있는지를 정규분포를 이용해 조사하는 검정입니다. A/B 테스트의 유의성을 판정하는 가장 기본적인 방법입니다. 2×2 카이제곱 검정으로도 거의 같은 일을 할 수 있으며, 양측 p값이 일치합니다. |
| 표준오차 | 표본에서 구한 통계량(여기서는 전환율 차이)이 표본을 뽑는 방법에 따라 우연히 얼마나 흔들리는지를 나타내는 표준편차입니다. 방문 수의 제곱근에 반비례해 작아지므로, 표준오차를 절반으로 줄이려면 방문 수가 4배 필요합니다. |
| 합동 (pooled) | ‘차이가 없다’고 가정하고 두 그룹의 데이터를 합쳐 하나의 전환율을 추정하는 것입니다. 영어 pool(하나로 모으다)에서 온 말로, 검정의 표준오차는 이 합동 값으로 구합니다. |
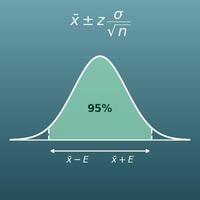
| 신뢰구간 | ‘실제 차이는 이 범위에 있을 것 같다’는 구간입니다. 95% 신뢰구간은 같은 실험을 여러 번 했을 때 95%의 비율로 실제 차이를 포함하도록 만드는 구간입니다. 구간이 0을 포함하지 않는 것은 5% 수준의 양측검정에서 유의한 것과 거의 항상 일치합니다. |
| 양측검정 | ‘차이가 있는가(어느 쪽이 높은지는 묻지 않음)’를 조사하는 검정입니다. 어느 쪽으로 갈지 모르는 보통의 A/B 테스트에서는 이것을 씁니다. |
| 단측검정 | ‘B가 A보다 높은가’처럼 방향을 정해 조사하는 검정입니다. p값이 양측의 절반이라 유의해지기 쉬우므로, 테스트 전에 방향을 정해 둔 경우에만 씁니다. |
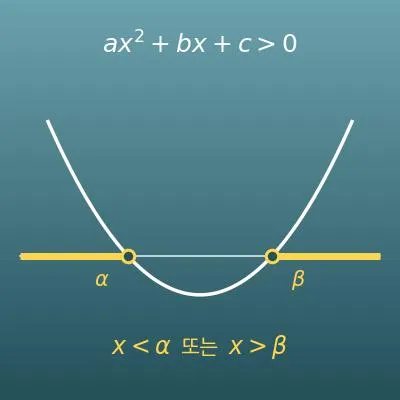
| 기각역 | ‘z값이 여기에 들어가면 귀무가설을 버린다(기각한다)’는 표준정규분포의 꼬리 영역입니다. 양측 5%라면 \(z < -1.96\)과 \(z > 1.96\)의 양쪽 꼬리로, 넓이의 합이 0.05입니다. 이 페이지 그래프에서 칠해진 부분입니다. |
| 임계값 | 기각역의 경계가 되는 z값입니다. 양측 5%라면 1.96, 양측 1%라면 2.576, 단측 5%라면 1.645입니다. 결과의 ‘z값의 여유’는 이번 z값이 임계값보다 얼마나 큰지(작은지)를 나타냅니다. |
| 정규근사 | 전환 수의 변동은 원래 이항분포를 따르지만, 방문 수가 많으면 정규분포(종 모양 곡선)로 잘 근사할 수 있습니다. z검정은 이 근사를 쓰므로, 기준으로 그룹마다 기대 전환 수(\(n\hat{p}\))와 기대 비전환 수(\(n(1-\hat{p})\))가 5 이상(가능하면 10 이상)이어야 합니다. |
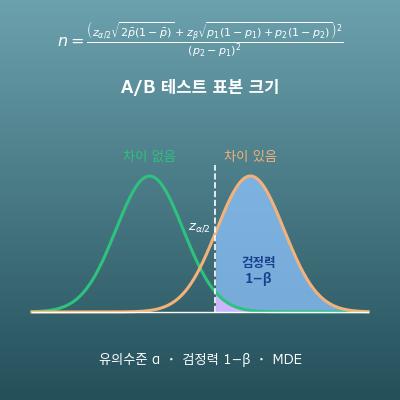
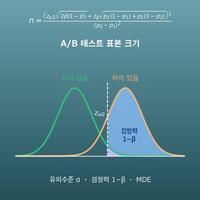
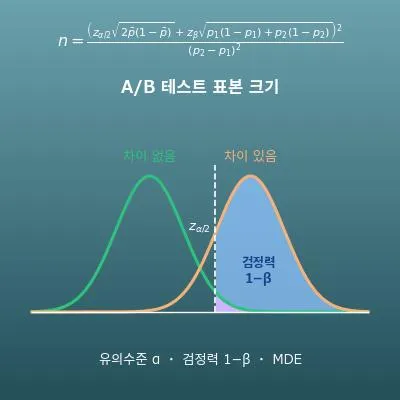
| 검정력 | 실제로 차이가 있을 때 검정이 그것을 ‘유의’로 검출할 수 있는 확률입니다. 방문 수가 적으면 검정력이 낮아, 실제로 효과가 있어도 ‘유의하지 않음’이 되는 일이 많습니다. ‘유의미한 차이 없음’은 ‘차이가 없다’는 증명이 아닙니다. |
| 제1종 오류 | 실제로는 차이가 없는데 ‘유의미한 차이가 있다’고 판정하는 잘못(거짓 양성)입니다. 유의수준 \(\alpha\)는 이 잘못을 허용하는 확률로, 5%라면 ‘실제로 차이가 없는 테스트를 100번 하면 5번 정도는 우연히 유의해진다’는 뜻입니다. |
| 다중비교 | 동시에 많은 버전이나 지표를 검정하는 것입니다. 유의수준 5%라도 지표 20개를 검정하면 그중 하나는 우연히 ‘유의’해질 가능성이 높습니다. 지표를 미리 좁히거나 유의수준을 엄격하게 하는 방법(본페로니 보정 등)이 필요합니다. |
| 조기 중단 (피킹) | 결과를 도중에 여러 번 보고 유의해진 시점에 테스트를 끝내는 것입니다. 테스트 중에 p값은 오르내리므로, ‘처음 5% 아래로 내려간 순간 멈춘다’를 되풀이하면 실제로 차이가 없어도 유의해질 확률이 5%를 크게 넘습니다. 필요한 방문 수를 먼저 정하고 거기에 이를 때까지 기다리는 것이 기본입니다. |
| 상대 리프트 (상승률) | A의 전환율에 비해 B의 전환율이 몇 % 늘었는지입니다. 차이 \(d\)를 A의 전환율로 나누어 100배 합니다. ‘0.5%p 상승’보다 ‘25% 상승’ 쪽이 늘어나는 전환 수나 매출의 어림으로 바꾸기 쉽습니다. |
| 퍼센트포인트 (%p) | %끼리 뺀 결과를 나타내는 단위로, %p라고 씁니다. ‘2.5% − 2% = 0.5%p’처럼 쓰며, ‘0.5%’라고 쓰면 ‘2%의 0.5%’와 헷갈리는 것을 피합니다. |
먼저 알아 두면 좋은 내용
이 페이지의 계산을 버튼만 누르는 것이 아니라 ‘뜻을 알고’ 쓸 수 있도록, 먼저 알아 두면 좋은 내용을 정리했습니다.
막히면 이 내용으로 돌아가 복습하는 것이 지름길입니다.
| 비와 비율·백분율(초등학교 6학년, 11~12세) |
|
| 역수와 제곱근(중학교 1~3학년, 12~15세) |
|
| 정규분포와 표준편차(고등학교 확률과 통계, 16~18세) |
|
| 가설검정의 사고방식(대학 기초 통계) |
|
| 이항분포와 정규근사(고등학교 확률과 통계, 16~18세) |
|
Excel로 계산하는 방법
| A군 방문 수 n_A | 10000 |
| A군 전환 수 x_A | 200 |
| B군 방문 수 n_B | 10000 |
| B군 전환 수 x_B | 250 |
| A군 전환율 p̂_A | =B2/B1 |
| B군 전환율 p̂_B | =B4/B3 |
| A군 전환율 p̂_A | 0.02 |
| B군 전환율 p̂_B | 0.025 |
| 전환율 차이 d | =B2-B1 |
| 상대 리프트 L(%) | =B3/B1*100 |
| A군 전환 수 x_A | 200 |
| B군 전환 수 x_B | 250 |
| A군 방문 수 n_A | 10000 |
| B군 방문 수 n_B | 10000 |
| 합동 전환율 p̂ | =(B1+B2)/(B3+B4) |
| 합동 전환율 p̂ | 0.0225 |
| A군 방문 수 n_A | 10000 |
| B군 방문 수 n_B | 10000 |
| 전환율 차이 d | 0.005 |
| 표준오차 SE | =SQRT(B1*(1-B1)*(1/B2+1/B3)) |
| z값 z | =B4/B5 |
| z값 z | 2.384 |
| 양측 p값 p₂ | =2*(1-NORM.S.DIST(ABS(B1),TRUE)) |
| 단측 p값 p₁ | =1-NORM.S.DIST(B1,TRUE) |
| A군 전환율 p̂_A | 0.02 |
| A군 방문 수 n_A | 10000 |
| B군 전환율 p̂_B | 0.025 |
| B군 방문 수 n_B | 10000 |
| 전환율 차이 d | 0.005 |
| 신뢰수준(0.95 = 95%) | 0.95 |
| z_(α/2) | =NORM.S.INV(1-(1-B6)/2) |
| 표준오차 SE_d | =SQRT(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| 하한 d_L | =B5-B7*B8 |
| 상한 d_U | =B5+B7*B8 |
첫 번째 표에서는 B5에 A의 전환율 0.02, B6에 B의 0.025가 표시됩니다. 두 번째 표에서는 차이 0.005(0.5%p)와 리프트 25, 세 번째 표에서는 합동 전환율 0.0225, 네 번째 표에서는 표준오차 약 0.002097과 z값 약 2.384가 나옵니다.
다섯 번째 표의 NORM.S.DIST(z, TRUE)는 표준정규분포의 누적확률 Φ(z)를 돌려주며, 양측 p값은 약 0.0171, 단측 p값은 약 0.0086입니다. 여섯 번째 표의 NORM.S.INV는 누적확률에서 z값을 구하는 함수로(신뢰수준 95%라면 1.96), 하한 약 0.0009, 상한 약 0.0091(0.09~0.91%p)이 나옵니다.
Google 스프레드시트로 계산하는 방법
| A군 방문 수 n_A | 10000 |
| A군 전환 수 x_A | 200 |
| B군 방문 수 n_B | 10000 |
| B군 전환 수 x_B | 250 |
| A군 전환율 p̂_A | =B2/B1 |
| B군 전환율 p̂_B | =B4/B3 |
| A군 전환율 p̂_A | 0.02 |
| B군 전환율 p̂_B | 0.025 |
| 전환율 차이 d | =B2-B1 |
| 상대 리프트 L(%) | =B3/B1*100 |
| A군 전환 수 x_A | 200 |
| B군 전환 수 x_B | 250 |
| A군 방문 수 n_A | 10000 |
| B군 방문 수 n_B | 10000 |
| 합동 전환율 p̂ | =(B1+B2)/(B3+B4) |
| 합동 전환율 p̂ | 0.0225 |
| A군 방문 수 n_A | 10000 |
| B군 방문 수 n_B | 10000 |
| 전환율 차이 d | 0.005 |
| 표준오차 SE | =SQRT(B1*(1-B1)*(1/B2+1/B3)) |
| z값 z | =B4/B5 |
| z값 z | 2.384 |
| 양측 p값 p₂ | =2*(1-NORMSDIST(ABS(B1))) |
| 단측 p값 p₁ | =1-NORMSDIST(B1) |
| A군 전환율 p̂_A | 0.02 |
| A군 방문 수 n_A | 10000 |
| B군 전환율 p̂_B | 0.025 |
| B군 방문 수 n_B | 10000 |
| 전환율 차이 d | 0.005 |
| 신뢰수준(0.95 = 95%) | 0.95 |
| z_(α/2) | =NORMSINV(1-(1-B6)/2) |
| 표준오차 SE_d | =SQRT(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| 하한 d_L | =B5-B7*B8 |
| 상한 d_U | =B5+B7*B8 |
Python으로 계산하는 방법
import math

visits_a, conversions_a = 10000, 200   # A군 방문 수와 전환 수
visits_b, conversions_b = 10000, 250   # B군 방문 수와 전환 수
alpha = 0.05                           # 유의수준(5%)

def normal_cdf(z):
    # 표준정규분포의 누적분포함수 Φ(z)
    return 0.5 * math.erfc(-z / math.sqrt(2))

def normal_ppf(p):
    # Φ의 역함수(이분법. z_(α/2)를 구하는 데 사용)
    low, high = -10.0, 10.0
    for _ in range(100):
        mid = (low + high) / 2
        if normal_cdf(mid) < p:
            low = mid
        else:
            high = mid
    return (low + high) / 2

cvr_a = conversions_a / visits_a
cvr_b = conversions_b / visits_b
diff = cvr_b - cvr_a
lift = diff / cvr_a * 100
pooled = (conversions_a + conversions_b) / (visits_a + visits_b)
se_pooled = math.sqrt(pooled * (1 - pooled) * (1 / visits_a + 1 / visits_b))
z = diff / se_pooled
p_two_sided = 2 * (1 - normal_cdf(abs(z)))
p_one_sided = 1 - normal_cdf(z)

se_diff = math.sqrt(cvr_a * (1 - cvr_a) / visits_a + cvr_b * (1 - cvr_b) / visits_b)
z_half = normal_ppf(1 - alpha / 2)
ci_low, ci_high = diff - z_half * se_diff, diff + z_half * se_diff

print(f"A군 전환율: {cvr_a * 100:.2f}%  B군 전환율: {cvr_b * 100:.2f}%")
print(f"차이: {diff * 100:.2f}%p  상대 리프트: {lift:.1f}%")
print(f"z값: {z:.3f}  양측 p값: {p_two_sided:.4f}  단측 p값: {p_one_sided:.4f}")
print("판정(양측):", "유의미한 차이 있음" if p_two_sided < alpha else "유의미한 차이 없음")
print(f"차이의 {(1 - alpha) * 100:.0f}% 신뢰구간: {ci_low * 100:.2f}~{ci_high * 100:.2f}%p")
LaTeX 등 수식 언어로 쓰는 법(복사 가능)
p̂_A = x_A ÷ n_A
\hat{p}_A = \dfrac{x_A}{n_A}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
    <mo>=</mo>
    <mfrac>
      <msub><mi>x</mi><mi>A</mi></msub>
      <msub><mi>n</mi><mi>A</mi></msub>
    </mfrac>
  </mrow>
</math>
hat(p)_A = x_A / n_A
xA/nA
pA := xA/nA;
pA = xA/nA;
p̂_A = x_A/n_A
d = p̂_B − p̂_A, L = d ÷ p̂_A × 100
d = \hat{p}_B - \hat{p}_A, \quad L = \dfrac{d}{\hat{p}_A} \times 100
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>=</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub>
<mo>−</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
<mo>,</mo><mspace width="1em"/>
<mi>L</mi><mo>=</mo>
<mfrac><mi>d</mi><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mfrac>
<mo>×</mo><mn>100</mn>
</mrow>
</math>
d = hat(p)_B - hat(p)_A, L = d / hat(p)_A xx 100
d = pB - pA; d/pA*100
d := pB - pA; L := d/pA*100;
d = pB - pA; L = d/pA*100;
d = p̂_B − p̂_A, L = d/p̂_A × 100
p̂ = (x_A + x_B) ÷ (n_A + n_B)
\hat{p} = \dfrac{x_A + x_B}{n_A + n_B}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mover accent="true"><mi>p</mi><mo>^</mo></mover>
    <mo>=</mo>
    <mfrac>
      <mrow><msub><mi>x</mi><mi>A</mi></msub><mo>+</mo><msub><mi>x</mi><mi>B</mi></msub></mrow>
      <mrow><msub><mi>n</mi><mi>A</mi></msub><mo>+</mo><msub><mi>n</mi><mi>B</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
hat(p) = (x_A + x_B) / (n_A + n_B)
(xA + xB)/(nA + nB)
pPool := (xA + xB)/(nA + nB);
pPool = (xA + xB)/(nA + nB);
p̂ = (x_A + x_B)/(n_A + n_B)
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d ÷ SE
\mathrm{SE} = \sqrt{\hat{p}(1-\hat{p})\left(\dfrac{1}{n_A}+\dfrac{1}{n_B}\right)}, \quad z = \dfrac{d}{\mathrm{SE}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi><mo>=</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mrow>
<msqrt>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
<mo>(</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>A</mi></msub></mfrac>
<mo>+</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>B</mi></msub></mfrac>
<mo>)</mo>
</msqrt>
</mfrac>
</mrow>
</math>
SE = sqrt(hat(p)(1 - hat(p))(1/n_A + 1/n_B)), z = d / SE
se = Sqrt[pPool*(1 - pPool)*(1/nA + 1/nB)]; z = d/se
SE := sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z := d/SE;
SE = sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z = d/SE;
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d/SE
p₂ = 2(1 − Φ(|z|)), p₁ = 1 − Φ(z)
p_2 = 2\left(1 - \Phi(|z|)\right), \quad p_1 = 1 - \Phi(z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>p</mi><mn>2</mn></msub><mo>=</mo>
<mn>2</mn><mo>(</mo><mn>1</mn><mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>z</mi><mo>|</mo><mo>)</mo><mo>)</mo>
<mo>,</mo><mspace width="1em"/>
<msub><mi>p</mi><mn>1</mn></msub><mo>=</mo>
<mn>1</mn><mo>−</mo><mi>Φ</mi><mo>(</mo><mi>z</mi><mo>)</mo>
</mrow>
</math>
p_2 = 2(1 - Phi(|z|)), p_1 = 1 - Phi(z)
p2 = 2*(1 - CDF[NormalDistribution[0, 1], Abs[z]]); p1 = 1 - CDF[NormalDistribution[0, 1], z]
p2 := 2*(1 - Statistics:-CDF(Normal(0, 1), abs(z))); p1 := 1 - Statistics:-CDF(Normal(0, 1), z);
p2 = 2*(1 - normcdf(abs(z))); p1 = 1 - normcdf(z);
p_2 = 2(1 − Φ(|z|)), p_1 = 1 − Φ(z)
d ± z_(α/2) × √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
d \pm z_{\alpha/2}\sqrt{\dfrac{\hat{p}_A(1-\hat{p}_A)}{n_A}+\dfrac{\hat{p}_B(1-\hat{p}_B)}{n_B}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>±</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>A</mi></msub>
</mfrac>
<mo>+</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>B</mi></msub>
</mfrac>
</msqrt>
</mrow>
</math>
d +- z_(alpha/2) sqrt((hat(p)_A(1 - hat(p)_A))/n_A + (hat(p)_B(1 - hat(p)_B))/n_B)
seD = Sqrt[pA*(1 - pA)/nA + pB*(1 - pB)/nB]; {d - zHalf*seD, d + zHalf*seD}
seD := sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); [d - zHalf*seD, d + zHalf*seD];
seD = sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); ci = [d - zHalf*seD, d + zHalf*seD];
d ± z_(α/2) √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
ChatGPT 에게 물어서 계산하는 방법
당신은 통계(가설검정) 계산 도우미입니다. 다음 계산을 Python 코드를 실제로 실행해서 하고, 실행 결과의 숫자만을 근거로 답해 주세요(암산이나 추측으로 답하지 마세요).

A/B 테스트 결과는 다음과 같습니다.
- A군: 방문 10000회, 전환 200건
- B군: 방문 10000회, 전환 250건
다음을 각각 구해 주세요.
1. 그룹별 전환율(%), 전환율 차이(%p), 상대 리프트(%)
2. 합동 전환율과 합동 표준오차 SE = √(p̂(1−p̂)(1/n_A + 1/n_B))
3. z값 = 차이 ÷ SE, 양측 p값과 단측 p값(표준정규분포)
4. 유의수준 5%(양측)에서 유의미한 차이가 있는지 판정
5. 차이의 95% 신뢰구간(그룹별 전환율로 구한 표준오차 √(p̂_A(1−p̂_A)/n_A + p̂_B(1−p̂_B)/n_B) 사용)

Python에서는 math.erfc(또는 scipy.stats.norm)를 사용하고, 사용한 공식과 실행 결과의 숫자를 함께 보여 주세요.
사용법
-
1숫자 입력계산하고 싶은 숫자를 입력란에 입력합니다
-
2계산‘계산’ 버튼을 누릅니다
-
3결과 확인계산 결과가 바로 표시됩니다. 계산의 원리와 공식 해설도 같은 페이지에서 확인할 수 있습니다
DataChef의 특징

전문 지식 없이도 직관적이고 간단하게 사용

개인정보를 등록하지 않고도 이용할 수 있습니다

"다운로드"를 누르면 파일이 자동으로 삭제됩니다


출처 표기 불필요

상업적 이용 허가 연락도 필요 없습니다
관련 기능
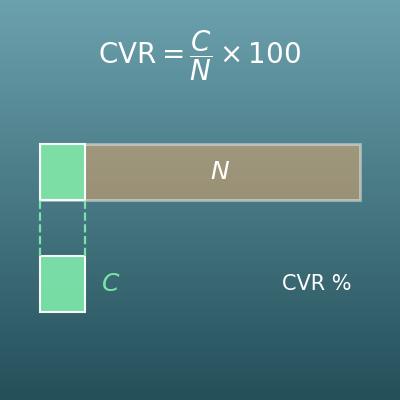
전환율(CVR) 계산기(필요 유입수·예상 전환수 역산)
유입 수, 전환 수, 전환율 중 두 가지로 나머지를 계산합니다. 한 그룹의 전환율만 구하려면 여기서 하세요
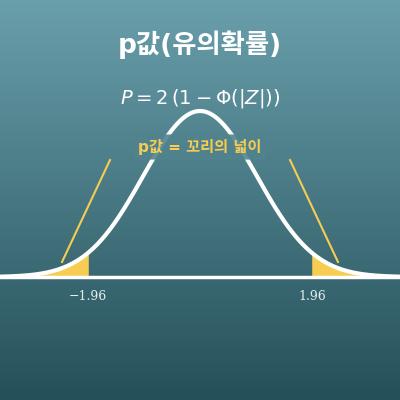
p값 계산기(유의확률·z값으로 p값 구하기)
가지고 있는 z값을 왼쪽·오른쪽·양측 p값으로 바꾸는 범용 계산기입니다. 이 페이지는 z값의 앞 단계(방문 수·전환 수)부터 계산합니다
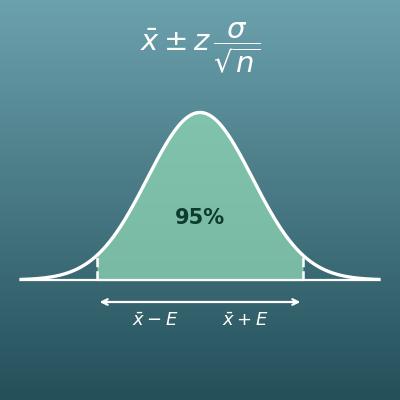
신뢰구간 계산기(모평균의 구간추정)
평균값(시험 점수, 매출 등)의 신뢰구간을 구합니다. 이 페이지의 ‘차이의 신뢰구간’을 평균값에 적용한 것입니다
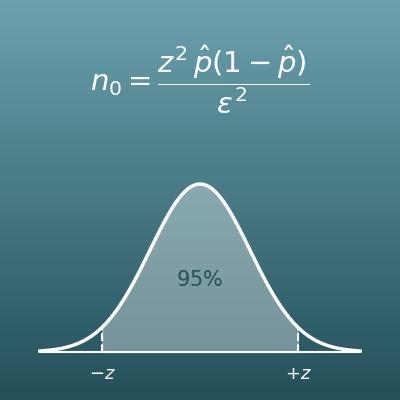
표본 크기 계산기(필요한 표본 수·허용오차)
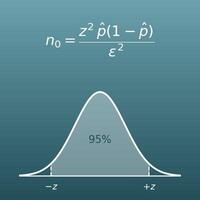
설문 조사에서 비율 하나를 허용오차 안에서 알아내는 데 필요한 인원을 계산합니다. 조사 설계는 여기서 하세요