



























































































Saisissez les visites et les conversions du groupe A (la version d’origine) et du groupe B (la version modifiée). En plus du taux de conversion de chaque groupe, de l’écart et de l’uplift relatif, le calcul réalise un test z de comparaison de deux proportions pour obtenir le score z et la p-valeur, et conclut « significatif / non significatif » au seuil de signification choisi.
Table des matières
-
Ce que vous pouvez faire sur cette page
-
À quoi sert ce calcul ?
-
Mode d'emploi
-
Formule
-
Taux de conversion de chaque groupe
-
Écart de taux de conversion et uplift relatif
-
Taux de conversion commun (un seul taux pour les deux groupes réunis)
-
Erreur type et score z (test z de comparaison de deux proportions)
-
P-valeurs (bilatérale et unilatérale)
-
Intervalle de confiance de l’écart de taux de conversion
-
-
Symboles et termes
-
Ce qu’il est utile de savoir avant de commencer
-
Calculer avec Excel
-
Calculer avec Google Sheets
-
Calculer avec Python
-
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
-
Faire faire le calcul par ChatGPT
-
Les atouts de DataChef
-
Fonctions connexes
-
Liste des calculatrices NumberChef
Ce que vous pouvez faire sur cette page
- Saisissez les visites (les clics ou les sessions conviennent aussi) et les conversions des groupes A et B, et obtenez d’un coup le taux de conversion de chaque groupe, l’écart entre les deux et l’uplift relatif
- « B semble meilleur, mais n’est-ce pas une variation due au hasard ? » Un test z de comparaison de deux proportions répond à cette question (score z, p-valeurs bilatérale et unilatérale, et conclusion au seuil de signification de 5 %, 1 % ou 10 %)
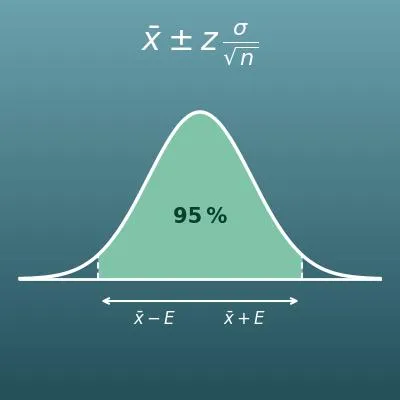
- Il donne aussi l’intervalle de confiance de l’écart (à 95 % par exemple) et la marge du score z par rapport au seuil de significativité (au-dessus ou en dessous)
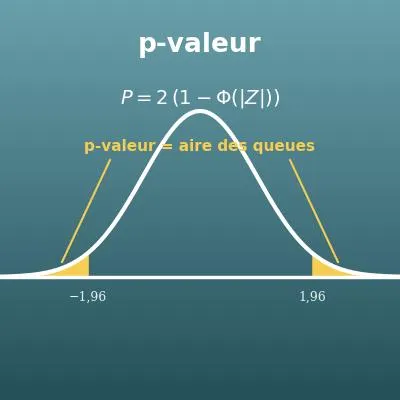
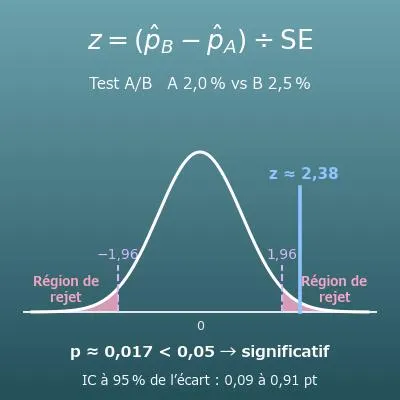
- Un graphique de la loi normale centrée réduite montre où tombe votre score z et colore la région de rejet (significatif si le score z y tombe)
- Une explication simple des formules et des formules à copier-coller pour Excel, Google Sheets et Python sont aussi sur cette page
À quoi sert ce calcul ?
« La version B, avec un bouton d’une autre couleur, a fait passer le taux de conversion de 2,0 % à 2,5 %. » Vérifier que cet écart n’est pas un simple hasard, c’est la significativité d’un test A/B, pratiquée tous les jours en marketing en ligne. Avec 10 000 visites de chaque côté, la p-valeur bilatérale est d’environ 0,017 : « significatif à 5 % ». Mais avec des taux de conversion semblables sur 500 visites de chaque côté (10 conversions contre 12 ou 13), la p-valeur est d’environ 0,5 à 0,7, et on peut seulement dire « c’est peut-être le hasard ».
Si vous passez à B parce que « B a l’air meilleur », il arrive souvent que les résultats reviennent en arrière le mois suivant. Fixer d’abord le nombre de visites et juger selon un seuil de signification évite cela (à condition que les visites soient réparties au hasard).
Envoyez le même e-mail avec deux objets différents à chaque moitié de la liste et comparez des taux d’ouverture de 48 % et de 52 %. C’est aussi un test d’écart entre deux proportions. Avec 5 000 e-mails de chaque côté, l’écart de 4 points a un score z d’environ 4 : un écart difficile à expliquer par le hasard.
Les grandes proportions comme les taux d’ouverture sont plus faciles à juger, avec le même nombre d’e-mails, que les petites comme les taux de conversion (l’écart a tendance à être grand par rapport à l’erreur type). Cette formule vous donne une idée de la façon dont l’indicateur comparé change le nombre d’envois nécessaires.
Comparer les taux d’amélioration de deux groupes, comme « 60 % d’amélioration avec le traitement standard et 70 % avec le nouveau », est un test de base des essais cliniques (les vraies études utilisent des protocoles stricts comme la randomisation et le double aveugle).
Les publications à l’appui des autorisations de médicaments et des recommandations de traitement indiquent toujours des p-valeurs et des intervalles de confiance. Une fois cette formule comprise, vous ne vous laissez plus impressionner par le seul mot « significatif » : vous savez aussi lire « quelle est la taille de l’écart ? » et « y avait-il assez de patients ? ».
Quand un nouveau procédé B semble faire baisser le taux de défauts de 1,5 % à 1,0 %, la conclusion dépend du volume : avec 2 000 pièces de chaque côté, « c’est dans la marge du hasard », et avec 20 000 pièces de chaque côté, « c’est une amélioration significative ». Ce calcul évite que les décisions sur les équipements et les procédés soient faussées par le hasard des petits échantillons.
Pour de petites proportions comme les taux de défauts, l’approximation normale devient grossière quand le nombre attendu de défauts (pièces × taux de défauts) passe sous 5 : on choisit alors un test exact qui utilise directement la loi binomiale (comme le test exact de Fisher).
Le même test sert pour des comparaisons comme « les classes utilisant le nouveau manuel ont un taux de réussite de 75 %, contre 65 % avec l’ancien ». Mais si vous attribuez les manuels par classe, les élèves n’ont pas été répartis au hasard, et les différences d’enseignants et d’élèves se mêlent au résultat.
En recherche en éducation et en sciences sociales, en plus de vérifier la significativité avec cette formule, le protocole compte : les groupes ont-ils été répartis au hasard, et quelqu’un a-t-il changé le découpage de la comparaison après avoir vu les résultats ? Connaître les hypothèses derrière la formule, c’est ce qui évite de se laisser tromper par les chiffres.
Formule
Symboles et termes
Symboles
| \(n_A,\ n_B\) | n indice A, n indice B | Visites (clics ou sessions) des groupes A et B. \(n\) est l’initiale de « nombre », la lettre habituelle en statistique pour la taille de l’échantillon. |
| \(x_A,\ x_B\) | x indice A, x indice B | Conversions des groupes A et B. Noter le nombre de succès \(x\) est l’usage pour la loi binomiale. |
| \(\hat{p}_A,\ \hat{p}_B\) | p chapeau indice A, p chapeau indice B | Taux de conversion des groupes A et B (proportions de l’échantillon). \(p\) est l’initiale de « proportion » ou de « probabilité », et le « \(\hat{}\) » (chapeau) au-dessus signale une valeur estimée à partir de l’échantillon pour la vraie valeur \(p\). |
| \(\hat{p}\) | p chapeau | Taux de conversion commun. Un seul taux de conversion estimé à partir des deux groupes réunis, en supposant qu’il n’y a pas de différence : \(\hat{p} = (x_A + x_B) \div (n_A + n_B)\). |
| \(d\) | d | Écart de taux de conversion (\(\hat{p}_B - \hat{p}_A\)), initiale de « différence ». Cette page l’affiche multiplié par 100, en points de pourcentage. |
| \(L\) | l | Uplift relatif (%), initiale de « lift » (hausse en anglais). De combien de % le taux de conversion de B a augmenté par rapport à celui de A. |
| \(\mathrm{SE}\) | s-e | Erreur type (standard error en anglais). Un repère de la variation due au hasard d’une valeur tirée de l’échantillon (ici, l’écart de taux de conversion) ; c’est l’écart-type de cette valeur. Le test utilise le taux de conversion commun, et l’intervalle de confiance utilise \(\mathrm{SE}_d\), tirée du taux de conversion de chaque groupe. |
| \(z\) | z | Score z (statistique de test). L’écart divisé par l’erreur type : combien de fois l’écart dépasse la variation due au hasard. Sans différence, il suit la loi normale centrée réduite (moyenne 0, écart-type 1) : la p-valeur se déduit de sa taille. |
| \(|z|\) | valeur absolue de z | La taille du score z sans son signe. Un test bilatéral ne s’intéresse pas au sens de l’écart : il utilise la valeur absolue. |
| \(\Phi\) | phi majuscule | La fonction de répartition de la loi normale centrée réduite. \(\Phi(z)\) est la probabilité qu’une valeur normale centrée réduite soit inférieure ou égale à \(z\), l’aire sous la courbe en cloche à gauche de \(z\). La lettre grecque phi majuscule est le symbole habituel. |
| \(p_2,\ p_1\) | p indice 2, p indice 1 | Les p-valeurs bilatérale et unilatérale. Les indices 2 et 1 signifient « deux queues » et « une queue », une notation propre à cette page ; les manuels de statistique écrivent simplement \(p\). |
| \(\alpha\) | alpha | Le seuil de signification : le seuil fixé à l’avance tel que « si la p-valeur est plus petite, on rejette l’hypothèse nulle ». On prend souvent 5 % (0,05). Lettre grecque alpha ; c’est la probabilité d’une erreur de première espèce (conclure à une différence qui n’existe pas). On parle aussi de risque α. |
| \(z_{\alpha/2}\) | z indice alpha sur 2 | Le score z limite (valeur critique) qui laisse une probabilité totale \(\alpha\) dans les deux queues. 1,96 pour un intervalle de confiance à 95 % (\(\alpha = 0{,}05\)) et 2,576 pour 99 %. Pour une seule queue, c’est \(z_\alpha\) (1,645 pour 5 %). |
| \(d_L,\ d_U\) | d indice L, d indice U | Les bornes inférieure (lower) et supérieure (upper) de l’intervalle de confiance de l’écart : les deux extrémités de la plage où se trouve probablement le vrai écart. |
Termes
| test A/B | Une expérience qui montre au hasard aux visiteurs, sur la même période, la version d’origine (A) ou une version modifiée (B), et compare les résultats. Très utilisée pour les sites web, les annonces et les e-mails. La répartition au hasard rend les facteurs autres que la version (jour de la semaine, source de trafic, etc.) identiques dans les deux groupes. |
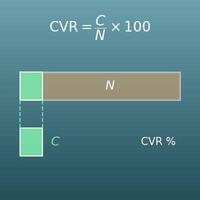
| taux de conversion (CVR) | La part des visites (clics) qui ont abouti à un résultat (une conversion) comme un achat ou une inscription. Pour calculer un seul taux de conversion ou remonter à partir de lui, voir la page de calcul du taux de conversion. |
| hypothèse nulle | L’hypothèse que le test cherche à rejeter : « A et B ont en réalité le même taux de conversion » (\(p_A = p_B\)), notée H₀. Le test vérifie à quel point l’écart observé serait improbable si elle était vraie. |
| hypothèse alternative | L’hypothèse que l’on veut montrer, opposée à l’hypothèse nulle. Dans un test bilatéral, c’est « A et B diffèrent » (\(p_A \neq p_B\)) ; dans un test unilatéral, « B est plus élevé que A » (\(p_B > p_A\)). |
| seuil de signification | Le seuil fixé avant le test : si la p-valeur est plus petite, on rejette l’hypothèse nulle. On prend souvent 5 % ; 1 % pour un test plus strict. « Significatif à 5 % » veut dire « la probabilité d’un écart aussi grand sans vraie différence est inférieure à 5 % ». |
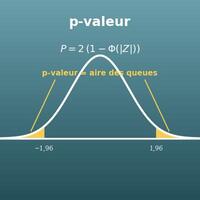
| p-valeur | La probabilité qu’un écart au moins aussi grand apparaisse par hasard, en supposant l’hypothèse nulle (pas de différence) vraie. Plus elle est petite, plus le résultat est difficile à expliquer par le hasard. Attention : ce n’est pas « la probabilité que B soit meilleur » (une erreur fréquente). |
| statistiquement significatif | La p-valeur est inférieure au seuil de signification : l’écart est jugé difficile à expliquer par une variation due au hasard. Cela ne promet pas que l’écart est grand ni que l’effet est certain ; avec un très grand nombre de visites, même un écart minuscule devient significatif. |
| statistique de test | Un nombre unique calculé à partir des données pour le test. Sur cette page, c’est le score z, « écart ÷ erreur type ». Son caractère plus ou moins extrême détermine la p-valeur. |
| test z de comparaison de deux proportions | Un test qui utilise la loi normale pour vérifier si les proportions (comme les taux de conversion) de deux groupes diffèrent. C’est la façon la plus simple de juger la significativité d’un test A/B. On peut faire presque la même chose avec un test du khi-deux sur un tableau 2×2, et les p-valeurs bilatérales sont identiques. |
| erreur type | L’écart-type d’une statistique tirée d’un échantillon (ici, l’écart de taux de conversion) : de combien elle varie par hasard selon l’échantillon. Elle diminue proportionnellement à la racine carrée du nombre de visites : pour diviser l’erreur type par deux, il faut 4 fois plus de visites. On dit aussi erreur standard. |
| regroupement (pooling) | Réunir les données des deux groupes pour estimer un seul taux de conversion, en supposant qu’il n’y a pas de différence. L’erreur type du test utilise ce taux commun. |
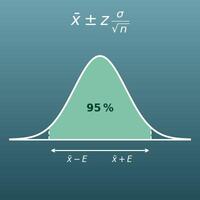
| intervalle de confiance | La plage où se trouve probablement le vrai écart. Un intervalle de confiance à 95 % est une façon de construire des intervalles telle que, si l’on répétait l’expérience de nombreuses fois, 95 % d’entre eux contiendraient le vrai écart. Si l’intervalle ne contient pas 0, cela concorde presque toujours avec un résultat significatif dans un test bilatéral à 5 %. |
| test bilatéral | Un test de « y a-t-il une différence (quel que soit le plus élevé) ? ». À utiliser pour un test A/B ordinaire où vous ne savez pas dans quel sens le résultat ira. |
| test unilatéral | Un test dans un sens fixé, comme « B est-il plus élevé que A ? ». Sa p-valeur est la moitié de la bilatérale, donc le résultat devient plus facilement significatif ; ne l’utilisez que si vous avez fixé le sens avant le test. |
| région de rejet | La zone des queues de la loi normale centrée réduite où, si le score z y tombe, on rejette l’hypothèse nulle. Pour un test bilatéral à 5 %, ce sont les deux queues \(z < -1{,}96\) et \(z > 1{,}96\), d’aire totale 0,05. C’est la partie colorée du graphique de cette page. |
| valeur critique | Le score z à la limite de la région de rejet. 1,96 pour un test bilatéral à 5 %, 2,576 pour un test bilatéral à 1 % et 1,645 pour un test unilatéral à 5 %. La « marge du score z » du résultat montre de combien ce score z est au-dessus (ou en dessous) de la valeur critique. |
| approximation normale | Le nombre de conversions suit en réalité une loi binomiale, mais avec beaucoup de visites, une loi normale (courbe en cloche) l’approche bien. Le test z utilise cette approximation : en repère, les conversions attendues \(n\hat{p}\) et les non-conversions attendues \(n(1-\hat{p})\) de chaque groupe devraient être d’au moins 5 (au moins 10 si possible). |
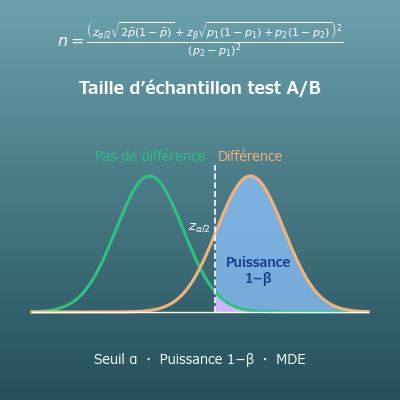
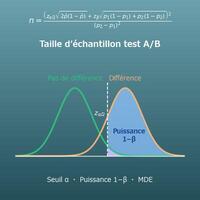
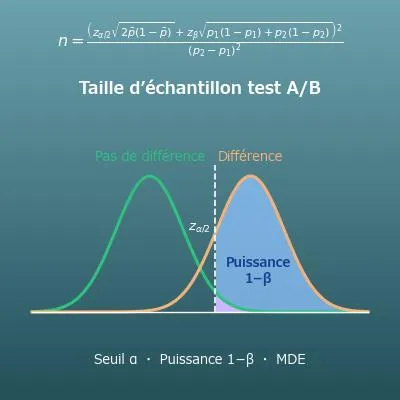
| puissance statistique | La probabilité que le test détecte comme significative une différence réelle. Avec peu de visites, la puissance est faible, et même un effet réel sort souvent « non significatif ». « Non significatif » ne prouve pas « aucune différence ». |
| erreur de première espèce | Conclure à un résultat significatif alors qu’il n’y a en réalité aucune différence (un faux positif). Le seuil de signification \(\alpha\) est le risque accepté pour cette erreur ; à 5 %, « lancez 100 tests sans vraie différence et environ 5 sortiront significatifs par hasard ». |
| comparaisons multiples | Tester de nombreuses versions ou de nombreux indicateurs à la fois. Même au seuil de signification de 5 %, testez 20 indicateurs et l’un d’eux sera probablement « significatif » par hasard. Il faut restreindre les indicateurs à l’avance ou utiliser un seuil de signification plus strict (correction de Bonferroni, etc.). |
| arrêt anticipé (peeking) | Regarder les résultats encore et encore pendant le test et l’arrêter dès qu’il semble significatif. La p-valeur monte et descend pendant un test : si vous « arrêtez dès la première fois qu’elle passe sous 5 % », le risque d’un résultat significatif sans vraie différence dépasse largement 5 %. La règle de base : fixer d’abord les visites nécessaires et attendre de les atteindre. |
| uplift relatif | De combien de % le taux de conversion de B a augmenté par rapport à celui de A : l’écart \(d\) divisé par le taux de conversion de A, multiplié par 100. « +25 % » se traduit plus facilement en conversions et en chiffre d’affaires supplémentaires que « +0,5 point ». On dit aussi hausse relative. |
| point de pourcentage | L’unité du résultat de la soustraction de deux pourcentages (souvent abrégée en « point »). On l’emploie comme dans « 2,5 % − 2 % = 0,5 point de pourcentage » ; écrire « 0,5 % » pourrait faire croire à « 0,5 % de 2 % ». |
Ce qu’il est utile de savoir avant de commencer
Ce qu’il est utile de savoir pour utiliser le calcul de cette page en comprenant ce qu’il fait, et pas seulement en appuyant sur le bouton.
Si vous bloquez, revenir sur ces notions est le chemin le plus court.
| Proportions et pourcentages (CM2-6e, 10-12 ans) |
|
| Inverses et racines carrées (4e-3e, 13-15 ans) |
|
| La loi normale et l’écart-type (terminale et études supérieures, 17 ans et plus) |
|
| La logique des tests d’hypothèse (études supérieures : BTS, IUT, licence, 18 ans et plus) |
|
| La loi binomiale et son approximation normale (1re-terminale et études supérieures, 16 ans et plus) |
|
Calculer avec Excel
| Visites A n_A | 10000 |
| Conversions A x_A | 200 |
| Visites B n_B | 10000 |
| Conversions B x_B | 250 |
| Taux de conversion de A p̂_A | =B2/B1 |
| Taux de conversion de B p̂_B | =B4/B3 |
| Taux de conversion de A p̂_A | 0,02 |
| Taux de conversion de B p̂_B | 0,025 |
| Écart d | =B2-B1 |
| Uplift relatif L (%) | =B3/B1*100 |
| Conversions A x_A | 200 |
| Conversions B x_B | 250 |
| Visites A n_A | 10000 |
| Visites B n_B | 10000 |
| Taux de conversion commun p̂ | =(B1+B2)/(B3+B4) |
| Taux de conversion commun p̂ | 0,0225 |
| Visites A n_A | 10000 |
| Visites B n_B | 10000 |
| Écart d | 0,005 |
| Erreur type SE | =RACINE(B1*(1-B1)*(1/B2+1/B3)) |
| Score z z | =B4/B5 |
| Score z z | 2,384 |
| P-valeur bilatérale p₂ | =2*(1-LOI.NORMALE.STANDARD.N(ABS(B1);VRAI)) |
| P-valeur unilatérale p₁ | =1-LOI.NORMALE.STANDARD.N(B1;VRAI) |
| Taux de conversion de A p̂_A | 0,02 |
| Visites A n_A | 10000 |
| Taux de conversion de B p̂_B | 0,025 |
| Visites B n_B | 10000 |
| Écart d | 0,005 |
| Niveau de confiance (0,95 = 95 %) | 0,95 |
| z_(α/2) | =LOI.NORMALE.STANDARD.INVERSE.N(1-(1-B6)/2) |
| Erreur type SE_d | =RACINE(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| Borne inférieure d_L | =B5-B7*B8 |
| Borne supérieure d_U | =B5+B7*B8 |
Dans le premier tableau, B5 affiche le taux de conversion de A, 0,02, et B6 celui de B, 0,025. Le deuxième tableau donne un écart de 0,005 (0,5 point de pourcentage) et un uplift de 25, le troisième un taux de conversion commun de 0,0225, et le quatrième une erreur type d’environ 0,002097 et un score z d’environ 2,384.
Dans le cinquième tableau, LOI.NORMALE.STANDARD.N(z;VRAI) renvoie la probabilité cumulée Φ(z) de la loi normale centrée réduite ; la p-valeur bilatérale vaut environ 0,0171 et l’unilatérale environ 0,0086. Dans le sixième tableau, LOI.NORMALE.STANDARD.INVERSE.N trouve le score z à partir d’une probabilité cumulée (1,96 pour un niveau de confiance de 95 %), ce qui donne une borne inférieure d’environ 0,0009 et une borne supérieure d’environ 0,0091 (de 0,09 à 0,91 point de pourcentage).
Calculer avec Google Sheets
| Visites A n_A | 10000 |
| Conversions A x_A | 200 |
| Visites B n_B | 10000 |
| Conversions B x_B | 250 |
| Taux de conversion de A p̂_A | =B2/B1 |
| Taux de conversion de B p̂_B | =B4/B3 |
| Taux de conversion de A p̂_A | 0,02 |
| Taux de conversion de B p̂_B | 0,025 |
| Écart d | =B2-B1 |
| Uplift relatif L (%) | =B3/B1*100 |
| Conversions A x_A | 200 |
| Conversions B x_B | 250 |
| Visites A n_A | 10000 |
| Visites B n_B | 10000 |
| Taux de conversion commun p̂ | =(B1+B2)/(B3+B4) |
| Taux de conversion commun p̂ | 0,0225 |
| Visites A n_A | 10000 |
| Visites B n_B | 10000 |
| Écart d | 0,005 |
| Erreur type SE | =RACINE(B1*(1-B1)*(1/B2+1/B3)) |
| Score z z | =B4/B5 |
| Score z z | 2,384 |
| P-valeur bilatérale p₂ | =2*(1-LOI.NORMALE.STANDARD(ABS(B1))) |
| P-valeur unilatérale p₁ | =1-LOI.NORMALE.STANDARD(B1) |
| Taux de conversion de A p̂_A | 0,02 |
| Visites A n_A | 10000 |
| Taux de conversion de B p̂_B | 0,025 |
| Visites B n_B | 10000 |
| Écart d | 0,005 |
| Niveau de confiance (0,95 = 95 %) | 0,95 |
| z_(α/2) | =LOI.NORMALE.STANDARD.INVERSE(1-(1-B6)/2) |
| Erreur type SE_d | =RACINE(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| Borne inférieure d_L | =B5-B7*B8 |
| Borne supérieure d_U | =B5+B7*B8 |
Calculer avec Python
import math

visits_a, conversions_a = 10000, 200   # visites et conversions de A
visits_b, conversions_b = 10000, 250   # visites et conversions de B
alpha = 0.05                           # seuil de signification (5 %)

def normal_cdf(z):
    # fonction de répartition de la loi normale centrée réduite Φ(z)
    return 0.5 * math.erfc(-z / math.sqrt(2))

def normal_ppf(p):
    # réciproque de Φ (dichotomie ; sert à trouver z_(α/2))
    low, high = -10.0, 10.0
    for _ in range(100):
        mid = (low + high) / 2
        if normal_cdf(mid) < p:
            low = mid
        else:
            high = mid
    return (low + high) / 2

cvr_a = conversions_a / visits_a
cvr_b = conversions_b / visits_b
diff = cvr_b - cvr_a
lift = diff / cvr_a * 100
pooled = (conversions_a + conversions_b) / (visits_a + visits_b)
se_pooled = math.sqrt(pooled * (1 - pooled) * (1 / visits_a + 1 / visits_b))
z = diff / se_pooled
p_two_sided = 2 * (1 - normal_cdf(abs(z)))
p_one_sided = 1 - normal_cdf(z)

se_diff = math.sqrt(cvr_a * (1 - cvr_a) / visits_a + cvr_b * (1 - cvr_b) / visits_b)
z_half = normal_ppf(1 - alpha / 2)
ci_low, ci_high = diff - z_half * se_diff, diff + z_half * se_diff

print(f"Taux de conversion A : {cvr_a * 100:.2f} %  Taux de conversion B : {cvr_b * 100:.2f} %")
print(f"Écart : {diff * 100:.2f} points  Uplift relatif : {lift:.1f} %")
print(f"Score z : {z:.3f}  p-valeur bilatérale : {p_two_sided:.4f}  p-valeur unilatérale : {p_one_sided:.4f}")
print("Conclusion (bilatéral) :", "statistiquement significatif" if p_two_sided < alpha else "non significatif")
print(f"Intervalle de confiance à {(1 - alpha) * 100:.0f} % de l'écart : de {ci_low * 100:.2f} à {ci_high * 100:.2f} points")
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
p̂_A = x_A ÷ n_A
\hat{p}_A = \dfrac{x_A}{n_A}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
    <mo>=</mo>
    <mfrac>
      <msub><mi>x</mi><mi>A</mi></msub>
      <msub><mi>n</mi><mi>A</mi></msub>
    </mfrac>
  </mrow>
</math>
hat(p)_A = x_A / n_A
xA/nA
pA := xA/nA;
pA = xA/nA;
p̂_A = x_A/n_A
d = p̂_B − p̂_A, L = d ÷ p̂_A × 100
d = \hat{p}_B - \hat{p}_A, \quad L = \dfrac{d}{\hat{p}_A} \times 100
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>=</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub>
<mo>−</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
<mo>,</mo><mspace width="1em"/>
<mi>L</mi><mo>=</mo>
<mfrac><mi>d</mi><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mfrac>
<mo>×</mo><mn>100</mn>
</mrow>
</math>
d = hat(p)_B - hat(p)_A, L = d / hat(p)_A xx 100
d = pB - pA; d/pA*100
d := pB - pA; L := d/pA*100;
d = pB - pA; L = d/pA*100;
d = p̂_B − p̂_A, L = d/p̂_A × 100
p̂ = (x_A + x_B) ÷ (n_A + n_B)
\hat{p} = \dfrac{x_A + x_B}{n_A + n_B}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mover accent="true"><mi>p</mi><mo>^</mo></mover>
    <mo>=</mo>
    <mfrac>
      <mrow><msub><mi>x</mi><mi>A</mi></msub><mo>+</mo><msub><mi>x</mi><mi>B</mi></msub></mrow>
      <mrow><msub><mi>n</mi><mi>A</mi></msub><mo>+</mo><msub><mi>n</mi><mi>B</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
hat(p) = (x_A + x_B) / (n_A + n_B)
(xA + xB)/(nA + nB)
pPool := (xA + xB)/(nA + nB);
pPool = (xA + xB)/(nA + nB);
p̂ = (x_A + x_B)/(n_A + n_B)
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d ÷ SE
\mathrm{SE} = \sqrt{\hat{p}(1-\hat{p})\left(\dfrac{1}{n_A}+\dfrac{1}{n_B}\right)}, \quad z = \dfrac{d}{\mathrm{SE}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi><mo>=</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mrow>
<msqrt>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
<mo>(</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>A</mi></msub></mfrac>
<mo>+</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>B</mi></msub></mfrac>
<mo>)</mo>
</msqrt>
</mfrac>
</mrow>
</math>
SE = sqrt(hat(p)(1 - hat(p))(1/n_A + 1/n_B)), z = d / SE
se = Sqrt[pPool*(1 - pPool)*(1/nA + 1/nB)]; z = d/se
SE := sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z := d/SE;
SE = sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z = d/SE;
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d/SE
p₂ = 2(1 − Φ(|z|)), p₁ = 1 − Φ(z)
p_2 = 2\left(1 - \Phi(|z|)\right), \quad p_1 = 1 - \Phi(z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>p</mi><mn>2</mn></msub><mo>=</mo>
<mn>2</mn><mo>(</mo><mn>1</mn><mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>z</mi><mo>|</mo><mo>)</mo><mo>)</mo>
<mo>,</mo><mspace width="1em"/>
<msub><mi>p</mi><mn>1</mn></msub><mo>=</mo>
<mn>1</mn><mo>−</mo><mi>Φ</mi><mo>(</mo><mi>z</mi><mo>)</mo>
</mrow>
</math>
p_2 = 2(1 - Phi(|z|)), p_1 = 1 - Phi(z)
p2 = 2*(1 - CDF[NormalDistribution[0, 1], Abs[z]]); p1 = 1 - CDF[NormalDistribution[0, 1], z]
p2 := 2*(1 - Statistics:-CDF(Normal(0, 1), abs(z))); p1 := 1 - Statistics:-CDF(Normal(0, 1), z);
p2 = 2*(1 - normcdf(abs(z))); p1 = 1 - normcdf(z);
p_2 = 2(1 − Φ(|z|)), p_1 = 1 − Φ(z)
d ± z_(α/2) × √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
d \pm z_{\alpha/2}\sqrt{\dfrac{\hat{p}_A(1-\hat{p}_A)}{n_A}+\dfrac{\hat{p}_B(1-\hat{p}_B)}{n_B}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>±</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>A</mi></msub>
</mfrac>
<mo>+</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>B</mi></msub>
</mfrac>
</msqrt>
</mrow>
</math>
d +- z_(alpha/2) sqrt((hat(p)_A(1 - hat(p)_A))/n_A + (hat(p)_B(1 - hat(p)_B))/n_B)
seD = Sqrt[pA*(1 - pA)/nA + pB*(1 - pB)/nB]; {d - zHalf*seD, d + zHalf*seD}
seD := sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); [d - zHalf*seD, d + zHalf*seD];
seD = sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); ci = [d - zHalf*seD, d + zHalf*seD];
d ± z_(α/2) √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
Faire faire le calcul par ChatGPT
Tu es un assistant de calcul en statistique (tests d’hypothèse). Fais le calcul suivant en exécutant réellement du code Python, et appuie ta réponse uniquement sur les nombres obtenus à l’exécution (ne réponds pas de tête ni au jugé).

Les résultats du test A/B sont :
- Groupe A : 10 000 visites, 200 conversions
- Groupe B : 10 000 visites, 250 conversions
Calcule chacun des points suivants :
1. Le taux de conversion de chaque groupe (%), l’écart de taux de conversion (en points de pourcentage) et l’uplift relatif (%)
2. Le taux de conversion commun et l’erreur type commune SE = √(p̂(1−p̂)(1/n_A + 1/n_B))
3. Le score z = écart ÷ SE, et les p-valeurs bilatérale et unilatérale (loi normale centrée réduite)
4. Si l’écart est statistiquement significatif au seuil de signification de 5 % (test bilatéral)
5. L’intervalle de confiance à 95 % de l’écart (avec l’erreur type calculée à partir du taux de conversion de chaque groupe, √(p̂_A(1−p̂_A)/n_A + p̂_B(1−p̂_B)/n_B))

En Python, utilise math.erfc (ou scipy.stats.norm) et montre les formules utilisées et les nombres obtenus à l’exécution.
Mode d'emploi
-
1Saisissez vos nombresTapez les nombres à calculer dans les champs de saisie
-
2CalculezAppuyez sur le bouton « Calculer »
-
3Lisez le résultatLe résultat s’affiche aussitôt. La même page explique aussi le raisonnement et la formule
Les atouts de DataChef

Aucune compétence requise – simple et intuitif

Aucune donnée personnelle nécessaire

Le fichier est supprimé automatiquement après le téléchargement


Aucune mention de crédit nécessaire

Aucune autorisation préalable nécessaire
Fonctions connexes
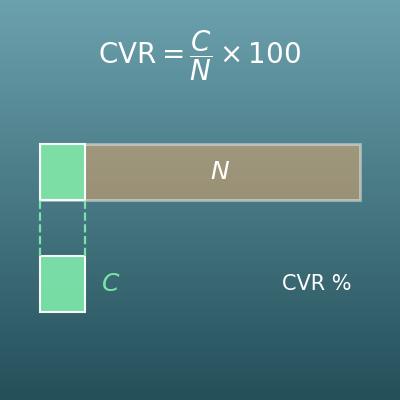
Calcul du taux de conversion (visites nécessaires et conversions attendues)
Saisissez deux valeurs parmi les visites, les conversions et le taux de conversion pour obtenir la troisième. Pour le taux de conversion d’un seul groupe
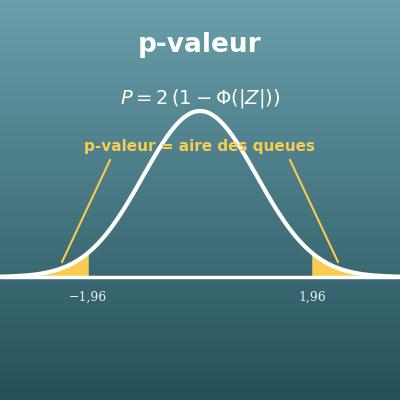
Calcul de la p-valeur : de Z à la p-valeur et inversement
Un calculateur général qui convertit un Z déjà connu en p-valeur à gauche, à droite ou bilatérale. Cette page commence une étape plus tôt, à partir des visites et des conversions
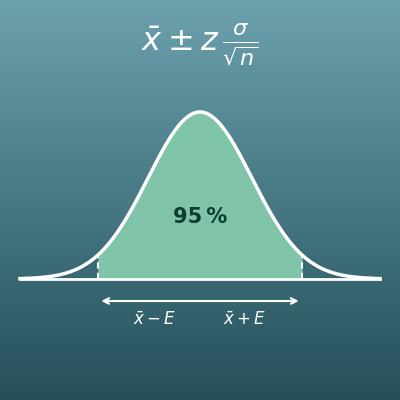
Calcul d’un intervalle de confiance pour une moyenne
Trouve l’intervalle de confiance d’une moyenne (notes, ventes, etc.). La version « moyenne » de l’intervalle de confiance de la différence de cette page
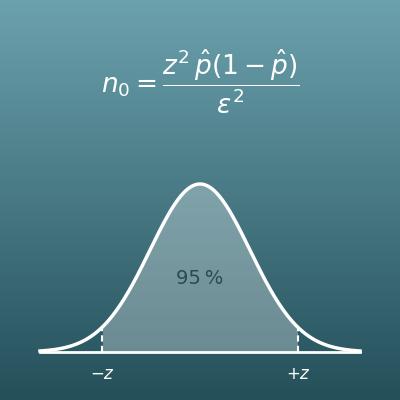
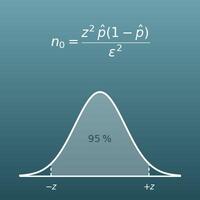
Calcul de la taille d’échantillon (sondage et marge d’erreur)
Calcule le nombre de personnes nécessaires pour estimer une proportion avec une marge d’erreur donnée dans un sondage. Pour concevoir une enquête