



























































































Saisissez les nombres dont vous voulez mesurer la dispersion, séparés par des points-virgules (;). L’écart-type de la population σ et celui de l’échantillon s sont calculés en même temps que la moyenne, les variances et la somme des carrés des écarts.
Table des matières
-
Ce que vous pouvez faire sur cette page
-
À quoi sert ce calcul ?
-
Mode d'emploi
-
Formules et figures
-
Symboles et termes
-
Ce qu’il est utile de savoir avant de commencer
-
Calculer avec Excel
-
Calculer avec Google Sheets
-
Calculer avec Python
-
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
-
Faire faire le calcul par ChatGPT
-
Les atouts de DataChef
-
Fonctions connexes
-
Liste des calculatrices NumberChef
Ce que vous pouvez faire sur cette page
- Saisissez vos nombres séparés par des points-virgules (;) et obtenez tout de suite l’écart-type
- L’écart-type de la population \(\sigma\) (on divise par \(N\)) et celui de l’échantillon \(s\) (on divise par \(N-1\)) s’affichent ensemble
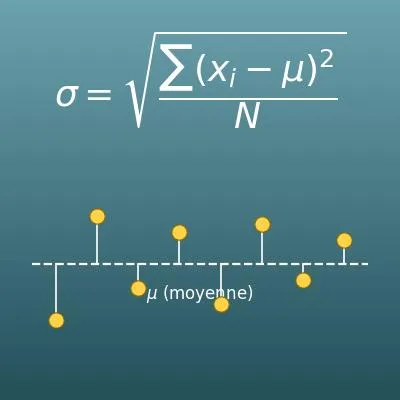
- La moyenne \(\mu\), la somme des carrés des écarts \(\sum (x_i-\mu)^2\) et les variances \(\sigma^2\) et \(s^2\) sont aussi calculées : vous suivez chaque étape d’un coup d’œil
- Une explication simple des formules et des formules à copier-coller pour Excel, Google Sheets et Python sont réunies sur cette page
À quoi sert ce calcul ?
Le score z (ou note centrée réduite) indique à combien d’écarts-types une note se trouve de la moyenne : \(z = \dfrac{x - \text{moyenne}}{\text{écart-type}}\). L’écart-type est directement au dénominateur.
Si la moyenne de la classe est 12/20 et l’écart-type 2,5, une note de 16/20 donne \(z = (16 - 12) \div 2{,}5 = 1{,}6\) : elle est 1,6 écart-type au-dessus de la moyenne. C’est le principe de l’harmonisation des notes entre correcteurs et des classements de certains concours. Cela explique aussi pourquoi une même note ressort davantage dans un contrôle où les notes sont très resserrées (faible dispersion).
Même fabriquées avec une grande précision, la longueur des vis ou la masse des pièces varient toujours un peu. Les usines mesurent cette variabilité avec l’écart-type et pilotent la production pour que « la moyenne ± 3 écarts-types » reste dans les tolérances du client.
Plus l’écart-type est petit, plus les produits sont réguliers et de bonne qualité. C’est un indicateur si fondamental qu’on peut presque dire qu’améliorer la qualité, c’est réduire l’écart-type.
Deux placements peuvent rapporter tous les deux 5 % par an en moyenne. Celui dont les rendements ont le plus grand écart-type connaît des années de forte hausse et des années de forte baisse : on le juge plus risqué.
En finance, l’écart-type des rendements s’appelle la volatilité, et c’est la mesure du risque la plus courante. Pour les décisions importantes sur votre argent, regardez la dispersion (l’écart-type) autant que la moyenne.
Deux villes peuvent avoir la même température moyenne annuelle. Si l’écart-type de leurs températures mensuelles est petit, la ville a un climat doux toute l’année ; s’il est grand, l’été et l’hiver sont très différents (climat océanique contre climat continental, par exemple).
L’écart-type traduit en un nombre le caractère « stable ou changeant », que la moyenne seule ne montre pas. On s’en sert pour comparer des climats et pour planifier les cultures ou le tourisme.
Les valeurs de référence indiquées sur une prise de sang sont parfois fixées en recueillant les données de nombreuses personnes en bonne santé et en prenant environ « la moyenne ± 2 écarts-types » (en pratique, chaque analyse utilise une méthode adaptée à la forme de sa distribution).
Connaître l’écart-type aide à garder son calme : sortir un peu des valeurs de référence ne veut pas forcément dire être malade, car une partie des personnes en bonne santé se trouve aussi en dehors.
Formules et figures
Symboles et termes
Symboles
| \(x_1, x_2, \ldots, x_N\) | x indice 1, x indice 2, …, x indice N | Les valeurs dont vous voulez mesurer la dispersion. (Exemple : les notes de 8 élèves à un contrôle) |
| \(N\) | N | Le nombre de valeurs (l’effectif total). (Exemple : pour 8 élèves, \(N = 8\)) |
| \(\mu\) | mu | La moyenne. Cette lettre grecque désigne la moyenne d’une population. La moyenne d’un échantillon se note \(\bar{x}\) (« x barre »), mais elle se calcule de la même façon. |
| \(x_i - \mu\) | x indice i moins mu | L’écart à la moyenne. Il indique à quelle distance chaque valeur se trouve de la moyenne. |
| \(S\) | S | La somme des carrés des écarts, \(\sum (x_i-\mu)^2\), obtenue en élevant chaque écart au carré et en additionnant le tout. La variance et l’écart-type sont construits à partir d’elle. |
| \(\sigma^2\) | sigma au carré | La variance de la population : la somme des carrés des écarts divisée par l’effectif \(N\). |
| \(\sigma\) | sigma | L’écart-type de la population, racine carrée de la variance de la population. C’est le symbole le plus connu de la dispersion. |
| \(s^2\) | s au carré | La variance de l’échantillon (variance corrigée) : la somme des carrés des écarts divisée par \(N-1\). |
| \(s\) | s | L’écart-type de l’échantillon, racine carrée de la variance de l’échantillon. |
| \(\sum\) | sigma (symbole de somme) | Un symbole qui veut dire « on additionne tout ». \(\sum_{i=1}^{N} x_i\) est la somme de \(x_1\) à \(x_N\). |
Termes
| écart-type | Un nombre qui indique à quel point les données sont dispersées autour de la moyenne. C’est la racine carrée de la variance ; comme il a la même unité que les données, il donne une bonne idée de « l’écart habituel à la moyenne ». C’est la mesure de dispersion la plus courante. |
| variance | La moyenne des carrés des écarts (les différences entre chaque valeur et la moyenne). Elle mesure l’ampleur de la dispersion, mais son unité est au carré : on la transforme donc en général en écart-type en prenant la racine carrée. |
| écart | La différence entre une valeur et la moyenne (\(x_i - \mu\)), aussi appelée écart à la moyenne. Positif, la valeur est au-dessus de la moyenne ; négatif, elle est en dessous. Additionnés tels quels, les écarts donnent toujours 0 : on les élève donc au carré avant de s’en servir. |
| somme des carrés des écarts | Les écarts élevés au carré puis tous additionnés. La variance et l’écart-type sont tous construits à partir de cette valeur. |
| population | Le groupe entier que l’on veut étudier. Si vos données forment ce groupe entier, prenez l’écart-type de la population \(\sigma\). |
| échantillon | Une partie des données tirée d’une population (le groupe entier). Pour estimer la dispersion du groupe entier à partir d’un échantillon, prenez l’écart-type de l’échantillon \(s\). |
| variance corrigée | La variance qui sert à estimer la variance d’une population à partir d’un échantillon (estimateur sans biais). On divise la somme des carrés des écarts par \(N-1\) : diviser par \(N\) donnerait une dispersion de la population trop petite, et diviser par un de moins corrige ce défaut. |
| correction de Bessel | Le fait de diviser par \(N-1\) au lieu de \(N\) dans la variance de l’échantillon. \(N-1\) s’appelle aussi le nombre de degrés de liberté. |
Ce qu’il est utile de savoir avant de commencer
Voici ce qui vous aide à utiliser le calcul de cette page en le comprenant vraiment, et pas seulement en appuyant sur le bouton.
| La moyenne (5e, 12-13 ans) |
|
| Nombres relatifs et parenthèses (5e-4e, 12-14 ans) |
|
| Puissances (4e, 13-14 ans) |
|
| Racine carrée (4e-3e, 13-15 ans) |
|
| Répartition et dispersion des données (du collège à la seconde, 12-16 ans) |
|
Calculer avec Excel
| Valeur 1 | 10 |
| Valeur 2 | 12 |
| Valeur 3 | 23 |
| Valeur 4 | 23 |
| Valeur 5 | 16 |
| Valeur 6 | 23 |
| Valeur 7 | 21 |
| Valeur 8 | 16 |
| Effectif N | =NB(B1:B8) |
| Somme Σx | =SOMME(B1:B8) |
| Moyenne μ | =MOYENNE(B1:B8) |
| Valeur 1 | 10 |
| Valeur 2 | 12 |
| Valeur 3 | 23 |
| Valeur 4 | 23 |
| Valeur 5 | 16 |
| Valeur 6 | 23 |
| Valeur 7 | 21 |
| Valeur 8 | 16 |
| Somme des carrés des écarts S | =SOMME.CARRES.ECARTS(B1:B8) |
| Valeur 1 | 10 |
| Valeur 2 | 12 |
| Valeur 3 | 23 |
| Valeur 4 | 23 |
| Valeur 5 | 16 |
| Valeur 6 | 23 |
| Valeur 7 | 21 |
| Valeur 8 | 16 |
| Variance de la population σ² | =VAR.P(B1:B8) |
| Écart-type de la population σ | =ECARTYPEP(B1:B8) |
| Valeur 1 | 10 |
| Valeur 2 | 12 |
| Valeur 3 | 23 |
| Valeur 4 | 23 |
| Valeur 5 | 16 |
| Valeur 6 | 23 |
| Valeur 7 | 21 |
| Valeur 8 | 16 |
| Variance de l’échantillon s² | =VAR(B1:B8) |
| Écart-type de l’échantillon s | =ECARTYPE(B1:B8) |
Le premier tableau affiche 18 pour la moyenne μ. L’écart-type de la population σ du troisième tableau vaut environ 4,899, et l’écart-type de l’échantillon s du quatrième environ 5,237.
Pour changer le nombre de valeurs, ajoutez (ou supprimez) des lignes de nombres, puis remplacez « B1:B8 » dans les formules par votre vraie plage de données (pour 10 valeurs, B1:B10).
ECARTYPEP et VAR.P, avec un « P », sont pour une population (on divise par N). ECARTYPE et VAR, sans « P », sont pour un échantillon (on divise par N − 1). SOMME.CARRES.ECARTS donne directement la somme des carrés des écarts.
Calculer avec Google Sheets
| Valeur 1 | 10 |
| Valeur 2 | 12 |
| Valeur 3 | 23 |
| Valeur 4 | 23 |
| Valeur 5 | 16 |
| Valeur 6 | 23 |
| Valeur 7 | 21 |
| Valeur 8 | 16 |
| Effectif N | =NB(B1:B8) |
| Somme Σx | =SOMME(B1:B8) |
| Moyenne μ | =MOYENNE(B1:B8) |
| Valeur 1 | 10 |
| Valeur 2 | 12 |
| Valeur 3 | 23 |
| Valeur 4 | 23 |
| Valeur 5 | 16 |
| Valeur 6 | 23 |
| Valeur 7 | 21 |
| Valeur 8 | 16 |
| Somme des carrés des écarts S | =SOMME.CARRES.ECARTS(B1:B8) |
| Valeur 1 | 10 |
| Valeur 2 | 12 |
| Valeur 3 | 23 |
| Valeur 4 | 23 |
| Valeur 5 | 16 |
| Valeur 6 | 23 |
| Valeur 7 | 21 |
| Valeur 8 | 16 |
| Variance de la population σ² | =VAR.P(B1:B8) |
| Écart-type de la population σ | =ECARTYPEP(B1:B8) |
| Valeur 1 | 10 |
| Valeur 2 | 12 |
| Valeur 3 | 23 |
| Valeur 4 | 23 |
| Valeur 5 | 16 |
| Valeur 6 | 23 |
| Valeur 7 | 21 |
| Valeur 8 | 16 |
| Variance de l’échantillon s² | =VAR(B1:B8) |
| Écart-type de l’échantillon s | =ECARTYPE(B1:B8) |
Dans Google Sheets aussi, ECARTYPEP et VAR.P servent pour une population, ECARTYPE et VAR pour un échantillon.
Calculer avec Python
import statistics

numbers = [10, 12, 23, 23, 16, 23, 21, 16]  # les nombres dont on veut mesurer la dispersion

mean = statistics.mean(numbers)               # moyenne μ
pstdev = statistics.pstdev(numbers)           # écart-type de la population σ (on divise par N)
pvariance = statistics.pvariance(numbers)     # variance de la population σ²
sstdev = statistics.stdev(numbers)            # écart-type de l’échantillon s (on divise par N-1)
svariance = statistics.variance(numbers)      # variance de l’échantillon s²

print(f"Effectif : {len(numbers)} / Somme : {sum(numbers)} / Moyenne : {mean}")
print(f"Variance de la population σ² : {pvariance} / Écart-type de la population σ : {pstdev}")
print(f"Variance de l’échantillon s² : {svariance} / Écart-type de l’échantillon s : {sstdev}")
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
μ = Σxᵢ ÷ N
\mu = \frac{x_1 + x_2 + \cdots + x_N}{N}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>μ</mi>
<mo>=</mo>
<mfrac>
<mrow>
<msub><mi>x</mi><mn>1</mn></msub>
<mo>+</mo>
<msub><mi>x</mi><mn>2</mn></msub>
<mo>+</mo>
<mo>⋯</mo>
<mo>+</mo>
<msub><mi>x</mi><mi>N</mi></msub>
</mrow>
<mi>N</mi>
</mfrac>
</mrow>
</math>
mu = (x_1 + x_2 + cdots + x_N) / N
Mean[data]
mu := add(x[i], i = 1 .. N)/N;
mu = mean(x);
μ = (x_1 + x_2 + ⋯ + x_N)/N
S = Σ(xᵢ − μ)²
S = \sum_{i=1}^{N} (x_i - \mu)^2
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>S</mi>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>1</mn></mrow>
<mi>N</mi>
</munderover>
<msup>
<mrow><mo>(</mo><msub><mi>x</mi><mi>i</mi></msub><mo>−</mo><mi>μ</mi><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mrow>
</math>
S = sum_(i=1)^N (x_i - mu)^2
Total[(data - Mean[data])^2]
S := add((x[i] - mu)^2, i = 1 .. N);
S = sum((x - mean(x)).^2);
S = ∑_(i=1)^N (x_i − μ)^2
σ² = S ÷ N ; s² = S ÷ (N − 1)
\sigma^2 = \frac{S}{N}, \qquad s^2 = \frac{S}{N-1}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msup><mi>σ</mi><mn>2</mn></msup>
<mo>=</mo>
<mfrac><mi>S</mi><mi>N</mi></mfrac>
<mo>,</mo>
<mspace width="1em"/>
<msup><mi>s</mi><mn>2</mn></msup>
<mo>=</mo>
<mfrac><mi>S</mi><mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow></mfrac>
</mrow>
</math>
sigma^2 = S/N, s^2 = S/(N-1)
popVar = S/n; sampleVar = Variance[data] (* N est une fonction prédéfinie de Mathematica, l’effectif est donc noté n *)
sigma2 := S/N; s2 := S/(N - 1);
popVar = S/N; sampleVar = var(x);
σ^2 = S/N, s^2 = S/(N−1)
σ = √(σ²) ; s = √(s²)
\sigma = \sqrt{\sigma^2} = \sqrt{\dfrac{S}{N}}, \qquad s = \sqrt{s^2} = \sqrt{\dfrac{S}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>σ</mi>
<mo>=</mo>
<msqrt><mfrac><mi>S</mi><mi>N</mi></mfrac></msqrt>
<mo>,</mo>
<mspace width="1em"/>
<mi>s</mi>
<mo>=</mo>
<msqrt><mfrac><mi>S</mi><mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow></mfrac></msqrt>
</mrow>
</math>
sigma = sqrt(S/N), s = sqrt(S/(N-1))
popSD = Sqrt[S/n]; sampleSD = StandardDeviation[data] (* N est une fonction prédéfinie de Mathematica, l’effectif est donc noté n *)
sigma := sqrt(S/N); s := sqrt(S/(N - 1));
popSD = sqrt(S/numel(x)); sampleSD = std(x);
σ = √(S/N), s = √(S/(N−1))
Faire faire le calcul par ChatGPT
Tu es un assistant de calcul statistique. Fais le calcul suivant en exécutant réellement du code Python, et appuie ta réponse uniquement sur les nombres obtenus à l’exécution (ne réponds pas de tête ni au jugé).

Pour les données suivantes, calcule chacune des valeurs ci-dessous.
Données : 10 ; 12 ; 23 ; 23 ; 16 ; 23 ; 21 ; 16
1. L’effectif, la somme et la moyenne
2. La somme des carrés des écarts (l’écart de chaque valeur à la moyenne, élevé au carré, puis tout additionné)
3. La variance de la population σ² (on divise par N) et l’écart-type de la population σ
4. La variance de l’échantillon s² (on divise par N − 1) et l’écart-type de l’échantillon s

Indique les formules utilisées et les nombres obtenus à l’exécution.
Mode d'emploi
-
1Saisissez vos nombresTapez les nombres à calculer dans les champs de saisie
-
2CalculezAppuyez sur le bouton « Calculer »
-
3Lisez le résultatLe résultat s’affiche aussitôt. La même page explique aussi le raisonnement et la formule
Les atouts de DataChef

Aucune compétence requise – simple et intuitif

Aucune donnée personnelle nécessaire

Le fichier est supprimé automatiquement après le téléchargement


Aucune mention de crédit nécessaire

Aucune autorisation préalable nécessaire
Fonctions connexes
Calcul de la moyenne
Calcule la moyenne, la médiane, la moyenne géométrique et plus encore à partir d’une liste de nombres

Calcul de probabilité avec la loi normale
Calcule la probabilité de tomber dans un intervalle donné à partir de la moyenne et de l’écart-type
Calcul de la différence en pourcentage entre deux valeurs
Exprime l’écart entre deux valeurs en pourcentage de leur moyenne