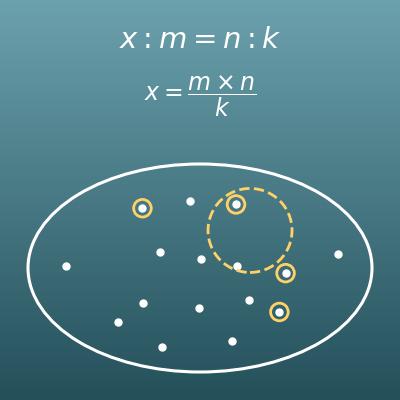










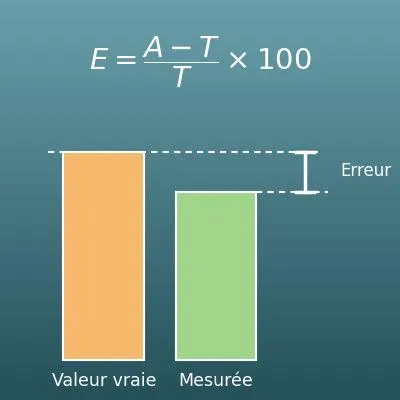













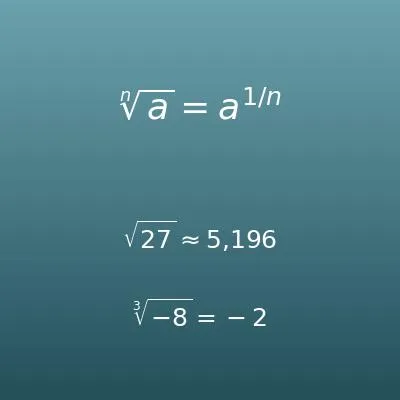





































































Deux façons d’utiliser ce calculateur. ① Entrez le niveau de confiance, la proportion et la marge d’erreur pour trouver la taille d’échantillon nécessaire. ② Entrez le niveau de confiance, la proportion et la taille d’échantillon pour trouver la marge d’erreur. N’entrez la taille de la population que si vous la connaissez.
Table des matières
-
Ce que vous pouvez faire sur cette page
-
À quoi sert ce calcul ?
-
Mode d'emploi
-
Formule
-
Taille d’échantillon nécessaire (quand la population est très grande)
-
Correction pour population finie de la taille d’échantillon (quand on connaît la taille \(N\) de la population)
-
Marge d’erreur (quand la population est très grande)
-
Correction pour population finie de la marge d’erreur (quand on connaît la taille \(N\) de la population)
-
-
Symboles et termes
-
Ce qu’il est utile de savoir avant de commencer
-
Calculer avec Excel
-
Calculer avec Google Sheets
-
Calculer avec Python
-
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
-
Faire faire le calcul par ChatGPT
-
Les atouts de DataChef
-
Fonctions connexes
-
Liste des calculatrices NumberChef
Ce que vous pouvez faire sur cette page
- « Combien de personnes interroger pour un niveau de confiance de 95 % et une marge d’erreur de ± 5 % ? » Obtenez tout de suite la taille d’échantillon nécessaire à votre enquête
- Et dans l’autre sens, « quelle est la précision, en plus ou en moins, d’un sondage auprès de 1 000 personnes ? » : la marge d’erreur se calcule sur la même page
- Si vous connaissez la taille de la population (500 salariés, 1 000 adhérents…), la correction pour population finie ramène le résultat au nombre vraiment nécessaire
- Une explication simple des formules et des formules à copier-coller pour Excel, Google Sheets et Python sont réunies sur cette page
À quoi sert ce calcul ?
Les sondages publiés dans les médias interrogent en général 1 000 à 2 000 personnes parmi près de 49 millions d’électeurs inscrits en France. Avec un niveau de confiance de 95 %, une marge d’erreur de ± 3 % et une proportion de 50 %, la taille d’échantillon nécessaire est \(1{,}96^2 \times 0{,}25 \div 0{,}03^2 \approx 1067{,}1\) (environ 1 068 personnes). Cette formule répond à la question : « 1 000 personnes suffisent-elles vraiment à connaître l’avis de dizaines de millions ? » (en France, les instituts utilisent aussi souvent la méthode des quotas, mais l’ordre de grandeur de l’erreur reste le même).
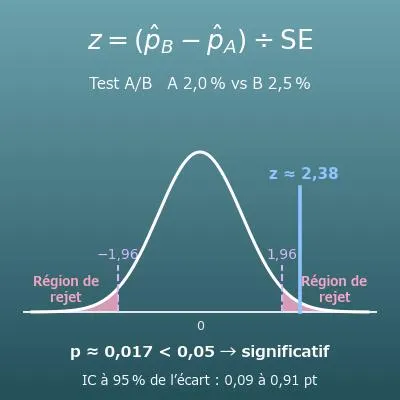
Dans l’autre sens, vous verrez que si « 45 % contre 47 % d’opinions favorables » reste dans une marge d’erreur de ± 3 points, on ne peut pas affirmer qu’il y a une différence statistique.
« Combien de nos 1 000 adhérents faut-il interroger ? » : c’est un cas typique pour la correction pour population finie. Avec un niveau de confiance de 95 %, une marge d’erreur de ± 5 % et une proportion de 50 %, la valeur avant correction, 384,16, descend à \(384{,}16 \div (1 + 383{,}16 \div 1000) \approx 277{,}7\) (278 personnes après arrondi).
En fixant à l’avance combien de réponses suffisent pour la précision voulue, avant d’enchaîner les relances auprès de tout le monde, vous arbitrez en chiffres entre le coût et la précision de l’enquête.
Cette formule sert aussi à estimer le taux de défauts de pièces produites en grande série sans toutes les contrôler. Si l’historique indique un taux de défauts d’environ 10 %, un niveau de confiance de 90 % et une marge d’erreur de ± 4 % donnent \(1{,}65^2 \times 0{,}1 \times 0{,}9 \div 0{,}04^2 \approx 153{,}1\) : un échantillon d’environ 154 pièces suffit.
L’exemple montre aussi que plus la proportion s’éloigne de 50 %, plus la dispersion \(\hat{p}(1-\hat{p})\) est petite, et moins il faut de pièces.
Dans une étude épidémiologique sur « la part des habitants d’une région qui présentent ce symptôme », le protocole doit indiquer le nombre de participants nécessaire. Si des études antérieures suggèrent une prévalence d’environ 20 %, un niveau de confiance de 95 % et une marge d’erreur de ± 3 % donnent \(1{,}96^2 \times 0{,}2 \times 0{,}8 \div 0{,}03^2 \approx 683{,}0\), soit environ 683 personnes.
La recherche clinique utilise aussi des méthodes plus précises adaptées au type d’étude (calcul de puissance, par exemple). Cette formule est la forme de base dont elles partent.
L’audience de la télévision est estimée à partir d’un panel de foyers, pas de tous les foyers. Exemple simplifié (les vraies méthodes de mesure sont plus complexes) : un panel de 2 700 foyers et une émission regardée par 10 % d’entre eux. Au niveau de confiance de 95 %, la marge d’erreur vaut \(1{,}96 \times \sqrt{0{,}1 \times 0{,}9 \div 2700} \approx 0{,}0113\) (environ ± 1,1 %).
Vous verrez alors que « l’écart entre 9,5 % et 10,5 % d’audience est peut-être dans la marge d’erreur », et vous lirez les chiffres de l’actualité avec un peu plus de recul.
Formule
Symboles et termes
Symboles
| \(n\) | n | La taille d’échantillon. Pour une enquête, c’est le nombre de personnes dont on recueille les réponses ; pour un contrôle, le nombre de pièces vérifiées. |
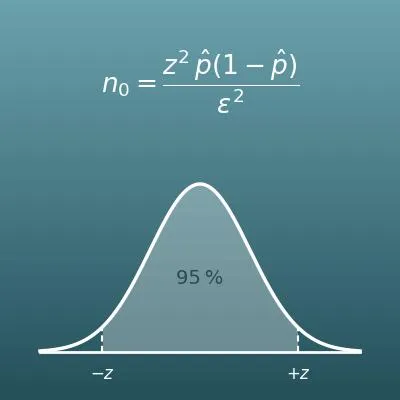
| \(n_0\) | n indice zéro | La taille d’échantillon nécessaire calculée en considérant la population comme très grande. C’est la valeur avant la correction pour population finie. |
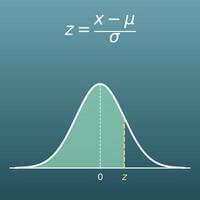
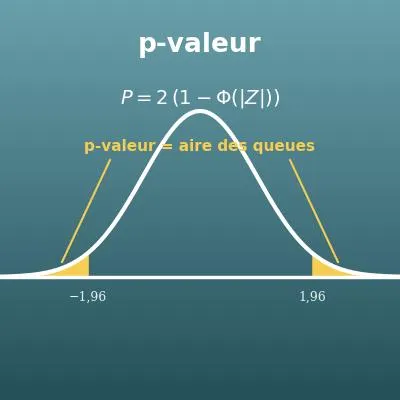
| \(z\) | z | Le score z (une valeur de la loi normale centrée réduite) associé au niveau de confiance. Les valeurs usuelles sont 1,96 pour 95 % et 2,58 pour 99 %. |
| \(\hat{p}\) | p chapeau | La proportion (la part de « oui » que l’on cherche, par exemple). Pour trouver la taille d’échantillon, on met la valeur attendue ; pour trouver la marge d’erreur, la proportion réellement obtenue dans l’enquête (la fréquence observée dans l’échantillon). Elle s’écrit en décimal entre 0 et 1 (0,5 pour 50 %). |
| \(\varepsilon\) | epsilon | La marge d’erreur : l’écart qu’on accepte entre le résultat de l’enquête et la vraie valeur. On l’écrit avec ±, comme « ± 5 % ». |
| \(N\) | N majuscule | La taille de la population : le nombre de personnes ou d’objets de tout le groupe étudié (exemple : les 500 salariés d’une entreprise). |
Termes
| population | Tout l’ensemble sur lequel on veut vraiment savoir quelque chose, comme « tous les électeurs du pays » ou « les 500 salariés de l’entreprise ». |
| échantillon | La partie de la population qu’on choisit pour l’étudier réellement. Le nombre de personnes ou d’objets de l’échantillon s’appelle la taille d’échantillon. |
| échantillonnage aléatoire | Choisir l’échantillon de façon que chaque membre de la population ait la même chance d’être tiré, comme par tirage au sort. Les formules de cette page supposent un échantillonnage aléatoire : elles ne valent pas pour une enquête où seuls répondent ceux qui le veulent. |
| proportion | La part que l’on veut vraiment connaître, comme la part de « oui » dans toute la population. La part obtenue sur un échantillon s’appelle la fréquence observée, pour bien les distinguer. |
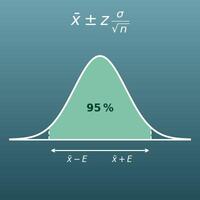
| niveau de confiance | Le degré de certitude : si l’on répétait la même enquête de nombreuses fois, le pourcentage de fois où le résultat resterait dans la marge d’erreur. 95 % est le plus utilisé. |
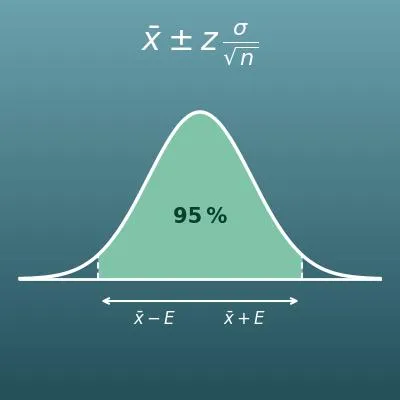
| intervalle de confiance | L’intervalle obtenu quand on donne un résultat d’enquête avec une certaine largeur, comme « 52 % ± 3 % (de 49 % à 55 %) ». La marge d’erreur ±ε de cette page correspond à cette largeur. |
| marge d’erreur | L’écart qu’on accepte entre le résultat de l’enquête et la vraie valeur. C’est ce que les sondages dans les médias appellent « une marge d’erreur de ± 3 points ». |
| correction pour population finie | Une correction qui réduit la taille d’échantillon nécessaire ou la marge d’erreur quand on sait que la population a une taille limitée. Elle traduit le fait que plus on étudie une grande part de la population, plus le résultat est sûr. |
Ce qu’il est utile de savoir avant de commencer
Voici ce qui vous aide à utiliser le calcul de cette page en le comprenant vraiment, et pas seulement en appuyant sur le bouton.
| Pourcentages et proportions (CM2-6e, 10-12 ans) |
|
| Racines carrées (4e-3e, 13-15 ans) |
|
| Échantillonnage (2de, 15-16 ans) |
|
| La loi normale et l’estimation (lycée ou études supérieures, 17 ans et plus) |
|
Calculer avec Excel
| Score z (1,96 pour 95 %) | 1,96 |
| Proportion attendue (%) | 50 |
| Marge d’erreur (%) | 5 |
| Valeur calculée n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Taille d’échantillon nécessaire (arrondie au-dessus) | =ARRONDI.SUP(B4;0) |
| Score z (1,96 pour 95 %) | 1,96 |
| Proportion attendue (%) | 50 |
| Marge d’erreur (%) | 5 |
| Taille de la population N | 500 |
| Valeur avant correction n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Taille d’échantillon nécessaire (corrigée, arrondie au-dessus) | =ARRONDI.SUP(B5/(1+(B5-1)/B4);0) |
| Score z (1,96 pour 95 %) | 1,96 |
| Proportion obtenue dans l’enquête (%) | 60 |
| Taille d’échantillon n | 100 |
| Marge d’erreur (%) | =B1*RACINE(B2/100*(1-B2/100)/B3)*100 |
| Score z (1,96 pour 95 %) | 1,96 |
| Proportion obtenue dans l’enquête (%) | 30 |
| Taille d’échantillon n | 200 |
| Taille de la population N | 1000 |
| Marge d’erreur avant correction (%) | =B1*RACINE(B2/100*(1-B2/100)/B3)*100 |
| Marge d’erreur corrigée (%) | =B5*RACINE((B4-B3)/(B4-1)) |
Dans le premier tableau, B4 affiche 384,16 et B5 affiche 385. Le résultat du deuxième tableau est 218, celui du troisième environ 9,60 (%) et celui du quatrième environ 5,68 (%).
« ^ » est une puissance (au carré), « RACINE » la racine carrée et « ARRONDI.SUP » la fonction qui arrondit vers le haut.
Attention : le calculateur de cette page ajoute 1 par prudence même quand la valeur calculée tombe juste sur un entier ; pour ces valeurs rondes, il peut donc y avoir 1 d’écart avec ARRONDI.SUP d’Excel.
Calculer avec Google Sheets
| Score z (1,96 pour 95 %) | 1,96 |
| Proportion attendue (%) | 50 |
| Marge d’erreur (%) | 5 |
| Valeur calculée n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Taille d’échantillon nécessaire (arrondie au-dessus) | =ARRONDI.SUP(B4;0) |
| Score z (1,96 pour 95 %) | 1,96 |
| Proportion attendue (%) | 50 |
| Marge d’erreur (%) | 5 |
| Taille de la population N | 500 |
| Valeur avant correction n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Taille d’échantillon nécessaire (corrigée, arrondie au-dessus) | =ARRONDI.SUP(B5/(1+(B5-1)/B4);0) |
| Score z (1,96 pour 95 %) | 1,96 |
| Proportion obtenue dans l’enquête (%) | 60 |
| Taille d’échantillon n | 100 |
| Marge d’erreur (%) | =B1*RACINE(B2/100*(1-B2/100)/B3)*100 |
| Score z (1,96 pour 95 %) | 1,96 |
| Proportion obtenue dans l’enquête (%) | 30 |
| Taille d’échantillon n | 200 |
| Taille de la population N | 1000 |
| Marge d’erreur avant correction (%) | =B1*RACINE(B2/100*(1-B2/100)/B3)*100 |
| Marge d’erreur corrigée (%) | =B5*RACINE((B4-B3)/(B4-1)) |
Calculer avec Python
import math

# Table rapide niveau de confiance (%) → score z (valeurs arrondies usuelles)
z_table = {80: 1.28, 85: 1.44, 90: 1.65, 95: 1.96, 98: 2.33, 99: 2.58}

# ---- Façon 1 : trouver la taille d’échantillon nécessaire ----
confidence_level = 95    # niveau de confiance (%)
population_ratio = 50    # proportion attendue (%)
margin_of_error = 5      # marge d’erreur (%)
population_size = None   # taille de la population (None si inconnue ou très grande)

z = z_table[confidence_level]
p = population_ratio / 100
e = margin_of_error / 100

raw_size = z ** 2 * p * (1 - p) / e ** 2   # valeur avant correction
if population_size is not None:
    raw_size = raw_size / (1 + (raw_size - 1) / population_size)   # correction pour population finie
required_size = math.floor(raw_size) + 1   # plus petit entier au-dessus de la valeur calculée (arrondi vers le haut par prudence)
print(f"Taille d’échantillon nécessaire : {required_size}")

# ---- Façon 2 : trouver la marge d’erreur ----
sample_size = 1000       # taille de l’échantillon réellement interrogé
sample_ratio = 50 / 100  # proportion obtenue dans l’enquête (0.5 pour 50 %)

error_ratio = z * math.sqrt(sample_ratio * (1 - sample_ratio) / sample_size)
print(f"Marge d’erreur : ±{error_ratio * 100:.2f} %")
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
n₀ = z² × p̂(1 − p̂) ÷ ε²
n_0 = \dfrac{z^2 \, \hat{p}(1-\hat{p})}{\varepsilon^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>n</mi><mn>0</mn></msub>
<mo>=</mo>
<mfrac>
<mrow>
<msup><mi>z</mi><mn>2</mn></msup>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<msup><mi>ε</mi><mn>2</mn></msup>
</mfrac>
</mrow>
</math>
n_0 = (z^2 hat(p)(1 - hat(p)))/(epsilon^2)
z^2*p*(1 - p)/err^2
n0 := z^2*p*(1 - p)/err^2;
n0 = z^2*p*(1 - p)/err^2;
n_0 = (z^2 p̂(1 − p̂))/ε^2
n = n₀ ÷ (1 + (n₀ − 1) ÷ N)
n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msub><mi>n</mi><mn>0</mn></msub>
<mrow>
<mn>1</mn><mo>+</mo>
<mfrac>
<mrow><msub><mi>n</mi><mn>0</mn></msub><mo>−</mo><mn>1</mn></mrow>
<mi>N</mi>
</mfrac>
</mrow>
</mfrac>
</mrow>
</math>
n = n_0/(1 + (n_0 - 1)/N)
n0/(1 + (n0 - 1)/nPop)
n := n0/(1 + (n0 - 1)/N);
n = n0/(1 + (n0 - 1)/N);
n = n_0/(1 + (n_0 − 1)/N)
ε = z × √(p̂(1 − p̂) ÷ n)
\varepsilon = z \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<mi>z</mi>
<msqrt>
<mfrac>
<mrow>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<mi>n</mi>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = z sqrt((hat(p)(1 - hat(p)))/n)
z*Sqrt[p*(1 - p)/n]
err := z*sqrt(p*(1 - p)/n);
err = z*sqrt(p*(1 - p)/n);
ε = z√((p̂(1 − p̂))/n)
ε = ε₀ × √((N − n) ÷ (N − 1))
\varepsilon = \varepsilon_0 \sqrt{\dfrac{N-n}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<msub><mi>ε</mi><mn>0</mn></msub>
<msqrt>
<mfrac>
<mrow><mi>N</mi><mo>−</mo><mi>n</mi></mrow>
<mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = epsilon_0 sqrt((N - n)/(N - 1))
err0*Sqrt[(nPop - n)/(nPop - 1)]
err := err0*sqrt((N - n)/(N - 1));
err = err0*sqrt((N - n)/(N - 1));
ε = ε_0 √((N − n)/(N − 1))
Faire faire le calcul par ChatGPT
Tu es un assistant de calcul pour les enquêtes statistiques. Fais le calcul suivant en exécutant réellement du code Python, et appuie ta réponse uniquement sur les nombres obtenus à l’exécution (ne réponds pas de tête ni par estimation).

Un service qui compte 1 000 adhérents mène une enquête de satisfaction. On prend un niveau de confiance de 95 % (score z 1,96), une proportion attendue de 50 % et une marge d’erreur de ± 5 %.
Calcule chacun des éléments suivants :
1. La taille d’échantillon nécessaire en considérant la population comme très grande (valeur calculée et nombre de personnes après arrondi vers le haut)
2. La taille d’échantillon nécessaire avec la correction pour population finie, pour une population de 1 000
3. La marge d’erreur (avec la correction pour population finie, en %) si seulement 200 personnes répondent

Montre les formules utilisées et les nombres obtenus à l’exécution. Réponds en français, avec la virgule comme séparateur décimal.
Mode d'emploi
-
1Saisissez vos nombresTapez les nombres à calculer dans les champs de saisie
-
2CalculezAppuyez sur le bouton « Calculer »
-
3Lisez le résultatLe résultat s’affiche aussitôt. La même page explique aussi le raisonnement et la formule
Les atouts de DataChef

Aucune compétence requise – simple et intuitif

Aucune donnée personnelle nécessaire

Le fichier est supprimé automatiquement après le téléchargement


Aucune mention de crédit nécessaire

Aucune autorisation préalable nécessaire
Fonctions connexes
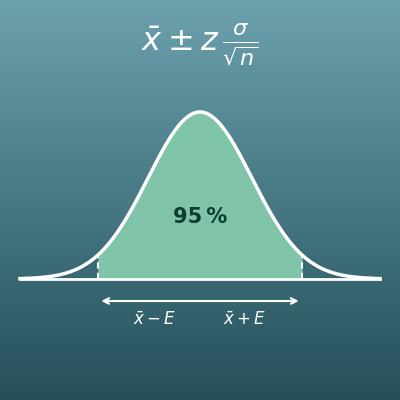
Calcul d’un intervalle de confiance pour une moyenne
Calcule un intervalle de confiance (à 95 %, par exemple) pour une moyenne
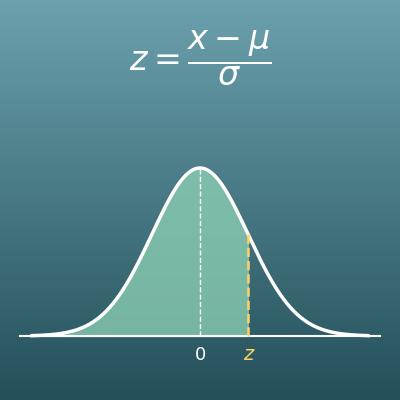
Calcul du score z : du score z à la probabilité et inversement
Calcule le score z à partir d’une valeur, de la moyenne et de l’écart-type, et le convertit en probabilité et inversement

Calcul de probabilité avec la loi normale
À partir de la moyenne et de l’écart-type, calcule la probabilité de tomber dans un intervalle donné