



























































































Remplissez un seul champ, soit Z (la statistique de test), soit l’une des cinq probabilités. Toutes les autres valeurs sont calculées (la conversion marche dans les deux sens, de Z à la p-valeur et de la p-valeur à Z).
Table des matières
-
Ce que vous pouvez faire sur cette page
-
À quoi sert ce calcul ?
-
Mode d'emploi
-
Formule et graphique
-
Symboles et termes
-
Ce qu’il est utile de savoir avant de commencer
-
Calculer avec Excel
-
Calculer avec Google Sheets
-
Calculer avec Python
-
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
-
Faire faire le calcul par ChatGPT
-
Les atouts de DataChef
-
Fonctions connexes
-
Liste des calculatrices NumberChef
Ce que vous pouvez faire sur cette page
- Entrez la statistique de test Z d’un test Z (ou d’un test semblable) et obtenez d’un coup les p-valeurs des tests unilatéral à gauche, unilatéral à droite et bilatéral
- Vous pouvez aussi remonter d’une p-valeur à Z (par exemple, trouver Z = 1,96 pour une p-valeur bilatérale de 0,05). Pratique pour trouver la limite de la région de rejet (la valeur critique)
- Les probabilités « entre 0 et Z » et « entre −Z et Z » s’affichent aussi : le calculateur remplace donc la table de la loi normale centrée réduite
- Une explication simple des formules et des formules à copier-coller pour Excel, Google Sheets et Python sont réunies sur cette page
À quoi sert ce calcul ?
Les essais cliniques d’un nouveau médicament utilisent un test d’hypothèse pour vérifier si « la différence entre le groupe traité et le groupe non traité relève du hasard », et la p-valeur sert d’élément de décision. Par exemple, une statistique de test \(Z = 2{,}5\) donne une p-valeur bilatérale d’environ 0,012, qui se lit « si le médicament n’avait aucun effet, la probabilité d’observer une différence aussi grande serait d’environ 1,2 % ».
Les publications médicales du monde entier présentent leurs résultats de cette façon. Savoir ce qu’est une p-valeur permet de lire l’actualité santé avec plus de recul (les vraies décisions médicales sont prises par des experts qui tiennent compte non seulement de la p-valeur, mais aussi de l’ampleur de l’effet et des effets indésirables).
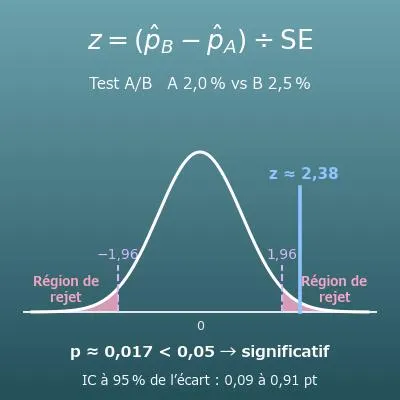
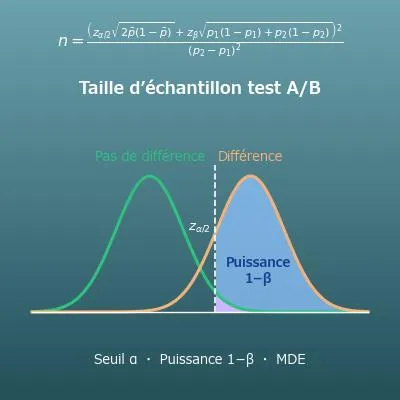
« On a changé la couleur du bouton et le taux de clic a augmenté. Mais n’est-ce pas le hasard ? » C’est à cela que répond le test d’un test A/B. Par exemple, une statistique de test \(Z = 2{,}17\) donne une p-valeur bilatérale d’environ 0,03, plus petite que le seuil de signification de 0,05 : on peut conclure à « une amélioration difficile à expliquer par le hasard ».
Les entreprises du web utilisent cette p-valeur tous les jours pour décider d’adopter ou non un changement de design ou de texte.
On teste, avec les données des contrôles par prélèvement, si la masse ou la dimension moyenne des produits s’est éloignée de la cible. Par exemple, une statistique de test \(Z = 2\) donne une p-valeur bilatérale d’environ 0,046 : au seuil de 5 %, on conclut que « quelque chose a changé dans le procédé » et on en cherche la cause.
La force de la p-valeur est de séparer « la variation due au hasard » d’« un vrai problème » : la décision d’arrêter une machine se prend avec des chiffres, pas au jugé.
Les articles scientifiques regorgent de formules comme « significatif à p < 0,05 » ou « p = 0,003 ». Dans un test bilatéral, p < 0,05 correspond à « \(|Z|\) dépasse 1,96 », et p < 0,01 à « dépasse environ 2,58 ».
Connaître ce lien aide à présenter correctement des résultats statistiques dans un mémoire ou un rapport, et à garder en tête un point clé pour lire les articles : « significatif » ne veut pas toujours dire important (l’ampleur de la différence est une autre question).
Un test d’hypothèse permet aussi de vérifier si un changement comme « la cote de popularité gagne 2 points en un mois » est un vrai changement ou seulement la variation (l’erreur) du sondage. Par exemple, une statistique de test \(Z = 1\) donne une p-valeur bilatérale d’environ 0,32 : « environ 1 fois sur 3 par hasard, même sans vraie différence ». Il est donc naturel de dire que c’est dans la marge d’erreur.
C’est une façon de penser statistique, simple et utile au quotidien : avant de s’enthousiasmer ou de s’inquiéter pour un chiffre de l’actualité, se demander « cet écart est-il significatif ? ».
Formule et graphique
Symboles et termes
Symboles
| \(P\) | p | La p-valeur : la probabilité d’obtenir par hasard un résultat au moins aussi extrême que celui observé, en supposant l’hypothèse nulle vraie. Plus elle est petite, plus le résultat est difficile à expliquer par le hasard. |
| \(Z\) | Z | La statistique de test (la valeur z), calculée à partir des données et considérée comme suivant la loi normale centrée réduite. Cette page calcule la p-valeur à partir de Z. Le calcul du score z lui-même se trouve dans la page liée « Calcul du score z ». |
| \(\Phi(Z)\) | phi de Z | La fonction de répartition de la loi normale centrée réduite (moyenne 0, écart-type 1). Elle donne la probabilité d’une valeur inférieure à \(Z\), c’est-à-dire l’aire sous la courbe à gauche de \(Z\). |
| \(\Phi^{-1}\) | phi moins un (réciproque de Φ) | La fonction réciproque de \(\Phi\) : à partir d’une probabilité (une aire), elle donne le Z correspondant. Ce calculateur l’utilise pour remonter d’une p-valeur à Z. (Exemple : \(\Phi^{-1}(0{,}975) \approx 1{,}96\)) |
| \(|Z|\) | valeur absolue de Z | La taille de \(Z\) sans son signe. Un test bilatéral compte un dépassement du côté positif ou du côté négatif comme le même « degré d’extrême » : il utilise donc la valeur absolue. (Exemple : \(|-1{,}5| = 1{,}5\)) |
| \(\alpha\) | alpha | Le seuil de signification (ou risque α) : la probabilité limite fixée à l’avance, du type « on rejette l’hypothèse nulle si la p-valeur est inférieure ou égale à ce seuil ». Par convention, on prend souvent 0,05 (5 %) ou 0,01 (1 %). |
Termes
| p-valeur (valeur p) | La probabilité d’obtenir un résultat au moins aussi extrême que celui observé, en supposant l’hypothèse nulle vraie. Plus la p-valeur est petite, plus il est difficile de croire que le résultat est dû au hasard, et plus on a de raisons de rejeter l’hypothèse nulle. |
| test d’hypothèse | Une démarche qui suppose d’abord « il n’y a pas de différence », mesure avec une p-valeur à quel point les données observées seraient improbables sous cette hypothèse, et décide s’il faut l’abandonner (on dit aussi test statistique). Le raisonnement ressemble à un raisonnement par l’absurde : si quelque chose de très rare s’est produit, on doute de l’hypothèse de départ. |
| hypothèse nulle | L’hypothèse par défaut que l’on cherche à mettre en défaut, notée \(H_0\), comme « il n’y a pas de différence entre les deux groupes » ou « il n’y a pas d’effet ». La p-valeur se calcule en supposant que l’hypothèse nulle est vraie. Son contraire est l’hypothèse alternative. |
| hypothèse alternative | L’affirmation opposée à l’hypothèse nulle, notée \(H_1\) (« il y a une différence », « il y a un effet »). C’est l’hypothèse retenue quand l’hypothèse nulle est rejetée. |
| seuil de signification | La probabilité limite pour rejeter l’hypothèse nulle, notée \(\alpha\) (alpha) ; on parle aussi de niveau de signification ou de risque α. La règle est de le fixer avant de faire le test, et 0,05 est le plus répandu. Si la p-valeur est inférieure ou égale au seuil, le résultat est dit « statistiquement significatif ». |
| rejeter | Abandonner l’hypothèse nulle parce que le test la rend « difficile à croire ». On la rejette quand la p-valeur est inférieure ou égale au seuil de signification. Attention : ne pas pouvoir la rejeter ne veut pas dire « l’hypothèse nulle est vraie », seulement « il n’y a pas assez d’éléments pour la rejeter ». |
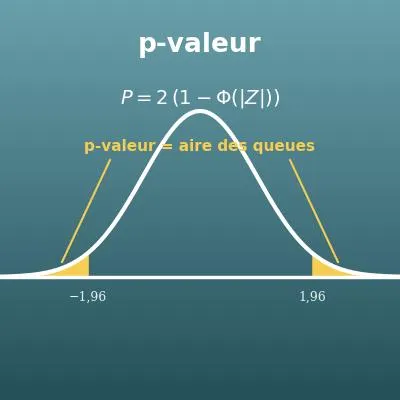
| test bilatéral | Un test qui considère un écart dans un sens ou dans l’autre, trop grand ou trop petit, comme une différence. La p-valeur est la somme des aires des deux extrémités de la loi. C’est le choix habituel quand on ne peut pas fixer le sens à l’avance. |
| test unilatéral | Un test qui ne regarde les écarts que dans un seul sens, seulement plus grand (à droite) ou seulement plus petit (à gauche). On l’utilise quand la théorie fixe le sens à l’avance, et la p-valeur est l’aire d’une seule extrémité. |
| statistique de test | La valeur calculée à partir des données pour faire le test. Dans un test Z, on la met sous une forme qui suit la loi normale centrée réduite (la valeur z), qui indique à combien d’écarts-types le résultat se trouve de la moyenne. |
| loi normale centrée réduite | La loi normale de moyenne 0 et d’écart-type 1 (une courbe en cloche symétrique). L’aire sous la courbe représente la probabilité, et l’aire totale vaut exactement 1. La p-valeur d’un test Z se calcule comme l’aire des extrémités de cette loi. |
| valeur critique | La valeur limite de la statistique de test au-delà de laquelle on rejette l’hypothèse nulle. Pour un test bilatéral au seuil de 5 %, c’est \(|Z| \approx 1{,}96\) ; à 1 %, \(|Z| \approx 2{,}576\). Vous pouvez le vérifier en remontant d’une p-valeur à Z avec ce calculateur. |
Ce qu’il est utile de savoir avant de commencer
Voici ce qui vous aide à utiliser le calcul de cette page en le comprenant vraiment, et pas seulement en appuyant sur le bouton.
| Les bases des probabilités (5e-3e, 12-15 ans) |
|
| Statistiques et écart-type (2de, 15-16 ans) |
|
| La loi normale et la lecture d’aires (lycée ou études supérieures, 17 ans et plus) |
|
| Le principe d’un test d’hypothèse (études supérieures, 18 ans et plus) |
|
Calculer avec Excel
| Z (statistique de test) | -1,5 |
| À gauche P(x<Z) | =LOI.NORMALE.STANDARD.N(B1;VRAI) |
| Z (statistique de test) | 2 |
| À droite P(x>Z) | =1-LOI.NORMALE.STANDARD.N(B1;VRAI) |
| Z (statistique de test) | 1,96 |
| P-valeur bilatérale | =2*(1-LOI.NORMALE.STANDARD.N(ABS(B1);VRAI)) |
« LOI.NORMALE.STANDARD.N(valeur;VRAI) » correspond à la fonction de répartition \(\Phi\) (l’aire à gauche de Z), et VRAI lui demande de « renvoyer la valeur cumulée (l’aire à gauche) ». « ABS » donne la valeur absolue (la taille sans le signe).
Le premier tableau affiche environ 0,0668 (environ 6,7 %) en B2, le deuxième environ 0,02275 (environ 2,3 %) et le troisième environ 0,05 (5 %). Il suffit de remplacer B1 par votre propre Z.
Pour aller dans l’autre sens, « d’une p-valeur à Z », utilisez « =LOI.NORMALE.STANDARD.INVERSE.N(probabilité) » (exemple : le Z d’une p-valeur bilatérale de 0,05 est `=LOI.NORMALE.STANDARD.INVERSE.N(1-0,05/2)`, environ 1,95996).
Calculer avec Google Sheets
| Z (statistique de test) | -1,5 |
| À gauche P(x<Z) | =LOI.NORMALE.STANDARD(B1) |
| Z (statistique de test) | 2 |
| À droite P(x>Z) | =1-LOI.NORMALE.STANDARD(B1) |
| Z (statistique de test) | 1,96 |
| P-valeur bilatérale | =2*(1-LOI.NORMALE.STANDARD(ABS(B1))) |
Les résultats sont les mêmes que dans Excel : environ 0,0668 dans le premier tableau, environ 0,02275 dans le deuxième et environ 0,05 dans le troisième.
Pour trouver Z à partir d’une p-valeur, utilisez « =LOI.NORMALE.STANDARD.INVERSE(probabilité) » (exemple : `=LOI.NORMALE.STANDARD.INVERSE(1-0,05/2)` vaut environ 1,95996).
Calculer avec Python
import math

def phi(z):
    # Fonction de répartition de la loi normale centrée réduite, Φ(z) (calculée avec la fonction d’erreur erf)
    return 0.5 * (1 + math.erf(z / math.sqrt(2)))

z = 1.96  # Z (statistique de test)

p_left = phi(z)                       # p-valeur à gauche P(x<Z)
p_right = 1 - phi(z)                  # p-valeur à droite P(x>Z)
p_two_sided = 2 * (1 - phi(abs(z)))   # p-valeur bilatérale

print(f"p-valeur à gauche : {p_left}")
print(f"p-valeur à droite : {p_right}")
print(f"p-valeur bilatérale : {p_two_sided}")
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
P = Φ(Z)
P = \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P = Phi(Z)
CDF[NormalDistribution[0, 1], z]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), z);
p = normcdf(z);
P = Φ(Z)
P = 1 − Φ(Z)
P = 1 - \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mn>1</mn>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P = 1 - Phi(Z)
1 - CDF[NormalDistribution[0, 1], z]
with(Statistics): 1 - CDF(RandomVariable(Normal(0, 1)), z);
p = 1 - normcdf(z);
P = 1 - Φ(Z)
P = 2(1 − Φ(|Z|))
P = 2\left(1 - \Phi(|Z|)\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mn>2</mn>
<mo>(</mo>
<mn>1</mn>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>Z</mi><mo>|</mo><mo>)</mo>
<mo>)</mo>
</mrow>
</math>
P = 2(1 - Phi(|Z|))
2 (1 - CDF[NormalDistribution[0, 1], Abs[z]])
with(Statistics): 2*(1 - CDF(RandomVariable(Normal(0, 1)), abs(z)));
p = 2*(1 - normcdf(abs(z)));
P = 2(1 - Φ(|Z|))
Faire faire le calcul par ChatGPT
Tu es un assistant de calcul en statistique. Fais le calcul suivant en exécutant réellement du code Python, et appuie ta réponse uniquement sur les nombres obtenus à l’exécution (ne réponds pas de tête ni par estimation).

Un test Z a donné une statistique de test Z = 2,5. On suppose que la statistique de test suit la loi normale centrée réduite (tu peux utiliser la bibliothèque standard de Python, comme math.erf ou statistics.NormalDist).
Calcule chacun des éléments suivants :
1. La p-valeur à gauche P(x<Z)
2. La p-valeur à droite P(x>Z)
3. La p-valeur bilatérale P(x<−Z ou x>Z)
4. Si l’on peut rejeter l’hypothèse nulle dans un test bilatéral au seuil de signification de 0,05

Montre les formules utilisées et les nombres obtenus à l’exécution. Réponds en français, avec la virgule comme séparateur décimal.
Mode d'emploi
-
1Saisissez vos nombresTapez les nombres à calculer dans les champs de saisie
-
2CalculezAppuyez sur le bouton « Calculer »
-
3Lisez le résultatLe résultat s’affiche aussitôt. La même page explique aussi le raisonnement et la formule
Les atouts de DataChef

Aucune compétence requise – simple et intuitif

Aucune donnée personnelle nécessaire

Le fichier est supprimé automatiquement après le téléchargement


Aucune mention de crédit nécessaire

Aucune autorisation préalable nécessaire
Fonctions connexes
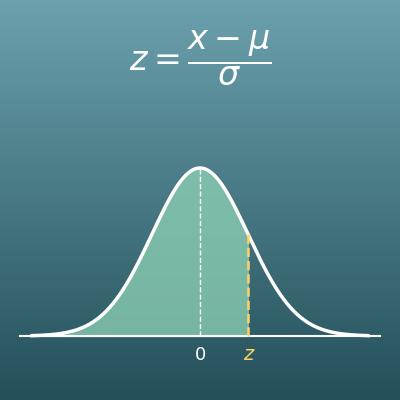
Calcul du score z : du score z à la probabilité et inversement
Calcule le score z à partir d’une valeur, de la moyenne et de l’écart-type. Remplace aussi la table de la loi normale

Calcul de probabilité avec la loi normale
À partir de la moyenne et de l’écart-type, calcule la probabilité de tomber dans un intervalle ou d’être dans le haut du classement