



























































































Trois façons d’utiliser ce calculateur. ① Trouver le score z à partir d’une valeur, de la moyenne et de l’écart-type. ② Passer d’un score z à une probabilité ou l’inverse (un seul champ à remplir). ③ Trouver la probabilité entre deux scores z. Remplissez uniquement les champs du groupe choisi.
Table des matières
-
Ce que vous pouvez faire sur cette page
-
À quoi sert ce calcul ?
-
Mode d'emploi
-
Formule et graphique
-
Symboles et termes
-
Ce qu’il est utile de savoir avant de commencer
-
Calculer avec Excel
-
Calculer avec Google Sheets
-
Calculer avec Python
-
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
-
Faire faire le calcul par ChatGPT
-
Les atouts de DataChef
-
Fonctions connexes
-
Liste des calculatrices NumberChef
Ce que vous pouvez faire sur cette page
- Entrez une valeur \(x\), la moyenne \(\mu\) et l’écart-type \(\sigma\) : vous obtenez d’un coup le score z et la probabilité d’avoir une valeur plus petite
- Au lieu de chercher dans la table de la loi normale centrée réduite, passez du score z à la probabilité, ou de la probabilité au score z
- Calculez aussi tout de suite la probabilité entre deux scores z (par exemple entre −1,96 et 1,96)
- Une explication simple des formules et des formules à copier-coller pour Excel, Google Sheets et Python sont réunies sur cette page
À quoi sert ce calcul ?
À un examen de moyenne 65 et d’écart-type 5, une note de 75 donne \(z = 2\). Si les notes suivent une loi normale, vous êtes dans les 2,3 % du haut environ (\(1 - \Phi(2) \approx 0{,}0228\)), soit à peu près le 97,7e percentile. Le QI est construit directement à partir des scores z (QI \(= 100 + 15 \times z\)) : un QI de 130 correspond à la même position.
C’est l’usage le plus courant du score z : transformer une note brute en rang, et mesurer ce que vaut vraiment un écart de quelques points, même entre des épreuves de barèmes et de moyennes différents.
« 80 en anglais (moyenne 70, écart-type 10) » et « 65 en maths (moyenne 50, écart-type 15) » : en notes brutes, l’anglais semble meilleur, mais en scores z, les deux valent \(z = 1\), la même position.
Même quand les unités, les barèmes ou la sévérité de la correction diffèrent, le score z permet de comparer équitablement « à quel point on est au-dessus du groupe ». La même idée sert à harmoniser des notes entre correcteurs ou entre épreuves, et à normaliser des évaluations en entreprise.
Certaines courbes de croissance, comme celles de l’OMS, situent la taille et le poids d’un enfant en écarts-types, notés DS (« déviation standard ») : c’est exactement un score z, qui dit à combien d’écarts-types l’enfant se trouve de la moyenne.
Environ 2,3 % des enfants se trouvent au-delà de chacune des lignes ±2 DS (\(z = \pm 2\)). Ces lignes, qui correspondent aux 2,3e et 97,7e percentiles, font partie des repères qu’utilise le médecin pour décider de surveiller la croissance (les enfants ne grandissent pas tous au même rythme, et c’est l’évolution de la courbe qui compte). Savoir ce que veut dire la ligne « −2 DS » aide à suivre les explications lors des visites médicales.
Les dimensions et les masses des produits varient souvent de façon proche d’une loi normale : en transformant les tolérances haute et basse en scores z, on estime le taux de défauts. Si les tolérances sont à la moyenne \(\pm 3\sigma\), environ 0,3 % des pièces sont hors tolérance (\(2 \times (1 - \Phi(3)) \approx 0{,}0027\)).
Le nom de la démarche qualité « Six Sigma » vient lui aussi de cette idée (combien de σ).
Les banques et les sociétés de gestion mesurent le risque de pertes sur leurs actifs avec un indicateur appelé valeur en risque (VaR). Si l’on suppose que les rendements suivent une loi normale, la limite « la perte reste en deçà avec une probabilité de 99 % » correspond au score z \(\Phi^{-1}(0{,}99) \approx 2{,}33\), soit 2,33 écarts-types de la moyenne.
Cette conversion « probabilité vers score z » est à la base des calculs de risque des institutions financières du monde entier.
Formule et graphique
Symboles et termes
Symboles
| \(z\) | z (score z) | Un nombre qui indique à combien d’écarts-types une valeur se trouve de la moyenne, obtenu par \(z = (x - \mu) \div \sigma\). Positif, la valeur est au-dessus de la moyenne ; négatif, en dessous. Sur cette page, un score z que vous choisissez vous-même, comme en ② et ③, s’écrit avec un \(Z\) majuscule. |
| \(x\) | x | La valeur mesurée, comme une note ou une taille. C’est la valeur de départ que l’on veut transformer en score z. |
| \(\mu\) | mu | La moyenne. C’est la position du centre du pic de la courbe. Une lettre grecque qui correspond au m latin. |
| \(\sigma\) | sigma | L’écart-type, la taille de la dispersion des données. Plus il est grand, plus le pic est bas et large. Une lettre grecque qui correspond au s latin. |
| \(\Phi(Z)\) | phi de Z | La fonction de répartition de la loi normale centrée réduite (moyenne 0, écart-type 1). Elle donne la probabilité d’une valeur inférieure à \(Z\), c’est-à-dire l’aire sous la courbe à gauche de \(Z\). |
| \(\Phi^{-1}\) | phi moins un (réciproque de Φ) | La fonction qui fait le chemin inverse de \(\Phi\) : à partir d’une probabilité (une aire), elle donne le score z correspondant. (Exemple : \(\Phi^{-1}(0{,}975) \approx 1{,}96\)) |
| \(Z_1,\ Z_2\) | Z indice 1, Z indice 2 | Les deux scores z que vous saisissez en ③. \(Z_1\) est la borne de gauche (la plus petite), \(Z_2\) celle de droite (la plus grande). |
Termes
| score z | Un nombre sans unité qui indique à combien d’écarts-types une valeur se trouve de la moyenne (on dit aussi valeur centrée réduite, ou cote z au Québec). Son grand atout : il place sur la même règle graduée des données d’unités ou de barèmes différents. |
| centrer-réduire | Transformer une valeur en score z : on retire la moyenne, puis on divise par l’écart-type. Une fois centrées et réduites, les données de n’importe quelle loi normale se traitent avec la seule loi normale centrée réduite, de moyenne 0 et d’écart-type 1. |
| loi normale centrée réduite | La loi normale de moyenne 0 et d’écart-type 1, notée \(\mathcal{N}(0\,;\,1)\). C’est la loi des scores z, qui sert de règle graduée commune pour les calculs de probabilités avec n’importe quelle loi normale. |
| loi normale | Une loi dont la courbe est en cloche, symétrique autour de la moyenne (on dit aussi loi de Gauss). Beaucoup de données réelles, comme des notes, des tailles ou des masses de produits, ont une forme proche de celle-ci. |
| fonction de répartition | La fonction qui donne la probabilité d’obtenir une valeur inférieure ou égale à celle-ci. Pour la loi normale centrée réduite, on la note \(\Phi\) (phi). Elle cumule l’aire à gauche de la courbe. |
| table de la loi normale | Un tableau qui donne, pour chaque score z, la valeur (l’aire) de \(\Phi\) correspondante (table de la loi normale centrée réduite). On la trouve à la fin des manuels de statistique. La façon ② de cette page peut la remplacer. |
| note T | Un score z remis à l’échelle pour que la moyenne soit 50 et qu’un écart-type vaille 10 (note T \(= 50 + 10 \times z\)). On la rencontre dans certains tests psychologiques. Le QI fonctionne de la même façon, avec une moyenne de 100 et 15 points par écart-type. |
Ce qu’il est utile de savoir avant de commencer
Voici ce qui vous aide à utiliser le calcul de cette page en le comprenant vraiment, et pas seulement en appuyant sur le bouton.
| La moyenne (5e, 12-13 ans) |
|
| Calculs avec les nombres relatifs (5e-4e, 12-14 ans) |
|
| Statistiques et écart-type (2de, 15-16 ans) |
|
| La loi normale et la lecture d’aires (lycée ou études supérieures, 17 ans et plus) |
|
Calculer avec Excel
| Valeur x | 75 |
| Moyenne μ | 65 |
| Écart-type σ | 5 |
| Score z | =(B1-B2)/B3 |
| Score z Z | 2 |
| P(x<Z) | =LOI.NORMALE.STANDARD.N(B1;VRAI) |
| Score z Z | 1,96 |
| Φ(Z) | =LOI.NORMALE.STANDARD.N(B1;VRAI) |
| Probabilité entre −Z et Z | =2*B2-1 |
| À gauche Z1 | -1 |
| À droite Z2 | 0 |
| Φ(Z1) | =LOI.NORMALE.STANDARD.N(B1;VRAI) |
| Φ(Z2) | =LOI.NORMALE.STANDARD.N(B2;VRAI) |
| Probabilité entre Z1 et Z2 | =B4-B3 |
Dans le premier tableau, changez la valeur, la moyenne et l’écart-type (B1 à B3) : B4 affiche le score z (avec les valeurs de l’exemple, B4 vaut 2). Le deuxième tableau donne la probabilité (B2) à partir du score z (B1) : avec la valeur de l’exemple, B2 vaut environ 0,97725 (97,7 %).
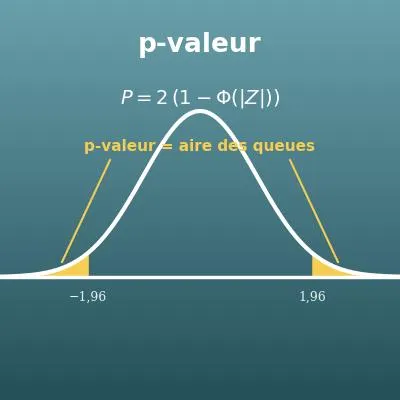
Dans le troisième, avec le score z 1,96, vous obtenez la probabilité entre −1,96 et 1,96 (B3), environ 0,95 (95 %). Le quatrième donne la probabilité entre deux scores z : avec les valeurs de l’exemple (−1 et 0), B5 vaut environ 0,34134 (34,1 %).
Pour aller dans l’autre sens, « d’une probabilité à un score z », utilisez « =LOI.NORMALE.STANDARD.INVERSE.N(probabilité) » (exemple : `=LOI.NORMALE.STANDARD.INVERSE.N(0,975)` vaut environ 1,95996).
Calculer avec Google Sheets
| Valeur x | 75 |
| Moyenne μ | 65 |
| Écart-type σ | 5 |
| Score z | =(B1-B2)/B3 |
| Score z Z | 2 |
| P(x<Z) | =LOI.NORMALE.STANDARD(B1) |
| Score z Z | 1,96 |
| Φ(Z) | =LOI.NORMALE.STANDARD(B1) |
| Probabilité entre −Z et Z | =2*B2-1 |
| À gauche Z1 | -1 |
| À droite Z2 | 0 |
| Φ(Z1) | =LOI.NORMALE.STANDARD(B1) |
| Φ(Z2) | =LOI.NORMALE.STANDARD(B2) |
| Probabilité entre Z1 et Z2 | =B4-B3 |
Les résultats sont les mêmes que dans Excel : le premier tableau donne un score z de 2 à partir de 75, 65 et 5, et le deuxième une probabilité d’environ 0,97725 pour un score z de 2.
Pour trouver un score z à partir d’une probabilité, utilisez « =LOI.NORMALE.STANDARD.INVERSE(probabilité) » (exemple : `=LOI.NORMALE.STANDARD.INVERSE(0,975)` vaut environ 1,95996).
Calculer avec Python
import math

def phi(z):
    # Fonction de répartition de la loi normale centrée réduite, Φ(z) (calculée avec la fonction d’erreur erf)
    return 0.5 * (1 + math.erf(z / math.sqrt(2)))

x = 75       # valeur mesurée
mean = 65    # moyenne
sd = 5       # écart-type

z_score = (x - mean) / sd             # score z
p_less_than_z = phi(z_score)          # probabilité d’une valeur inférieure au score z, P(x<Z)

z = 1.96
p_between_minus_z_and_z = 2 * phi(z) - 1   # probabilité entre -z et z

z1, z2 = -1, 0
p_between_z1_z2 = phi(z2) - phi(z1)        # probabilité entre z1 et z2

print(f"Score z : {z_score}")
print(f"P(x<Z) : {p_less_than_z}")
print(f"Probabilité entre -z et z : {p_between_minus_z_and_z}")
print(f"Probabilité entre z1 et z2 : {p_between_z1_z2}")
Écrire la formule en LaTeX et autres langages mathématiques (à copier-coller)
z = (x − μ) ÷ σ
z = \dfrac{x - \mu}{\sigma}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi>
<mo>=</mo>
<mfrac>
<mrow><mi>x</mi><mo>−</mo><mi>μ</mi></mrow>
<mi>σ</mi>
</mfrac>
</mrow>
</math>
z = (x - mu)/sigma
(x - mu)/sigma
z := (x - mu)/sigma;
z = (x - mu)/sigma;
z = (x-μ)/σ
P(x<Z) = Φ(Z)
P(x<Z) = \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>x</mi><mo><</mo><mi>Z</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P(x<Z) = Phi(Z)
CDF[NormalDistribution[0, 1], Z]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), Z);
p = normcdf(Z);
P(x<Z) = Φ(Z)
P(−Z<x<Z) = 2Φ(Z) − 1
P(-Z<x<Z) = 2\Phi(Z) - 1
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mo>−</mo><mi>Z</mi><mo><</mo><mi>x</mi><mo><</mo><mi>Z</mi><mo>)</mo>
<mo>=</mo>
<mn>2</mn><mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo><mo>−</mo><mn>1</mn>
</mrow>
</math>
P(-Z<x<Z) = 2 Phi(Z) - 1
2 CDF[NormalDistribution[0, 1], Z] - 1
with(Statistics): 2*CDF(RandomVariable(Normal(0, 1)), Z) - 1;
p = 2*normcdf(Z) - 1;
P(-Z<x<Z) = 2Φ(Z) - 1
P(Z₁<x<Z₂) = Φ(Z₂) − Φ(Z₁)
P(Z_1<x<Z_2) = \Phi(Z_2) - \Phi(Z_1)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><msub><mi>Z</mi><mn>1</mn></msub><mo><</mo><mi>x</mi><mo><</mo><msub><mi>Z</mi><mn>2</mn></msub><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><msub><mi>Z</mi><mn>2</mn></msub><mo>)</mo>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><msub><mi>Z</mi><mn>1</mn></msub><mo>)</mo>
</mrow>
</math>
P(Z_1<x<Z_2) = Phi(Z_2) - Phi(Z_1)
CDF[NormalDistribution[0, 1], Z2] - CDF[NormalDistribution[0, 1], Z1]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), Z2) - CDF(RandomVariable(Normal(0, 1)), Z1);
p = normcdf(Z2) - normcdf(Z1);
P(Z1<x<Z2) = Φ(Z2) - Φ(Z1)
Faire faire le calcul par ChatGPT
Tu es un assistant de calcul en statistique. Fais le calcul suivant en exécutant réellement du code Python, et appuie ta réponse uniquement sur les nombres obtenus à l’exécution (ne réponds pas de tête ni par estimation).

Une personne a eu 75 points à un examen de moyenne 65 points et d’écart-type 5 points.
1. Calcule le score z de cette personne.
2. Calcule la probabilité d’avoir une note inférieure à cette valeur, P(x<Z) (utilise la fonction de répartition Φ de la loi normale centrée réduite ; tu peux utiliser la bibliothèque standard de Python, comme math.erf ou statistics.NormalDist).
3. Calcule aussi la probabilité qu’un score z soit compris entre −1,96 et 1,96.

Montre les formules utilisées et les nombres obtenus à l’exécution. Réponds en français, avec la virgule comme séparateur décimal.
Mode d'emploi
-
1Saisissez vos nombresTapez les nombres à calculer dans les champs de saisie
-
2CalculezAppuyez sur le bouton « Calculer »
-
3Lisez le résultatLe résultat s’affiche aussitôt. La même page explique aussi le raisonnement et la formule
Les atouts de DataChef

Aucune compétence requise – simple et intuitif

Aucune donnée personnelle nécessaire

Le fichier est supprimé automatiquement après le téléchargement


Aucune mention de crédit nécessaire

Aucune autorisation préalable nécessaire
Fonctions connexes

Calcul de probabilité avec la loi normale
À partir de la moyenne et de l’écart-type, calcule la probabilité de tomber dans un intervalle ou d’être dans le haut du classement
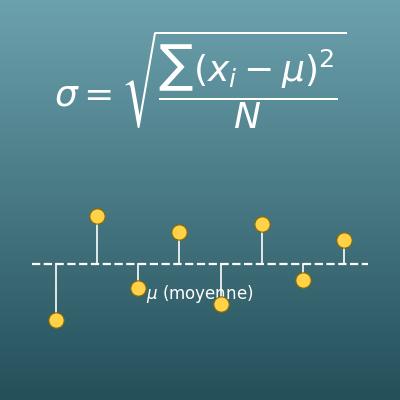
Calcul de l’écart-type d’une population ou d’un échantillon
À partir d’une liste de nombres, calcule l’écart-type de la population et de l’échantillon, la variance et la moyenne