使い方は3つあります。①測った値・平均・標準偏差からzスコアを求める ②zスコアと確率を相互変換する(どれか1つだけ入力) ③2つのzスコアの間に入る確率を求める。使いたい組の欄だけに入力してください。
このページでできること
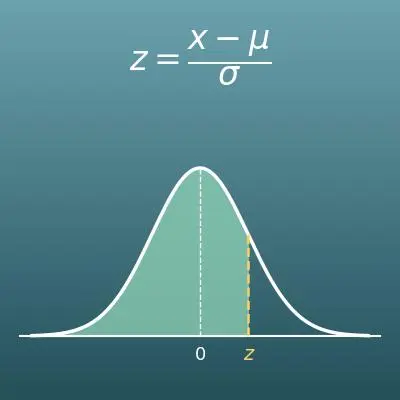
- 測った値 \(x\)・平均 \(\mu\)・標準偏差 \(\sigma\) を入れるだけで、zスコア(標準得点)とその値より小さくなる確率をまとめて計算します
- 「標準正規分布表(z表)」を引く代わりに、zスコアと確率をどちらの向きにも変換できます(zスコア→確率、確率→zスコアの逆算も可)
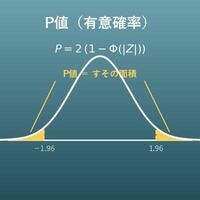
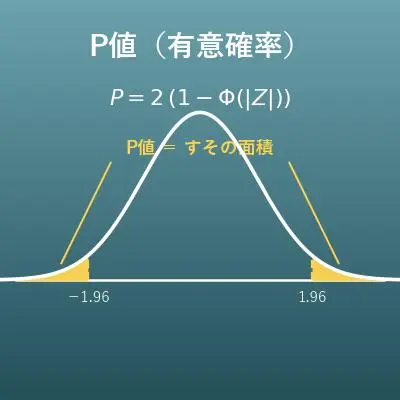
- 2つのzスコアの間に入る確率(例:−1.96〜1.96の間に入る確率)もその場で計算できます
- 式のやさしい解説・Excel/Googleスプレッドシート/Python用のコピペ数式・計算ドリル(演習問題)もこのページにまとまっています
この計算は何の役に立つ?
偏差値はzスコアそのものからできていて、偏差値 \(= 50 + 10 \times z\) です。平均65点・標準偏差5点のテストで75点なら \(z = 2\)、つまり偏差値70で、正規分布なら上位約2.3%(\(1 - \Phi(2) \fallingdotseq 0.0228\))の位置とわかります。
満点も平均も違う模試同士の成績を比べたり、「あと偏差値5」が実際どのくらいの差なのかを確率で読み取ったりできる、一番身近なzスコアの応用です。
「英語80点(平均70点・標準偏差10点)」と「数学65点(平均50点・標準偏差15点)」は、素点では英語が上に見えますが、zスコアに直すとどちらも \(z = 1\) で同じ位置です。
単位や満点、採点の厳しさが違うデータ同士でも、zスコアなら「集団の中でどのくらい上か」で公平に比べられます。入試の得点調整や人事評価の正規化にも、この考え方が使われています。
母子健康手帳や小児科の成長曲線では、身長・体重の評価に「SDスコア」という指標が使われます。これはzスコアと同じもので、平均から標準偏差(SD)いくつ分離れているかを表します。
目安として±2SD(\(z = \pm 2\))の外側はそれぞれ約2.3%で、経過を確認する目安の一つとされています(成長には個人差があり、判断は医師が経過を見て行います)。グラフの「−2SD」の線の意味がわかると、健診の説明が読み取りやすくなります。
製品の寸法や重さのばらつきは正規分布に近くなることが多く、規格の上限・下限をzスコアに直せば不良率を見積もれます。規格が平均±3σの位置なら、外れるのは約0.3%(\(2 \times (1 - \Phi(3)) \fallingdotseq 0.0027\))です。
「シックスシグマ」という品質改善活動の名前も、このzスコア(σ何個分か)から来ています。
銀行や運用会社は、保有資産の損失リスクを「バリュー・アット・リスク(VaR)」という指標で測ります。収益率が正規分布に従うと仮定すると、「99%の確率で損失がこの範囲に収まる」境界はzスコアで \(\Phi^{-1}(0.99) \fallingdotseq 2.33\)、つまり平均から標準偏差2.33個分の位置です。
世界中の金融機関のリスク計算の土台に、この「確率→zスコア」の逆変換が使われています。
式とグラフ
用語・記号の解説
記号
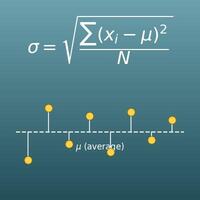
| \(z\) | ゼット(zスコア・z値) | 値が平均から標準偏差いくつ分離れているかを表す数。\(z = (x - \mu) \div \sigma\) で求めます。プラスは平均より上、マイナスは平均より下です。このページの使い方②・③のように「指定したzスコアの値」を指すときは、大文字の \(Z\) で書き分けています。 |
| \(x\) | エックス | 測った値。テストの得点や身長など、zスコアに直したい元の値です。 |
| \(\mu\) | ミュー | 平均。分布の山の中心の位置です。ギリシャ文字で、英語のmにあたります。 |
| \(\sigma\) | シグマ | 標準偏差。データの散らばりの大きさです。大きいほど山は低く広くなります。ギリシャ文字で、英語のsにあたります。 |
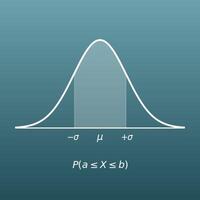
| \(\Phi(Z)\) | ファイ・ゼット | 標準正規分布(平均0・標準偏差1)の累積分布関数。「\(Z\) より小さい値になる確率」=曲線の \(Z\) より左側の面積を返します。 |
| \(\Phi^{-1}\) | ファイ・インバース(Φの逆関数) | \(\Phi\) の逆向きの関数。「確率(面積)」から「そうなるzスコア」を返します。(例:\(\Phi^{-1}(0.975) \fallingdotseq 1.96\)) |
| \(Z_1,\ Z_2\) | ゼットいち・ゼットに | 使い方③で指定する2つのzスコア。\(Z_1\) が左側(小さい方)、\(Z_2\) が右側(大きい方)の境界です。 |
用語
| zスコア (標準得点) |
ゼットスコア(ひょうじゅんとくてん) | 値が「平均から標準偏差いくつ分離れているか」を表す無単位の数。standard score、z値、基準値とも呼ばれます。単位や満点が違うデータ同士を同じものさしで比べられるのが最大の特長です。 |
| 標準化 | ひょうじゅんか | 元の値をzスコアに直すこと。どんな正規分布のデータも、標準化すれば平均0・標準偏差1の標準正規分布1つで扱えるようになります。 |
| 標準正規分布 | ひょうじゅんせいきぶんぷ | 平均0・標準偏差1の正規分布。zスコアの世界の分布で、あらゆる正規分布の確率計算の「共通のものさし」として使われます。 |
| 正規分布 | せいきぶんぷ | 平均の周りに左右対称の釣り鐘型(ベル型)で散らばる分布。テストの点数・身長・製品の重さのばらつきなど、世の中の多くのデータがこの形に近くなります。 |
| 累積分布関数 | るいせきぶんぷかんすう | 「その値以下になる確率」を返す関数。標準正規分布のものは記号 \(\Phi\)(ファイ)で表します。曲線の左側の面積を足し上げた(累積した)ものなのでこの名前です。 |
| 標準正規分布表 (z表) |
ひょうじゅんせいきぶんぷひょう | zスコアと \(\Phi\) の値(面積)の対応をまとめた数表。高校の教科書や統計の本の巻末に載っています。このページの使い方②は、このz表の代わりとして使えます。 |
| 偏差値 | へんさち | zスコアを「平均50・標準偏差1つ分を10」に置き直した値(偏差値 \(= 50 + 10 \times z\))。日本の模試・受験で広く使われる、zスコアの身近な応用例です。 |
前提として理解しておくといいこと
このページの計算を「意味がわかって」使えるようになるために、前提として理解しておくといいことをまとめました。
| 平均(小学5年) |
|
| 正負の数の計算(中学1年) |
|
| データの分析・標準偏差(高校 数学I) |
|
| 正規分布と面積の見方(高校 数学B/統計) |
|
Excelで計算する方法
| 測った値 x | 75 |
| 平均 μ | 65 |
| 標準偏差 σ | 5 |
| zスコア | =(B1-B2)/B3 |
| zスコア Z | 2 |
| P(x<Z) | =NORM.S.DIST(B1,TRUE) |
| zスコア Z | 1.96 |
| Φ(Z) | =NORM.S.DIST(B1,TRUE) |
| −ZとZの間になる確率 | =2*B2-1 |
| 左側 Z1 | -1 |
| 右側 Z2 | 0 |
| Φ(Z1) | =NORM.S.DIST(B1,TRUE) |
| Φ(Z2) | =NORM.S.DIST(B2,TRUE) |
| Z1とZ2の間になる確率 | =B4-B3 |
1つ目の表なら測った値・平均・標準偏差(B1〜B3)を書き換えるとB4にzスコアが出ます(例の値だとB4は2)。2つ目の表はzスコア(B1)から確率(B2)を求め、例の値だとB2は約0.97725(97.7%)になります。
3つ目の表はzスコア1.96を入れると、−1.96〜1.96の間になる確率(B3)が約0.95(95%)と出ます。4つ目の表は2つのzスコアの間になる確率で、例の値(−1と0)だとB5は約0.34134(34.1%)になります。
逆に「確率からzスコアを知りたい」ときは「=NORM.S.INV(確率)」を使います(例:`=NORM.S.INV(0.975)` は約1.95996)。
Googleスプレッドシートで計算する方法
| 測った値 x | 75 |
| 平均 μ | 65 |
| 標準偏差 σ | 5 |
| zスコア | =(B1-B2)/B3 |
| zスコア Z | 2 |
| P(x<Z) | =NORMSDIST(B1) |
| zスコア Z | 1.96 |
| Φ(Z) | =NORMSDIST(B1) |
| −ZとZの間になる確率 | =2*B2-1 |
| 左側 Z1 | -1 |
| 右側 Z2 | 0 |
| Φ(Z1) | =NORMSDIST(B1) |
| Φ(Z2) | =NORMSDIST(B2) |
| Z1とZ2の間になる確率 | =B4-B3 |
値の出方はExcel版と同じで、1つ目の表なら75・65・5からzスコア2、2つ目の表ならzスコア2から確率約0.97725が出ます。
逆に確率からzスコアを求めるときは「=NORMSINV(確率)」を使います(例:`=NORMSINV(0.975)` は約1.95996)。
Pythonで計算する方法
import math

def phi(z):
    # 標準正規分布の累積分布関数 Φ(z)(誤差関数 erf を使って計算)
    return 0.5 * (1 + math.erf(z / math.sqrt(2)))

x = 75       # 測った値
mean = 65    # 平均
sd = 5       # 標準偏差

z_score = (x - mean) / sd             # zスコア
p_less_than_z = phi(z_score)          # zスコアより小さい値になる確率 P(x<Z)

z = 1.96
p_between_minus_z_and_z = 2 * phi(z) - 1   # −zとzの間になる確率

z1, z2 = -1, 0
p_between_z1_z2 = phi(z2) - phi(z1)        # z1とz2の間になる確率

print(f"zスコア: {z_score}")
print(f"P(x<Z): {p_less_than_z}")
print(f"−zとzの間になる確率: {p_between_minus_z_and_z}")
print(f"z1とz2の間になる確率: {p_between_z1_z2}")
数式記述言語(LaTeX等)での書き方(コピペ可)
z = (x − μ) ÷ σ
z = \dfrac{x - \mu}{\sigma}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi>
<mo>=</mo>
<mfrac>
<mrow><mi>x</mi><mo>−</mo><mi>μ</mi></mrow>
<mi>σ</mi>
</mfrac>
</mrow>
</math>
z = (x - mu)/sigma
(x - mu)/sigma
z := (x - mu)/sigma;
z = (x - mu)/sigma;
z = (x-μ)/σ
P(x<Z) = Φ(Z)
P(x<Z) = \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>x</mi><mo><</mo><mi>Z</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P(x<Z) = Phi(Z)
CDF[NormalDistribution[0, 1], Z]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), Z);
p = normcdf(Z);
P(x<Z) = Φ(Z)
P(−Z<x<Z) = 2Φ(Z) − 1
P(-Z<x<Z) = 2\Phi(Z) - 1
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mo>−</mo><mi>Z</mi><mo><</mo><mi>x</mi><mo><</mo><mi>Z</mi><mo>)</mo>
<mo>=</mo>
<mn>2</mn><mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo><mo>−</mo><mn>1</mn>
</mrow>
</math>
P(-Z<x<Z) = 2 Phi(Z) - 1
2 CDF[NormalDistribution[0, 1], Z] - 1
with(Statistics): 2*CDF(RandomVariable(Normal(0, 1)), Z) - 1;
p = 2*normcdf(Z) - 1;
P(-Z<x<Z) = 2Φ(Z) - 1
P(Z₁<x<Z₂) = Φ(Z₂) − Φ(Z₁)
P(Z_1<x<Z_2) = \Phi(Z_2) - \Phi(Z_1)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><msub><mi>Z</mi><mn>1</mn></msub><mo><</mo><mi>x</mi><mo><</mo><msub><mi>Z</mi><mn>2</mn></msub><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><msub><mi>Z</mi><mn>2</mn></msub><mo>)</mo>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><msub><mi>Z</mi><mn>1</mn></msub><mo>)</mo>
</mrow>
</math>
P(Z_1<x<Z_2) = Phi(Z_2) - Phi(Z_1)
CDF[NormalDistribution[0, 1], Z2] - CDF[NormalDistribution[0, 1], Z1]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), Z2) - CDF(RandomVariable(Normal(0, 1)), Z1);
p = normcdf(Z2) - normcdf(Z1);
P(Z1<x<Z2) = Φ(Z2) - Φ(Z1)
ChatGPT に聞いて計算してもらう方法
あなたは統計の計算アシスタントです。次の計算を、必ずPythonコードを実際に実行して行い、実行結果の数値だけを根拠に回答してください(暗算や推測で答えないでください)。

平均65点・標準偏差5点のテストで75点を取った人がいます。
1. この人のzスコアを求めてください。
2. その値より小さい点数を取る確率 P(x<Z) を求めてください(標準正規分布の累積分布関数 Φ を使ってください。math.erfやstatistics.NormalDistなど、Pythonの標準ライブラリを使って構いません)。
3. さらに、zスコアが−1.96から1.96の間に入る確率も求めてください。

計算に使った式と、実行結果の数値を示してください。
計算ドリル(演習問題)
このページの式を、自分の手で計算できるようになるための演習問題です。
答えと解説は解答ページにあります。
使い方
-
1数値を入力計算したい数値を入力欄に入力します
-
2計算「計算する」ボタンを押します
-
3結果を確認計算結果がその場に表示されます。計算の考え方や式の解説も同じページで確認できます
DataChefの特徴

専門知識不要、直感的で簡単な操作
個人情報を登録することなく使用できます
「ダウンロード」押下でファイルを自動削除
クレジット表記不要
商用利用許諾の連絡も不要です
関連機能
正規分布の確率
平均と標準偏差から、指定した範囲に入る確率・上位何%かを計算します
標準偏差計算機
数値のリストから母標準偏差・標本標準偏差・分散・平均を計算します