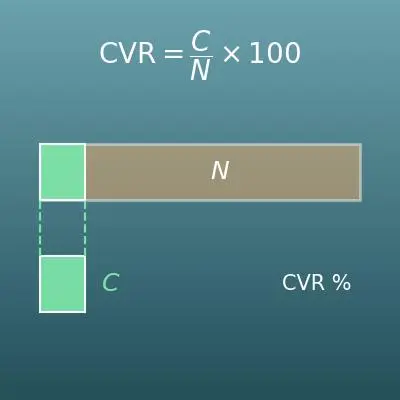
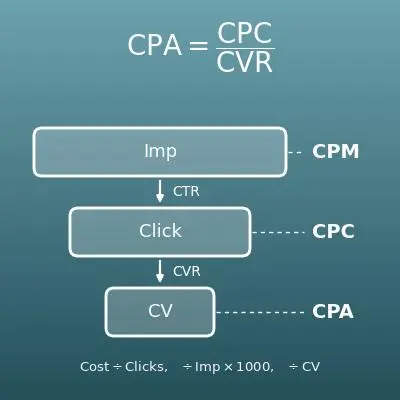
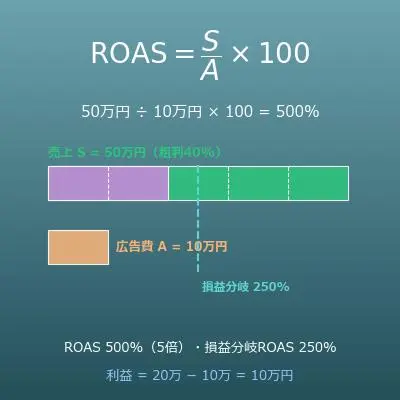
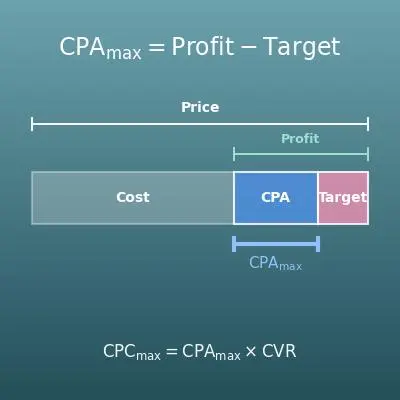
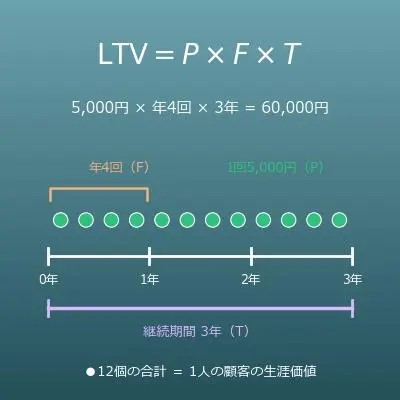
A群(元のパターン)とB群(変更したパターン)それぞれの訪問数とコンバージョン数を入力してください。各群のCVR・差・相対リフト率に加え、2標本比率のz検定でz値とp値を求め、選んだ有意水準で「有意差あり/なし」を判定します。
目次
このページでできること
- A群・B群それぞれの訪問数(クリック数・セッション数でも可)とコンバージョン数を入れるだけで、各群のCVR・CVRの差・相対リフト率をまとめて計算します
- 「Bの方がCVRが高く見えるけれど、偶然のばらつきではないか?」を2標本比率のz検定で判定します(z値・両側/片側のp値・有意水準5%/1%/10%の判定)
- CVRの差の信頼区間(95%など)と、「有意になるまでz値があとどれだけ足りないか」の余裕もわかります
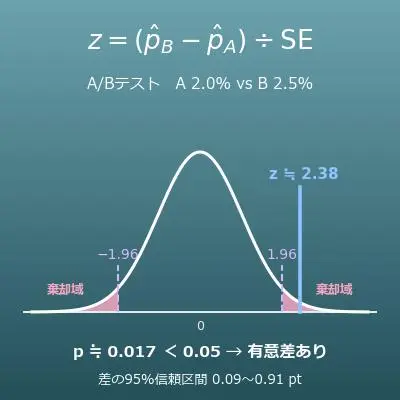
- 標準正規分布のグラフに、今回のz値の位置と棄却域(ここに入れば有意)を塗って表示します
- 式のやさしい解説・Excel/Googleスプレッドシート/Python用のコピペ数式・計算ドリル(演習問題)もこのページにまとまっています
この計算は何の役に立つ?
「ボタンの色を変えたBの方がCVRが2.0%から2.5%に上がった」——この差が偶然でないか確かめるのがA/Bテストの有意差判定で、Webマーケティングでは日常的に行われています。訪問10000回ずつなら両側p値は約0.017で「5%で有意差あり」ですが、同じくらいのCVRでも訪問500回ずつ(CV10件と12〜13件)なら p値は0.5〜0.7程度になり「偶然かもしれない」としか言えません。
「Bの方が高そう」と見た目で判断して切り替えると、翌月には元に戻っていた、ということが実際によく起こります。訪問数を先に決めてテストし、有意水準で判定するのはそれを防ぐためです(訪問者がランダムに振り分けられていることが前提です)。
同じメールを件名だけ変えて半数ずつに送り、開封率48%と52%を比べる——これも2つの比率の差の検定です。各5000通なら差4ポイントのz値は約4で、偶然とは考えにくい差だと判断できます。
開封率のような大きめの比率は、CVRのような小さい比率よりも同じ通数で判定しやすい(標準誤差に対して差が大きくなりやすい)という性質があります。どの指標を比べるかで必要な配信数が変わる、という感覚がこの式から身につきます。
「従来の治療で改善した人の割合は60%、新しい治療では70%」のような2つの群の改善率の比較は、医学の臨床試験で使われる基本的な検定です(実際の試験ではランダム化・盲検化などの厳密な設計のもとで行われます)。
薬の承認や治療ガイドラインの根拠となる論文には、必ずp値や信頼区間が載っています。この式の意味がわかると、「有意差あり」の一言に振り回されず、「差の大きさはどのくらいか」「対象人数は十分か」まで読み取れるようになります。
新しい工程Bで不良率が1.5%から1.0%に下がったように見えるとき、生産数がそれぞれ2000個なら「偶然の範囲」、20000個なら「有意な改善」と判定が変わります。設備投資や工程変更の判断を、少ないサンプルの偶然に左右されないようにするための計算です。
不良率のように小さい比率では、期待不良数(個数 × 不良率)が5を下回ると正規近似が粗くなるため、そういうときは二項分布を直接使う正確な検定(フィッシャーの正確検定など)が選ばれます。
「新しい教材を使ったクラスの合格率は75%、従来の教材では65%」のような比較にも同じ検定が使えます。ただしクラス単位で教材を分けると、生徒をランダムに振り分けたことにはならず、先生や生徒の違いが結果に混ざります。
教育や社会科学の研究では、この式で有意差を確かめると同時に、「ランダムに分けられているか」「結果を見てから比較の切り口を変えていないか」という設計の面が重視されます。式の前提を知ることが、数字にだまされないための力になります。
式
用語・記号の解説
記号
| \(n_A,\ n_B\) | エヌ・エー、エヌ・ビー | A群・B群の訪問数(クリック数・セッション数)。\(n\) は number(数)の頭文字で、統計では標本の大きさ(サンプルサイズ)を表す慣例の文字です。 |
| \(x_A,\ x_B\) | エックス・エー、エックス・ビー | A群・B群のコンバージョン数(CV数)。「成功した回数」を \(x\) で表すのは二項分布の慣例です。 |
| \(\hat{p}_A,\ \hat{p}_B\) | ピーハット・エー、ピーハット・ビー ピーのハット | A群・B群のCVR(標本から求めた比率)。\(p\) は proportion(比率)または probability(確率)の頭文字、上の「\(\hat{}\)」(ハット)は「本当の値 \(p\) を標本から推定した値」という意味の記号です。 |
| \(\hat{p}\) | ピーハット | プールしたCVR。「差がない」と仮定して両群のデータを合わせて求めた、1つのCVRの推定値です。\(\hat{p} = (x_A + x_B) \div (n_A + n_B)\) で求めます。 |
| \(d\) | ディー | CVRの差(\(\hat{p}_B - \hat{p}_A\))。\(d\) は difference(差)の頭文字です。このページでは100倍して「ポイント」で表示します。 |
| \(L\) | エル | 相対リフト率(%)。\(L\) は lift(持ち上げる)の頭文字で、AのCVRに対してBのCVRが何%増えたかを表します。 |
| \(\mathrm{SE}\) | エスイー | 標準誤差(Standard Error)。標本から求めた値(ここではCVRの差)が偶然でどのくらい揺れるかの目安で、標本の値の標準偏差にあたります。検定ではプールしたCVRで求め、信頼区間では各群のCVRで求めた \(\mathrm{SE}_d\) を使います。 |
| \(z\) | ゼット | z値(検定統計量)。差を標準誤差で割った値で、「差は偶然の揺れ幅の何倍か」を表します。差がないとき標準正規分布(平均0・標準偏差1)に従うので、この値の大きさからp値が求められます。 |
| \(|z|\) | ゼットの絶対値 | z値の符号を取り去った大きさ。両側検定では「どちら向きの差か」を問わないので、絶対値を使います。 |
| \(\Phi\) | ファイ | 標準正規分布の累積分布関数。\(\Phi(z)\) は「標準正規分布に従う値が \(z\) 以下になる確率」で、ベル型の曲線の \(z\) から左側の面積です。ギリシャ文字の大文字ファイで、確率分布の累積分布関数を表すのに慣例的に使われます。 |
| \(p_2,\ p_1\) | ピー・ツー、ピー・ワン | 両側p値と片側p値。添え字の2・1は「すそが2つ(両側)」「すそが1つ(片側)」を表す、このページでの書き分けです。統計の本では単に \(p\) と書きます。 |
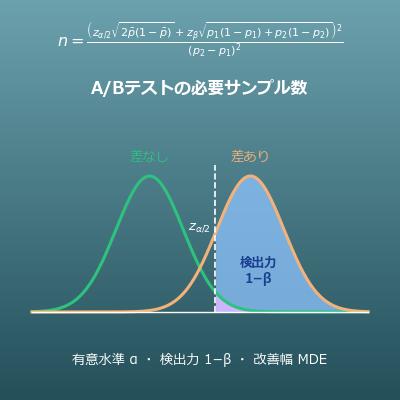
| \(\alpha\) | アルファ | 有意水準。「p値がこれより小さければ帰無仮説を捨てる」と事前に決める境界で、5%(0.05)がよく使われます。ギリシャ文字のアルファで、第一種の過誤(差がないのに「ある」と判定してしまう誤り)の確率にあたります。 |
| \(z_{\alpha/2}\) | ゼット・アルファ・ニブンノイチ | 両側で合わせて \(\alpha\) の確率をすそに残すときの境界のz値(臨界値)。95%信頼区間(\(\alpha = 0.05\))なら1.96、99%なら2.576です。片側では \(z_\alpha\)(5%なら1.645)になります。 |
| \(d_L,\ d_U\) | ディー・エル、ディー・ユー | 差の信頼区間の下限(Lower)と上限(Upper)。本当の差がこの範囲にありそうだ、という区間の両端です。 |
用語
| A/Bテスト | エービーテスト | 元のパターン(A)と変更したパターン(B)を、同じ期間に訪問者へランダムに出し分けて成果を比べる実験。Webサイト・広告・メールなどで広く使われます。ランダムに分けることで、曜日や流入元の違いなど「パターン以外の要因」を両群で同じ条件にできるのがポイントです。 |
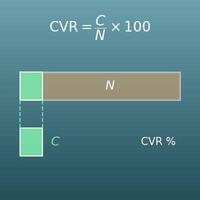
| コンバージョン率 (CVR) |
コンバージョンりつ | 訪問(クリック)のうち、購入・申込などの成果(コンバージョン)に至った割合。\(\mathrm{CVR}\) は Conversion Rate の略です。CVR単体の計算・逆算は「コンバージョン率(CVR)の計算」ページで扱っています。 |
| 帰無仮説 | きむかせつ | 「AとBのCVRに本当は差がない(\(p_A = p_B\))」という、検定で否定したい側の仮説。「無に帰したい仮説」という意味の名前です。検定は、この仮説のもとで今回の差がどれくらい起こりにくいかを調べます。 |
| 対立仮説 | たいりつかせつ | 帰無仮説と対立する、示したい側の仮説。両側検定では「AとBに差がある(\(p_A \neq p_B\))」、片側検定では「BがAより高い(\(p_B > p_A\))」です。 |
| 有意水準 | ゆういすいじゅん | 「p値がこれより小さければ帰無仮説を捨てる」と、テストの前に決めておく境界。5%がよく使われ、厳しく判定したいときは1%にします。「5%で有意」とは「差がないのに偶然これほどの差が出る確率が5%未満」という意味です。 |
| p値 | ピーち | 帰無仮説(差がない)が正しいと仮定したとき、今回以上の差が偶然に出る確率。小さいほど「偶然とは考えにくい」ことを表します。「Bの方が良い確率」ではないことに注意してください(よくある誤解です)。 |
| 有意差 | ゆういさ | p値が有意水準より小さく、「偶然のばらつきでは説明しにくい差」と判断されたこと。「統計的に有意」とも言います。差の大きさや効果の確実さを保証する言葉ではなく、訪問数が非常に多ければごくわずかな差でも有意になります。 |
| 検定統計量 | けんていとうけいりょう | 検定のためにデータから計算する1つの数値。このページではz値がそれで、「差 ÷ 標準誤差」で求めます。この値がどのくらい極端かでp値が決まります。 |
| 2標本比率のz検定 | にひょうほんひりつのゼットけんてい | 2つの群の比率(CVRなど)に差があるかを、正規分布を使って調べる検定。A/Bテストの有意差判定として最も基本的な方法です。ほぼ同じ内容を「2×2のカイ二乗検定」で行うこともでき、両側検定のp値は一致します。 |
| 標準誤差 | ひょうじゅんごさ | 標本から求めた統計量(ここではCVRの差)が、標本の取り方によって偶然どのくらい揺れるかを表す標準偏差。訪問数の平方根に反比例して小さくなるので、標準誤差を半分にするには訪問数を4倍にする必要があります。 |
| プール | プール | 「差がない」と仮定して、両群のデータを合わせて1つのCVRを推定すること。英語の pool(1つにまとめる)から来ています。検定の標準誤差はこのプールした値で計算します。 |
| 信頼区間 | しんらいくかん | 「本当の差はこの範囲にありそうだ」という区間。95%信頼区間は、同じ実験を何度もくり返したとき、その95%で本当の差を含むような区間の作り方です。区間が0を含まなければ、両側5%の検定で有意になることとほぼ対応します。 |
| 両側検定 | りょうがわけんてい | 「差があるか(どちらが高いかは問わない)」を調べる検定。どちらに転ぶかわからない普通のA/Bテストではこちらを使います。 |
| 片側検定 | かたがわけんてい | 「BがAより高いか」のように向きを決めて調べる検定。両側検定に比べてp値が半分になり有意になりやすいので、向きをテストの前に決めていた場合だけ使います。 |
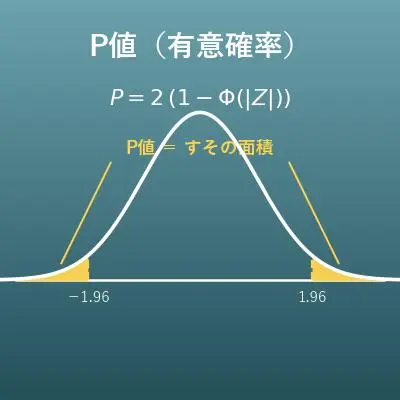
| 棄却域 | ききゃくいき | 「z値がここに入ったら帰無仮説を捨てる(棄却する)」という、標準正規分布のすその領域。両側5%なら \(z < -1.96\) と \(z > 1.96\) の2つのすそで、合わせて面積が0.05になります。このページのグラフで塗られている部分です。 |
| 臨界値 | りんかいち | 棄却域の境界になるz値。両側5%なら1.96、両側1%なら2.576、片側5%なら1.645です。計算結果の「z値の余裕」は、今回のz値が臨界値をどれだけ超えているか(足りないか)を表します。 |
| 正規近似 | せいききんじ | CV数のばらつきは本来「二項分布」に従いますが、訪問数が多いと正規分布(ベル型の曲線)でよく近似できます。z検定はこの近似を使うので、各群の期待CV数 \(n\hat{p}\) と期待非CV数 \(n(1-\hat{p})\) が5以上(できれば10以上)あることが目安です。 |
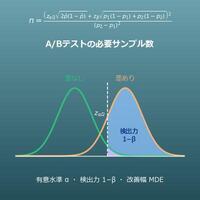
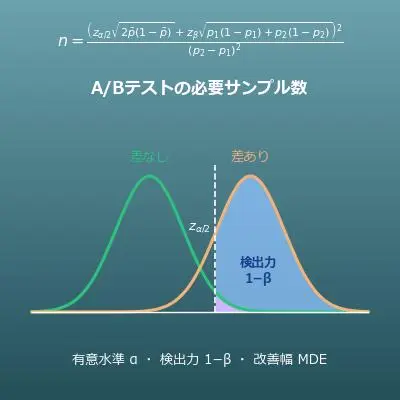
| 検出力 | けんしゅつりょく | 本当に差があるときに、検定がそれを「有意」と検出できる確率。訪問数が少ないと検出力が低く、本当は効果があっても「有意差なし」になりがちです。「有意差なし」は「差がない」の証明ではありません。 |
| 第一種の過誤 | だいいっしゅのかご | 本当は差がないのに「有意差あり」と判定してしまう誤り。有意水準 \(\alpha\) はこの誤りを許す確率で、5%なら「差がないテストを100回やると約5回は偶然有意になる」ことを意味します。 |
| 多重比較 | たじゅうひかく | 同時に多くのパターンや指標を検定すること。5%の有意水準でも、20個の指標を検定すればどれか1つは偶然「有意」になる計算です。見る指標を事前に絞るか、有意水準を厳しくする(ボンフェローニ補正など)必要があります。 |
| 早期停止 (ピーキング) |
そうきていし | 結果を途中で何度も見て、有意になった時点でテストを打ち切ること。p値はテスト中に上下に揺れるので、「一度でも5%を切ったら止める」を続けると、差がなくても有意になる確率が5%をはるかに超えてしまいます。必要な訪問数を先に決め、そこまで待つのが基本です。 |
| 相対リフト率 | そうたいリフトりつ | AのCVRに対してBのCVRが何%増えたか。差 \(d\) をAのCVRで割って100倍します。「0.5ポイント上がった」より「25%増えた」の方が、CV数や売上の増加を見積もりやすい表現です。 |
| ポイント | ポイント | %どうしの引き算の結果を表す単位。「2.5% − 2% = 0.5ポイント」のように使い、「0.5%」と書くと「2%の0.5%」と混同されるのを避けます。 |
前提として理解しておくといいこと
このページの計算を「意味がわかって」使えるようになるために、前提として理解しておくといいことをまとめました。
つまずいたら、この表の内容に戻って復習するのが近道です。
| 割合・百分率(小学5年) |
|
| 分数の逆数と平方根(小学6年〜中学3年) |
|
| 正規分布と標準偏差(高校 数学B「統計的な推測」) |
|
| 仮説検定の考え方(高校 数学B「統計的な推測」) |
|
| 二項分布とその正規近似(高校 数学B) |
|
Excelで計算する方法
| A群の訪問数 n_A | 10000 |
| A群のCV数 x_A | 200 |
| B群の訪問数 n_B | 10000 |
| B群のCV数 x_B | 250 |
| A群のCVR p̂_A | =B2/B1 |
| B群のCVR p̂_B | =B4/B3 |
| A群のCVR p̂_A | 0.02 |
| B群のCVR p̂_B | 0.025 |
| CVRの差 d | =B2-B1 |
| 相対リフト率 L(%) | =B3/B1*100 |
| A群のCV数 x_A | 200 |
| B群のCV数 x_B | 250 |
| A群の訪問数 n_A | 10000 |
| B群の訪問数 n_B | 10000 |
| プールしたCVR p̂ | =(B1+B2)/(B3+B4) |
| プールしたCVR p̂ | 0.0225 |
| A群の訪問数 n_A | 10000 |
| B群の訪問数 n_B | 10000 |
| CVRの差 d | 0.005 |
| 標準誤差 SE | =SQRT(B1*(1-B1)*(1/B2+1/B3)) |
| z値 z | =B4/B5 |
| z値 z | 2.384 |
| 両側p値 p₂ | =2*(1-NORM.S.DIST(ABS(B1),TRUE)) |
| 片側p値 p₁ | =1-NORM.S.DIST(B1,TRUE) |
| A群のCVR p̂_A | 0.02 |
| A群の訪問数 n_A | 10000 |
| B群のCVR p̂_B | 0.025 |
| B群の訪問数 n_B | 10000 |
| CVRの差 d | 0.005 |
| 信頼水準(0.95 = 95%) | 0.95 |
| z_(α/2) | =NORM.S.INV(1-(1-B6)/2) |
| 標準誤差 SE_d | =SQRT(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| 下限 d_L | =B5-B7*B8 |
| 上限 d_U | =B5+B7*B8 |
1つ目の表はB5にA群のCVR 0.02、B6にB群のCVR 0.025が出ます。2つ目の表は差0.005(0.5ポイント)とリフト率25、3つ目の表はプールしたCVR 0.0225、4つ目の表は標準誤差約0.002097とz値約2.384になります。
5つ目の表の NORM.S.DIST(z, TRUE) は標準正規分布の累積確率 Φ(z) を返す関数で、両側p値は約0.0171、片側p値は約0.0086になります。6つ目の表の NORM.S.INV は累積確率からz値を逆に求める関数(信頼水準95%なら1.96)で、下限約0.0009・上限約0.0091(0.09〜0.91ポイント)になります。
Googleスプレッドシートで計算する方法
| A群の訪問数 n_A | 10000 |
| A群のCV数 x_A | 200 |
| B群の訪問数 n_B | 10000 |
| B群のCV数 x_B | 250 |
| A群のCVR p̂_A | =B2/B1 |
| B群のCVR p̂_B | =B4/B3 |
| A群のCVR p̂_A | 0.02 |
| B群のCVR p̂_B | 0.025 |
| CVRの差 d | =B2-B1 |
| 相対リフト率 L(%) | =B3/B1*100 |
| A群のCV数 x_A | 200 |
| B群のCV数 x_B | 250 |
| A群の訪問数 n_A | 10000 |
| B群の訪問数 n_B | 10000 |
| プールしたCVR p̂ | =(B1+B2)/(B3+B4) |
| プールしたCVR p̂ | 0.0225 |
| A群の訪問数 n_A | 10000 |
| B群の訪問数 n_B | 10000 |
| CVRの差 d | 0.005 |
| 標準誤差 SE | =SQRT(B1*(1-B1)*(1/B2+1/B3)) |
| z値 z | =B4/B5 |
| z値 z | 2.384 |
| 両側p値 p₂ | =2*(1-NORMSDIST(ABS(B1))) |
| 片側p値 p₁ | =1-NORMSDIST(B1) |
| A群のCVR p̂_A | 0.02 |
| A群の訪問数 n_A | 10000 |
| B群のCVR p̂_B | 0.025 |
| B群の訪問数 n_B | 10000 |
| CVRの差 d | 0.005 |
| 信頼水準(0.95 = 95%) | 0.95 |
| z_(α/2) | =NORMSINV(1-(1-B6)/2) |
| 標準誤差 SE_d | =SQRT(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| 下限 d_L | =B5-B7*B8 |
| 上限 d_U | =B5+B7*B8 |
Pythonで計算する方法
import math

visits_a, conversions_a = 10000, 200   # A群の訪問数・CV数
visits_b, conversions_b = 10000, 250   # B群の訪問数・CV数
alpha = 0.05                           # 有意水準(5%)

def normal_cdf(z):
    # 標準正規分布の累積分布関数 Φ(z)
    return 0.5 * math.erfc(-z / math.sqrt(2))

def normal_ppf(p):
    # Φの逆関数(二分法。z_(α/2) を求めるのに使う)
    low, high = -10.0, 10.0
    for _ in range(100):
        mid = (low + high) / 2
        if normal_cdf(mid) < p:
            low = mid
        else:
            high = mid
    return (low + high) / 2

cvr_a = conversions_a / visits_a
cvr_b = conversions_b / visits_b
diff = cvr_b - cvr_a
lift = diff / cvr_a * 100
pooled = (conversions_a + conversions_b) / (visits_a + visits_b)
se_pooled = math.sqrt(pooled * (1 - pooled) * (1 / visits_a + 1 / visits_b))
z = diff / se_pooled
p_two_sided = 2 * (1 - normal_cdf(abs(z)))
p_one_sided = 1 - normal_cdf(z)

se_diff = math.sqrt(cvr_a * (1 - cvr_a) / visits_a + cvr_b * (1 - cvr_b) / visits_b)
z_half = normal_ppf(1 - alpha / 2)
ci_low, ci_high = diff - z_half * se_diff, diff + z_half * se_diff

print(f"A群のCVR: {cvr_a * 100:.2f}%  B群のCVR: {cvr_b * 100:.2f}%")
print(f"差: {diff * 100:.2f}ポイント  相対リフト率: {lift:.1f}%")
print(f"z値: {z:.3f}  両側p値: {p_two_sided:.4f}  片側p値: {p_one_sided:.4f}")
print("判定(両側):", "有意差あり" if p_two_sided < alpha else "有意差なし")
print(f"差の{(1 - alpha) * 100:.0f}%信頼区間: {ci_low * 100:.2f} 〜 {ci_high * 100:.2f}ポイント")
数式記述言語(LaTeX等)での書き方(コピペ可)
p̂_A = x_A ÷ n_A
\hat{p}_A = \dfrac{x_A}{n_A}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
    <mo>=</mo>
    <mfrac>
      <msub><mi>x</mi><mi>A</mi></msub>
      <msub><mi>n</mi><mi>A</mi></msub>
    </mfrac>
  </mrow>
</math>
hat(p)_A = x_A / n_A
xA/nA
pA := xA/nA;
pA = xA/nA;
p̂_A = x_A/n_A
d = p̂_B − p̂_A, L = d ÷ p̂_A × 100
d = \hat{p}_B - \hat{p}_A, \quad L = \dfrac{d}{\hat{p}_A} \times 100
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>=</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub>
<mo>−</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
<mo>,</mo><mspace width="1em"/>
<mi>L</mi><mo>=</mo>
<mfrac><mi>d</mi><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mfrac>
<mo>×</mo><mn>100</mn>
</mrow>
</math>
d = hat(p)_B - hat(p)_A, L = d / hat(p)_A xx 100
d = pB - pA; d/pA*100
d := pB - pA; L := d/pA*100;
d = pB - pA; L = d/pA*100;
d = p̂_B − p̂_A, L = d/p̂_A × 100
p̂ = (x_A + x_B) ÷ (n_A + n_B)
\hat{p} = \dfrac{x_A + x_B}{n_A + n_B}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mover accent="true"><mi>p</mi><mo>^</mo></mover>
    <mo>=</mo>
    <mfrac>
      <mrow><msub><mi>x</mi><mi>A</mi></msub><mo>+</mo><msub><mi>x</mi><mi>B</mi></msub></mrow>
      <mrow><msub><mi>n</mi><mi>A</mi></msub><mo>+</mo><msub><mi>n</mi><mi>B</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
hat(p) = (x_A + x_B) / (n_A + n_B)
(xA + xB)/(nA + nB)
pPool := (xA + xB)/(nA + nB);
pPool = (xA + xB)/(nA + nB);
p̂ = (x_A + x_B)/(n_A + n_B)
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d ÷ SE
\mathrm{SE} = \sqrt{\hat{p}(1-\hat{p})\left(\dfrac{1}{n_A}+\dfrac{1}{n_B}\right)}, \quad z = \dfrac{d}{\mathrm{SE}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi><mo>=</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mrow>
<msqrt>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
<mo>(</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>A</mi></msub></mfrac>
<mo>+</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>B</mi></msub></mfrac>
<mo>)</mo>
</msqrt>
</mfrac>
</mrow>
</math>
SE = sqrt(hat(p)(1 - hat(p))(1/n_A + 1/n_B)), z = d / SE
se = Sqrt[pPool*(1 - pPool)*(1/nA + 1/nB)]; z = d/se
SE := sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z := d/SE;
SE = sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z = d/SE;
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d/SE
p₂ = 2(1 − Φ(|z|)), p₁ = 1 − Φ(z)
p_2 = 2\left(1 - \Phi(|z|)\right), \quad p_1 = 1 - \Phi(z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>p</mi><mn>2</mn></msub><mo>=</mo>
<mn>2</mn><mo>(</mo><mn>1</mn><mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>z</mi><mo>|</mo><mo>)</mo><mo>)</mo>
<mo>,</mo><mspace width="1em"/>
<msub><mi>p</mi><mn>1</mn></msub><mo>=</mo>
<mn>1</mn><mo>−</mo><mi>Φ</mi><mo>(</mo><mi>z</mi><mo>)</mo>
</mrow>
</math>
p_2 = 2(1 - Phi(|z|)), p_1 = 1 - Phi(z)
p2 = 2*(1 - CDF[NormalDistribution[0, 1], Abs[z]]); p1 = 1 - CDF[NormalDistribution[0, 1], z]
p2 := 2*(1 - Statistics:-CDF(Normal(0, 1), abs(z))); p1 := 1 - Statistics:-CDF(Normal(0, 1), z);
p2 = 2*(1 - normcdf(abs(z))); p1 = 1 - normcdf(z);
p_2 = 2(1 − Φ(|z|)), p_1 = 1 − Φ(z)
d ± z_(α/2) × √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
d \pm z_{\alpha/2}\sqrt{\dfrac{\hat{p}_A(1-\hat{p}_A)}{n_A}+\dfrac{\hat{p}_B(1-\hat{p}_B)}{n_B}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>±</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>A</mi></msub>
</mfrac>
<mo>+</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>B</mi></msub>
</mfrac>
</msqrt>
</mrow>
</math>
d +- z_(alpha/2) sqrt((hat(p)_A(1 - hat(p)_A))/n_A + (hat(p)_B(1 - hat(p)_B))/n_B)
seD = Sqrt[pA*(1 - pA)/nA + pB*(1 - pB)/nB]; {d - zHalf*seD, d + zHalf*seD}
seD := sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); [d - zHalf*seD, d + zHalf*seD];
seD = sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); ci = [d - zHalf*seD, d + zHalf*seD];
d ± z_(α/2) √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
ChatGPT に聞いて計算してもらう方法
あなたは統計(仮説検定)の計算アシスタントです。次の計算を、必ずPythonコードを実際に実行して行い、実行結果の数値だけを根拠に回答してください(暗算や推測で答えないでください)。

A/Bテストの結果は次のとおりです。
- A群:訪問数10000、コンバージョン数200
- B群:訪問数10000、コンバージョン数250
次の値をそれぞれ求めてください。
1. 各群のコンバージョン率(%)、CVRの差(ポイント)、相対リフト率(%)
2. プールしたコンバージョン率と、プールした標準誤差 SE = √(p̂(1−p̂)(1/n_A + 1/n_B))
3. z値 = 差 ÷ SE と、両側p値・片側p値(標準正規分布)
4. 有意水準5%(両側)で有意差があるかどうかの判定
5. 差の95%信頼区間(各群のCVRのばらつきから求めた標準誤差 √(p̂_A(1−p̂_A)/n_A + p̂_B(1−p̂_B)/n_B) を使う)

Pythonでは math.erfc(または scipy.stats.norm)を使って計算し、計算に使った式と実行結果の数値を示してください。
計算ドリル(演習問題)
このページの式を、自分の手で計算できるようになるための演習問題です。
答えと解説は解答ページにあります。
使い方
-
1数値を入力計算したい数値を入力欄に入力します
-
2計算「計算する」ボタンを押します
-
3結果を確認計算結果がその場に表示されます。計算の考え方や式の解説も同じページで確認できます
DataChefの特徴

専門知識不要、直感的で簡単な操作
個人情報を登録することなく使用できます
「ダウンロード」押下でファイルを自動削除
クレジット表記不要
商用利用許諾の連絡も不要です
関連機能
コンバージョン率(CVR)の計算と逆算
流入数・CV数・CVRのうち2つから残りを計算します。1つの群のCVRを求めるだけならこちらです
P値計算機(Z値⇔P値)
手元にz値があるときに、左側・右側・両側のp値へ変換する汎用の計算機です。このページはz値の手前(訪問数・CV数)から計算します
信頼区間計算機(母平均の区間推定)
平均値(テストの点数・売上など)の信頼区間を求めます。このページの「差の信頼区間」の平均値版です
サンプルサイズ計算機(必要サンプル数・許容誤差)
アンケート・調査で1つの比率を許容誤差内で知るための必要人数を計算します。調査の設計はこちらです