平均・標準偏差と、知りたい範囲の下限・上限を入力してください。範囲に入る確率と、信頼区間の一覧表を計算します。
このページでできること
- 「平均 \(\mu\)」と「ばらつき(標準偏差 \(\sigma\))」を入れるだけで、値が指定した範囲に入る確率がその場でわかります
- 「80点以上は上位何%?」のような、ある値以上(以下)になる確率もまとめて計算します
- 統計でよく使う信頼区間(全体の95%が入る範囲など)の一覧表も同時に表示します
- 正規分布のやさしい解説・Excel/Googleスプレッドシート/Python用のコピペ数式・計算ドリル(演習問題)もこのページにまとまっています
この計算は何の役に立つ?
偏差値は「平均を50、標準偏差1つ分を10」として点数を置き直したものです。正規分布では平均 \(+1\sigma\) 以上(=偏差値60以上)は全体の約16%、\(+2\sigma\) 以上(=偏差値70以上)は約2.3%しかいません。
この対応がわかると、「偏差値が5上がる」ことの重み、模試の判定や順位の意味を、感覚ではなく数字で読み取れるようになります。
血液検査などの「基準範囲」は、健康な人の測定値の分布から、中央の95%が入る範囲(およそ平均 \(\pm 2\sigma\))として決められることが多いです。
つまりどの検査項目でも、健康な人の約5%(20人に1人)は基準範囲を外れます。項目数が多い健診では、健康でもどこか1つは引っかかる人がむしろ珍しくありません。この事実を知っていると、「基準値を少し外れた=即異常」ではないことを理解したうえで、医師の説明を落ち着いて聞けます。検査結果に一喜一憂しがちな人ほど役に立つ知識です。
製品の重さや寸法のばらつきは正規分布に近くなります。例えば「内容量の平均102g・標準偏差1g、規格の下限100g」なら、規格を下回るのは \(-2\sigma\) より外側の約2.3%と見積もれます。
工場では、この計算で不良率を予測し、平均をどこに設定すれば(=どれだけ多めに入れれば)クレームと原価のバランスが取れるかを決めています。
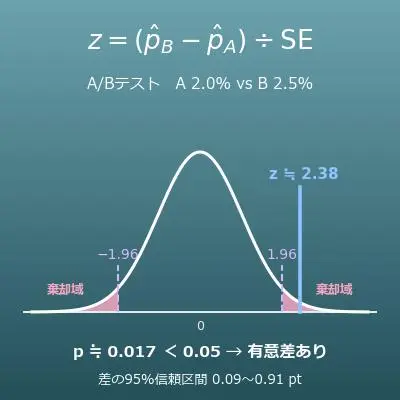
デザインAとBのどちらのクリック率が高いかを比べるとき、「この差は偶然の範囲か、本物の差か」を正規分布(信頼区間)で判定します。
結果に表示される信頼区間の表の「0.95」の行が、まさに実務で最もよく使われる「95%信頼区間」です。広告費のような大きなお金を動かす判断の裏側で、この計算が毎日使われています。
アクチュアリー(保険数理人)と呼ばれる専門職は、保険金の支払いリスクを確率で見積もって保険料を決めています。
個々の事故は予測できなくても、大勢の契約者の合計は正規分布に近づく性質(中心極限定理)があるため、全体の支払額は驚くほど正確に予測できます。私たちが手頃な保険料で大きな保障を得られるのは、この数学のおかげです。
式とグラフ
用語・記号の解説
記号
| \(\mu\) | ミュー | 平均。分布の山の中心の位置です。ギリシャ文字で、英語のmにあたります。 |
| \(\sigma\) | シグマ | 標準偏差。データの散らばりの大きさで、山の幅を決めます。大きいほど山は低く広くなります。ギリシャ文字で、英語のsにあたります。 |
| \(X\) | エックス(確率変数) | テストの点数や身長のような、「測るたびに値が変わりうる量」を表す文字です。 |
| \(\Phi\) | ファイ(大文字) | 標準正規分布(平均0・標準偏差1)の累積分布関数。「その値以下になる確率」を返す関数です。 |
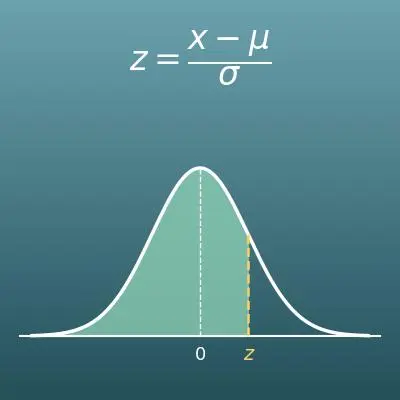
| \(z\) | ゼット(z値・zスコア) | 値が平均から標準偏差いくつ分離れているかを表す数。\(z = (x - \mu) \div \sigma\) で求めます。 |
| \(e\) | イー(自然対数の底、ネイピア数) | 約2.71828…の定数。指数関数の土台になる特別な数です。 |
| \(\pi\) | パイ(円周率) | 約3.14159…の定数。正規分布の式では、曲線の下の面積の合計をちょうど1にするために現れます。 |
用語
| 正規分布 | せいきぶんぷ | 平均の周りに左右対称の釣り鐘型(ベル型)で散らばる分布。「平均くらいの値が一番よく出て、平均から離れるほど珍しくなる」性質を持つデータ——身長・テストの点数・製品の重さのばらつきなど——のモデルとして使われます。 |
| 標準偏差 | ひょうじゅんへんさ | データの散らばりの大きさを一つの数で表したもの。同じ平均でも散らばりが大きいデータと小さいデータがあり、標準偏差が大きいほど分布の山は低く広くなります。 |
| 標準化 (z値) |
ひょうじゅんか | 値を「平均から標準偏差いくつ分離れているか(\(z\) 値)」に直すこと。どんな正規分布も標準化すれば、平均0・標準偏差1の標準正規分布1つで確率を求められます。テストの偏差値も同じ考え方で、偏差値 \(= 50 + 10 \times z\) です。 |
| 累積分布関数 | るいせきぶんぷかんすう | 「その値以下になる確率」を返す関数。標準正規分布のものは記号 \(\Phi\)(ファイ)で表し、範囲に入る確率は「上限までの \(\Phi\)」から「下限までの \(\Phi\)」を引いて求めます。 |
| 確率密度関数 | かくりつみつどかんすう | 分布の曲線そのものの式。曲線の高さは確率ではなく「確率の密度」で、曲線とヨコ軸で囲まれた範囲の面積が確率を表します。正規分布では釣り鐘型の曲線になります。 |
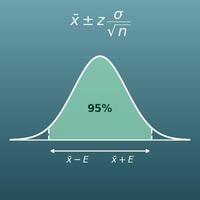
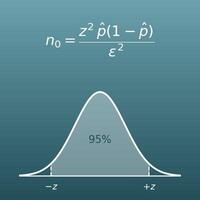
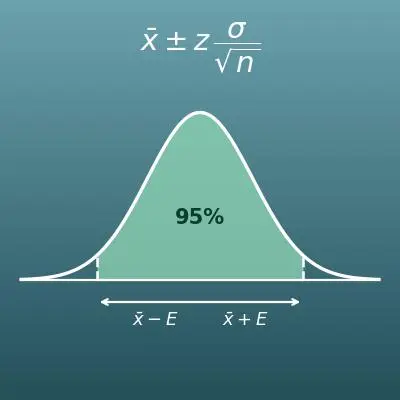
| 信頼区間 | しんらいくかん | 結果に表示される一覧表は、平均を中心に分布全体の◯%が入る範囲(\(\mu \pm z \times \sigma\))と倍率 \(z\) の対応表です。なお統計学で「95%信頼区間」というときは、本来は標本データから母平均などの真の値を推定した区間を指しますが、正規分布を仮定すると同じ \(z\) 値(95%なら1.96)を使うため、この表の \(z\) 値がそのまま役立ちます。アンケートや検査結果の「誤差の幅」の計算によく使われます。 |
| 68–95–99.7ルール | ろくはち・きゅうご・きゅうきゅうてんななルール | 正規分布では、平均 \(\pm 1\sigma\) に約68.3%、\(\pm 2\sigma\) に約95.4%、\(\pm 3\sigma\) に約99.7%のデータが入る、という覚えておくと便利な目安です。 |
| 中心極限定理 | ちゅうしんきょくげんていり | たくさんの小さな偶然が重なってできる量(合計や平均)は、元の分布によらず正規分布に近づく、という数学的な性質。世の中の多くのデータが正規分布に近くなる背景にある定理です。 |
前提として理解しておくといいこと
このページの計算を「意味がわかって」使えるようになるために、前提として理解しておくといいことをまとめました。
| 平均(小学5年) |
|
| データの分析・標準偏差(高校 数学I) |
|
| 割合と面積の見方(小学5年〜中学) |
|
| 標準化・z値(高校 数学B/統計) |
|
Excelで計算する方法
| 平均 μ | 62 |
| 標準偏差 σ | 14 |
| 範囲の下限 | 50 |
| 範囲の上限 | 80 |
| 下限〜上限の間に入る確率 | =NORM.DIST(B4,B1,B2,TRUE)-NORM.DIST(B3,B1,B2,TRUE) |
| 平均 μ | 62 |
| 標準偏差 σ | 14 |
| この値以上の割合を知りたい | 80 |
| その値以上になる確率 | =1-NORM.DIST(B3,B1,B2,TRUE) |
| 平均 μ | 62 |
| 標準偏差 σ | 14 |
| 高さを知りたい位置 x | 80 |
| その位置での曲線の高さ | =NORM.DIST(B3,B1,B2,FALSE) |
「範囲に入る確率」は、「上限以下の確率」から「下限以下の確率」を引いて求めます。
最後の引数をFALSEにすると、確率ではなくその位置での曲線の高さ(確率密度関数の値)が返ります。
貼り付けるとB列が入力欄になり、最後の行の数式が自動計算します。1つ目の表なら約0.70(約70%)、2つ目の表なら約0.10(約10%=上位約10%)と表示されます。
Googleスプレッドシートで計算する方法
| 平均 μ | 62 |
| 標準偏差 σ | 14 |
| 範囲の下限 | 50 |
| 範囲の上限 | 80 |
| 下限〜上限の間に入る確率 | =NORMDIST(B4,B1,B2,TRUE)-NORMDIST(B3,B1,B2,TRUE) |
| 平均 μ | 62 |
| 標準偏差 σ | 14 |
| この値以上の割合を知りたい | 80 |
| その値以上になる確率 | =1-NORMDIST(B3,B1,B2,TRUE) |
| 平均 μ | 62 |
| 標準偏差 σ | 14 |
| 高さを知りたい位置 x | 80 |
| その位置での曲線の高さ | =NORMDIST(B3,B1,B2,FALSE) |
NORMDIST(x, 平均, 標準偏差, TRUE) が「x以下になる確率」を返すので、上限の分から下限の分を引くと範囲内の確率になります。
最後の引数をFALSEにすると、確率ではなくその位置での曲線の高さ(確率密度)が返ります。
Pythonで計算する方法
from statistics import NormalDist

mean = 62               # 平均
standard_deviation = 14 # 標準偏差
lower_bound = 50        # 範囲の下限
upper_bound = 80        # 範囲の上限

distribution = NormalDist(mean, standard_deviation)
p_between = distribution.cdf(upper_bound) - distribution.cdf(lower_bound)

print(f"{lower_bound}から{upper_bound}の間に入る確率: {p_between}")
数式記述言語(LaTeX等)での書き方(コピペ可)
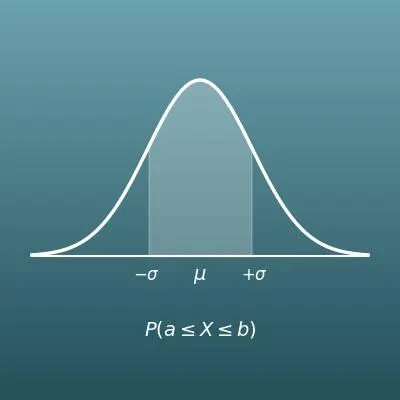
P(a ≤ X ≤ b) = Φ((b − μ)/σ) − Φ((a − μ)/σ)
P(a \le X \le b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>a</mi><mo>≤</mo><mi>X</mi><mo>≤</mo><mi>b</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>b</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
<mo>−</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>a</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
P(a <= X <= b) = Phi((b - mu)/sigma) - Phi((a - mu)/sigma)
CDF[NormalDistribution[mu, sigma], b] - CDF[NormalDistribution[mu, sigma], a]
with(Statistics): CDF(RandomVariable(Normal(mu, sigma)), b) - CDF(RandomVariable(Normal(mu, sigma)), a);
p = normcdf(b, mu, sigma) - normcdf(a, mu, sigma);
P(a ≤ X ≤ b) = Φ((b-μ)/σ) - Φ((a-μ)/σ)
f(x) = 1/(σ√(2π)) · e^(−(x − μ)²/(2σ²))
f(x) = \frac{1}{\sigma\sqrt{2\pi}}\, e^{-\frac{(x-\mu)^2}{2\sigma^2}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>f</mi><mo>(</mo><mi>x</mi><mo>)</mo>
<mo>=</mo>
<mfrac>
<mn>1</mn>
<mrow><mi>σ</mi><msqrt><mrow><mn>2</mn><mi>π</mi></mrow></msqrt></mrow>
</mfrac>
<msup>
<mi>e</mi>
<mrow>
<mo>−</mo>
<mfrac>
<msup><mrow><mo>(</mo><mi>x</mi><mo>−</mo><mi>μ</mi><mo>)</mo></mrow><mn>2</mn></msup>
<mrow><mn>2</mn><msup><mi>σ</mi><mn>2</mn></msup></mrow>
</mfrac>
</mrow>
</msup>
</mrow>
</math>
f(x) = 1/(sigma sqrt(2 pi)) e^(-(x - mu)^2 / (2 sigma^2))
PDF[NormalDistribution[mu, sigma], x]
with(Statistics): PDF(RandomVariable(Normal(mu, sigma)), x);
y = normpdf(x, mu, sigma);
f(x) = 1/(σ√(2π)) e^(-(x-μ)^2/(2σ^2))
ChatGPT に聞いて計算してもらう方法
あなたは確率の計算アシスタントです。次の計算を、必ずPythonコードを実際に実行して行い、実行結果の数値だけを根拠に回答してください(暗算や推測で答えないでください)。

あるテストの点数は、平均62点・標準偏差14点の正規分布に従うとします。
次の値をそれぞれ求めてください。
1. 点数が50点から80点の間に入る確率
2. 80点以上になる確率(上位何%か)
3. 50点以下になる確率

Pythonのstatistics.NormalDistを使い、計算に使ったコードと実行結果の数値を示してください。
計算ドリル(演習問題)
68–95–99.7ルール(平均 \(\pm 1\sigma\) に約68%、\(\pm 2\sigma\) に約95%、\(\pm 3\sigma\) に約99.7%)を使って解く演習問題です。
答えと解説は解答ページにあります。
使い方
-
1数値を入力計算したい数値を入力欄に入力します
-
2計算「計算する」ボタンを押します
-
3結果を確認計算結果がその場に表示されます。計算の考え方や式の解説も同じページで確認できます
DataChefの特徴

専門知識不要、直感的で簡単な操作
個人情報を登録することなく使用できます
「ダウンロード」押下でファイルを自動削除
クレジット表記不要
商用利用許諾の連絡も不要です
関連機能
2つの独立な事象の確率
2つの確率から「両方起こる」「少なくとも一方が起こる」確率などを計算します
2つの事象の確率(2つの値から残りを逆算)
わかっている2つの確率から、残りの確率をまとめて逆算します
くり返したときの確率
n回連続で起こる確率、n回中少なくとも1回は起こる確率を計算します