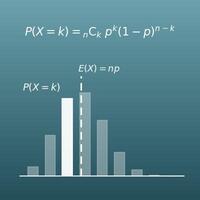Vul het gemiddelde, de standaardafwijking en de onder- en bovengrens van het gewenste bereik in. De rekenmachine berekent de kans om in dat bereik te vallen en een tabel met betrouwbaarheidsintervallen.
Inhoudsopgave
-
Wat je op deze pagina kunt doen
-
Waarvoor is deze berekening handig?
-
Zo werkt het
-
Formule en grafiek
-
Symbolen en begrippen
-
Handig om vooraf te weten
-
Berekenen met Excel
-
Berekenen met Google Spreadsheets
-
Berekenen met Python
-
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
-
Zo laat je ChatGPT de berekening doen
-
Kenmerken van DataChef
-
Gerelateerde functies
-
Alle rekenmachines van NumberChef
Wat je op deze pagina kunt doen
- Vul het gemiddelde \(\mu\) en de spreiding (de standaardafwijking \(\sigma\)) in en je ziet meteen de kans dat een waarde in een bepaald bereik valt
- Ook de kans om op of boven (of op of onder) een waarde te komen wordt berekend, zoals “Welk percentage van de leerlingen haalde 80 punten of meer?”
- Tegelijk zie je een tabel met de bereiken die in de statistiek vaak worden gebruikt (zoals het bereik waarin 95% van alle waarden ligt)
- Een uitleg in gewone taal van de normale verdeling en formules om te kopiëren voor Excel, Google Spreadsheets en Python staan ook op deze pagina
Waarvoor is deze berekening handig?
IQ-scores zijn zo gekozen dat het gemiddelde 100 is en één standaardafwijking 15 punten. In een normale verdeling zit slechts ongeveer 16% van de mensen op \(+1\sigma\) of hoger (een IQ van 115 of meer) en slechts ongeveer 2,3% op \(+2\sigma\) of hoger (130 of meer).
Als je dit verband ziet, is een percentiel bij gestandaardiseerde toetsen geen raadsel meer. Je kunt in getallen aflezen wat “10 punten erbij” of “het 90e percentiel” echt betekent, en niet alleen op gevoel.
De “referentiewaarden” bij bloedonderzoek en vergelijkbare labuitslagen worden vaak vastgesteld als het bereik waarin de middelste 95% van de metingen van gezonde mensen ligt (ongeveer het gemiddelde \(\pm 2\sigma\)).
Bij elke testwaarde valt dus ongeveer 5% van de gezonde mensen (1 op de 20) buiten de referentiewaarden. Bij een controle met veel waarden komt het zelfs vaak voor dat een gezond persoon op minstens één waarde afwijkt. Als je dit weet, begrijp je dat “een beetje buiten het bereik” niet automatisch betekent dat “er iets mis is”, en kun je de uitleg van je huisarts rustig aanhoren. Het is vooral handig als uitslagen je snel ongerust maken.
Het gewicht en de afmetingen van producten variëren op een manier die dicht bij een normale verdeling komt. Is de gemiddelde inhoud van zakjes bijvoorbeeld 102 g met een standaardafwijking van 1 g en is de ondergrens 100 g, dan liggen de zakjes onder de 100 g voorbij \(-2\sigma\), ongeveer 2,3%.
Fabrieken gebruiken deze berekening om het uitvalpercentage te voorspellen en om te bepalen waar ze het gemiddelde vulgewicht instellen (hoeveel extra erin gaat) om klachten en kosten tegen elkaar af te wegen.
Als je vergelijkt of ontwerp A of ontwerp B het hoogste doorklikpercentage heeft, gebruik je de normale verdeling (een betrouwbaarheidsinterval) om te beslissen of het verschil toeval is of een echt verschil.
De rij “0,95” in de tabel in het resultaat is precies het “95%-betrouwbaarheidsinterval” dat in de praktijk het vaakst wordt gebruikt. Achter beslissingen die grote geldbedragen verplaatsen, zoals advertentiebudgetten, wordt deze berekening elke dag gebruikt.
Beroepsmensen die actuarissen heten, schatten het risico op het uitkeren van schadeclaims als kansen en stellen daaruit verzekeringspremies vast.
Losse ongelukken kun je niet voorspellen, maar het totaal over veel verzekerden komt dicht bij een normale verdeling (de centrale limietstelling), dus de totale uitkering is verrassend nauwkeurig te voorspellen. Door deze wiskunde kunnen we voor een betaalbare premie een grote dekking krijgen.
Formule en grafiek
Symbolen en begrippen
Symbolen
| \(\mu\) | mu | Het gemiddelde. Het is de plek waar het midden van de piek van de verdeling ligt. Een Griekse letter die overeenkomt met de m. |
| \(\sigma\) | sigma | De standaardafwijking. Ze geeft de grootte van de spreiding van de gegevens aan en bepaalt de breedte van de piek. Hoe groter ze is, hoe lager en breder de piek. Een Griekse letter die overeenkomt met de s. |
| \(X\) | X (toevalsvariabele) | Een letter voor een grootheid waarvan de waarde elke keer kan veranderen als je meet, zoals een toetsscore of een lengte. |
| \(\Phi\) | hoofdletter fi | De cumulatieve verdelingsfunctie van de standaard normale verdeling (gemiddelde 0, standaardafwijking 1). Ze geeft de kans om die waarde of minder te krijgen. |
| \(z\) | z (z-score) | Een getal dat aangeeft hoeveel standaardafwijkingen een waarde van het gemiddelde ligt. Je vindt het met \(z = (x - \mu) \div \sigma\). |
| \(e\) | e (het getal van Euler) | Een constante, ongeveer 2,71828…, en het grondtal van de natuurlijke logaritme. Het is een bijzonder getal in het hart van exponentiële functies. |
| \(\pi\) | pi | Een constante, ongeveer 3,14159…, de verhouding tussen de omtrek van een cirkel en zijn middellijn. In de formule van de normale verdeling komt ze voor om de totale oppervlakte onder de kromme precies 1 te maken. |
Begrippen
| normale verdeling | Een verdeling die symmetrisch in een klokvorm rond het gemiddelde ligt. Ze wordt gebruikt als model voor gegevens waarbij waarden dicht bij het gemiddelde het vaakst voorkomen en waarden zeldzamer worden naarmate ze verder van het gemiddelde af liggen, zoals lengtes, toetsscores en het gewicht van producten. |
| standaardafwijking | Eén getal dat aangeeft hoe verspreid de gegevens zijn. Twee gegevensreeksen kunnen hetzelfde gemiddelde maar een verschillende spreiding hebben. Hoe groter de standaardafwijking, hoe lager en breder de piek van de verdeling. |
| standaardiseren (z-score) | Een waarde omschrijven naar “hoeveel standaardafwijkingen ligt die van het gemiddelde” (de \(z\)-score). Elke normale verdeling kun je na het standaardiseren behandelen met de ene standaard normale verdeling met gemiddelde 0 en standaardafwijking 1. IQ-scores gebruiken hetzelfde idee: IQ \(= 100 + 15 \times z\). |
| cumulatieve verdelingsfunctie | Een functie die de kans geeft om die waarde of minder te krijgen. Voor de standaard normale verdeling schrijf je ze als \(\Phi\) (fi). De kans op een bereik is “\(\Phi\) tot en met de bovengrens” min “\(\Phi\) tot en met de ondergrens”. |
| kansdichtheid | De formule voor de kromme van de verdeling zelf. De hoogte van de kromme is geen kans maar een kansdichtheid. De oppervlakte tussen de kromme en de horizontale as over een bereik is de kans. Bij de normale verdeling is het een klokvormige kromme. |
| betrouwbaarheidsinterval | De tabel in het resultaat geeft voor elk percentage het bereik rond het gemiddelde waarin dat deel van de hele verdeling ligt (\(\mu \pm z \times \sigma\)) en de bijbehorende factor \(z\). Strikt genomen is een “95%-betrouwbaarheidsinterval” in de statistiek een bereik voor de werkelijke waarde (zoals het populatiegemiddelde), geschat uit steekproefgegevens. Maar als je een normale verdeling aanneemt, gebruikt het dezelfde \(z\) (1,96 voor 95%), dus de \(z\)-waarden in deze tabel gelden direct. Het wordt vaak gebruikt om de “foutmarge” van enquêtes en testresultaten te berekenen. |
| 68-95-99,7-regel | Een handige vuistregel, ook wel de empirische regel genoemd: in een normale verdeling ligt ongeveer 68,3% van de gegevens binnen het gemiddelde \(\pm 1\sigma\), ongeveer 95,4% binnen \(\pm 2\sigma\) en ongeveer 99,7% binnen \(\pm 3\sigma\). |
| centrale limietstelling | Het wiskundige feit dat een grootheid die uit veel kleine toevallige effecten is opgebouwd (een som of een gemiddelde) dicht bij een normale verdeling komt, ongeacht de oorspronkelijke verdeling. Het is de reden dat zoveel gegevens uit de praktijk bij benadering een normale verdeling volgen. |
Handig om vooraf te weten
Dit is wat je helpt om de berekening op deze pagina echt te begrijpen, en niet alleen op de knop te drukken.
| Het gemiddelde (groep 7-8, 10-12 jaar) |
|
| Gegevens analyseren en standaardafwijking (bovenbouw havo/vwo, 15-18 jaar) |
|
| Aandelen lezen als oppervlakten (groep 8 en klas 1, 11-13 jaar) |
|
| Standaardiseren en z-scores (bovenbouw havo/vwo, 15-18 jaar) |
|
Berekenen met Excel
| Gemiddelde μ | 62 |
| Standaardafwijking σ | 14 |
| Ondergrens | 50 |
| Bovengrens | 80 |
| Kans tussen de grenzen | =NORM.VERD.N(B4;B1;B2;WAAR)-NORM.VERD.N(B3;B1;B2;WAAR) |
| Gemiddelde μ | 62 |
| Standaardafwijking σ | 14 |
| Waarde (zoek het aandeel op of boven die waarde) | 80 |
| Kans op die waarde of meer | =1-NORM.VERD.N(B3;B1;B2;WAAR) |
| Gemiddelde μ | 62 |
| Standaardafwijking σ | 14 |
| Punt x | 80 |
| Hoogte van de kromme op dat punt | =NORM.VERD.N(B3;B1;B2;ONWAAR) |
De kans op een bereik is “de kans op de bovengrens of minder” min “de kans op de ondergrens of minder”.
Zet je het laatste argument op ONWAAR, dan krijg je in plaats van een kans de hoogte van de kromme op dat punt (de waarde van de kansdichtheid).
Na het plakken bevat kolom B je invoer en rekent de formule in de laatste rij automatisch. De eerste tabel toont ongeveer 0,70 (ongeveer 70%) en de tweede ongeveer 0,10 (ongeveer 10%, dus de bovenste 10% of zo).
Berekenen met Google Spreadsheets
| Gemiddelde μ | 62 |
| Standaardafwijking σ | 14 |
| Ondergrens | 50 |
| Bovengrens | 80 |
| Kans tussen de grenzen | =NORM.VERD(B4;B1;B2;WAAR)-NORM.VERD(B3;B1;B2;WAAR) |
| Gemiddelde μ | 62 |
| Standaardafwijking σ | 14 |
| Waarde (zoek het aandeel op of boven die waarde) | 80 |
| Kans op die waarde of meer | =1-NORM.VERD(B3;B1;B2;WAAR) |
| Gemiddelde μ | 62 |
| Standaardafwijking σ | 14 |
| Punt x | 80 |
| Hoogte van de kromme op dat punt | =NORM.VERD(B3;B1;B2;ONWAAR) |
NORM.VERD(x; gemiddelde; standaardafwijking; WAAR) geeft de kans om x of minder te krijgen, dus de waarde voor de bovengrens min de waarde voor de ondergrens is de kans op het bereik.
Zet je het laatste argument op ONWAAR, dan krijg je in plaats van een kans de hoogte van de kromme op dat punt (de kansdichtheid).
Berekenen met Python
from statistics import NormalDist

mean = 62               # gemiddelde
standard_deviation = 14 # standaardafwijking
lower_bound = 50        # ondergrens van het bereik
upper_bound = 80        # bovengrens van het bereik

distribution = NormalDist(mean, standard_deviation)
p_between = distribution.cdf(upper_bound) - distribution.cdf(lower_bound)

print(f"Kans tussen {lower_bound} en {upper_bound}: {p_between}")
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
P(a ≤ X ≤ b) = Φ((b − μ)/σ) − Φ((a − μ)/σ)
P(a \le X \le b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>a</mi><mo>≤</mo><mi>X</mi><mo>≤</mo><mi>b</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>b</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
<mo>−</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>a</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
P(a <= X <= b) = Phi((b - mu)/sigma) - Phi((a - mu)/sigma)
CDF[NormalDistribution[mu, sigma], b] - CDF[NormalDistribution[mu, sigma], a]
with(Statistics): CDF(RandomVariable(Normal(mu, sigma)), b) - CDF(RandomVariable(Normal(mu, sigma)), a);
p = normcdf(b, mu, sigma) - normcdf(a, mu, sigma);
P(a ≤ X ≤ b) = Φ((b-μ)/σ) - Φ((a-μ)/σ)
f(x) = 1/(σ√(2π)) · e^(−(x − μ)²/(2σ²))
f(x) = \frac{1}{\sigma\sqrt{2\pi}}\, e^{-\frac{(x-\mu)^2}{2\sigma^2}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>f</mi><mo>(</mo><mi>x</mi><mo>)</mo>
<mo>=</mo>
<mfrac>
<mn>1</mn>
<mrow><mi>σ</mi><msqrt><mrow><mn>2</mn><mi>π</mi></mrow></msqrt></mrow>
</mfrac>
<msup>
<mi>e</mi>
<mrow>
<mo>−</mo>
<mfrac>
<msup><mrow><mo>(</mo><mi>x</mi><mo>−</mo><mi>μ</mi><mo>)</mo></mrow><mn>2</mn></msup>
<mrow><mn>2</mn><msup><mi>σ</mi><mn>2</mn></msup></mrow>
</mfrac>
</mrow>
</msup>
</mrow>
</math>
f(x) = 1/(sigma sqrt(2 pi)) e^(-(x - mu)^2 / (2 sigma^2))
PDF[NormalDistribution[mu, sigma], x]
with(Statistics): PDF(RandomVariable(Normal(mu, sigma)), x);
y = normpdf(x, mu, sigma);
f(x) = 1/(σ√(2π)) e^(-(x-μ)^2/(2σ^2))
Zo laat je ChatGPT de berekening doen
Je bent een assistent voor kansberekening. Voer de volgende berekening uit door echt Python-code uit te voeren, en baseer je antwoord alleen op de getallen uit het uitvoerresultaat (geen hoofdrekenen of gokken).

De scores van een toets volgen een normale verdeling met een gemiddelde van 62 punten en een standaardafwijking van 14 punten.
Zoek elk van de volgende waarden:
1. De kans dat een score tussen 50 en 80 punten ligt
2. De kans dat een score 80 punten of meer is (de bovenste hoeveel procent)
3. De kans dat een score 50 punten of minder is

Gebruik statistics.NormalDist van Python en laat de code zien die je hebt gebruikt en de getallen uit het uitvoerresultaat.
Zo werkt het
-
1Vul je getallen inTyp de getallen waarmee je wilt rekenen in de invoervelden
-
2BerekenKlik op de knop “Berekenen”
-
3Bekijk het resultaatHet resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
Kenmerken van DataChef

Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Zonder persoonlijke gegevens op te geven

Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt


Geen bronvermelding vereist

Geen toestemming vooraf nodig
Gerelateerde functies
Kans op twee gebeurtenissen (en, of, geen van beide)
Berekent uit twee kansen de kans dat beide gebeuren, dat minstens één gebeurt, en meer
Kans op twee gebeurtenissen terugrekenen (ontbrekende waarden)
Rekent uit de twee kansen die je kent alle andere kansen terug
Kans bij herhaling (n keer achter elkaar, minstens één keer)
Berekent de kans dat iets n keer achter elkaar gebeurt, of minstens één keer in n pogingen