Vul de grootte van de steekproef, het steekproefgemiddelde, de standaardafwijking en het betrouwbaarheidsniveau in. De rekenmachine berekent het betrouwbaarheidsinterval voor het populatiegemiddelde (onder- en bovengrens), de foutmarge en een tabel voor gangbare betrouwbaarheidsniveaus.
Inhoudsopgave
-
Wat je op deze pagina kunt doen
-
Waarvoor is deze berekening handig?
-
Zo werkt het
-
Formule en grafiek
-
Symbolen en begrippen
-
Handig om vooraf te weten
-
Berekenen met Excel
-
Berekenen met Google Spreadsheets
-
Berekenen met Python
-
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
-
Zo laat je ChatGPT de berekening doen
-
Kenmerken van DataChef
-
Gerelateerde functies
-
Alle rekenmachines van NumberChef
Wat je op deze pagina kunt doen
- Vul de grootte van de steekproef \(n\), het steekproefgemiddelde \(\bar{x}\), de standaardafwijking \(\sigma\) en het betrouwbaarheidsniveau (%) in en je ziet meteen het betrouwbaarheidsinterval voor het populatiegemiddelde (onder- en bovengrens)
- Ook de foutmarge \(E\) (hoever de schatting naar boven of beneden kan afwijken), de standaardfout en de kritieke waarde z voor het betrouwbaarheidsniveau worden berekend
- Bekijk de betrouwbaarheidsintervallen bij gangbare betrouwbaarheidsniveaus zoals 90%, 95% en 99% in één tabel en zie in een grafiek hoe het interval breder wordt
- Een uitleg van de formules in gewone taal en formules om te kopiëren voor Excel, Google Spreadsheets en Python staan ook op deze pagina
Waarvoor is deze berekening handig?
De “foutmarge” in een peilingresultaat zoals “45% is tevreden over het kabinet (foutmarge ±2,5 procentpunt)” is precies de foutmarge \(E\) op deze pagina. Bij een peiling met 45% tevredenen en 1.600 ondervraagden is de spreiding \(\sigma = \sqrt{0{,}45 \times 0{,}55} \approx 0{,}497\), dus bij een betrouwbaarheidsniveau van 95% is \(E = 1{,}96 \times 0{,}497 \div \sqrt{1600} \approx 0{,}024\) (ongeveer ±2,4 procentpunt). Dit gaat ervan uit dat het aandeel antwoorden kan worden benaderd met een normale verdeling. De “±2,5 procentpunt” in nieuwsberichten komt overeen met een schatting bij 50%, waar de spreiding het grootst is.
Zo kun je zelf beoordelen of het nieuws dat “het aandeel met 1 procentpunt is verschoven” binnen de foutmarge valt.
Een fabriek kan niet elke fles openmaken en meten, dus ze controleert een steekproef. Als 50 flessen (met de opdruk 500 ml) gemiddeld 500,2 ml bevatten met een standaardafwijking van 2 ml, dan is het 95%-betrouwbaarheidsinterval voor de gemiddelde inhoud van alles wat is geproduceerd ongeveer 499,65 tot 500,75 ml.
Met alleen steekproefcontroles statistisch nagaan dat producten niet onder de vermelde hoeveelheid zitten, is een berekening die elke dag wordt gebruikt in de voedingsmiddelen-, drank- en geneesmiddelenindustrie.
Resultaten in medische artikelen worden bijna altijd met een betrouwbaarheidsinterval gerapporteerd, zoals in “het nieuwe medicijn verlaagde de bloeddruk gemiddeld met 8,0 mmHg (95%-betrouwbaarheidsinterval: 5,6 tot 10,4)”. In een onderzoek met 100 personen waarin de dalingen een standaardafwijking van 12 mmHg hebben, is \(E = 1{,}96 \times 12 \div \sqrt{100} \approx 2{,}4\).
Ligt het hele interval aan de plus-kant (het bevat geen 0), dan ondersteunt dat “het medicijn had effect”. Bevat het interval wel 0, lees het dan als “het kan toeval zijn”. Dit is een van de belangrijkste manieren om gezondheidsinformatie zelf te beoordelen.
Elke leerling in het land testen is een enorm karwei, dus landelijke onderzoeken naar fitheid en leerprestaties gebeuren vaak met steekproeven. Heeft een steekproef van 400 leerlingen bijvoorbeeld een gemiddelde tijd van 9,2 seconden op de 50 meter sprint met een standaardafwijking van 0,8 seconde, dan is het 95%-betrouwbaarheidsinterval voor de gemiddelde tijd van alle leerlingen ongeveer 9,12 tot 9,28 seconden. Slechts 400 leerlingen geven een vrij smal bereik.
Ook overheidsstatistieken, zoals de Enquête beroepsbevolking van het CBS waarop de werkloosheidscijfers zijn gebaseerd, berusten vooral op steekproeven, en deze berekening onderbouwt hoe nauwkeurig ze zijn.
Als de gemiddelde tijd op je site stijgt van 180 seconden naar 184 seconden, is dat dan het effect van je aanpassing of gewoon toeval? Met 2.500 bezoekers en een standaardafwijking van 90 seconden is het 95%-betrouwbaarheidsinterval voor de gemiddelde tijd ongeveer 176,5 tot 183,5 seconden, dus er is een marge van ongeveer ±3,5 seconden.
Is een verandering ongeveer even groot als de breedte van het betrouwbaarheidsinterval, dan kun je zeggen dat ze “nog niet van toeval te onderscheiden is”. Dit idee is de basis om de resultaten van A/B-tests niet verkeerd te lezen.
Formule en grafiek
Symbolen en begrippen
Symbolen
| \(n\) | n | De grootte van de steekproef: hoeveel stuks of mensen je echt hebt gemeten. (Voorbeeld: meet je 50 flessen, dan is \(n = 50\)) |
| \(\bar{x}\) | x-streep | Het steekproefgemiddelde, het gemiddelde van de steekproef die je hebt gemeten. De streep erboven is het teken voor een gemiddelde. |
| \(\sigma\) | sigma | De standaardafwijking van de populatie, de grootte van de spreiding in de hele populatie. Een Griekse letter die overeenkomt met de s. Is de steekproef groot genoeg, dan kun je in plaats daarvan de standaardafwijking van de steekproef gebruiken. |
| \(\sqrt{n}\) | wortel uit n | De wortel uit de grootte van de steekproef (voorbeeld: \(\sqrt{25} = 5\)). Ze staat in de noemer van de standaardfout, en ze is de reden dat 4 keer zoveel gegevens de fout alleen maar halveert. |
| \(z\) | zet (kritieke waarde) | De factor die door het betrouwbaarheidsniveau wordt bepaald. Het is de grens in de standaard normale verdeling waartussen precies het betrouwbaarheidsniveau in het midden ligt. Voor 95% is het ongeveer 1,96. Ze wordt ook z* geschreven. |
| \(E\) | E | De foutmarge. Ze is de helft van de breedte van het betrouwbaarheidsinterval en een maat voor hoever het steekproefgemiddelde naar boven of beneden van het populatiegemiddelde kan afwijken. E staat voor “error” (fout). |
| \(L,\ U\) | L, U | De onder- en bovengrens van het betrouwbaarheidsinterval, te vinden met \(L = \bar{x} - E\) en \(U = \bar{x} + E\). |
| \(\Phi^{-1}\) | fi invers (inverse van Φ) | De functie die andersom werkt dan \(\Phi\), de cumulatieve verdelingsfunctie van de standaard normale verdeling. Ze neemt een kans (oppervlakte) en geeft de bijbehorende z. (Voorbeeld: \(\Phi^{-1}(0{,}975) \approx 1{,}96\)) |
| \(C\) | C | Het betrouwbaarheidsniveau als decimaal getal. Voor 95% is \(C = 0{,}95\). |
Begrippen
| betrouwbaarheidsinterval | Een bereik dat uit steekproefgegevens is geschat en waarin het populatiegemiddelde waarschijnlijk ligt. Je maakt het door het steekproefgemiddelde met de foutmarge naar boven en beneden uit te breiden. |
| betrouwbaarheidsniveau | Hoe zeker je van het interval kunt zijn. Het is het deel van de intervallen dat het populatiegemiddelde zou bevatten als je steeds op dezelfde manier intervallen maakte. 95% wordt het meest gebruikt. Het heet ook wel betrouwbaarheidscoëfficiënt. |
| populatie | De hele groep die je eigenlijk zou willen onderzoeken. (Voorbeelden - alle flessen die een fabriek maakt, of alle kiezers in het land) |
| steekproef | Het deel van de populatie dat je echt uitkiest en onderzoekt. Met een steekproef afleiden hoe de populatie eruitziet is waar het schatten in de statistiek om draait. |
| populatiegemiddelde | Het gemiddelde van de hele populatie. Je kunt niet alles meten, dus de precieze waarde is onbekend. Een betrouwbaarheidsinterval schat waar deze onbekende waarde ligt. Het wordt meestal \(\mu\) (mu) geschreven. |
| steekproefgemiddelde | Het gemiddelde van de steekproef, \(\bar{x}\). Het is de meest waarschijnlijke schatting in één getal van het populatiegemiddelde (een puntschatting), maar het verandert elke keer een beetje, afhankelijk van welke steekproef je toevallig trekt. |
| standaardfout | De grootte van de spreiding van het steekproefgemiddelde zelf, te vinden met \(\sigma \div \sqrt{n}\). Je verwart haar makkelijk met de spreiding van de afzonderlijke gegevenswaarden (de standaardafwijking), dus pas op. |
| intervalschatting | Een manier om een onbekende waarde zoals het populatiegemiddelde te schatten met een bereik in plaats van met één getal. Vergeleken met een puntschatting is het voordeel dat het ook laat zien hoe ver de schatting ernaast kan zitten. |
| t-verdeling | De verdeling die je gebruikt in plaats van de normale verdeling (z) als de steekproef klein is en de standaardafwijking van de populatie onbekend. De rekenmachine op deze pagina ondersteunt alleen de z-methode. Naarmate de steekproef groter wordt, komt de t-verdeling dichter bij de normale verdeling en worden de resultaten bijna gelijk. |
Handig om vooraf te weten
Dit is wat je helpt om de berekening op deze pagina echt te begrijpen, en niet alleen op de knop te drukken.
| Het gemiddelde (groep 7-8, 10-12 jaar) |
|
| Wortels (klas 3, 14-15 jaar) |
|
| Steekproeven (klas 2-3, 13-15 jaar) |
|
| Gegevens analyseren en standaardafwijking (bovenbouw havo/vwo, 15-18 jaar) |
|
| De normale verdeling en intervalschattingen (bovenbouw havo/vwo, 16-18 jaar) |
|
Berekenen met Excel
| Betrouwbaarheid (%) | 95 |
| z | =NORM.S.INV((1+B1/100)/2) |
| z | 1,96 |
| Standaardafwijking σ | 2 |
| Grootte van de steekproef n | 25 |
| Foutmarge E | =B1*B2/WORTEL(B3) |
| Grootte van de steekproef n | 50 |
| Steekproefgemiddelde x̄ | 500,2 |
| Standaardafwijking σ | 2 |
| Betrouwbaarheid (%) | 95 |
| z | =NORM.S.INV((1+B4/100)/2) |
| Foutmarge E | =B5*B3/WORTEL(B1) |
| Ondergrens | =B2-B6 |
| Bovengrens | =B2+B6 |
De eerste tabel vindt z alleen uit het betrouwbaarheidsniveau (B1); vul 95 in en B2 is ongeveer 1,959964. De tweede tabel is de foutmarge; met de voorbeeldwaarden is B4 gelijk aan 0,784.
De derde tabel vindt het betrouwbaarheidsinterval uit alle invoer tegelijk. Met de voorbeeldwaarden (n = 50, x̄ = 500,2, σ = 2, 95%) is de ondergrens (B7) ongeveer 499,6456 en de bovengrens (B8) ongeveer 500,7544. Vervang gewoon B1 tot en met B4 door je eigen getallen.
Berekenen met Google Spreadsheets
| Betrouwbaarheid (%) | 95 |
| z | =STAND.NORM.INV((1+B1/100)/2) |
| z | 1,96 |
| Standaardafwijking σ | 2 |
| Grootte van de steekproef n | 25 |
| Foutmarge E | =B1*B2/WORTEL(B3) |
| Grootte van de steekproef n | 50 |
| Steekproefgemiddelde x̄ | 500,2 |
| Standaardafwijking σ | 2 |
| Betrouwbaarheid (%) | 95 |
| z | =STAND.NORM.INV((1+B4/100)/2) |
| Foutmarge E | =B5*B3/WORTEL(B1) |
| Ondergrens | =B2-B6 |
| Bovengrens | =B2+B6 |
Kopieer de hele tabel, plak ze in cel A1 en vervang de getallen in kolom B door je eigen getallen. De resultaten zijn dezelfde als in de Excel-versie: in de derde tabel is de ondergrens ongeveer 499,6456 en de bovengrens ongeveer 500,7544.
Berekenen met Python
import math
from statistics import NormalDist

sample_size = 50        # steekproefgrootte n
sample_mean = 500.2     # steekproefgemiddelde x̄
sd = 2                  # standaardafwijking σ
confidence_level = 95   # betrouwbaarheidsniveau (%)

z = NormalDist().inv_cdf((1 + confidence_level / 100) / 2)  # kritieke waarde z voor het betrouwbaarheidsniveau
standard_error = sd / math.sqrt(sample_size)                # standaardfout σ ÷ √n
margin_of_error = z * standard_error                        # foutmarge E
lower = sample_mean - margin_of_error                       # ondergrens van het betrouwbaarheidsinterval
upper = sample_mean + margin_of_error                       # bovengrens van het betrouwbaarheidsinterval

print(f"z: {z}")
print(f"Foutmarge E: {margin_of_error}")
print(f"{confidence_level}%-betrouwbaarheidsinterval: {lower} tot {upper}")
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
E = z × σ ÷ √n
E = z \times \dfrac{\sigma}{\sqrt{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi>
<mo>=</mo>
<mi>z</mi>
<mo>×</mo>
<mfrac>
<mi>σ</mi>
<msqrt><mi>n</mi></msqrt>
</mfrac>
</mrow>
</math>
E = z sigma / sqrt(n)
z*sigma/Sqrt[n]
E := z*sigma/sqrt(n);
E = z*sigma/sqrt(n);
E = zσ/√n
L = x̄ − E, U = x̄ + E
L = \bar{x} - E,\quad U = \bar{x} + E
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>L</mi>
<mo>=</mo>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>−</mo>
<mi>E</mi>
<mo>,</mo>
<mspace width="1em"/>
<mi>U</mi>
<mo>=</mo>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>+</mo>
<mi>E</mi>
</mrow>
</math>
L = bar x - E, U = bar x + E
{xbar - e, xbar + e}
L := xbar - E; U := xbar + E;
L = xbar - E; U = xbar + E;
L = x̄ - E, U = x̄ + E
z = Φ⁻¹((1 + C) ÷ 2)
z = \Phi^{-1}\!\left(\dfrac{1+C}{2}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi>
<mo>=</mo>
<msup><mi>Φ</mi><mrow><mo>−</mo><mn>1</mn></mrow></msup>
<mrow>
<mo>(</mo>
<mfrac>
<mrow><mn>1</mn><mo>+</mo><mi>C</mi></mrow>
<mn>2</mn>
</mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
z = Phi^-1((1 + C)/2)
InverseCDF[NormalDistribution[0, 1], (1 + c)/2]
with(Statistics): Quantile(RandomVariable(Normal(0, 1)), (1 + c)/2);
z = norminv((1 + c)/2);
z = Φ^(-1)((1+C)/2)
Zo laat je ChatGPT de berekening doen
Je bent een assistent voor statistische berekeningen. Voer de volgende berekening uit door echt Python-code uit te voeren, en baseer je antwoord alleen op de getallen uit het uitvoerresultaat (geen hoofdrekenen of gokken).

Er zijn 50 flessen van een productielijn gehaald en hun inhoud is gemeten. Het gemiddelde was 500,2 ml. De spreiding van de vulhoeveelheid (de standaardafwijking van de populatie) is bekend: 2 ml.
1. Bereken de kritieke waarde z voor een betrouwbaarheidsniveau van 95% (gebruik de inverse van de cumulatieve verdelingsfunctie van de standaardnormale verdeling; je mag statistics.NormalDist().inv_cdf uit de standaardbibliotheek van Python gebruiken).
2. Bereken de foutmarge E = z × σ ÷ √n.
3. Bereken het 95%-betrouwbaarheidsinterval (onder- en bovengrens) voor het populatiegemiddelde (de werkelijke gemiddelde inhoud van alle flessen).

Laat de formules zien die je hebt gebruikt en de getallen uit het uitvoerresultaat.
Zo werkt het
-
1Vul je getallen inTyp de getallen waarmee je wilt rekenen in de invoervelden
-
2BerekenKlik op de knop “Berekenen”
-
3Bekijk het resultaatHet resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
Kenmerken van DataChef

Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Zonder persoonlijke gegevens op te geven

Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt


Geen bronvermelding vereist

Geen toestemming vooraf nodig
Gerelateerde functies
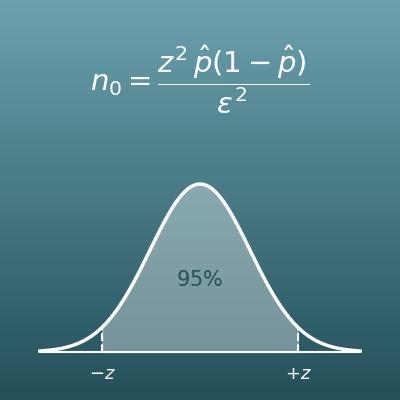
Steekproefgrootte berekenen (enquête, foutmarge en betrouwbaarheid)
Berekent uit de foutmarge die je accepteert en het betrouwbaarheidsniveau hoe groot de steekproef van een onderzoek moet zijn
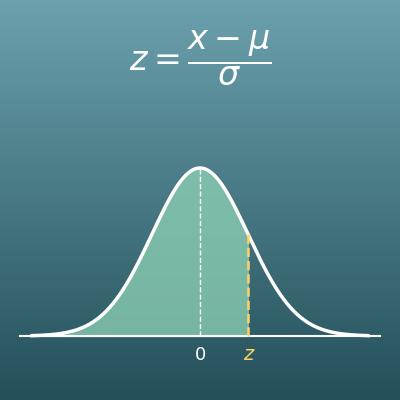
Z-score berekenen: z-score naar kans en terug
Berekent de z-score (standaardscore) uit een waarde, gemiddelde en standaardafwijking en rekent die om naar een kans en terug
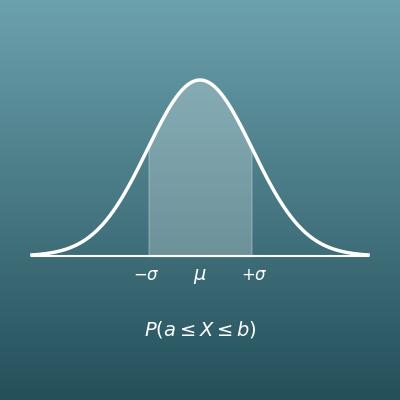
Normale verdeling berekenen (kans tussen twee waarden en z-tabel)
Berekent uit het gemiddelde en de standaardafwijking de kans op een bepaald bereik