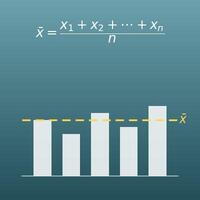Vul de waarden van je gegevens in, gescheiden door puntkomma’s (;). Het gemiddelde (rekenkundig gemiddelde), de mediaan, de modus en de variatiebreedte worden samen berekend, met de gegevens van klein naar groot gesorteerd.
Inhoudsopgave
-
Wat je op deze pagina kunt doen
-
Waarvoor is deze berekening handig?
-
Zo werkt het
-
Formule
-
Symbolen en begrippen
-
Handig om vooraf te weten
-
Berekenen met Excel
-
Berekenen met Google Spreadsheets
-
Berekenen met Python
-
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
-
Zo laat je ChatGPT de berekening doen
-
Kenmerken van DataChef
-
Gerelateerde functies
-
Alle rekenmachines van NumberChef
Wat je op deze pagina kunt doen
- Vul getallen in, gescheiden door puntkomma’s (;), en je krijgt in één keer vier maten: het gemiddelde (rekenkundig gemiddelde), de mediaan, de modus en de variatiebreedte
- De modus (de waarde die het vaakst voorkomt) wordt automatisch geteld. Ook gegevens met twee of meer modi (bimodaal of multimodaal) en gegevens waarin elke waarde één keer voorkomt, zodat er geen modus is, worden goed verwerkt
- De gegevens van klein naar groot gesorteerd, het maximum, het minimum, de som en het aantal worden ook getoond, zodat je de mediaan en de variatiebreedte zelf kunt controleren
- Een heldere uitleg van “Wanneer gebruik ik het gemiddelde, de mediaan of de modus?” en formules om te kopiëren voor Excel, Google Spreadsheets en Python staan ook op deze pagina
Waarvoor is deze berekening handig?
Stel dat een winkel op één dag 7 paar schoenen verkoopt, in maat 39, 40, 39, 41, 40, 39 en 43. Het gemiddelde is ongeveer maat 40,1, maar wat de winkel meer moet inkopen is de maat die het best verkoopt, en dat is de modus: maat 39 (3 paar).
Beslis je wat je bestelt of op voorraad houdt op basis van “wat het best verkoopt”, zoals bij maten, kleuren of modellen, dan is de modus, en niet het gemiddelde, het getal dat telt.
Stel dat vijf huishoudens een spaargeld hebben van € 30.000, € 30.000, € 40.000, € 50.000 en € 400.000. Het gemiddelde is € 110.000, maar de mediaan is € 40.000 en de modus is € 30.000.
Bij scheve gegevens zoals spaargeld of inkomen trekken een paar grote waarden het gemiddelde omhoog, dus de mediaan of de modus ligt dichter bij wat een typisch huishouden heeft. Daarom publiceert het CBS het inkomen van huishoudens zowel het gemiddelde als de mediaan. Als je het verschil kent, laat je je niet misleiden als je in het nieuws over een “gemiddelde” leest.
Bij een stemming onder een klas van 30 leerlingen over de favoriete lunch bij het schooluitje, met pannenkoeken 12 stemmen, patat 10 en broodje kroket 8, is de typische keuze de modus, “pannenkoeken”. Je kunt van lunchgerechten geen gemiddelde of mediaan berekenen.
De modus is de enige centrummaat die je kunt gebruiken voor gegevens die geen getallen zijn (categorische gegevens). Van productenquêtes tot verkiezingsuitslagen is het een van de meest gebruikte basisprincipes van het samenvatten van gegevens.
In fabrieken worden regelmatig een paar producten van de lijn gehaald en gemeten op afmeting of gewicht, en wordt de variatiebreedte (maximum − minimum) van elke kleine steekproef genoteerd en bewaakt. Dit heet een R-kaart (een regelkaart voor de variatiebreedte) en wordt veel gebruikt (regelkaarten zijn een van de zeven basisgereedschappen van kwaliteitsbeheer).
Wordt de variatiebreedte plotseling groter, dan is dat een teken dat er iets mis is, zoals een los machineonderdeel of ongelijk materiaal. Omdat één aftrekking de spreiding laat zien, wordt het dagelijks op de fabrieksvloer gebruikt.
Ook al is het klasgemiddelde een 6,0, de klas kan zijn verdeeld in een groep die het goed deed (rond de 8) en een groep die moeite had (rond de 4), met bijna niemand in de buurt van de 6 (een bimodale verdeling).
Beoordeel niet alleen op het gemiddelde, maar kijk ook naar de modus, de mediaan en de spreiding van de cijfers (de variatiebreedte). Dan kun je hulp plannen die past bij de echte situatie van de klas.
Formule
Symbolen en begrippen
Symbolen
| \(x_1, x_2, \ldots, x_n\) | x index 1, x index 2, …, x index n | De afzonderlijke gegevens. (Voorbeeld: de cijfers van 5 toetsen) |
| \(n\) | n | Het aantal waarden. (Voorbeeld: bij 5 toetsen is \(n = 5\)) |
| \(\bar{x}\) | x-streep | Het gemiddelde (rekenkundig gemiddelde). Een streep boven de letter is de standaardmanier om een gemiddelde in de statistiek te schrijven. Het gemiddelde van een hele populatie schrijf je in plaats daarvan als \(\mu\) (mu). |
| \(\tilde{x}\) | x-tilde | De mediaan. Schoolboeken schrijven vaak gewoon het woord “mediaan” in plaats van een symbool, en soms staat er een letter voor (zoals M of Med). |
| \(M_o\) | M index o (modus) | De modus, een verkorting van het woord “modus”. Ook geschreven als Mo. Schoolboeken schrijven meestal gewoon het woord in plaats van een symbool. |
| \(f(x)\) | f van x | Hoe vaak de waarde \(x\) in de gegevens voorkomt (de frequentie). (Voorbeeld: komt 7,0 twee keer voor, dan is \(f(7{,}0) = 2\)) |
| \(f_{\max}\) | f max | De grootste frequentie (het hoogste aantal keren). Een modus is een waarde waarvan de frequentie gelijk is aan dit getal. |
| \(x_{(k)}\) | x index k tussen haakjes | De \(k\)-de waarde als de gegevens van klein naar groot gesorteerd zijn. (Voorbeeld: \(x_{(1)}\) is het minimum) |
| \(x_{\max},\ x_{\min}\) | x max, x min | Het maximum en het minimum van de gegevens. Ze zijn de invoer van de formule voor de variatiebreedte. |
| \(R\) | R | De variatiebreedte, het maximum min het minimum. De letter komt van het Engelse “range”. |
Begrippen
| centrummaat | Eén getal dat samenvat waar het midden van de gegevens ligt. De drie belangrijkste zijn het gemiddelde, de mediaan en de modus. Op school leer je ze meestal in de onderbouw van het voortgezet onderwijs. |
| rekenkundig gemiddelde | Alle gegevens opgeteld en gedeeld door het aantal waarden. Dit bedoelen mensen meestal met “gemiddelde”. Omdat het elke waarde gebruikt, wordt het makkelijk door uitschieters beïnvloed. |
| mediaan | De waarde precies in het midden als de gegevens van klein naar groot gesorteerd zijn. Bij een even aantal waarden neem je het gemiddelde van de twee middelste waarden. Het is een centrummaat waar uitschieters nauwelijks invloed op hebben. |
| modus | De waarde die het vaakst in de gegevens voorkomt. Hebben meerdere waarden de hoogste frequentie, dan zijn ze allemaal een modus (meervoud: modi). Komt elke waarde één keer voor, dan is er geen modus. Het is de enige centrummaat die ook voor categorische gegevens werkt. |
| variatiebreedte | Het maximum min het minimum. De snelste maat voor hoe ver de gegevens uit elkaar liggen. Ook wel spreidingsbreedte genoemd. |
| frequentie | Hoe vaak een waarde (of een klasse) in de gegevens voorkomt. De modus is de waarde met de hoogste frequentie. |
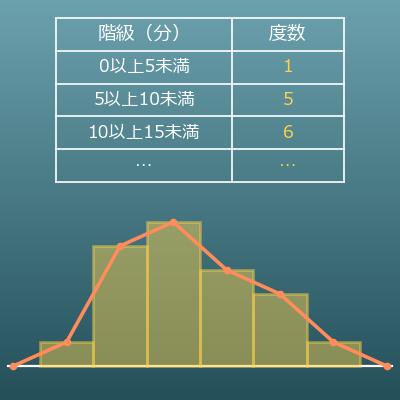
| frequentietabel | Een tabel die de gegevens verdeelt in klassen (klasse, zoals “60 tot 70”) en de frequentie van elke klasse telt. Bij fijn gespreide gegevens, zoals lengte, zie je de modus als de klasse met de hoogste frequentie. |
| klasse | In een frequentietabel een van de intervallen, zoals “60 tot 70”, waarin de gegevens worden verdeeld (niet te verwarren met een schoolklas). Het midden van een klasse heet het klassenmidden, en bij fijn gespreide gegevens neem je als modus het klassenmidden van de klasse met de hoogste frequentie. |
| bimodaal (multimodaal) | Als de verdeling van de gegevens twee (of meer) pieken heeft. Meer dan één modus is een teken hiervan, en de gegevens kunnen een mengsel zijn van twee groepen met verschillende kenmerken. |
| uitschieter | Een waarde die extreem ver van de andere waarden ligt. Het gemiddelde en de variatiebreedte worden sterk door uitschieters beïnvloed, maar de mediaan en de modus nauwelijks. |
Handig om vooraf te weten
Dit helpt je om de berekening op deze pagina echt te begrijpen en niet alleen op de knop te drukken.
| Optellen, aftrekken en delen (groep 4 tot 6, 7-10 jaar) |
|
| Het gemiddelde (groep 7, 10-11 jaar) |
|
| Statistiek en centrummaten (klas 1 tot 2, 12-14 jaar) |
|
| Frequentietabellen en histogrammen (klas 1 tot 2, 12-14 jaar) |
|
Berekenen met Excel
| Waarde 1 | 6 |
| Waarde 2 | 7 |
| Waarde 3 | 7 |
| Waarde 4 | 8 |
| Waarde 5 | 9,5 |
| Modus | =MODUS.ENKELV(B1:B5) |
| Waarde 1 | 6 |
| Waarde 2 | 7 |
| Waarde 3 | 7 |
| Waarde 4 | 8 |
| Waarde 5 | 9,5 |
| Som | =SOM(B1:B5) |
| Aantal | =AANTAL(B1:B5) |
| Gemiddelde (rekenkundig gemiddelde) | =GEMIDDELDE(B1:B5) |
| Waarde 1 | 6 |
| Waarde 2 | 7 |
| Waarde 3 | 7 |
| Waarde 4 | 8 |
| Waarde 5 | 9,5 |
| Mediaan | =MEDIAAN(B1:B5) |
| Waarde 1 | 6 |
| Waarde 2 | 7 |
| Waarde 3 | 7 |
| Waarde 4 | 8 |
| Waarde 5 | 9,5 |
| Maximum | =MAX(B1:B5) |
| Minimum | =MIN(B1:B5) |
| Variatiebreedte (max − min) | =B6-B7 |
De eerste tabel toont de modus 7 in B6. De tweede toont de som 37,5 in B6, het aantal 5 in B7 en het gemiddelde 7,5 in B8. De derde toont de mediaan 7 in B6 en de vierde toont de variatiebreedte 3,5 in B8.
MODUS.ENKELV geeft maar de eerste modus als er meer zijn. Komt elke waarde één keer voor, dan krijg je de foutmelding “#N/B”, wat betekent dat er geen modus is.
Wil je een ander aantal waarden gebruiken, voeg dan rijen met getallen toe (of verwijder ze) en pas daarna “B1:B5” in de formules aan naar je werkelijke gegevensbereik (voor 7 waarden B1:B7).
Berekenen met Google Spreadsheets
| Waarde 1 | 6 |
| Waarde 2 | 7 |
| Waarde 3 | 7 |
| Waarde 4 | 8 |
| Waarde 5 | 9,5 |
| Modus | =MODUS(B1:B5) |
| Waarde 1 | 6 |
| Waarde 2 | 7 |
| Waarde 3 | 7 |
| Waarde 4 | 8 |
| Waarde 5 | 9,5 |
| Som | =SOM(B1:B5) |
| Aantal | =AANTAL(B1:B5) |
| Gemiddelde (rekenkundig gemiddelde) | =GEMIDDELDE(B1:B5) |
| Waarde 1 | 6 |
| Waarde 2 | 7 |
| Waarde 3 | 7 |
| Waarde 4 | 8 |
| Waarde 5 | 9,5 |
| Mediaan | =MEDIAAN(B1:B5) |
| Waarde 1 | 6 |
| Waarde 2 | 7 |
| Waarde 3 | 7 |
| Waarde 4 | 8 |
| Waarde 5 | 9,5 |
| Maximum | =MAX(B1:B5) |
| Minimum | =MIN(B1:B5) |
| Variatiebreedte (max − min) | =B6-B7 |
Kopieer de hele tabel, plak die in cel A1 en vervang B1 tot en met B5 door je eigen getallen.
Berekenen met Python
import statistics

numbers = [10, 2, 38, 23, 38, 23, 21]  # de gegevens

mean_value = statistics.mean(numbers)        # gemiddelde (rekenkundig gemiddelde)
median_value = statistics.median(numbers)    # mediaan
mode_values = statistics.multimode(numbers)  # modus (een lijst met alle modi als er meer zijn)
value_range = max(numbers) - min(numbers)    # variatiebreedte (max - min)

print(f"Gemiddelde: {mean_value}")
print(f"Mediaan: {median_value}")
print(f"Modus: {mode_values}")
print(f"Variatiebreedte: {value_range}")
print(f"Gesorteerd: {sorted(numbers)}")
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
Mo = x (f(x) = f_max)
M_o = x \quad \bigl(\, f(x) = f_{\max} \,\bigr)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mi>M</mi><mi>o</mi></msub>
    <mo>=</mo>
    <mi>x</mi>
    <mspace width="1em"/>
    <mrow>
      <mo>(</mo>
      <mi>f</mi><mo>(</mo><mi>x</mi><mo>)</mo>
      <mo>=</mo>
      <msub><mi>f</mi><mi>max</mi></msub>
      <mo>)</mo>
    </mrow>
  </mrow>
</math>
M_o = x (f(x) = f_(max))
Commonest[{x1, x2, x3}]
Statistics:-Mode([x1, x2, x3]);
M = mode(x);
M_o = x (f(x) = f_max)
x̄ = (x₁ + x₂ + ⋯ + xₙ) ÷ n
\bar{x} = \frac{x_1 + x_2 + \cdots + x_n}{n} = \frac{1}{n}\sum_{i=1}^{n} x_i
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mover accent="true"><mi>x</mi><mo>¯</mo></mover>
<mo>=</mo>
<mfrac>
<mrow>
<msub><mi>x</mi><mn>1</mn></msub>
<mo>+</mo>
<msub><mi>x</mi><mn>2</mn></msub>
<mo>+</mo>
<mo>⋯</mo>
<mo>+</mo>
<msub><mi>x</mi><mi>n</mi></msub>
</mrow>
<mi>n</mi>
</mfrac>
</mrow>
</math>
bar x = (x_1 + x_2 + cdots + x_n) / n
Mean[{x1, x2, x3}]
xbar := add(x[i], i = 1 .. n)/n;
xbar = mean(x);
x̄ = (x_1 + x_2 + ⋯ + x_n)/n
\tilde{x} = \begin{cases} x_{(\,(n+1)/2\,)} & (n:\ \mathrm{oneven}) \\[6pt] \dfrac{x_{(n/2)} + x_{(n/2+1)}}{2} & (n:\ \mathrm{even}) \end{cases}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mover accent="true"><mi>x</mi><mo>~</mo></mover>
<mo>=</mo>
<mrow>
<mo>{</mo>
<mtable columnalign="center left">
<mtr>
<mtd><msub><mi>x</mi><mrow><mo>(</mo><mo>(</mo><mi>n</mi><mo>+</mo><mn>1</mn><mo>)</mo><mo>/</mo><mn>2</mn><mo>)</mo></mrow></msub></mtd>
<mtd><mrow><mo>(</mo><mi>n</mi><mo>:</mo><mtext>oneven</mtext><mo>)</mo></mrow></mtd>
</mtr>
<mtr>
<mtd><mfrac>
<mrow>
<msub><mi>x</mi><mrow><mo>(</mo><mi>n</mi><mo>/</mo><mn>2</mn><mo>)</mo></mrow></msub>
<mo>+</mo>
<msub><mi>x</mi><mrow><mo>(</mo><mi>n</mi><mo>/</mo><mn>2</mn><mo>+</mo><mn>1</mn><mo>)</mo></mrow></msub>
</mrow>
<mn>2</mn>
</mfrac></mtd>
<mtd><mrow><mo>(</mo><mi>n</mi><mo>:</mo><mtext>even</mtext><mo>)</mo></mrow></mtd>
</mtr>
</mtable>
</mrow>
</mrow>
</math>
tilde x = {(x_(((n+1)/2)), if n odd), ((x_((n/2)) + x_((n/2+1)))/2, if n even):}
Median[{x1, x2, x3}]
Statistics:-Median([x1, x2, x3]);
med = median(x);
x̃ = (x_((n/2)) + x_((n/2+1)))/2 (bij een even aantal waarden; bij een oneven aantal is x̃ = x_(((n+1)/2)))
R = xₘₐₓ − xₘᵢₙ
R = x_{\max} - x_{\min}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>R</mi>
<mo>=</mo>
<msub><mi>x</mi><mi>max</mi></msub>
<mo>−</mo>
<msub><mi>x</mi><mi>min</mi></msub>
</mrow>
</math>
R = x_(max) - x_(min)
Max[{x1, x2, x3}] - Min[{x1, x2, x3}]
R := max(L) - min(L);
R = max(x) - min(x);
R = x_max − x_min
Zo laat je ChatGPT de berekening doen
Je bent een assistent voor statistische berekeningen. Doe de volgende berekening door echt Python-code uit te voeren en baseer je antwoord alleen op de getallen uit het resultaat van de uitvoering (geef geen antwoord uit het hoofd of op gevoel).

Bepaal voor de volgende gegevens elk van de onderstaande waarden.
Gegevens: 10, 2, 38, 23, 38, 23, 21
1. Het gemiddelde (rekenkundig gemiddelde)
2. De mediaan
3. De modus. Zijn het er meer, noem ze dan allemaal. Komt elke waarde één keer voor, antwoord dan “geen modus”
4. De variatiebreedte (maximum − minimum)
5. De gegevens van klein naar groot gesorteerd

Toon de formules die je hebt gebruikt en de getallen uit het resultaat van de uitvoering.
Zo werkt het
-
1Vul je getallen inTyp de getallen waarmee je wilt rekenen in de invoervelden
-
2BerekenKlik op de knop “Berekenen”
-
3Bekijk het resultaatHet resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
Kenmerken van DataChef

Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Zonder persoonlijke gegevens op te geven

Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt


Geen bronvermelding vereist

Geen toestemming vooraf nodig
Gerelateerde functies
Gemiddelde berekenen (rekenkundig gemiddelde)
Berekent het gemiddelde (rekenkundig gemiddelde) samen met de som, het aantal, het meetkundig gemiddelde en meer
Standaardafwijking berekenen voor populatie en steekproef
Berekent hoe ver gegevens uit elkaar liggen (standaardafwijking en variantie), zowel voor een populatie als voor een steekproef
Normale verdeling berekenen (kans tussen twee waarden en z-tabel)
Bereken uit het gemiddelde en de standaardafwijking de kans dat een waarde in een bepaald interval valt