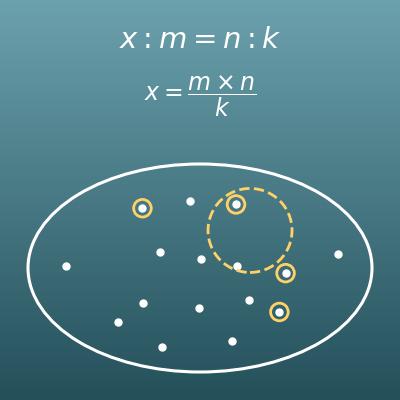
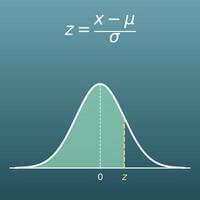
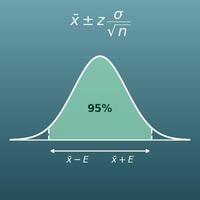
Je kunt deze rekenmachine op twee manieren gebruiken. ① Vul het betrouwbaarheidsniveau, de proportie en de foutmarge in om de benodigde steekproefgrootte te vinden. ② Vul het betrouwbaarheidsniveau, de proportie en de steekproefgrootte in om de foutmarge te vinden. Vul de grootte van de populatie alleen in als je die weet.
Inhoudsopgave
-
Wat je op deze pagina kunt doen
-
Waarvoor is deze berekening handig?
-
Zo werkt het
-
Formule
-
Benodigde steekproefgrootte (als de populatie heel groot is)
-
Correctie voor eindige populaties bij de steekproefgrootte (als je de grootte van de populatie \(N\) weet)
-
Foutmarge (als de populatie heel groot is)
-
Correctie voor eindige populaties bij de foutmarge (als je de grootte van de populatie \(N\) weet)
-
-
Symbolen en begrippen
-
Handig om vooraf te weten
-
Berekenen met Excel
-
Berekenen met Google Spreadsheets
-
Berekenen met Python
-
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
-
Zo laat je ChatGPT de berekening doen
-
Kenmerken van DataChef
-
Gerelateerde functies
-
Alle rekenmachines van NumberChef
Wat je op deze pagina kunt doen
- “Hoeveel mensen moet ik ondervragen voor een betrouwbaarheidsniveau van 95% en een foutmarge van ±5%?” Je ziet meteen de grootte van de steekproef die je onderzoek nodig heeft
- Andersom: “Hoe nauwkeurig, plus of min, is een enquête onder 1.000 mensen?” Je berekent de foutmarge op dezelfde pagina
- Weet je hoe groot de populatie is (500 medewerkers, 1.000 leden, enzovoort), dan bepaalt de correctie voor eindige populaties het aantal dat je echt nodig hebt
- Een uitleg van de formules in gewone taal en formules om te kopiëren voor Excel, Google Spreadsheets en Python staan ook op deze pagina
Waarvoor is deze berekening handig?
Peilingen in het nieuws ondervragen meestal ongeveer 1.000 tot 2.000 willekeurig gekozen mensen uit ruim 13 miljoen kiesgerechtigden. Bij een betrouwbaarheidsniveau van 95%, een foutmarge van ±3% en een proportie van 50% is de benodigde steekproefgrootte \(1{,}96^2 \times 0{,}25 \div 0{,}03^2 \approx 1067{,}1\) (ongeveer 1.068 mensen). Deze formule beantwoordt de vraag: “Kunnen ongeveer 1.000 mensen echt vertellen wat miljoenen denken?”
Andersom zie je dat als “45% tegenover 47% tevredenen” binnen een foutmarge van ±3 procentpunt valt, je niet zeker kunt zeggen dat er statistisch een verschil is.
“Hoeveel van onze 1.000 leden moeten we ondervragen?” is een klassiek geval voor de correctie voor eindige populaties. Bij een betrouwbaarheidsniveau van 95%, een foutmarge van ±5% en een proportie van 50% zakt de waarde vóór correctie, 384,16, naar \(384{,}16 \div (1 + 383{,}16 \div 1000) \approx 277{,}7\) (278 mensen na naar boven afronden).
Als je vooraf bepaalt hoeveel reacties genoeg zijn voor de nauwkeurigheid die je nodig hebt, voordat je herinnering na herinnering naar iedereen stuurt, kun je de kosten en de nauwkeurigheid van het onderzoek met getallen tegen elkaar afwegen.
Deze formule wordt ook gebruikt om het uitvalpercentage van in massa geproduceerde onderdelen te schatten zonder elk onderdeel te controleren. Wijzen eerdere gegevens op een uitvalpercentage van ongeveer 10%, dan geven een betrouwbaarheidsniveau van 90% en een foutmarge van ±4% \(1{,}65^2 \times 0{,}1 \times 0{,}9 \div 0{,}04^2 \approx 153{,}1\), dus een steekproef van ongeveer 154 onderdelen is genoeg.
Het voorbeeld laat ook zien dat hoe verder de proportie van 50% af ligt, hoe kleiner de spreiding \(\hat{p}(1-\hat{p})\) is en hoe minder stuks je nodig hebt.
Bij een epidemiologisch onderzoek naar “het aandeel mensen in een gebied dat deze aandoening heeft” moet het onderzoeksplan vermelden hoeveel deelnemers nodig zijn. Wijzen eerdere onderzoeken op een prevalentie van ongeveer 20%, dan geven een betrouwbaarheidsniveau van 95% en een foutmarge van ±3% \(1{,}96^2 \times 0{,}2 \times 0{,}8 \div 0{,}03^2 \approx 683{,}0\), ongeveer 683 mensen.
Echt klinisch onderzoek gebruikt ook nauwkeurigere methoden die bij de onderzoeksopzet passen (zoals een poweranalyse). Deze formule is de basisvorm waarvan ze uitgaan.
Kijkcijfers worden geschat uit een panel van huishoudens in een steekproef, niet uit elk huishouden. Neem als vereenvoudigd voorbeeld (echte kijkcijfermethoden zijn ingewikkelder) een panel van 2.700 huishoudens en een programma waar 10% van kijkt. Bij een betrouwbaarheidsniveau van 95% is de foutmarge \(1{,}96 \times \sqrt{0{,}1 \times 0{,}9 \div 2700} \approx 0{,}0113\) (ongeveer ±1,1%).
Zo zie je dat “het verschil tussen een kijkcijfer van 9,5% en 10,5% binnen de foutmarge kan vallen”, en lees je de getallen in het nieuws een stap dieper.
Formule
Symbolen en begrippen
Symbolen
| \(n\) | n | De steekproefgrootte. Bij een enquête is dat het aantal mensen van wie je de antwoorden verzamelt; bij een controle het aantal stuks dat je test. |
| \(n_0\) | n index nul | De berekende benodigde steekproefgrootte als de populatie als heel groot wordt beschouwd. Het is de waarde vóór de correctie voor eindige populaties. |
| \(z\) | zet | De z-score (een waarde van de standaard normale verdeling) bij het betrouwbaarheidsniveau. De gebruikelijke waarden zijn 1,96 voor 95% en 2,58 voor 99%. |
| \(\hat{p}\) | p-dak | De proportie (zoals het aandeel “ja”-antwoorden dat je wilt weten). Gebruik om de steekproefgrootte te vinden je verwachte waarde; gebruik om de foutmarge te vinden de proportie die je in het onderzoek echt hebt gekregen (de steekproefproportie). Schrijf haar als decimaal getal van 0 tot 1 (0,5 voor 50%). |
| \(\varepsilon\) | epsilon | De foutmarge, het verschil dat je toestaat tussen de uitkomst van het onderzoek en de werkelijke waarde. Ze wordt met ± geschreven, zoals in “±5%”. |
| \(N\) | hoofdletter N | De grootte van de populatie, het aantal mensen of stuks in de hele groep die je wilt onderzoeken (voorbeeld - alle 500 medewerkers). |
Begrippen
| populatie | De hele groep waarover je echt iets wilt weten, zoals “alle kiesgerechtigden in het land” of “alle 500 medewerkers”. |
| steekproef | Het deel van de populatie dat je kiest om echt te onderzoeken. Het aantal mensen of stuks in de steekproef heet de steekproefgrootte. |
| aselecte steekproef | De steekproef zo kiezen dat iedereen in de populatie dezelfde kans heeft om te worden gekozen, zoals namen uit een hoed trekken. De formules op deze pagina gaan uit van een aselecte steekproef en werken niet bij onderzoeken waarin alleen de mensen antwoorden die dat willen. |
| populatieproportie | De proportie die je echt wilt weten, zoals het aandeel “ja” in de hele populatie. De proportie die je uit een steekproef krijgt, heet de steekproefproportie, om ze uit elkaar te houden. |
| betrouwbaarheidsniveau | Hoe zeker je kunt zijn: als je hetzelfde onderzoek vaak herhaalde, het percentage keren dat de uitkomst binnen de foutmarge zou vallen. 95% wordt het meest gebruikt. |
| betrouwbaarheidsinterval | Het bereik dat je krijgt als je de uitkomst van een onderzoek met enige breedte weergeeft, zoals in “52% ± 3% (49% tot 55%)”. De foutmarge ±ε op deze pagina is die breedte. |
| foutmarge | Het verschil dat je toestaat tussen de uitkomst van het onderzoek en de werkelijke waarde. Het is wat peilingen in het nieuws bedoelen met “een foutmarge van ±3 procentpunt”. |
| correctie voor eindige populaties | Een correctie die de benodigde steekproefgrootte of de foutmarge verlaagt als je weet dat de populatie een beperkte grootte heeft. Ze weerspiegelt dat de uitkomst zekerder is naarmate je meer van de populatie onderzoekt. |
Handig om vooraf te weten
Dit is wat je helpt om de berekening op deze pagina echt te begrijpen, en niet alleen op de knop te drukken.
| Procenten en verhoudingen (groep 7-8, 10-12 jaar) |
|
| Wortels (klas 3, 14-15 jaar) |
|
| Aselecte steekproeven (klas 2-3, 13-15 jaar) |
|
| De normale verdeling en statistische gevolgtrekking (bovenbouw havo/vwo, 16-18 jaar) |
|
Berekenen met Excel
| z-score (1,96 voor 95%) | 1,96 |
| Verwachte proportie (%) | 50 |
| Foutmarge (%) | 5 |
| Berekende waarde n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Benodigde steekproefgrootte (naar boven afgerond) | =AFRONDEN.NAAR.BOVEN(B4;0) |
| z-score (1,96 voor 95%) | 1,96 |
| Verwachte proportie (%) | 50 |
| Foutmarge (%) | 5 |
| Grootte van de populatie N | 500 |
| Waarde vóór correctie n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Benodigde steekproefgrootte (gecorrigeerd, naar boven afgerond) | =AFRONDEN.NAAR.BOVEN(B5/(1+(B5-1)/B4);0) |
| z-score (1,96 voor 95%) | 1,96 |
| Proportie uit het onderzoek (%) | 60 |
| Grootte van de steekproef n | 100 |
| Foutmarge (%) | =B1*WORTEL(B2/100*(1-B2/100)/B3)*100 |
| z-score (1,96 voor 95%) | 1,96 |
| Proportie uit het onderzoek (%) | 30 |
| Grootte van de steekproef n | 200 |
| Grootte van de populatie N | 1000 |
| Foutmarge vóór correctie (%) | =B1*WORTEL(B2/100*(1-B2/100)/B3)*100 |
| Gecorrigeerde foutmarge (%) | =B5*WORTEL((B4-B3)/(B4-1)) |
In de eerste tabel toont B4 384,16 en B5 385. Het antwoord in de tweede tabel is 218, in de derde ongeveer 9,60 (%) en in de vierde ongeveer 5,68 (%).
“^” is een macht (kwadraat), “WORTEL” is de wortel en “AFRONDEN.NAAR.BOVEN” is de functie om naar boven af te ronden.
Let op: de rekenmachine op deze pagina rondt voor de zekerheid ook één hoger af als de berekende waarde precies een geheel getal is, dus bij zulke ronde waarden kan ze 1 verschillen van AFRONDEN.NAAR.BOVEN in Excel.
Berekenen met Google Spreadsheets
| z-score (1,96 voor 95%) | 1,96 |
| Verwachte proportie (%) | 50 |
| Foutmarge (%) | 5 |
| Berekende waarde n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Benodigde steekproefgrootte (naar boven afgerond) | =AFRONDEN.NAAR.BOVEN(B4;0) |
| z-score (1,96 voor 95%) | 1,96 |
| Verwachte proportie (%) | 50 |
| Foutmarge (%) | 5 |
| Grootte van de populatie N | 500 |
| Waarde vóór correctie n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Benodigde steekproefgrootte (gecorrigeerd, naar boven afgerond) | =AFRONDEN.NAAR.BOVEN(B5/(1+(B5-1)/B4);0) |
| z-score (1,96 voor 95%) | 1,96 |
| Proportie uit het onderzoek (%) | 60 |
| Grootte van de steekproef n | 100 |
| Foutmarge (%) | =B1*WORTEL(B2/100*(1-B2/100)/B3)*100 |
| z-score (1,96 voor 95%) | 1,96 |
| Proportie uit het onderzoek (%) | 30 |
| Grootte van de steekproef n | 200 |
| Grootte van de populatie N | 1000 |
| Foutmarge vóór correctie (%) | =B1*WORTEL(B2/100*(1-B2/100)/B3)*100 |
| Gecorrigeerde foutmarge (%) | =B5*WORTEL((B4-B3)/(B4-1)) |
Berekenen met Python
import math

# Snelle tabel van betrouwbaarheidsniveau (%) naar z-score (gangbare afgeronde waarden)
z_table = {80: 1.28, 85: 1.44, 90: 1.65, 95: 1.96, 98: 2.33, 99: 2.58}

# ---- Manier 1: de benodigde steekproefgrootte berekenen ----
confidence_level = 95    # betrouwbaarheidsniveau (%)
population_ratio = 50    # verwachte proportie (%)
margin_of_error = 5      # foutmarge (%)
population_size = None   # grootte van de populatie (None als onbekend of heel groot)

z = z_table[confidence_level]
p = population_ratio / 100
e = margin_of_error / 100

raw_size = z ** 2 * p * (1 - p) / e ** 2   # waarde vóór correctie
if population_size is not None:
    raw_size = raw_size / (1 + (raw_size - 1) / population_size)   # correctie voor eindige populaties
required_size = math.floor(raw_size) + 1   # kleinste gehele getal boven de berekende waarde (voor de zekerheid naar boven afgerond)
print(f"Benodigde steekproefgrootte: {required_size}")

# ---- Manier 2: de foutmarge berekenen ----
sample_size = 1000       # steekproefgrootte die echt is ondervraagd
sample_ratio = 50 / 100  # proportie uit het onderzoek (0,5 voor 50%)

error_ratio = z * math.sqrt(sample_ratio * (1 - sample_ratio) / sample_size)
print(f"Foutmarge: ±{error_ratio * 100:.2f}%")
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
n₀ = z² × p̂(1 − p̂) ÷ ε²
n_0 = \dfrac{z^2 \, \hat{p}(1-\hat{p})}{\varepsilon^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>n</mi><mn>0</mn></msub>
<mo>=</mo>
<mfrac>
<mrow>
<msup><mi>z</mi><mn>2</mn></msup>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<msup><mi>ε</mi><mn>2</mn></msup>
</mfrac>
</mrow>
</math>
n_0 = (z^2 hat(p)(1 - hat(p)))/(epsilon^2)
z^2*p*(1 - p)/err^2
n0 := z^2*p*(1 - p)/err^2;
n0 = z^2*p*(1 - p)/err^2;
n_0 = (z^2 p̂(1 − p̂))/ε^2
n = n₀ ÷ (1 + (n₀ − 1) ÷ N)
n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msub><mi>n</mi><mn>0</mn></msub>
<mrow>
<mn>1</mn><mo>+</mo>
<mfrac>
<mrow><msub><mi>n</mi><mn>0</mn></msub><mo>−</mo><mn>1</mn></mrow>
<mi>N</mi>
</mfrac>
</mrow>
</mfrac>
</mrow>
</math>
n = n_0/(1 + (n_0 - 1)/N)
n0/(1 + (n0 - 1)/nPop)
n := n0/(1 + (n0 - 1)/N);
n = n0/(1 + (n0 - 1)/N);
n = n_0/(1 + (n_0 − 1)/N)
ε = z × √(p̂(1 − p̂) ÷ n)
\varepsilon = z \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<mi>z</mi>
<msqrt>
<mfrac>
<mrow>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<mi>n</mi>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = z sqrt((hat(p)(1 - hat(p)))/n)
z*Sqrt[p*(1 - p)/n]
err := z*sqrt(p*(1 - p)/n);
err = z*sqrt(p*(1 - p)/n);
ε = z√((p̂(1 − p̂))/n)
ε = ε₀ × √((N − n) ÷ (N − 1))
\varepsilon = \varepsilon_0 \sqrt{\dfrac{N-n}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<msub><mi>ε</mi><mn>0</mn></msub>
<msqrt>
<mfrac>
<mrow><mi>N</mi><mo>−</mo><mi>n</mi></mrow>
<mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = epsilon_0 sqrt((N - n)/(N - 1))
err0*Sqrt[(nPop - n)/(nPop - 1)]
err := err0*sqrt((N - n)/(N - 1));
err = err0*sqrt((N - n)/(N - 1));
ε = ε_0 √((N − n)/(N − 1))
Zo laat je ChatGPT de berekening doen
Je bent een rekenassistent voor statistische onderzoeken. Voer de volgende berekening uit door echt Python-code uit te voeren, en baseer je antwoord alleen op de getallen uit het uitvoerresultaat (geen hoofdrekenen of gokken).

Een dienst met 1.000 leden houdt een tevredenheidsonderzoek. Gebruik een betrouwbaarheidsniveau van 95% (z-score 1,96), een verwachte proportie van 50% en een foutmarge van ±5%.
Bereken elk van de volgende waarden:
1. De benodigde steekproefgrootte als de populatie als heel groot wordt beschouwd (de berekende waarde en het aantal mensen na naar boven afronden)
2. De benodigde steekproefgrootte met de correctie voor eindige populaties voor een populatie van 1.000
3. De foutmarge (met de correctie voor eindige populaties, in %) als slechts 200 mensen reageren

Laat de formules zien die je hebt gebruikt en de getallen uit het uitvoerresultaat.
Zo werkt het
-
1Vul je getallen inTyp de getallen waarmee je wilt rekenen in de invoervelden
-
2BerekenKlik op de knop “Berekenen”
-
3Bekijk het resultaatHet resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
Kenmerken van DataChef

Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Zonder persoonlijke gegevens op te geven

Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt


Geen bronvermelding vereist

Geen toestemming vooraf nodig
Gerelateerde functies
Betrouwbaarheidsinterval berekenen (voor een populatiegemiddelde)
Berekent een betrouwbaarheidsinterval (zoals een 95%-betrouwbaarheidsinterval) voor een gemiddelde
Z-score berekenen: z-score naar kans en terug
Berekent de z-score uit een waarde, gemiddelde en standaardafwijking en rekent die om naar een kans en terug
Normale verdeling berekenen (kans tussen twee waarden en z-tabel)
Berekent uit het gemiddelde en de standaardafwijking de kans op een bepaald bereik