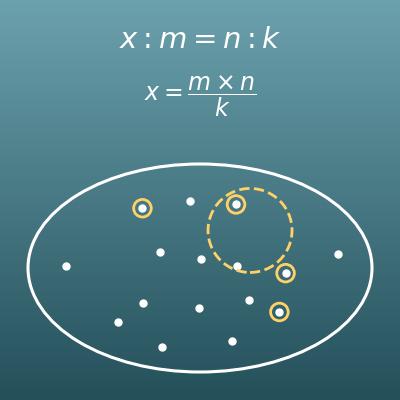
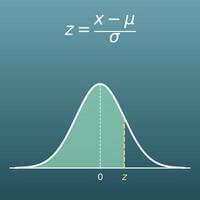
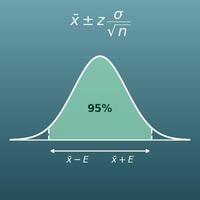
Questa calcolatrice si usa in due modi. 1) Scrivi il livello di confidenza, la proporzione e il margine di errore per trovare la dimensione del campione che serve. 2) Scrivi il livello di confidenza, la proporzione e la dimensione del campione per trovare il margine di errore. Scrivi la dimensione della popolazione solo se la conosci.
Indice
-
Cosa puoi fare in questa pagina
-
A cosa serve questo calcolo?
-
Come si usa
-
Formula
-
Dimensione del campione necessaria (quando la popolazione è molto grande)
-
Correzione per popolazione finita della dimensione del campione (quando conosci la dimensione della popolazione \(N\))
-
Margine di errore (quando la popolazione è molto grande)
-
Correzione per popolazione finita del margine di errore (quando conosci la dimensione della popolazione \(N\))
-
-
Simboli e termini
-
Cosa conviene sapere prima
-
Come calcolarlo con Excel
-
Come calcolarlo con Fogli Google
-
Come calcolarlo con Python
-
La formula in LaTeX e in altre notazioni matematiche (da copiare)
-
Come chiedere a ChatGPT di fare il calcolo
-
I punti di forza di DataChef
-
Funzioni correlate
-
Tutte le calcolatrici di NumberChef
Cosa puoi fare in questa pagina
- «Quante persone devo intervistare per un livello di confidenza del 95% e un margine di errore di ±5%?» Ottieni subito la numerosità del campione che serve alla tua indagine
- Al contrario, «Quanto è accurata, in più o in meno, un’indagine su 1000 persone?» Trovi il margine di errore nella stessa pagina
- Se conosci la dimensione della popolazione (500 dipendenti, 1000 iscritti e così via), la correzione per popolazione finita la riduce al numero che ti serve davvero
- In questa stessa pagina trovi anche una spiegazione semplice delle formule e le formule pronte da copiare per Excel, Fogli Google e Python
A cosa serve questo calcolo?
I sondaggi nazionali sui giornali e in televisione intervistano di solito da 1000 a 2000 persone scelte a caso tra più di 45 milioni di elettori. Con un livello di confidenza del 95%, un margine di errore di ±3% e una proporzione del 50%, la dimensione del campione necessaria è \(1{,}96^2 \times 0{,}25 \div 0{,}03^2 \approx 1067{,}1\) (circa 1068 persone). Questa formula risponde alla domanda: «Bastano davvero circa 1000 persone per sapere che cosa pensano decine di milioni di persone?»
Al contrario, puoi vedere che se «45% contro 47% di gradimento» sta dentro un margine di errore di ±3 punti, non puoi dire con certezza che ci sia una differenza statistica.
«Quanti dei nostri 1000 iscritti dobbiamo interpellare?» è un caso classico per la correzione per popolazione finita. Con un livello di confidenza del 95%, un margine di errore di ±5% e una proporzione del 50%, il valore prima della correzione, 384,16, scende a \(384{,}16 \div (1 + 383{,}16 \div 1000) \approx 277{,}7\) (278 persone dopo l’arrotondamento per eccesso).
Se decidi in anticipo quante risposte bastano per la precisione che ti serve, prima di mandare solleciti a tutti, puoi bilanciare con i numeri il costo e la precisione dell’indagine.
Questa formula si usa anche per stimare la percentuale di difetti di pezzi prodotti in serie senza controllarli tutti. Se i dati storici indicano una percentuale di difetti di circa il 10%, un livello di confidenza del 90% e un margine di errore di ±4% danno \(1{,}65^2 \times 0{,}1 \times 0{,}9 \div 0{,}04^2 \approx 153{,}1\), quindi basta un campione di circa 154 pezzi.
L’esempio mostra anche che più la proporzione è lontana dal 50%, più la dispersione \(\hat{p}(1-\hat{p})\) è piccola e meno elementi servono.
In uno studio epidemiologico sulla «quota di persone di una zona che hanno questa condizione», il piano dello studio deve indicare quanti partecipanti servono. Se studi precedenti suggeriscono una prevalenza di circa il 20%, un livello di confidenza del 95% e un margine di errore di ±3% danno \(1{,}96^2 \times 0{,}2 \times 0{,}8 \div 0{,}03^2 \approx 683{,}0\), cioè circa 683 persone.
La ricerca clinica reale usa anche metodi più precisi adatti al disegno dello studio (come l’analisi della potenza). Questa formula è la forma di base da cui partono.
Gli ascolti TV si stimano da un panel di famiglie campione, non da tutte le case. Come esempio semplificato (i metodi reali di misurazione sono più complessi), prendi un panel di 2700 famiglie e un programma visto nel 10% di esse. Con un livello di confidenza del 95%, il margine di errore è \(1{,}96 \times \sqrt{0{,}1 \times 0{,}9 \div 2700} \approx 0{,}0113\) (circa ±1,1%). In Italia gli ascolti sono misurati da Auditel con un panel di circa 16.100 famiglie: con lo stesso calcolo semplificato il margine scenderebbe a \(1{,}96 \times \sqrt{0{,}1 \times 0{,}9 \div 16100} \approx 0{,}0046\) (circa ±0,46%).
Puoi allora vedere che «la differenza tra uno share del 9,5% e uno del 10,5% può rientrare nel margine di errore» e leggere le notizie con i numeri un passo più a fondo.
Formula
Simboli e termini
Simboli
| \(n\) | enne | La dimensione del campione (la numerosità campionaria). In un sondaggio è il numero di persone di cui raccogli le risposte; in un controllo è il numero di pezzi che esamini. |
| \(n_0\) | enne con zero | Il valore calcolato della dimensione del campione necessaria quando la popolazione è considerata molto grande. È il valore prima della correzione per popolazione finita. |
| \(z\) | zeta | Il punteggio z (un valore della distribuzione normale standard) corrispondente al livello di confidenza. I valori abituali sono 1,96 per il 95% e 2,58 per il 99%. |
| \(\hat{p}\) | pi con il cappuccio | La proporzione (come la quota di risposte «sì» che vuoi conoscere). Per trovare la dimensione del campione, usa il valore che ti aspetti; per trovare il margine di errore, usa la proporzione che hai davvero ottenuto nell’indagine (la proporzione del campione). Si scrive come numero decimale da 0 a 1 (0,5 per il 50%). |
| \(\varepsilon\) | epsilon | Il margine di errore, lo scarto che ammetti tra il risultato dell’indagine e il valore vero. Si indica con ±, come in «±5%». |
| \(N\) | enne maiuscola | La dimensione della popolazione, il numero di persone o elementi dell’intero gruppo che vuoi studiare (esempio: tutti i 500 dipendenti). |
Termini
| popolazione | L’intero gruppo che vuoi davvero conoscere, come «tutti gli elettori del Paese» o «tutti i 500 dipendenti». |
| campione | La parte della popolazione che scegli per studiarla davvero. Il numero di persone o elementi del campione si chiama dimensione del campione (o numerosità campionaria). |
| campionamento casuale | Scegliere il campione in modo che tutti nella popolazione abbiano la stessa probabilità di essere scelti, come pescando i nomi da un cappello. Le formule di questa pagina presuppongono un campionamento casuale e non valgono per sondaggi in cui rispondono solo le persone che vogliono farlo. |
| proporzione della popolazione | La proporzione che vuoi davvero conoscere, come la quota di «sì» nell’intera popolazione. La proporzione ottenuta da un campione si chiama proporzione campionaria, per distinguerle. |
| livello di confidenza | Il grado di sicurezza: se ripetessi molte volte la stessa indagine, la percentuale di volte in cui il risultato cadrebbe entro il margine di errore. Il 95% è il più usato. |
| intervallo di confidenza | L’intervallo che si ottiene quando mostri un risultato d’indagine con una certa ampiezza, come in «52% ± 3% (da 49% a 55%)». Il margine di errore ±ε di questa pagina è quell’ampiezza. |
| margine di errore | Lo scarto che ammetti tra il risultato dell’indagine e il valore vero. È ciò che nei sondaggi delle notizie si indica con «un margine di errore di ±3 punti». |
| correzione per popolazione finita | Una correzione che abbassa la dimensione del campione necessaria o il margine di errore quando sai che la popolazione ha una dimensione limitata. Riflette il fatto che più studi della popolazione, più il risultato è sicuro. |
Cosa conviene sapere prima
Ecco che cosa conviene sapere per usare il calcolo di questa pagina capendone il significato, e non solo premendo il pulsante.
| Percentuali e rapporti (classe 5ª della primaria, 10-11 anni) |
|
| Radici quadrate (classe 2ª della secondaria di primo grado, 12-13 anni) |
|
| Campionamento casuale (scuola secondaria di primo grado, 12-14 anni) |
|
| La distribuzione normale e l’inferenza statistica (scuola secondaria di secondo grado, 14-19 anni) |
|
Come calcolarlo con Excel
| Punteggio z (1,96 per il 95%) | 1,96 |
| Proporzione attesa (%) | 50 |
| Margine di errore (%) | 5 |
| Valore calcolato n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Dimensione del campione necessaria (per eccesso) | =ARROTONDA.PER.ECC(B4;0) |
| Punteggio z (1,96 per il 95%) | 1,96 |
| Proporzione attesa (%) | 50 |
| Margine di errore (%) | 5 |
| Dimensione della popolazione N | 500 |
| Valore prima della correzione n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Dimensione del campione necessaria (corretta, per eccesso) | =ARROTONDA.PER.ECC(B5/(1+(B5-1)/B4);0) |
| Punteggio z (1,96 per il 95%) | 1,96 |
| Proporzione ottenuta nell’indagine (%) | 60 |
| Dimensione del campione n | 100 |
| Margine di errore (%) | =B1*RADQ(B2/100*(1-B2/100)/B3)*100 |
| Punteggio z (1,96 per il 95%) | 1,96 |
| Proporzione ottenuta nell’indagine (%) | 30 |
| Dimensione del campione n | 200 |
| Dimensione della popolazione N | 1000 |
| Margine di errore prima della correzione (%) | =B1*RADQ(B2/100*(1-B2/100)/B3)*100 |
| Margine di errore corretto (%) | =B5*RADQ((B4-B3)/(B4-1)) |
Nella prima tabella, B4 mostra 384,16 e B5 mostra 385. La risposta della seconda tabella è 218, quella della terza circa 9,60 (%) e quella della quarta circa 5,68 (%).
«^» è la potenza (al quadrato), «RADQ» è la radice quadrata e «ARROTONDA.PER.ECC» è la funzione per arrotondare per eccesso.
Nota che la calcolatrice di questa pagina aggiunge uno in più per sicurezza anche quando il valore calcolato è esattamente un numero intero, quindi per valori tondi può differire di 1 da ARROTONDA.PER.ECC di Excel.
Come calcolarlo con Fogli Google
| Punteggio z (1,96 per il 95%) | 1,96 |
| Proporzione attesa (%) | 50 |
| Margine di errore (%) | 5 |
| Valore calcolato n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Dimensione del campione necessaria (per eccesso) | =ARROTONDA.PER.ECC(B4;0) |
| Punteggio z (1,96 per il 95%) | 1,96 |
| Proporzione attesa (%) | 50 |
| Margine di errore (%) | 5 |
| Dimensione della popolazione N | 500 |
| Valore prima della correzione n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Dimensione del campione necessaria (corretta, per eccesso) | =ARROTONDA.PER.ECC(B5/(1+(B5-1)/B4);0) |
| Punteggio z (1,96 per il 95%) | 1,96 |
| Proporzione ottenuta nell’indagine (%) | 60 |
| Dimensione del campione n | 100 |
| Margine di errore (%) | =B1*RADQ(B2/100*(1-B2/100)/B3)*100 |
| Punteggio z (1,96 per il 95%) | 1,96 |
| Proporzione ottenuta nell’indagine (%) | 30 |
| Dimensione del campione n | 200 |
| Dimensione della popolazione N | 1000 |
| Margine di errore prima della correzione (%) | =B1*RADQ(B2/100*(1-B2/100)/B3)*100 |
| Margine di errore corretto (%) | =B5*RADQ((B4-B3)/(B4-1)) |
Come calcolarlo con Python
import math

# Tabella rapida dal livello di confidenza (%) al punteggio z (valori abituali arrotondati)
z_table = {80: 1.28, 85: 1.44, 90: 1.65, 95: 1.96, 98: 2.33, 99: 2.58}

# ---- Modo 1: trova la dimensione del campione necessaria ----
confidence_level = 95    # livello di confidenza (%)
population_ratio = 50    # proporzione attesa (%)
margin_of_error = 5      # margine di errore (%)
population_size = None   # dimensione della popolazione (None se non nota o molto grande)

z = z_table[confidence_level]
p = population_ratio / 100
e = margin_of_error / 100

raw_size = z ** 2 * p * (1 - p) / e ** 2   # valore prima della correzione
if population_size is not None:
    raw_size = raw_size / (1 + (raw_size - 1) / population_size)   # correzione per popolazione finita
required_size = math.floor(raw_size) + 1   # il più piccolo intero sopra il valore calcolato (per eccesso, per sicurezza)
print(f"Dimensione del campione necessaria: {required_size}")

# ---- Modo 2: trova il margine di errore ----
sample_size = 1000       # dimensione del campione intervistato davvero
sample_ratio = 50 / 100  # proporzione ottenuta nell’indagine (0,5 per il 50%)

error_ratio = z * math.sqrt(sample_ratio * (1 - sample_ratio) / sample_size)
print(f"Margine di errore: ±{error_ratio * 100:.2f}%")
La formula in LaTeX e in altre notazioni matematiche (da copiare)
n₀ = z² × p̂(1 − p̂) ÷ ε²
n_0 = \dfrac{z^2 \, \hat{p}(1-\hat{p})}{\varepsilon^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>n</mi><mn>0</mn></msub>
<mo>=</mo>
<mfrac>
<mrow>
<msup><mi>z</mi><mn>2</mn></msup>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<msup><mi>ε</mi><mn>2</mn></msup>
</mfrac>
</mrow>
</math>
n_0 = (z^2 hat(p)(1 - hat(p)))/(epsilon^2)
z^2*p*(1 - p)/err^2
n0 := z^2*p*(1 - p)/err^2;
n0 = z^2*p*(1 - p)/err^2;
n_0 = (z^2 p̂(1 − p̂))/ε^2
n = n₀ ÷ (1 + (n₀ − 1) ÷ N)
n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msub><mi>n</mi><mn>0</mn></msub>
<mrow>
<mn>1</mn><mo>+</mo>
<mfrac>
<mrow><msub><mi>n</mi><mn>0</mn></msub><mo>−</mo><mn>1</mn></mrow>
<mi>N</mi>
</mfrac>
</mrow>
</mfrac>
</mrow>
</math>
n = n_0/(1 + (n_0 - 1)/N)
n0/(1 + (n0 - 1)/nPop)
n := n0/(1 + (n0 - 1)/N);
n = n0/(1 + (n0 - 1)/N);
n = n_0/(1 + (n_0 − 1)/N)
ε = z × √(p̂(1 − p̂) ÷ n)
\varepsilon = z \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<mi>z</mi>
<msqrt>
<mfrac>
<mrow>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<mi>n</mi>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = z sqrt((hat(p)(1 - hat(p)))/n)
z*Sqrt[p*(1 - p)/n]
err := z*sqrt(p*(1 - p)/n);
err = z*sqrt(p*(1 - p)/n);
ε = z√((p̂(1 − p̂))/n)
ε = ε₀ × √((N − n) ÷ (N − 1))
\varepsilon = \varepsilon_0 \sqrt{\dfrac{N-n}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<msub><mi>ε</mi><mn>0</mn></msub>
<msqrt>
<mfrac>
<mrow><mi>N</mi><mo>−</mo><mi>n</mi></mrow>
<mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = epsilon_0 sqrt((N - n)/(N - 1))
err0*Sqrt[(nPop - n)/(nPop - 1)]
err := err0*sqrt((N - n)/(N - 1));
err = err0*sqrt((N - n)/(N - 1));
ε = ε_0 √((N − n)/(N − 1))
Come chiedere a ChatGPT di fare il calcolo
Sei un assistente per il calcolo delle indagini statistiche. Esegui il calcolo seguente eseguendo davvero del codice Python e basa la risposta solo sui numeri del risultato dell’esecuzione (non rispondere con calcoli a mente o ipotesi).

Un servizio con 1000 iscritti sta facendo un’indagine di soddisfazione. Usa un livello di confidenza del 95% (punteggio z 1,96), una proporzione attesa del 50% e un margine di errore di ±5%.
Trova ciascuno dei seguenti valori:
1. La dimensione del campione necessaria quando la popolazione è considerata molto grande (il valore calcolato e il numero di persone dopo l’arrotondamento per eccesso)
2. La dimensione del campione necessaria con la correzione per popolazione finita per una popolazione di 1000
3. Il margine di errore (con la correzione per popolazione finita, in %) se rispondono solo 200 persone

Mostra le formule che hai usato e i numeri del risultato dell’esecuzione.
Come si usa
-
1Inserisci i numeriScrivi nei campi i numeri con cui vuoi fare il calcolo
-
2CalcolaFai clic sul pulsante «Calcola»
-
3Guarda il risultatoIl risultato compare subito. Nella stessa pagina trovi anche lo svolgimento del calcolo e la spiegazione della formula
I punti di forza di DataChef

Nessuna competenza richiesta, semplice e intuitivo

Nessun dato personale richiesto

Il file viene eliminato automaticamente dopo il download


Nessun obbligo di attribuzione

Nessuna autorizzazione preventiva necessaria
Funzioni correlate
Calcolatrice dell’intervallo di confidenza per la media
Calcola un intervallo di confidenza (come un intervallo di confidenza al 95%) per una media
Calcolatrice del punteggio z (z-score): da z a probabilità e viceversa
Trova il punteggio z da un valore, una media e una deviazione standard e convertilo in probabilità e viceversa

Calcolatrice di probabilità della distribuzione normale
Dalla media e dalla deviazione standard calcola la probabilità di cadere in un dato intervallo