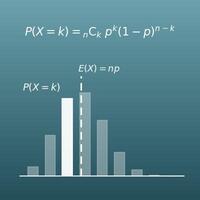Scrivi la media, la deviazione standard e il limite inferiore e superiore dell’intervallo che ti interessa. La calcolatrice trova la probabilità di cadere in quell’intervallo e una tabella di intervalli di confidenza.
Indice
-
Cosa puoi fare in questa pagina
-
A cosa serve questo calcolo?
-
Come si usa
-
Formula e grafico
-
Simboli e termini
-
Cosa conviene sapere prima
-
Come calcolarlo con Excel
-
Come calcolarlo con Fogli Google
-
Come calcolarlo con Python
-
La formula in LaTeX e in altre notazioni matematiche (da copiare)
-
Come chiedere a ChatGPT di fare il calcolo
-
I punti di forza di DataChef
-
Funzioni correlate
-
Tutte le calcolatrici di NumberChef
Cosa puoi fare in questa pagina
- Scrivi la media \(\mu\) e la dispersione (la deviazione standard \(\sigma\)) e ottieni subito la probabilità che un valore cada in un dato intervallo
- Calcola anche la probabilità di ottenere un valore maggiore o uguale (o minore o uguale) a un dato valore, come in «Quale percentuale degli studenti ha preso 80 o più?»
- Mostra anche una tabella degli intervalli più usati in statistica (come l’intervallo che contiene il 95% del totale)
- In questa stessa pagina trovi anche una spiegazione semplice della distribuzione normale e le formule pronte da copiare per Excel, Fogli Google e Python
A cosa serve questo calcolo?
I punteggi delle prove INVALSI di Italiano e Matematica della scuola secondaria di primo grado sono espressi su una scala in cui la media di riferimento è 200 e una deviazione standard vale 40 punti. In una distribuzione normale solo circa il 16% degli studenti sta a \(+1\sigma\) o più (240 punti o più) e solo circa il 2,3% sta a \(+2\sigma\) o più (280 punti o più).
Quando capisci questa corrispondenza, i percentili dei test standardizzati non sono più un mistero: puoi leggere in numeri, e non solo a sensazione, che cosa rappresentano «20 punti in più» o «il 90º percentile».
L’«intervallo di riferimento» delle analisi del sangue e di esami simili è spesso fissato come l’intervallo che contiene il 95% centrale delle misure di persone sane (circa la media \(\pm 2\sigma\)).
Quindi, per qualsiasi esame, circa il 5% delle persone sane (1 su 20) cade fuori dall’intervallo di riferimento. In un controllo con molti esami è anzi normale che una persona sana risulti fuori range in almeno uno. Sapendolo, capisci che «un po’ fuori dall’intervallo» non significa automaticamente che «c’è qualcosa che non va», e puoi ascoltare con calma la spiegazione del medico. È utile soprattutto se i referti tendono a preoccuparti.
Il peso e le dimensioni dei prodotti variano in un modo che si avvicina a una distribuzione normale. Per esempio, se le confezioni sono riempite con un contenuto medio di 102 g e una deviazione standard di 1 g, con limite minimo di specifica a 100 g, quelle sotto il minimo sono quelle oltre \(-2\sigma\), circa il 2,3%.
Le fabbriche usano questo calcolo per prevedere la percentuale di difetti e per decidere dove fissare il riempimento medio (quanto in più mettere) per bilanciare i reclami dei clienti e il costo.
Quando confronti se il design A o il design B ha la percentuale di clic più alta, usi la distribuzione normale (un intervallo di confidenza) per decidere se la differenza è solo casuale o reale.
La riga «0,95» della tabella mostrata nel risultato è proprio l’«intervallo di confidenza al 95%» usato più spesso nella pratica. Dietro le decisioni che muovono grandi somme di denaro, come i budget pubblicitari, questo calcolo si usa ogni giorno.
I professionisti chiamati attuari stimano come probabilità il rischio di pagare i sinistri e ne ricavano i premi assicurativi.
I singoli incidenti non si possono prevedere, ma il totale su molti assicurati si avvicina a una distribuzione normale (il teorema del limite centrale), quindi il totale dei pagamenti si può prevedere con sorprendente precisione. È grazie a questa matematica che possiamo avere una copertura ampia con un premio accessibile.
Formula e grafico
Simboli e termini
Simboli
| \(\mu\) | mi | La media. È la posizione del centro del picco della distribuzione. È una lettera greca che corrisponde alla m. |
| \(\sigma\) | sigma | La deviazione standard. È la grandezza della dispersione dei dati e determina la larghezza del picco. Più è grande, più il picco è basso e largo. È una lettera greca che corrisponde alla s. |
| \(X\) | ics maiuscola (variabile casuale) | Una lettera che indica una grandezza il cui valore può cambiare a ogni misura, come il punteggio di un test o un’altezza. |
| \(\Phi\) | fi maiuscola | La funzione di ripartizione della distribuzione normale standard (media 0, deviazione standard 1). Restituisce la probabilità di ottenere quel valore o meno. |
| \(z\) | zeta (punteggio z) | Un numero che dice a quante deviazioni standard dalla media si trova un valore. Si trova con \(z = (x - \mu) \div \sigma\). |
| \(e\) | e (numero di Nepero) | Una costante, circa 2,71828…, la base del logaritmo naturale. È un numero speciale alla base delle funzioni esponenziali. |
| \(\pi\) | pi greco | Una costante, circa 3,14159…, il rapporto tra la circonferenza di un cerchio e il suo diametro. Nella formula della distribuzione normale compare per rendere l’area totale sotto la curva esattamente 1. |
Termini
| distribuzione normale | Una distribuzione che si sparge in modo simmetrico intorno alla media con una forma a campana. Si usa come modello per dati in cui i valori vicini alla media sono i più comuni e diventano più rari quanto più si allontanano dalla media, come le altezze, i punteggi di un test e i pesi dei prodotti. Si chiama anche distribuzione gaussiana. |
| deviazione standard | Un solo numero che mostra quanto sono dispersi i dati. Due insiemi di dati possono avere la stessa media ma dispersioni diverse. Più la deviazione standard è grande, più il picco della distribuzione è basso e largo. |
| standardizzazione | Riscrivere un valore come «a quante deviazioni standard dalla media si trova» (il punteggio z). Qualunque distribuzione normale, una volta standardizzata, si può trattare con l’unica distribuzione normale standard con media 0 e deviazione standard 1. I punteggi INVALSI usano la stessa idea: punteggio \(= 200 + 40 \times z\). |
| funzione di ripartizione | Una funzione che restituisce la probabilità di ottenere quel valore o meno. Per la distribuzione normale standard si scrive \(\Phi\) (fi). La probabilità di un intervallo è «\(\Phi\) fino al limite superiore» meno «\(\Phi\) fino al limite inferiore». |
| funzione di densità | La formula della curva stessa della distribuzione. L’altezza della curva non è una probabilità ma una densità di probabilità. L’area compresa tra la curva e l’asse orizzontale su un intervallo è la probabilità. Per la distribuzione normale è una curva a campana. |
| intervallo di confidenza | La tabella nel risultato elenca, per ogni percentuale, l’intervallo centrato sulla media che contiene quella parte dell’intera distribuzione (\(\mu \pm z \times \sigma\)) e il suo moltiplicatore \(z\). A rigore, un «intervallo di confidenza al 95%» in statistica è un intervallo per il valore vero (come la media della popolazione) stimato da dati campionari. Ma quando si assume una distribuzione normale si usa lo stesso \(z\) (1,96 per il 95%), quindi i valori di \(z\) di questa tabella valgono direttamente. Si usa spesso per trovare il «margine di errore» dei sondaggi e dei risultati dei test. |
| regola empirica (68–95–99,7) | Un criterio pratico da ricordare: in una distribuzione normale, circa il 68,3% dei dati cade entro la media \(\pm 1\sigma\), circa il 95,4% entro \(\pm 2\sigma\) e circa il 99,7% entro \(\pm 3\sigma\). |
| teorema del limite centrale | Il fatto matematico per cui una grandezza formata da molti piccoli effetti casuali (una somma o una media) si avvicina a una distribuzione normale, qualunque sia la distribuzione di partenza. È il motivo per cui tanti dati reali si avvicinano a una distribuzione normale. |
Cosa conviene sapere prima
Ecco che cosa conviene sapere per usare il calcolo di questa pagina capendone il significato, e non solo premendo il pulsante.
| La media (classe 5ª della primaria, 10-11 anni) |
|
| Analisi dei dati e deviazione standard (scuola secondaria di secondo grado, 14-19 anni) |
|
| Leggere le quote come aree (dalla classe 5ª della primaria alla secondaria di primo grado, 10-14 anni) |
|
| Standardizzazione e punteggi z (scuola secondaria di secondo grado, 14-19 anni) |
|
Come calcolarlo con Excel
| Media μ | 62 |
| Dev. standard σ | 14 |
| Limite inferiore | 50 |
| Limite superiore | 80 |
| Probabilità tra i due limiti | =DISTRIB.NORM.N(B4;B1;B2;VERO)-DISTRIB.NORM.N(B3;B1;B2;VERO) |
| Media μ | 62 |
| Dev. standard σ | 14 |
| Valore (di cui trovare la quota uguale o superiore) | 80 |
| Probabilità di quel valore o più | =1-DISTRIB.NORM.N(B3;B1;B2;VERO) |
| Media μ | 62 |
| Dev. standard σ | 14 |
| Punto x | 80 |
| Altezza della curva in quel punto | =DISTRIB.NORM.N(B3;B1;B2;FALSO) |
La probabilità di un intervallo è «la probabilità del limite superiore o meno» meno «la probabilità del limite inferiore o meno».
Se metti FALSO come ultimo argomento, ottieni l’altezza della curva in quel punto (il valore della funzione di densità) invece di una probabilità.
Dopo l’incolla, la colonna B contiene i tuoi dati e la formula dell’ultima riga si calcola in automatico. La prima tabella mostra circa 0,70 (circa il 70%) e la seconda circa 0,10 (circa il 10%, cioè più o meno il 10% più alto).
Come calcolarlo con Fogli Google
| Media μ | 62 |
| Dev. standard σ | 14 |
| Limite inferiore | 50 |
| Limite superiore | 80 |
| Probabilità tra i due limiti | =DISTRIB.NORM(B4;B1;B2;VERO)-DISTRIB.NORM(B3;B1;B2;VERO) |
| Media μ | 62 |
| Dev. standard σ | 14 |
| Valore (di cui trovare la quota uguale o superiore) | 80 |
| Probabilità di quel valore o più | =1-DISTRIB.NORM(B3;B1;B2;VERO) |
| Media μ | 62 |
| Dev. standard σ | 14 |
| Punto x | 80 |
| Altezza della curva in quel punto | =DISTRIB.NORM(B3;B1;B2;FALSO) |
DISTRIB.NORM(x; media; deviazione_standard; VERO) restituisce la probabilità di ottenere x o meno, quindi il valore del limite superiore meno quello del limite inferiore è la probabilità dell’intervallo.
Se metti FALSO come ultimo argomento, ottieni l’altezza della curva in quel punto (la densità di probabilità) invece di una probabilità.
Come calcolarlo con Python
from statistics import NormalDist

mean = 62               # media
standard_deviation = 14 # deviazione standard
lower_bound = 50        # limite inferiore dell’intervallo
upper_bound = 80        # limite superiore dell’intervallo

distribution = NormalDist(mean, standard_deviation)
p_between = distribution.cdf(upper_bound) - distribution.cdf(lower_bound)

print(f"Probabilità tra {lower_bound} e {upper_bound}: {p_between}")
La formula in LaTeX e in altre notazioni matematiche (da copiare)
P(a ≤ X ≤ b) = Φ((b − μ)/σ) − Φ((a − μ)/σ)
P(a \le X \le b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>a</mi><mo>≤</mo><mi>X</mi><mo>≤</mo><mi>b</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>b</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
<mo>−</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>a</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
P(a <= X <= b) = Phi((b - mu)/sigma) - Phi((a - mu)/sigma)
CDF[NormalDistribution[mu, sigma], b] - CDF[NormalDistribution[mu, sigma], a]
with(Statistics): CDF(RandomVariable(Normal(mu, sigma)), b) - CDF(RandomVariable(Normal(mu, sigma)), a);
p = normcdf(b, mu, sigma) - normcdf(a, mu, sigma);
P(a ≤ X ≤ b) = Φ((b-μ)/σ) - Φ((a-μ)/σ)
f(x) = 1/(σ√(2π)) · e^(−(x − μ)²/(2σ²))
f(x) = \frac{1}{\sigma\sqrt{2\pi}}\, e^{-\frac{(x-\mu)^2}{2\sigma^2}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>f</mi><mo>(</mo><mi>x</mi><mo>)</mo>
<mo>=</mo>
<mfrac>
<mn>1</mn>
<mrow><mi>σ</mi><msqrt><mrow><mn>2</mn><mi>π</mi></mrow></msqrt></mrow>
</mfrac>
<msup>
<mi>e</mi>
<mrow>
<mo>−</mo>
<mfrac>
<msup><mrow><mo>(</mo><mi>x</mi><mo>−</mo><mi>μ</mi><mo>)</mo></mrow><mn>2</mn></msup>
<mrow><mn>2</mn><msup><mi>σ</mi><mn>2</mn></msup></mrow>
</mfrac>
</mrow>
</msup>
</mrow>
</math>
f(x) = 1/(sigma sqrt(2 pi)) e^(-(x - mu)^2 / (2 sigma^2))
PDF[NormalDistribution[mu, sigma], x]
with(Statistics): PDF(RandomVariable(Normal(mu, sigma)), x);
y = normpdf(x, mu, sigma);
f(x) = 1/(σ√(2π)) e^(-(x-μ)^2/(2σ^2))
Come chiedere a ChatGPT di fare il calcolo
Sei un assistente per il calcolo delle probabilità. Esegui il calcolo seguente eseguendo davvero del codice Python e basa la risposta solo sui numeri del risultato dell’esecuzione (non rispondere con calcoli a mente o ipotesi).

I punteggi di un test seguono una distribuzione normale con media 62 punti e deviazione standard 14 punti.
Trova ciascuno dei seguenti valori:
1. La probabilità che un punteggio sia tra 50 e 80 punti
2. La probabilità che un punteggio sia di 80 punti o più (quanto sta in alto, in percentuale)
3. La probabilità che un punteggio sia di 50 punti o meno

Usa statistics.NormalDist di Python e mostra il codice che hai usato e i numeri del risultato dell’esecuzione.
Come si usa
-
1Inserisci i numeriScrivi nei campi i numeri con cui vuoi fare il calcolo
-
2CalcolaFai clic sul pulsante «Calcola»
-
3Guarda il risultatoIl risultato compare subito. Nella stessa pagina trovi anche lo svolgimento del calcolo e la spiegazione della formula
I punti di forza di DataChef

Nessuna competenza richiesta, semplice e intuitivo

Nessun dato personale richiesto

Il file viene eliminato automaticamente dopo il download


Nessun obbligo di attribuzione

Nessuna autorizzazione preventiva necessaria
Funzioni correlate
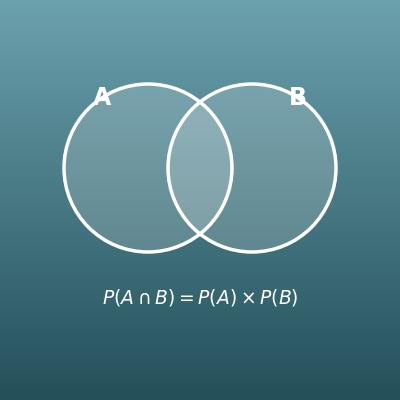
Probabilità di due eventi indipendenti (e, o, nessuno dei due)
Da due probabilità calcola la probabilità che accadano entrambi, che ne accada almeno uno e altro
Probabilità di due eventi (ricava i valori mancanti)
Dalle due probabilità che conosci ricava tutte le altre probabilità
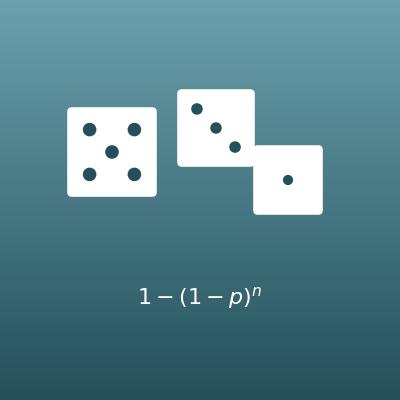
Probabilità di prove ripetute (n volte di fila, almeno una volta)
Calcola la probabilità che qualcosa accada n volte di fila, o almeno una volta in n tentativi