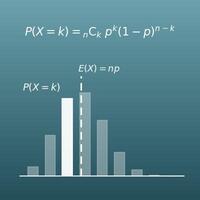Geben Sie Mittelwert, Standardabweichung sowie die untere und obere Grenze des gesuchten Bereichs ein. Der Rechner bestimmt die Wahrscheinlichkeit für diesen Bereich und eine Tabelle der Konfidenzintervalle.
Inhaltsverzeichnis
-
Das können Sie auf dieser Seite
-
Wofür braucht man diese Berechnung?
-
Anleitung
-
Formeln und Graphen
-
Symbole und Begriffe
-
Das sollten Sie vorher wissen
-
So berechnen Sie es in Excel
-
So berechnen Sie es in Google Tabellen
-
So berechnen Sie es in Python
-
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
-
So lassen Sie ChatGPT rechnen
-
Die Vorteile von DataChef
-
Verwandte Funktionen
-
Alle Rechner von NumberChef
Das können Sie auf dieser Seite
- Geben Sie den Mittelwert \(\mu\) und die Streuung (Standardabweichung \(\sigma\)) ein – und Sie sehen sofort, mit welcher Wahrscheinlichkeit ein Wert in einem bestimmten Bereich liegt
- Auch die Wahrscheinlichkeit, einen Wert zu erreichen oder zu überschreiten (bzw. zu unterschreiten), wird berechnet – etwa „Wie viel Prozent haben 80 Punkte oder mehr?“
- Gleichzeitig erscheint eine Tabelle der in der Statistik üblichen Bereiche (etwa des Bereichs, in dem 95 % aller Werte liegen)
- Dazu eine verständliche Erklärung der Normalverteilung sowie fertige Formeln zum Kopieren für Excel, Google Tabellen und Python
Wofür braucht man diese Berechnung?
IQ-Werte sind so festgelegt, dass der Mittelwert 100 beträgt und eine Standardabweichung 15 Punkte. Bei einer Normalverteilung liegen nur etwa 16 % der Menschen bei \(+1\sigma\) oder darüber (IQ 115 oder mehr) und nur etwa 2,3 % bei \(+2\sigma\) oder darüber (IQ 130 oder mehr).
Wer diesen Zusammenhang kennt, kann Prozentränge in Tests mit Zahlen statt nach Gefühl einordnen – etwa, was „15 IQ-Punkte mehr“ oder „Prozentrang 90“ tatsächlich bedeuten.
Der „Referenzbereich“ bei Blutwerten und ähnlichen Laborwerten wird oft als der Bereich festgelegt, in dem die mittleren 95 % der Messwerte gesunder Menschen liegen (etwa Mittelwert \(\pm 2\sigma\)).
Bei jedem einzelnen Wert liegen also rund 5 % der Gesunden (1 von 20) außerhalb des Referenzbereichs. Bei einem Check-up mit vielen Werten ist es deshalb ganz normal, dass auch ein gesunder Mensch bei mindestens einem Wert auffällt. Wer das weiß, versteht, dass „knapp außerhalb des Bereichs“ nicht automatisch „krank“ bedeutet, und kann der Erklärung der Ärztin oder des Arztes in Ruhe zuhören. Besonders hilfreich, wenn Laborergebnisse Sie leicht beunruhigen.
Gewicht und Maße von Produkten streuen annähernd nach einer Normalverteilung. Werden Packungen z. B. mit durchschnittlich 102 g bei einer Standardabweichung von 1 g gefüllt und liegt die Untergrenze bei 100 g, dann liegen nur die Packungen jenseits von \(-2\sigma\) darunter – etwa 2,3 %.
Mit dieser Rechnung schätzen Hersteller den Ausschuss und entscheiden, wie hoch der mittlere Füllwert sein muss (wie viel sie zusätzlich einfüllen), damit Reklamationen und Kosten im Gleichgewicht bleiben.
Vergleicht man, ob Design A oder Design B die höhere Klickrate erzielt, entscheidet man mit der Normalverteilung (einem Konfidenzintervall), ob der Unterschied nur Zufall oder echt ist.
Die Zeile „0,95“ in der Tabelle des Ergebnisses ist genau das „95-%-Konfidenzintervall“, das in der Praxis am häufigsten verwendet wird. Hinter Entscheidungen über viel Geld, etwa Werbebudgets, steckt jeden Tag diese Rechnung.
Aktuare (Versicherungsmathematiker) schätzen das Risiko von Schadenszahlungen als Wahrscheinlichkeit ein und legen danach die Beiträge fest.
Einzelne Schadensfälle lassen sich nicht vorhersagen, aber die Summe über viele Versicherte nähert sich einer Normalverteilung an (zentraler Grenzwertsatz). Deshalb lässt sich die Gesamtauszahlung erstaunlich genau vorhersagen. Dieser Mathematik ist es zu verdanken, dass wir für einen bezahlbaren Beitrag einen hohen Versicherungsschutz bekommen.
Formeln und Graphen
Symbole und Begriffe
Symbole
| \(\mu\) | My | Der Mittelwert. Dort liegt die Mitte des Gipfels der Verteilung. Ein griechischer Buchstabe, der unserem m entspricht. |
| \(\sigma\) | Sigma | Die Standardabweichung. Sie gibt an, wie stark die Daten streuen, und bestimmt die Breite des Gipfels. Je größer sie ist, desto flacher und breiter wird die Kurve. Ein griechischer Buchstabe, der unserem s entspricht. |
| \(X\) | X (Zufallsgröße) | Steht für eine Größe, deren Wert bei jeder Messung anders ausfallen kann, etwa eine Punktzahl oder eine Körpergröße. |
| \(\Phi\) | großes Phi | Die Verteilungsfunktion der Standardnormalverteilung (Mittelwert 0, Standardabweichung 1). Sie gibt die Wahrscheinlichkeit an, diesen Wert oder einen kleineren zu erhalten. |
| \(z\) | z (z-Wert) | Gibt an, wie viele Standardabweichungen ein Wert vom Mittelwert entfernt ist. Man berechnet ihn mit \(z = (x - \mu) \div \sigma\). |
| \(e\) | e (Eulersche Zahl) | Eine Konstante, etwa 2,71828 …, die Basis des natürlichen Logarithmus. Eine besondere Zahl, auf der die Exponentialfunktion beruht. |
| \(\pi\) | Pi (Kreiszahl) | Eine Konstante, etwa 3,14159 …, das Verhältnis von Kreisumfang zu Durchmesser. In der Gleichung der Normalverteilung sorgt sie dafür, dass die Fläche unter der Kurve genau 1 ist. |
Begriffe
| Normalverteilung | Eine Verteilung, die symmetrisch in Glockenform (Gaußsche Glockenkurve) um den Mittelwert streut. Sie dient als Modell für Daten, bei denen Werte nahe dem Mittelwert am häufigsten sind und umso seltener werden, je weiter sie davon entfernt liegen – etwa Körpergrößen, Testergebnisse oder das Gewicht von Produkten. |
| Standardabweichung | Eine einzige Zahl, die angibt, wie stark die Daten streuen. Zwei Datensätze können denselben Mittelwert, aber eine unterschiedlich große Streuung haben. Je größer die Standardabweichung, desto flacher und breiter ist der Gipfel der Verteilung. |
| Standardisierung | Einen Wert umrechnen in „so viele Standardabweichungen vom Mittelwert entfernt“ (den z-Wert). Jede Normalverteilung lässt sich so auf die Standardnormalverteilung mit Mittelwert 0 und Standardabweichung 1 zurückführen. Der IQ beruht auf derselben Idee: IQ \(= 100 + 15 \cdot z\). |
| Standardnormalverteilung | Die Normalverteilung mit Mittelwert 0 und Standardabweichung 1. Auf sie bezieht sich die Tabelle der Funktion \(\Phi\) in Formelsammlungen. |
| Verteilungsfunktion | Eine Funktion, die die Wahrscheinlichkeit angibt, diesen Wert oder einen kleineren zu erhalten. Bei der Standardnormalverteilung schreibt man sie \(\Phi\) (Phi). Die Wahrscheinlichkeit für einen Bereich ist „\(\Phi\) bis zur oberen Grenze“ minus „\(\Phi\) bis zur unteren Grenze“. |
| Dichtefunktion | Die Gleichung der Kurve der Verteilung selbst. Die Höhe der Kurve ist keine Wahrscheinlichkeit, sondern eine Wahrscheinlichkeitsdichte. Die Fläche zwischen Kurve und waagerechter Achse über einem Bereich ist die Wahrscheinlichkeit. Bei der Normalverteilung ist es eine Glockenkurve. |
| Konfidenzintervall | Die Tabelle im Ergebnis zeigt für jeden Prozentsatz den Bereich um den Mittelwert, in dem dieser Anteil der gesamten Verteilung liegt (\(\mu \pm z \times \sigma\)), und den zugehörigen Faktor \(z\). Genau genommen meint man in der Statistik mit einem „95-%-Konfidenzintervall“ einen Bereich für den wahren Wert (etwa den Mittelwert der Grundgesamtheit), der aus Stichprobendaten geschätzt wird. Setzt man eine Normalverteilung voraus, verwendet man dafür aber dasselbe \(z\) (1,96 für 95 %), sodass die \(z\)-Werte dieser Tabelle direkt gelten. Damit berechnet man häufig die Fehlerspanne von Umfragen und Messergebnissen. |
| σ-Regeln | Eine praktische Faustregel (Sigma-Regeln, im Englischen 68-95-99,7-Regel): Bei einer Normalverteilung liegen etwa 68,3 % der Daten im Bereich Mittelwert \(\pm 1\sigma\), etwa 95,4 % in \(\pm 2\sigma\) und etwa 99,7 % in \(\pm 3\sigma\). |
| zentraler Grenzwertsatz | Die mathematische Tatsache, dass eine Größe, die aus vielen kleinen zufälligen Einflüssen entsteht (eine Summe oder ein Durchschnitt), sich einer Normalverteilung annähert – unabhängig von der ursprünglichen Verteilung. Dieser Satz erklärt, warum so viele reale Daten annähernd normalverteilt sind. |
Das sollten Sie vorher wissen
Damit Sie die Berechnung auf dieser Seite wirklich verstehen und nicht nur auf die Schaltfläche klicken, hilft Ihnen dieses Vorwissen.
| Der Mittelwert (Klasse 5–6, 10–12 Jahre) |
|
| Datenanalyse und Standardabweichung (Klasse 10–11, 15–17 Jahre) |
|
| Anteile als Flächen lesen (Klasse 5–7, 10–13 Jahre) |
|
| Standardisierung und z-Werte (Oberstufe, Klasse 11–13, 16–19 Jahre) |
|
So berechnen Sie es in Excel
| Mittelwert μ | 62 |
| Standardabw. σ | 14 |
| Untere Grenze | 50 |
| Obere Grenze | 80 |
| Wahrscheinlichkeit zwischen den Grenzen | =NORM.VERT(B4;B1;B2;WAHR)-NORM.VERT(B3;B1;B2;WAHR) |
| Mittelwert μ | 62 |
| Standardabw. σ | 14 |
| Wert (Anteil ab diesem Wert) | 80 |
| Wahrscheinlichkeit für diesen Wert oder mehr | =1-NORM.VERT(B3;B1;B2;WAHR) |
| Mittelwert μ | 62 |
| Standardabw. σ | 14 |
| Stelle x | 80 |
| Höhe der Kurve an dieser Stelle | =NORM.VERT(B3;B1;B2;FALSCH) |
Die Wahrscheinlichkeit für einen Bereich ist „Wahrscheinlichkeit bis zur oberen Grenze“ minus „Wahrscheinlichkeit bis zur unteren Grenze“.
Setzen Sie das letzte Argument auf FALSCH, erhalten Sie statt einer Wahrscheinlichkeit die Höhe der Kurve an dieser Stelle (den Wert der Dichtefunktion).
Nach dem Einfügen ist Spalte B das Eingabefeld, und die Formel in der letzten Zeile rechnet automatisch. Die erste Tabelle zeigt etwa 0,70 (rund 70 %), die zweite etwa 0,10 (rund 10 %, also die oberen 10 %).
So berechnen Sie es in Google Tabellen
| Mittelwert μ | 62 |
| Standardabw. σ | 14 |
| Untere Grenze | 50 |
| Obere Grenze | 80 |
| Wahrscheinlichkeit zwischen den Grenzen | =NORMVERT(B4;B1;B2;WAHR)-NORMVERT(B3;B1;B2;WAHR) |
| Mittelwert μ | 62 |
| Standardabw. σ | 14 |
| Wert (Anteil ab diesem Wert) | 80 |
| Wahrscheinlichkeit für diesen Wert oder mehr | =1-NORMVERT(B3;B1;B2;WAHR) |
| Mittelwert μ | 62 |
| Standardabw. σ | 14 |
| Stelle x | 80 |
| Höhe der Kurve an dieser Stelle | =NORMVERT(B3;B1;B2;FALSCH) |
NORMVERT(x; Mittelwert; Standardabweichung; WAHR) liefert die Wahrscheinlichkeit, x oder weniger zu erhalten. Der Wert für die obere Grenze minus der Wert für die untere Grenze ergibt also die Wahrscheinlichkeit für den Bereich.
Setzen Sie das letzte Argument auf FALSCH, erhalten Sie statt einer Wahrscheinlichkeit die Höhe der Kurve an dieser Stelle (die Wahrscheinlichkeitsdichte).
So berechnen Sie es in Python
from statistics import NormalDist

mean = 62               # Mittelwert
standard_deviation = 14 # Standardabweichung
lower_bound = 50        # untere Grenze des Bereichs
upper_bound = 80        # obere Grenze des Bereichs

distribution = NormalDist(mean, standard_deviation)
p_between = distribution.cdf(upper_bound) - distribution.cdf(lower_bound)

print(f"Wahrscheinlichkeit zwischen {lower_bound} und {upper_bound}: {p_between}")
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
P(a ≤ X ≤ b) = Φ((b − μ)/σ) − Φ((a − μ)/σ)
P(a \le X \le b) = \Phi\!\left(\frac{b-\mu}{\sigma}\right) - \Phi\!\left(\frac{a-\mu}{\sigma}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>a</mi><mo>≤</mo><mi>X</mi><mo>≤</mo><mi>b</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>b</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
<mo>−</mo>
<mi>Φ</mi>
<mrow>
<mo>(</mo>
<mfrac><mrow><mi>a</mi><mo>−</mo><mi>μ</mi></mrow><mi>σ</mi></mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
P(a <= X <= b) = Phi((b - mu)/sigma) - Phi((a - mu)/sigma)
CDF[NormalDistribution[mu, sigma], b] - CDF[NormalDistribution[mu, sigma], a]
with(Statistics): CDF(RandomVariable(Normal(mu, sigma)), b) - CDF(RandomVariable(Normal(mu, sigma)), a);
p = normcdf(b, mu, sigma) - normcdf(a, mu, sigma);
P(a ≤ X ≤ b) = Φ((b-μ)/σ) - Φ((a-μ)/σ)
f(x) = 1/(σ√(2π)) · e^(−(x − μ)²/(2σ²))
f(x) = \frac{1}{\sigma\sqrt{2\pi}}\, e^{-\frac{(x-\mu)^2}{2\sigma^2}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>f</mi><mo>(</mo><mi>x</mi><mo>)</mo>
<mo>=</mo>
<mfrac>
<mn>1</mn>
<mrow><mi>σ</mi><msqrt><mrow><mn>2</mn><mi>π</mi></mrow></msqrt></mrow>
</mfrac>
<msup>
<mi>e</mi>
<mrow>
<mo>−</mo>
<mfrac>
<msup><mrow><mo>(</mo><mi>x</mi><mo>−</mo><mi>μ</mi><mo>)</mo></mrow><mn>2</mn></msup>
<mrow><mn>2</mn><msup><mi>σ</mi><mn>2</mn></msup></mrow>
</mfrac>
</mrow>
</msup>
</mrow>
</math>
f(x) = 1/(sigma sqrt(2 pi)) e^(-(x - mu)^2 / (2 sigma^2))
PDF[NormalDistribution[mu, sigma], x]
with(Statistics): PDF(RandomVariable(Normal(mu, sigma)), x);
y = normpdf(x, mu, sigma);
f(x) = 1/(σ√(2π)) e^(-(x-μ)^2/(2σ^2))
So lassen Sie ChatGPT rechnen
Sie sind ein Assistent für Wahrscheinlichkeitsrechnung. Führen Sie die folgende Berechnung aus, indem Sie tatsächlich Python-Code ausführen, und stützen Sie Ihre Antwort ausschließlich auf die Zahlen aus dem Ausführungsergebnis (nicht im Kopf rechnen oder schätzen).

Die Punktzahlen einer Klassenarbeit sind normalverteilt mit einem Mittelwert von 62 Punkten und einer Standardabweichung von 14 Punkten.
Bestimmen Sie:
1. Die Wahrscheinlichkeit, dass eine Punktzahl zwischen 50 und 80 Punkten liegt
2. Die Wahrscheinlichkeit, dass eine Punktzahl 80 Punkte oder mehr beträgt (die oberen wie viel Prozent)
3. Die Wahrscheinlichkeit, dass eine Punktzahl 50 Punkte oder weniger beträgt

Verwenden Sie statistics.NormalDist von Python und zeigen Sie den verwendeten Code und die Zahlen aus dem Ausführungsergebnis.
Anleitung
-
1Werte eingebenTragen Sie die Zahlen, mit denen Sie rechnen möchten, in die Eingabefelder ein
-
2BerechnenKlicken Sie auf die Schaltfläche „Berechnen“
-
3Ergebnis ansehenDas Ergebnis erscheint sofort. Auf derselben Seite finden Sie auch den Rechenweg und die Erklärung der Formel
Die Vorteile von DataChef

Kein Fachwissen nötig – einfach und intuitiv

Keine persönlichen Daten erforderlich

Die Datei wird nach dem Download automatisch gelöscht


Keine Quellenangabe nötig

Keine vorherige Genehmigung erforderlich
Verwandte Funktionen
Wahrscheinlichkeit zweier unabhängiger Ereignisse berechnen
Berechnet aus zwei Wahrscheinlichkeiten, wie wahrscheinlich es ist, dass beide eintreten, dass mindestens eines eintritt und mehr
Wahrscheinlichkeiten zweier Ereignisse rückwärts berechnen
Berechnet aus zwei bekannten Wahrscheinlichkeiten alle übrigen auf einmal
Wahrscheinlichkeit „mindestens einmal“ und „n-mal hintereinander“ berechnen
Berechnet die Wahrscheinlichkeit, dass etwas n-mal hintereinander eintritt oder bei n Versuchen mindestens einmal