Geben Sie die Anzahl der Versuche n, die Trefferwahrscheinlichkeit p bei einem Versuch und die Anzahl der Treffer k ein. Sie erhalten die Wahrscheinlichkeit für genau k Treffer, die kumulierten Wahrscheinlichkeiten für höchstens k und mindestens k Treffer, den Erwartungswert, die Varianz und die Standardabweichung sowie ein Säulendiagramm der gesamten Verteilung.
Inhaltsverzeichnis
-
Was Sie auf dieser Seite tun können
-
Wofür ist diese Berechnung nützlich?
-
Anleitung
-
Formeln und Diagramme
-
Symbole und Begriffe
-
Was Sie vorab wissen sollten
-
Mit Excel berechnen
-
Mit Google Tabellen berechnen
-
Mit Python berechnen
-
Die Formel in LaTeX und anderen mathematischen Schreibweisen (zum Kopieren)
-
Die Berechnung von ChatGPT ausführen lassen
-
Die Vorteile von DataChef
-
Verwandte Funktionen
-
Alle NumberChef-Rechner
Was Sie auf dieser Seite tun können
- Geben Sie nur 3 Zahlen ein, und Sie erhalten sofort „die Wahrscheinlichkeit, dass etwas mit der Wahrscheinlichkeit \(p\) bei \(n\) Versuchen genau \(k\)-mal eintritt“, \(P(X = k) = {}_{n}\mathrm{C}_{k}\, p^{k} (1-p)^{n-k}\)
- Die Antwort erscheint als vollständig gekürzter Bruch wie \(\dfrac{3}{8}\) (der exakte Wert) und zugleich als Dezimalzahl und in Prozent. Sie sehen auch den Rechenweg für die Anzahl der Kombinationen \({}_{n}\mathrm{C}_{k}\)
- Gleichzeitig berechnet der Rechner die kumulierten Wahrscheinlichkeiten „höchstens \(k\)-mal“ \(P(X \le k)\) und „mindestens \(k\)-mal“ \(P(X \ge k)\)
- Er zeigt den Erwartungswert \(E(X) = np\), die Varianz \(\mathrm{Var}(X) = np(1-p)\) und die Standardabweichung \(\sigma\) und prüft die Faustregel für die Normalapproximation
- Die gesamte Verteilung, von 0 bis \(n\) Treffern, wird als Säulendiagramm gezeichnet, sodass Sie auf einen Blick sehen, welche Trefferzahlen am wahrscheinlichsten sind
Wofür ist diese Berechnung nützlich?
Öffnen Sie 100 Lootboxen mit einer Drop-Rate von 1 %, folgt die Anzahl der seltenen Drops der Binomialverteilung \(B(100; 0{,}01)\) (unter der Annahme, dass jeder Versuch wie angegeben dieselbe Chance hat und unabhängig ist). Die Wahrscheinlichkeit, überhaupt nichts zu bekommen, beträgt \(0{,}99^{100} \approx 36{,}6\,\%\), die Verteilung zeigt also, dass das Bauchgefühl „100 Versuche bei 1 % sind fast sicher“ riskant ist.
„Den Erwartungswert \(np\) plus die Streuung“ abzuschätzen, wenn Sie planen, wie viel Sie ausgeben, ist genau die Rechnung dieser Seite.
Statt jedes Teil zu prüfen, nutzen Fabriken die Stichprobenprüfung: „Aus einem Los werden \(n\) Teile entnommen, und das Los wird angenommen, wenn höchstens \(c\) Teile fehlerhaft sind.“ Die Wahrscheinlichkeit, dass ein Los mit der Fehlerquote \(p\) angenommen wird, ist genau die kumulierte binomiale Wahrscheinlichkeit \(P(X \le c)\). Entnimmt man zum Beispiel einem Los mit 1 % Fehlerquote 20 Teile und nimmt es nur bei 0 Fehlern an, beträgt die Annahmewahrscheinlichkeit \(0{,}99^{20} \approx 81{,}8\,\%\).
Diese Rechnung dient dazu, Prüfregeln zu entwerfen, die gute Lose mit hoher Wahrscheinlichkeit annehmen und schlechte ablehnen.
Raten Sie bei allen 20 Fragen einer Klausur mit je 4 Antwortmöglichkeiten, folgt die Anzahl der richtigen Antworten der Binomialverteilung \(B(20; 0{,}25)\), und der Erwartungswert ist \(20 \cdot 0{,}25 = 5\) Fragen. Die Chance, durch Glück 8 oder mehr richtig zu haben, beträgt nur etwa 10 %, was wahrscheinlichkeitstheoretisch bestätigt, dass bloßes Raten selten zum Bestehen reicht.
Auch wer Klausuren stellt, behält diese Verteilung im Blick, wenn er die Anzahl der Fragen und die Bestehensgrenze festlegt, damit man nicht durch Glück besteht.
Wirft eine Spielerin mit einer Freiwurfquote von 70 % 10 Freiwürfe, beträgt die Wahrscheinlichkeit für genau 7 Treffer nur \({}_{10}\mathrm{C}_{7} \cdot 0{,}7^{7} \cdot 0{,}3^{3} \approx 26{,}7\,\%\) (jeder Wurf wird als unabhängig mit fester Trefferquote behandelt). Genau 7 von 10 zu treffen ist für eine 70-%-Werferin also nicht so gewöhnlich, wie es klingt. 6 oder 8 Treffer kommen ständig vor.
Die Binomialverteilung hilft Ihnen zu erkennen, wie viel von einer „Serie“ oder einem „Formtief“ nur normale zufällige Schwankung ist.
Bei Umfragen zur Sonntagsfrage und bei der Messung von Einschaltquoten behandelt man die Anzahl der Personen unter den \(n\) Befragten, die eine bestimmte Antwort geben, als binomialverteilt. Die Fehlermarge „plus/minus einige Prozentpunkte“ wird aus der Standardabweichung \(\sqrt{np(1-p)}\) und der Normalapproximation berechnet.
Wie viele Personen befragt werden müssen, um die Fehlermarge auf eine Zielgröße zu senken, richtet sich unmittelbar nach den Eigenschaften der Binomialverteilung.
Formeln und Diagramme
Symbole und Begriffe
Symbole
| \(X\) | X | Die Zufallsgröße für die Anzahl der Treffer. Üblicherweise schreibt man Zahlen, die vom Zufall bestimmt werden, mit Großbuchstaben vom Ende des Alphabets, etwa \(X,\ Y,\ Z\). |
| \(P(X = k)\) | P von X gleich k | Die Wahrscheinlichkeit, dass die Trefferzahl \(X\) genau \(k\) ist. \(P\) steht für „Probability“, das englische Wort für Wahrscheinlichkeit. |
| \({}_{n}\mathrm{C}_{k}\) | n über k | Die Anzahl der Kombinationen, \(k\) von \(n\) Dingen auszuwählen. \(C\) steht für „Combination“. In deutschen Schulbüchern schreibt man stattdessen meist den Binomialkoeffizienten \(\dbinom{n}{k}\), gelesen „\(n\) über \(k\)“. |
| \(n\) | n | Die Anzahl der Versuche (wie oft Sie wiederholen). Für eine Anzahl wird häufig der Buchstabe \(n\) verwendet. |
| \(p\) | p | Die Wahrscheinlichkeit für einen Treffer bei einem Versuch (Trefferwahrscheinlichkeit). Der Buchstabe stammt von „Probability“, und der Kleinbuchstabe steht häufig für die Wahrscheinlichkeit eines einzelnen Versuchs. |
| \(1 - p\) | eins minus p | Die Wahrscheinlichkeit für eine Niete bei einem Versuch (kein Treffer). Es tritt immer entweder ein Treffer oder eine Niete ein, also bleibt, was von der Gesamtwahrscheinlichkeit \(1\) nach Abzug von \(p\) übrig ist. Sie wird auch \(q\) geschrieben. |
| \(k\) | k | Die Anzahl der Treffer, eine ganze Zahl von \(0\) bis \(n\). Der Buchstabe \(k\) wird häufig verwendet, um „wie oft“ anzugeben. |
| \(P(X \le k)\) | P von X kleiner gleich k | Die Wahrscheinlichkeit für höchstens \(k\) Treffer (irgendeine Zahl von 0 bis \(k\)). Es ist eine kumulierte Wahrscheinlichkeit, die bis \(k\) aufaddierten exakten Wahrscheinlichkeiten. |
| \(P(X \ge k)\) | P von X größer gleich k | Die Wahrscheinlichkeit für mindestens \(k\) Treffer (irgendeine Zahl von \(k\) bis \(n\)). Zieht man \(P(X \le k-1)\) von der Gesamtwahrscheinlichkeit \(1\) ab (das Gegenereignis), wird die Summe kürzer. |
| \(E(X)\) | E von X | Der Erwartungswert (die durchschnittliche Trefferzahl). \(E\) steht für „Expectation“. Bei der Binomialverteilung ist \(E(X) = np\). Er wird auch \(\mu\) geschrieben. |
| \(\mathrm{Var}(X)\) | Varianz von X | Die Varianz (wie stark die Ergebnisse streuen). Bei der Binomialverteilung ist \(\mathrm{Var}(X) = np(1-p)\). Sie wird auch \(V(X)\) oder \(\sigma^2\) geschrieben. |
| \(\sigma\) | Sigma | Die Standardabweichung. Der griechische Kleinbuchstabe Sigma. Sie ist die Quadratwurzel der Varianz, \(\sigma = \sqrt{\mathrm{Var}(X)}\), und zeigt den typischen Abstand zum Erwartungswert. |
| \(B(n; p)\) | B von n Strichpunkt p | Die Binomialverteilung mit \(n\) Versuchen und der Trefferwahrscheinlichkeit \(p\). \(B\) steht für „binomial“. „\(X\) ist binomialverteilt“ schreibt man \(X \sim B(n; p)\). |
| \(N(\mu; \sigma^2)\) | N von My Strichpunkt Sigma Quadrat | Die Normalverteilung mit Mittelwert \(\mu\) und Varianz \(\sigma^2\). \(N\) steht für „normal“. Üblicherweise lautet die Reihenfolge in der Klammer „Mittelwert; Varianz“. |
| \(\approx\) | ungefähr gleich | Das Zeichen für „ungefähr gleich“. Auf dieser Seite zeigt es, dass sich die Binomialverteilung näherungsweise durch die Normalverteilung ersetzen lässt. |
Begriffe
| Binomialverteilung | Die Wahrscheinlichkeitsverteilung von „wie oft etwas mit der Wahrscheinlichkeit \(p\) bei \(n\) Versuchen eintritt“. Der Name kommt daher, dass das \({}_{n}\mathrm{C}_{k}\) in der Formel dasselbe ist wie der Binomialkoeffizient (die Koeffizienten im binomischen Lehrsatz). In Deutschland wird sie in der Stochastik der Oberstufe behandelt. |
| Zufallsgröße | Eine Variable, deren Wert vom Zufall bestimmt wird. Auf dieser Seite ist die Trefferzahl die Zufallsgröße. Sie nimmt die Werte von 0 bis höchstens n an, jeden mit einer eigenen Wahrscheinlichkeit. |
| Versuch | Eine einzelne Durchführung eines Experiments oder einer Beobachtung, deren Ergebnis vom Zufall bestimmt wird, etwa ein Münzwurf oder das Ziehen eines Loses. |
| Bernoulli-Kette | Derselbe Versuch wird jedes Mal mit derselben Wahrscheinlichkeit wiederholt, ohne dass sich die Ergebnisse gegenseitig beeinflussen (unabhängig). Die Binomialverteilung ist die Verteilung der Trefferzahl in einer Bernoulli-Kette. |
| unabhängig | Wenn das Ergebnis eines Versuchs das Ergebnis eines anderen nicht beeinflusst. Der erste und der zweite Wurf eines Würfels sind unabhängig, das Ziehen von Losen ohne Zurücklegen dagegen nicht (weil die früheren Ergebnisse ändern, wie viele Gewinne übrig sind). |
| Kombination | Eine Möglichkeit, \(k\) von \(n\) Dingen auszuwählen, wobei die Reihenfolge keine Rolle spielt. Die Gesamtzahl davon ist \({}_{n}\mathrm{C}_{k}\) (der Binomialkoeffizient). In der Binomialverteilung zählt sie die Möglichkeiten, auszuwählen, bei welchen der \(n\) Versuche ein Treffer eintritt. |
| kumulierte Wahrscheinlichkeit | Die bis zu einer bestimmten Trefferzahl aufaddierten exakten Wahrscheinlichkeiten. Die Wahrscheinlichkeit für höchstens \(k\) Treffer, \(P(X \le k)\), ist das typische Beispiel. Sie ist die Verteilungsfunktion der Zufallsgröße. |
| Gegenereignis | Das Ereignis, dass etwas nicht eintritt. Die Wahrscheinlichkeiten ergeben immer zusammen 1, also lässt sich eine Wahrscheinlichkeit wie „mindestens \(k\)“ leicht finden, indem man die Gegenseite (höchstens \(k-1\)) von 1 abzieht. |
| Erwartungswert | Der durchschnittliche Wert, wenn Sie die Versuche oft wiederholen. Bei der Binomialverteilung ist es die durchschnittliche Trefferzahl, gegeben durch die einfache Formel \(np\). |
| Varianz | Ein Maß dafür, wie weit die tatsächlichen Werte typischerweise vom Erwartungswert abweichen (die Streuung). Sie ist als Mittelwert der quadrierten Abweichungen definiert. |
| Standardabweichung | Die Quadratwurzel der Varianz. Die Varianz hat quadrierte Einheiten, also führt das Wurzelziehen zur ursprünglichen Einheit zurück (hier die Trefferzahl) und ergibt ein Maß für die Streuung. |
| Normalverteilung | Eine symmetrische, glockenförmige Verteilung, bei der Werte nahe am Mittelwert am wahrscheinlichsten sind und Werte weiter weg weniger wahrscheinlich. Viele reale Größen wie Körpergrößen und Messfehler haben annähernd diese Form, und auch die Binomialverteilung nähert sich ihr bei großem \(n\). |
| Normalapproximation | Das Ersetzen der Binomialverteilung durch die Normalverteilung \(N(np; np(1-p))\) bei großem \(n\). Die gängige Faustregel ist \(np \ge 5\) und \(n(1-p) \ge 5\) (in Schulbüchern oft die Laplace-Bedingung \(\sigma > 3\)). |
Was Sie vorab wissen sollten
Damit Sie die Berechnung auf dieser Seite mit echtem Verständnis nutzen können und nicht nur auf die Schaltfläche klicken, hilft Ihnen das folgende Grundwissen.
Wenn Sie nicht weiterkommen, ist es der schnellste Weg, die Themen dieser Tabelle noch einmal durchzugehen.
| Grundlagen der Wahrscheinlichkeit (Klasse 7, 12–13 Jahre) |
|
| Rechnen mit Brüchen (Klasse 5–6, 10–12 Jahre) |
|
| Potenzen (Klasse 7–8, 12–14 Jahre) |
|
| Kombinatorik und Kombinationen (Sekundarstufe II, ab 15 Jahren) |
|
| Bernoulli-Ketten und das Gegenereignis (Sekundarstufe II, ab 15 Jahren) |
|
| Zufallsgrößen, Erwartungswert und Varianz (Sekundarstufe II, ab 16 Jahren) |
|
| Die Normalverteilung (Sekundarstufe II, ab 16 Jahren) |
|
Mit Excel berechnen
| Anzahl der Versuche n | 4 |
| Trefferwahrscheinlichkeit p | 0,5 |
| Anzahl der Treffer k | 2 |
| Wahrscheinlichkeit für genau k Treffer P(X=k) | =BINOM.VERT(B3;B1;B2;FALSCH) |
| Anzahl der Versuche n | 4 |
| Trefferwahrscheinlichkeit p | 0,5 |
| Anzahl der Treffer k | 2 |
| Wahrscheinlichkeit für höchstens k Treffer P(X≤k) | =BINOM.VERT(B3;B1;B2;WAHR) |
| Wahrscheinlichkeit für mindestens k Treffer P(X≥k) | =1-BINOM.VERT(B3-1;B1;B2;WAHR) |
| Anzahl der Versuche n | 30 |
| Trefferwahrscheinlichkeit p | =1/6 |
| Erwartungswert E(X) = np | =B1*B2 |
| Varianz Var(X) = np(1-p) | =B1*B2*(1-B2) |
| Standardabweichung σ | =WURZEL(B4) |
| Anzahl der Versuche n | 20 |
| Trefferwahrscheinlichkeit p | 0,5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| Faustregel erfüllt? | =UND(B3>=5;B4>=5) |
BINOM.VERT ist die Funktion der Binomialverteilung. Ihre Argumente lauten der Reihe nach „Anzahl der Treffer; Anzahl der Versuche; Trefferwahrscheinlichkeit; kumuliert oder nicht“. Mit FALSCH am Ende erhalten Sie die exakte Wahrscheinlichkeit, mit WAHR die kumulierte Wahrscheinlichkeit für höchstens diese Trefferzahl.
Die erste Tabelle ist das Beispiel für genau 2-mal Kopf bei 4 Münzwürfen, und die Antwort ist 0,375 (= 3/8).
Beide Antworten in der zweiten Tabelle sind 0,6875. „Mindestens k“ ergibt sich, indem man „höchstens k−1“ von 1 abzieht (diese Formel liefert einen Fehler, wenn k gleich 0 ist, aber die Wahrscheinlichkeit für 0 oder mehr ist immer 1).
Die dritte Tabelle ist die Anzahl der Einsen bei 30 Würfen mit einem Würfel: Erwartungswert 5, Varianz 4,1667 und Standardabweichung 2,0412.
Die vierte Tabelle zeigt WAHR, wenn np und n(1−p) beide mindestens 5 sind (die Faustregel für die Normalapproximation ist erfüllt), und sonst FALSCH.
Mit Google Tabellen berechnen
| Anzahl der Versuche n | 4 |
| Trefferwahrscheinlichkeit p | 0,5 |
| Anzahl der Treffer k | 2 |
| Wahrscheinlichkeit für genau k Treffer P(X=k) | =BINOMVERT(B3;B1;B2;FALSCH) |
| Anzahl der Versuche n | 4 |
| Trefferwahrscheinlichkeit p | 0,5 |
| Anzahl der Treffer k | 2 |
| Wahrscheinlichkeit für höchstens k Treffer P(X≤k) | =BINOMVERT(B3;B1;B2;WAHR) |
| Wahrscheinlichkeit für mindestens k Treffer P(X≥k) | =1-BINOMVERT(B3-1;B1;B2;WAHR) |
| Anzahl der Versuche n | 30 |
| Trefferwahrscheinlichkeit p | =1/6 |
| Erwartungswert E(X) = np | =B1*B2 |
| Varianz Var(X) = np(1-p) | =B1*B2*(1-B2) |
| Standardabweichung σ | =WURZEL(B4) |
| Anzahl der Versuche n | 20 |
| Trefferwahrscheinlichkeit p | 0,5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| Faustregel erfüllt? | =UND(B3>=5;B4>=5) |
Wie in Excel liefert die Formel für „mindestens k“ einen Fehler, wenn k gleich 0 ist (die Wahrscheinlichkeit für 0 oder mehr ist immer 1).
Mit Python berechnen
from fractions import Fraction
from math import comb, sqrt

trial_count = 4                  # Anzahl der Versuche n
success_prob = Fraction(1, 2)    # Trefferwahrscheinlichkeit p (auch eine Dezimalzahl wie 0.3 geht)
success_count = 2                # Anzahl der Treffer k

failure_prob = 1 - success_prob

# Wahrscheinlichkeit für genau k Treffer P(X=k) = nCk × p^k × (1−p)^(n−k)
exact_prob = (comb(trial_count, success_count)
              * success_prob ** success_count
              * failure_prob ** (trial_count - success_count))
print(f"Wahrscheinlichkeit für genau {success_count} Treffer: {exact_prob} = {float(exact_prob)}")

# kumulierte Wahrscheinlichkeiten (höchstens k, mindestens k)
prob_le = sum(comb(trial_count, i) * success_prob ** i * failure_prob ** (trial_count - i)
              for i in range(success_count + 1))
prob_ge = 1 - prob_le + exact_prob
print(f"Wahrscheinlichkeit für höchstens {success_count} Treffer: {prob_le} = {float(prob_le)}")
print(f"Wahrscheinlichkeit für mindestens {success_count} Treffer: {prob_ge} = {float(prob_ge)}")

# Erwartungswert, Varianz und Standardabweichung
mean = trial_count * success_prob
variance = mean * failure_prob
print(f"Erwartungswert: {mean}  Varianz: {variance}  Standardabweichung: {sqrt(variance)}")
Die Formel in LaTeX und anderen mathematischen Schreibweisen (zum Kopieren)
P(X = k) = nCk · pᵏ · (1 − p)ⁿ⁻ᵏ
P(X = k) = \binom{n}{k} \cdot p^{k} \cdot (1 - p)^{n - k}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>=</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>k</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>k</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>k</mi></mrow>
</msup>
</mrow>
</math>
P(X = k) = C(n,k) p^k (1-p)^(n-k)
PDF[BinomialDistribution[n, p], k]
binomial(n, k)*p^k*(1-p)^(n-k);
binopdf(k, n, p)
P(X=k) = C(n,k) p^k (1-p)^(n-k)
P(X ≤ k) = Σ[i=0→k] nCi · pⁱ · (1 − p)ⁿ⁻ⁱ
P(X \le k) = \sum_{i=0}^{k} \binom{n}{i} \cdot p^{i} \cdot (1 - p)^{n - i}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>≤</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>0</mn></mrow>
<mi>k</mi>
</munderover>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>i</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>i</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>i</mi></mrow>
</msup>
</mrow>
</math>
P(X <= k) = sum_(i=0)^k C(n,i) p^i (1-p)^(n-i)
CDF[BinomialDistribution[n, p], k]
add(binomial(n, i)*p^i*(1-p)^(n-i), i = 0..k);
binocdf(k, n, p)
P(X≤k) = Σ_(i=0)^k C(n,i) p^i (1-p)^(n-i)
E(X) = np, Var(X) = np(1 − p), σ = √(np(1 − p))
E(X) = np, \quad \mathrm{Var}(X) = np(1 - p), \quad \sigma = \sqrt{np(1 - p)}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo><mi>n</mi><mi>p</mi>
<mo>,</mo>
<mi>Var</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>,</mo>
<mi>σ</mi><mo>=</mo>
<msqrt><mi>n</mi><mi>p</mi><mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow></msqrt>
</mrow>
</math>
E(X) = np, Var(X) = np(1-p), sigma = sqrt(np(1-p))
{Mean[BinomialDistribution[n, p]], Variance[BinomialDistribution[n, p]], StandardDeviation[BinomialDistribution[n, p]]}
n*p; n*p*(1-p); sqrt(n*p*(1-p));
[m, v] = binostat(n, p); s = sqrt(v);
E(X) = np, Var(X) = np(1-p), σ = √(np(1-p))
B(n; p) ≈ N(np; np(1 − p))
B(n; p) \approx N(np; np(1 - p))
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>B</mi><mo>(</mo><mi>n</mi><mo>;</mo><mi>p</mi><mo>)</mo>
<mo>≈</mo>
<mi>N</mi><mo>(</mo><mi>n</mi><mi>p</mi><mo>;</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>)</mo>
</mrow>
</math>
B(n; p) ~~ N(np; np(1-p))
NormalDistribution[n p, Sqrt[n p (1 - p)]]
Normal(n*p, sqrt(n*p*(1-p)));
pd = makedist('Normal', 'mu', n*p, 'sigma', sqrt(n*p*(1-p)));
B(n; p) ≈ N(np; np(1-p))
Die Berechnung von ChatGPT ausführen lassen
Sie sind ein Assistent für Mathematik (Wahrscheinlichkeitsrechnung und Statistik). Führen Sie die folgende Berechnung aus, indem Sie tatsächlich Python-Code ausführen, und stützen Sie Ihre Antwort nur auf die Zahlen aus dem Ausführungsergebnis (rechnen Sie nicht im Kopf und raten Sie nicht).

Sie nehmen 10-mal an einer Verlosung teil, und jede Teilnahme gewinnt mit der Wahrscheinlichkeit 1/6. Berechnen Sie für die Binomialverteilung der Anzahl der Gewinne:
1. Die Wahrscheinlichkeit für genau 2 Gewinne, P(X=2) (als vollständig gekürzten Bruch und als Dezimalzahl)
2. Die Wahrscheinlichkeit für höchstens 2 Gewinne, P(X≤2), und für mindestens 2 Gewinne, P(X≥2)
3. Den Erwartungswert E(X), die Varianz Var(X) und die Standardabweichung σ
4. Ob die Faustregel für die Normalapproximation, np ≥ 5 und n(1−p) ≥ 5, erfüllt ist

Rechnen Sie in Python exakt mit fractions und math.comb aus der Standardbibliothek und zeigen Sie die verwendeten Formeln und die Zahlen aus dem Ausführungsergebnis.
Anleitung
-
1Zahlen eingebenGeben Sie die Zahlen, mit denen Sie rechnen möchten, in die Eingabefelder ein
-
2BerechnenKlicken Sie auf die Schaltfläche „Berechnen“
-
3Ergebnis ablesenDas Ergebnis erscheint sofort. Auf derselben Seite finden Sie auch den Rechenweg und die Erklärung der Formel
Die Vorteile von DataChef

Kein Fachwissen nötig – einfach und intuitiv

Keine persönlichen Daten erforderlich

Die Datei wird nach dem Download automatisch gelöscht


Keine Quellenangabe nötig

Keine vorherige Genehmigung erforderlich
Verwandte Funktionen
Wahrscheinlichkeit bei wiederholten Versuchen (mindestens einmal, n-mal in Folge)
Berechnet die Wahrscheinlichkeit, dass etwas n-mal hintereinander, mindestens einmal oder nie eintritt
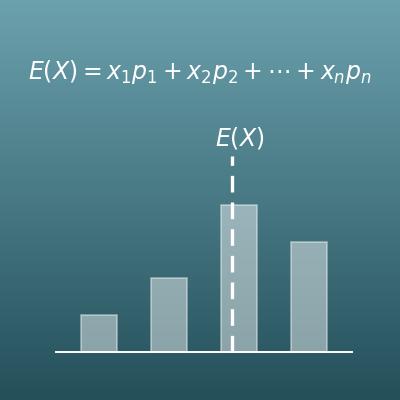
Erwartungswert berechnen (Varianz, Standardabweichung)
Berechnet aus einer Verteilungstabelle den Erwartungswert E(X), die Varianz Var(X) und die Standardabweichung. Für jede Verteilung, nicht nur die Binomialverteilung
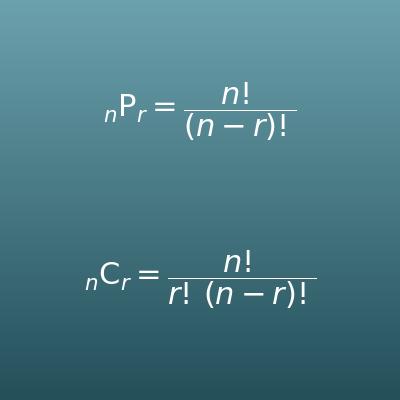
Kombinatorik Rechner (Variationen, Kombinationen, n über k)
Berechnet die Anzahl der Kombinationen nCr (nCk) aus der Formel der Binomialverteilung einzeln, mit Rechenweg

Normalverteilung berechnen (Wahrscheinlichkeit für einen Bereich)
Berechnet aus Mittelwert und Standardabweichung die Wahrscheinlichkeit, dass ein Wert in einen bestimmten Bereich fällt. Für die Normalapproximation der Binomialverteilung