Stichprobengröße für A/B-Tests berechnen – Besuche pro Variante und Testdauer aus MDE, Signifikanz und Teststärke
Für die Stichprobengröße geben Sie Basis-CVR, MDE, Signifikanzniveau und Teststärke ein und klicken auf „Berechnen“. Sie erhalten die Stichprobengröße pro Variante A und B (aufgerundet) und insgesamt, mit den Besuchen pro Tag auch die nötigen Tage. Stellen Sie „Gesucht“ auf Teststärke, um die Stichprobe pro Variante festzulegen und stattdessen die Teststärke 1 − β zu berechnen.
Inhaltsverzeichnis
-
Das können Sie auf dieser Seite
-
Wofür braucht man diese Berechnung?
-
Anleitung
-
Formeln und Abbildungen
-
Symbole und Begriffe
-
Das sollten Sie vorher wissen
-
So berechnen Sie es in Excel
-
So berechnen Sie es in Google Tabellen
-
So berechnen Sie es in Python
-
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
-
So lassen Sie ChatGPT rechnen
-
Die Vorteile von DataChef
-
Verwandte Funktionen
-
Alle Rechner von NumberChef
Das können Sie auf dieser Seite
- Geben Sie die Basis-CVR (die Conversion-Rate Ihrer aktuellen Variante A), den minimalen nachweisbaren Effekt (MDE, relativ in % oder in Prozentpunkten), das Signifikanzniveau \(\alpha\) (zwei- oder einseitig) und die Teststärke \(1-\beta\) ein – Sie erhalten die nötige Stichprobengröße pro Variante Ihres A/B-Tests (aufgerundet) und insgesamt
- „Meine Seite konvertiert mit 3 %. Wie viele Besuche brauchen A und B jeweils, um einen Uplift von 10 % (3 % auf 3,3 %) nachzuweisen?“ Diese Seite beantwortet die wichtigste Frage vor dem Start eines Tests
- Mit den Besuchen pro Tag (optional) sehen Sie auch, wie viele Tage es dauert, bis die Stichprobe erreicht ist (aufgerundet)
- Steht die Zahl der Besuche pro Variante schon fest, legen Sie die Stichprobe fest und berechnen umgekehrt die Teststärke \(1-\beta\) (die Wahrscheinlichkeit, einen echten Unterschied auch zu finden)
- Dazu ein Graph, wie sich die Stichprobengröße mit dem MDE ändert, eine leicht verständliche Erklärung der Formeln und Formeln zum Kopieren für Excel, Google Tabellen und Python
Wofür braucht man diese Berechnung?
Angenommen, die Produktseite eines Onlineshops konvertiert mit 2 %, und Sie wollen nachweisen, dass ein neuer Buttontext einen relativen Uplift von 10 % bringt (2 % auf 2,2 %). Bei einem Signifikanzniveau von 5 % (zweiseitig) und 80 % Teststärke brauchen Sie etwa 80.682 Besuche pro Variante, insgesamt etwa 161.364.
Ein Vergleich von ein paar Dutzend oder ein paar Hundert Besuchen („B war letzte Woche besser“) kann einen zufälligen nicht von einem echten Unterschied unterscheiden. Wer die Stichprobe vor dem Start berechnet, verschwendet keine Wochen mit einem Test, der keine Antwort liefern kann.
Eine Landingpage erzielt Demo-Anfragen mit einer CVR von 5 %. Um einen Uplift von 1 Prozentpunkt (5 % auf 6 %) nachzuweisen, brauchen Sie 8.158 Besuche pro Variante, insgesamt 16.316. Bei 300 Besuchen am Tag sind das \(16316 \div 300 \approx 54{,}4\), also 55 Tage – oder 8 Wochen, wenn Sie die Wochentage ausgleichen wollen.
Will jemand nach 2 Wochen Ergebnisse, können Sie mit Zahlen erklären: „In 2 Wochen (4.200 Besuche, 2.100 pro Variante) bräuchten wir einen viel größeren MDE von etwa 3 Prozentpunkten (5 % auf 8 %, dafür reichen 1.059 pro Variante).“
Hat Ihr Newsletter eine Öffnungsrate von 20 % und wollen Sie nachweisen, dass eine neue Betreffzeile 2 Prozentpunkte mehr bringt (20 % auf 22 %), müssen Sie an 6.510 Personen pro Variante senden, insgesamt 13.020 (Signifikanzniveau 5 %, Teststärke 80 %).
Eine Kennzahl mit hoher Quote wie die Öffnungsrate braucht weniger Personen, um einen Unterschied zu zeigen, als eine CVR von wenigen Prozent. Das liegt am Teil \(p(1-p)\) der Formel: Dieselben „2 Punkte“ brauchen je nach Kennzahl eine andere Stichprobe.
Angenommen, ein Test sollte auf einer Seite mit 3 % CVR einen relativen Uplift von 10 % zeigen, lief mit 5.000 Besuchen pro Variante und ergab „kein signifikanter Unterschied“. Rechnet man die Teststärke zurück, liegt sie nur bei etwa 13,5 %. Der Test war so angelegt, dass er eine echte Verbesserung in mehr als 8 von 10 Fällen übersieht.
Das richtige Fazit lautet hier nicht „es hat nichts gebracht“, sondern „mit dieser Stichprobe ließ sich das nicht feststellen“. Wer die Teststärke zurückrechnet, liest Tests nicht falsch und verwirft keine guten Ideen.
Eine App hat eine Retention am nächsten Tag von 40 %. Um nachzuweisen, dass ein neues Tutorial einen relativen Uplift von 10 % bringt (40 % auf 44 %), genügen etwa 2.389 neue Nutzer pro Variante, insgesamt etwa 4.778 (Signifikanzniveau 5 %, Teststärke 80 %).
Eine Kennzahl nahe 50 % wie die Retention hat eine große Streuung, aber auch der Unterschied der Quoten (4 Punkte) ist groß – Ergebnisse kommen daher schneller als bei einem Test auf eine CVR von wenigen Prozent. Die Stichprobe für jede Kennzahl abzuschätzen, hilft auch bei der Entscheidung, welche Verbesserung Sie zuerst angehen.
Bei einem Test, bei dem eine übersehene gute Idee teuer wäre, etwa bei einer geänderten Preisdarstellung, können Sie die Teststärke von 80 % auf 90 % erhöhen. Bei 3 % CVR und einem relativen Uplift von 10 % steigt die Stichprobe pro Variante von 53.211 auf 71.233 (etwa das 1,34-Fache).
Die Rechnung zeigt genau, wie viele Besuche mehr nötig sind, um das Übersehen zu halbieren (von 20 % auf 10 %) – so passen Sie Stichprobe und Testdauer an die Bedeutung des Tests an.
Formeln und Abbildungen
Symbole und Begriffe
Symbole
| \(p_1\) | p eins | Die Basis-CVR (die Conversion-Rate der aktuellen Variante A). \(p\) steht für „Proportion“ (Anteil) oder „Probability“ (Wahrscheinlichkeit). In den Formeln wird 3 % als Dezimalzahl 0,03 geschrieben. |
| \(p_2\) | p zwei | Die Ziel-CVR (die Conversion-Rate, die Variante B erreichen soll). Relativ in % ist sie \(p_1 (1 + r/100)\), in Prozentpunkten \(p_1 + d\). |
| \(\bar{p}\) | p quer | Der Mittelwert der beiden CVRs, \((p_1 + p_2) \div 2\): die gemeinsame CVR, die man ohne Unterschied annimmt. Der Strich darüber kennzeichnet in der Statistik einen Mittelwert. |
| \(r\) | Er | Der relativ in % angegebene MDE (r wie „Ratio“, Verhältnis): um wie viel Prozent sich die Basis-CVR verbessert (3 % auf 3,3 % ergibt \(r = 10\)). |
| \(d\) | De | Der in Prozentpunkten angegebene MDE (d wie Differenz): die reine Differenz der CVR (3 % auf 3,3 % ergibt \(d = 0{,}3\) Punkte). |
| \(p_2 - p_1\) | p zwei minus p eins | Der nachzuweisende Unterschied, in Prozentpunkten als Dezimalzahl (0,3 Punkte sind 0,003). Die Stichprobe wird durch sein Quadrat geteilt – je kleiner der Unterschied, desto schneller wächst die Stichprobe. |
| \(\alpha\) | Alpha | Das Signifikanzniveau: die Wahrscheinlichkeit, einen Unterschied für echt zu halten, den es nicht gibt (die Wahrscheinlichkeit eines Fehlers 1. Art). Üblich sind 5 % (0,05). Alpha ist der erste griechische Buchstabe und steht in der Statistik für den Fehler „erster“ Art. |
| \(\beta\) | Beta | Die Wahrscheinlichkeit, einen echten Unterschied zu übersehen (die Wahrscheinlichkeit eines Fehlers 2. Art). Beta ist der zweite griechische Buchstabe und steht für den Fehler „zweiter“ Art. |
| \(1-\beta\) | eins minus Beta | Die Teststärke: die Wahrscheinlichkeit, einen echten Unterschied zu erkennen. Üblich sind 80 % oder 90 %. |
| \(z_{\alpha/2}\) | z Index Alpha halbe | Der z-Wert zum Signifikanzniveau \(\alpha\) beim zweiseitigen Test (der Punkt, oberhalb dessen \(\alpha/2\) der Standardnormalverteilung liegt). 1,9600 bei 5 %, 2,5758 bei 1 % und 1,6449 bei 10 %. Ein einseitiger Test verwendet stattdessen \(z_{\alpha}\) (1,6449 bei 5 %). |
| \(z_{\beta}\) | z Index Beta | Der z-Wert zur Teststärke \(1-\beta\) (der Punkt, unterhalb dessen die Wahrscheinlichkeit \(1-\beta\) der Standardnormalverteilung liegt). 0,8416 bei 80 % und 1,2816 bei 90 %. |
| \(z_{1-\beta}\) | z Index eins minus Beta | In der Formel für die Teststärke der aus der Stichprobe zurückgerechnete z-Wert. Setzt man ihn in \(\Phi\) ein, erhält man die Teststärke (dasselbe wie \(z_{\beta}\), nur von der gesuchten Größe her geschrieben). |
| \(\Phi\) | Phi (groß) | Die Verteilungsfunktion der Standardnormalverteilung. Sie liefert die Wahrscheinlichkeit, dass ein z-Wert höchstens einen bestimmten Wert annimmt: \(\Phi(1{,}96) \approx 0{,}975\) und \(\Phi(0{,}8416) \approx 0{,}80\). Das große griechische Phi ist das übliche Zeichen dafür. |
| \(n\) | En | Die Stichprobe pro Variante (je A und B), n wie „Number“ (Anzahl). Für A und B zusammen sind es \(2n\). |
| \(\sqrt{\ \ }\) | Wurzel | Die Quadratwurzel: die positive Zahl, die quadriert die Zahl darunter ergibt, etwa \(\sqrt{30000} \approx 173{,}205\). Sie taucht auf, wenn man die Streuung (Standardabweichung) einer CVR bestimmt. |
| \(V\) | Vau | Die Besuche pro Tag (alle Besuche der getesteten Seite, A und B zusammen), V wie englisch „Visits“. |
| \(D\) | De | Die nötigen Tage, D wie englisch „Days“. |
| \(\lceil\ \rceil\) | Aufrundungsklammern | Das Zeichen für Aufrunden (die Aufrundungsfunktion). Es liefert die kleinste ganze Zahl, die größer oder gleich der Zahl darin ist (\(\lceil 53{,}211 \rceil = 54\)). |
Begriffe
| A/B-Test | Ein Experiment, das Besucher im selben Zeitraum zufällig auf die aktuelle Variante (A) und eine neue Variante (B) verteilt, um zu sehen, welche besser abschneidet (z. B. eine höhere CVR hat). Damit prüfen Sie mit Daten statt Bauchgefühl, ob eine Änderung wie Buttonfarbe, Überschrift, Preisdarstellung oder Aufbau einer Landingpage wirklich hilft. |
| CVR (Conversion-Rate) | Der Anteil der Besuche oder Klicks, die in einer Zielaktion (einer Conversion) wie Kauf oder Anmeldung enden. In den Formeln dieser Seite ist die CVR von Variante A \(p_1\) und die von Variante B \(p_2\). |
| MDE (minimaler nachweisbarer Effekt) | Der kleinste Uplift, den Sie nachweisen können wollen (Minimum Detectable Effect). Er ist der erste Wert, den Sie bei der Planung eines A/B-Tests festlegen. Je kleiner er ist, desto schneller wächst die Stichprobe (umgekehrt proportional zum Quadrat des Unterschieds) – wählen Sie daher den kleinsten Uplift, der für Ihr Geschäft wirklich zählt. |
| Signifikanzniveau | Die Wahrscheinlichkeit \(\alpha\), die Sie für den Fehler in Kauf nehmen, einen zufälligen Unterschied für echt zu halten, obwohl es keinen gibt. Üblich sind 5 % – etwa ein Fehlalarm in 20 Fällen. Ein strengeres Niveau (1 %) braucht eine größere Stichprobe. |
| Teststärke (Power) | Die Wahrscheinlichkeit \(1-\beta\), einen echten Unterschied auch zu erkennen. Üblich sind 80 % – man nimmt in Kauf, etwa jeden fünften echten Uplift zu übersehen. Sagt ein Test mit geringer Teststärke „kein Unterschied“, ist das kein Beleg, dass es keinen gibt. |
| Fehler 1. Art | Der Fehler, einen Unterschied für echt zu halten, den es nicht gibt (falsch positiv, α-Fehler). Die zulässige Wahrscheinlichkeit dafür ist das Signifikanzniveau \(\alpha\). Er ist die Kehrseite des Fehlers 2. Art (Übersehen): Drückt man den einen, steigt meist der andere. Der grundlegende Weg, beide klein zu halten, ist eine größere Stichprobe. |
| Fehler 2. Art | Der Fehler, einen echten Unterschied zu übersehen (falsch negativ, β-Fehler). Seine Wahrscheinlichkeit ist \(\beta\), und \(1-\beta\) ist die Teststärke. Er ist die Kehrseite des Fehlers 1. Art (Fehlalarm): Drückt man den einen, steigt meist der andere. Der grundlegende Weg, beide klein zu halten, ist eine größere Stichprobe. |
| Nullhypothese | Die Hypothese „Variante A und B haben dieselbe CVR“, die der Test widerlegen will. Der Test fragt, wie ungewöhnlich die Daten wären, wenn die Nullhypothese stimmt. Sind sie ungewöhnlich genug, wird sie abgelehnt, und das Ergebnis lautet „Unterschied“ (die Alternativhypothese wird angenommen). |
| Alternativhypothese | Die Hypothese „Variante A und B haben unterschiedliche CVRs“, die der Test zeigen will. Sie wird angenommen, wenn die Nullhypothese (kein Unterschied) abgelehnt wird. |
| zweiseitiger Test | Ein Test, der sowohl „B ist höher“ als auch „B ist niedriger“ als Unterschied zählt. Er ist richtig für einen gewöhnlichen A/B-Test, bei dem die Richtung offen ist. Er braucht eine größere Stichprobe als ein einseitiger Test, erkennt aber auch, wenn B schlechter abschneidet. |
| einseitiger Test | Ein Test, der nur nach „B ist höher“ sucht. Er braucht eine kleinere Stichprobe als ein zweiseitiger Test, kann aber nicht erkennen, wenn B schlechter abschneidet – Sie müssen ihn daher vor dem Start festlegen. (Nach dem Blick auf das Ergebnis auf einseitig umzustellen, ist unzulässig.) |
| z-Test für zwei Anteile | Ein Test, der mit einem z-Wert (dem standardisierten Unterschied) und der Standardnormalverteilung prüft, ob sich zwei Gruppen in einem Anteil (etwa der CVR) unterscheiden. Die Formeln dieser Seite ermitteln die Stichprobe für diesen Test. Die Näherung durch die Normalverteilung funktioniert, wenn jede Gruppe genug Conversions hat (als Faustregel mindestens 5 bis 10). |
| Standardnormalverteilung | Die Normalverteilung mit Mittelwert 0 und Standardabweichung 1 (symmetrische Glockenform). Ein z-Wert ist ein Punkt auf ihrer waagerechten Achse, und jedem z-Wert entspricht genau eine Wahrscheinlichkeit, etwa „rechts von 1,96 liegen 2,5 %“. |
| Verteilungsfunktion | Eine Funktion, die die Wahrscheinlichkeit für einen Wert höchstens so groß wie ein gegebener Wert liefert (kumulative Verteilungsfunktion). Die der Standardnormalverteilung heißt \(\Phi\) und steht am Ende der Formel für die Teststärke. In Excel ist es NORM.S.VERT (mit WAHR als zweitem Argument), in Python NormalDist().cdf. |
| Standardabweichung (Streuung) | Wie stark Daten streuen. Die Streuung eines Anteils \(p\) ist proportional zu \(\sqrt{p(1-p)}\). \(\sqrt{2\bar{p}(1-\bar{p})}\) und \(\sqrt{p_1(1-p_1)+p_2(1-p_2)}\) in den Formeln sind die Streuung der Differenz der CVRs beider Gruppen. |
| multiples Testen (multiple Vergleiche) | Mehrere B-Varianten oder Kennzahlen gleichzeitig vergleichen. Je mehr Vergleiche, desto eher wirkt mindestens einer zufällig signifikant; nötig ist dann eine Korrektur, etwa das Signifikanzniveau durch die Zahl der Vergleiche zu teilen (Bonferroni-Korrektur). |
| Peeking (vorzeitiger Abbruch) | Vor Erreichen der nötigen Stichprobe immer wieder auf das Ergebnis schauen und abbrechen, sobald es signifikant aussieht. Zufällige Unterschiede werden so leicht „gefunden“, und ein Test mit geplantem Signifikanzniveau von 5 % liegt in Wahrheit viel öfter falsch. Die Formeln dieser Seite setzen voraus, dass Sie die Stichprobe vorab festlegen und warten, bis sie erreicht ist. |
Das sollten Sie vorher wissen
Damit Sie die Berechnung auf dieser Seite mit Verständnis nutzen und nicht nur auf den Knopf drücken, hilft Ihnen Folgendes.
Kommen Sie nicht weiter, ist es am schnellsten, diese Themen noch einmal zu wiederholen.
| Prozentrechnung (Klasse 6–7, 11–13 Jahre) |
|
| Quadratwurzeln (Klasse 8–9, 13–15 Jahre) |
|
| Grundlagen der Wahrscheinlichkeitsrechnung (Klasse 7–10, 12–16 Jahre) |
|
| Normalverteilung und z-Werte (Oberstufe Stochastik, 16–18 Jahre) |
|
| Die Idee des Hypothesentests (Oberstufe Stochastik oder Einführung an der Hochschule, ab 16 Jahren) |
|
| Aufrunden (Klasse 4, 9–10 Jahre) |
|
So berechnen Sie es in Excel
| Basis-CVR p1 (%) | 3 |
| Relativer Uplift r (%) | 10 |
| Ziel-CVR p2 (%) | =B1*(1+B2/100) |
| Basis-CVR p1 (%) | 3 |
| Ziel-CVR p2 (%) | 3,3 |
| Signifikanzniveau α (%, zweiseitig) | 5 |
| Teststärke 1−β (%) | 80 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| z_β | =NORM.S.INV(B4/100) |
| Mittlere CVR p̄ | =(B1+B2)/2/100 |
| Stichprobe pro Variante n (aufgerundet) | =AUFRUNDEN((B5*WURZEL(2*B7*(1-B7))+B6*WURZEL(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2;0) |
| Stichprobe pro Variante n | 53211 |
| Besuche pro Tag V (A + B) | 2000 |
| Nötige Tage D (aufgerundet) | =AUFRUNDEN(2*B1/B2;0) |
| Basis-CVR p1 (%) | 3 |
| Ziel-CVR p2 (%) | 3,3 |
| Signifikanzniveau α (%, zweiseitig) | 5 |
| Stichprobe pro Variante n | 30000 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| Mittlere CVR p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ABS(B2-B1)/100*WURZEL(B4)-B5*WURZEL(2*B6*(1-B6)))/WURZEL(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| Teststärke 1−β (%) | =NORM.S.VERT(B7;WAHR)*100 |
Die erste Tabelle zeigt in B3 3,3 (Ziel-CVR 3,3 %), die zweite in B8 53211 (Stichprobe pro Variante), die dritte in B3 54 (nötige Tage) und die vierte in B8 etwa 55,71 (Teststärke 55,71 %).
NORM.S.INV macht aus einer Wahrscheinlichkeit einen z-Wert, NORM.S.VERT (mit WAHR als zweitem Argument) aus einem z-Wert eine Wahrscheinlichkeit. Für einen einseitigen Test streichen Sie „/2“ in der Formel für z_α/2, sodass sie =NORM.S.INV(1-B3/100) lautet. AUFRUNDEN(…;0) rundet auf.
So berechnen Sie es in Google Tabellen
| Basis-CVR p1 (%) | 3 |
| Relativer Uplift r (%) | 10 |
| Ziel-CVR p2 (%) | =B1*(1+B2/100) |
| Basis-CVR p1 (%) | 3 |
| Ziel-CVR p2 (%) | 3,3 |
| Signifikanzniveau α (%, zweiseitig) | 5 |
| Teststärke 1−β (%) | 80 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| z_β | =NORM.S.INV(B4/100) |
| Mittlere CVR p̄ | =(B1+B2)/2/100 |
| Stichprobe pro Variante n (aufgerundet) | =AUFRUNDEN((B5*WURZEL(2*B7*(1-B7))+B6*WURZEL(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2;0) |
| Stichprobe pro Variante n | 53211 |
| Besuche pro Tag V (A + B) | 2000 |
| Nötige Tage D (aufgerundet) | =AUFRUNDEN(2*B1/B2;0) |
| Basis-CVR p1 (%) | 3 |
| Ziel-CVR p2 (%) | 3,3 |
| Signifikanzniveau α (%, zweiseitig) | 5 |
| Stichprobe pro Variante n | 30000 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| Mittlere CVR p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ABS(B2-B1)/100*WURZEL(B4)-B5*WURZEL(2*B6*(1-B6)))/WURZEL(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| Teststärke 1−β (%) | =NORM.S.VERT(B7;WAHR)*100 |
So berechnen Sie es in Python
from math import sqrt, ceil
from statistics import NormalDist

base_cvr = 3.0          # Basis-CVR (%)
relative_mde = 10.0     # nachzuweisender MDE (relativ, %)
alpha = 0.05            # Signifikanzniveau (zweiseitig)
power = 0.80            # Teststärke
daily_visits = 2000     # Besuche pro Tag (A + B zusammen)

p1 = base_cvr / 100
p2 = p1 * (1 + relative_mde / 100)          # Ziel-CVR
z_alpha = NormalDist().inv_cdf(1 - alpha / 2)  # einseitig: 1 - alpha
z_beta = NormalDist().inv_cdf(power)
p_bar = (p1 + p2) / 2

n_exact = (z_alpha * sqrt(2 * p_bar * (1 - p_bar))
           + z_beta * sqrt(p1 * (1 - p1) + p2 * (1 - p2))) ** 2 / (p2 - p1) ** 2
n_per_group = ceil(n_exact)                  # Stichprobe pro Variante (aufgerundet)
days = ceil(2 * n_per_group / daily_visits)  # nötige Tage

print(f"Ziel-CVR: {p2 * 100:.4g} %")
print(f"Stichprobe pro Variante: {n_per_group} (insgesamt {2 * n_per_group})")
print(f"Nötige Tage: {days}")

# Umgekehrt: Teststärke bei 30.000 Besuchen pro Variante
n_fixed = 30000
z_power = (abs(p2 - p1) * sqrt(n_fixed) - z_alpha * sqrt(2 * p_bar * (1 - p_bar))) \
          / sqrt(p1 * (1 - p1) + p2 * (1 - p2))
print(f"Teststärke bei {n_fixed} pro Variante: {NormalDist().cdf(z_power) * 100:.2f} %")
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
p₂ = p₁ × (1 + r/100)
p_2 = p_1 \left(1 + \dfrac{r}{100}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mi>p</mi><mn>2</mn></msub>
    <mo>=</mo>
    <msub><mi>p</mi><mn>1</mn></msub>
    <mo>(</mo><mn>1</mn><mo>+</mo><mfrac><mi>r</mi><mn>100</mn></mfrac><mo>)</mo>
  </mrow>
</math>
p_2 = p_1 (1 + r/100)
p1*(1 + r/100)
p2 := p1*(1 + r/100);
p2 = p1*(1 + r/100);
p_2 = p_1 (1 + r/100)
n = (z_α/2 √(2p̄(1 − p̄)) + z_β √(p₁(1 − p₁) + p₂(1 − p₂)))² ÷ (p₂ − p₁)²
n = \dfrac{\left( z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})} + z_{\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2 - p_1)^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msup>
<mrow>
<mo>(</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
<mo>+</mo>
<msub><mi>z</mi><mi>β</mi></msub>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
<mo>)</mo>
</mrow>
<mn>2</mn>
</msup>
<msup>
<mrow><mo>(</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mfrac>
</mrow>
</math>
n = (z_(alpha/2) sqrt(2 bar p (1 - bar p)) + z_beta sqrt(p_1(1 - p_1) + p_2(1 - p_2)))^2 / (p_2 - p_1)^2
Ceiling[(za*Sqrt[2*pbar*(1 - pbar)] + zb*Sqrt[p1*(1 - p1) + p2*(1 - p2)])^2/(p2 - p1)^2]
n := ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = (z_(α/2) √(2p̄(1 − p̄)) + z_β √(p_1(1 − p_1) + p_2(1 − p_2)))^2/(p_2 − p_1)^2
D = ⌈2n ÷ V⌉
D = \left\lceil \dfrac{2n}{V} \right\rceil
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>D</mi>
<mo>=</mo>
<mo>⌈</mo>
<mfrac><mrow><mn>2</mn><mi>n</mi></mrow><mi>V</mi></mfrac>
<mo>⌉</mo>
</mrow>
</math>
D = |~ (2n)/V ~|
Ceiling[2*n/v]
days := ceil(2*n/V);
D = ceil(2*n/V);
D = ⌈2n/V⌉
1 − β = Φ((|p₂ − p₁|√n − z_α/2 √(2p̄(1 − p̄))) ÷ √(p₁(1 − p₁) + p₂(1 − p₂)))
1 - \beta = \Phi\left( \dfrac{|p_2 - p_1|\sqrt{n} - z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})}}{\sqrt{p_1(1-p_1)+p_2(1-p_2)}} \right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mn>1</mn><mo>−</mo><mi>β</mi>
<mo>=</mo>
<mi>Φ</mi>
<mo>(</mo>
<mfrac>
<mrow>
<mo>|</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>|</mo>
<msqrt><mi>n</mi></msqrt>
<mo>−</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
</mrow>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
</mfrac>
<mo>)</mo>
</mrow>
</math>
1 - beta = Phi((|p_2 - p_1| sqrt(n) - z_(alpha/2) sqrt(2 bar p (1 - bar p))) / sqrt(p_1(1 - p_1) + p_2(1 - p_2)))
CDF[NormalDistribution[0, 1], (Abs[p2 - p1]*Sqrt[n] - za*Sqrt[2*pbar*(1 - pbar)])/Sqrt[p1*(1 - p1) + p2*(1 - p2)]]
power := Statistics[CDF](Normal(0, 1), (abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
power = normcdf((abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
1 − β = Φ((|p_2 − p_1| √n − z_(α/2) √(2p̄(1 − p̄)))/√(p_1(1 − p_1) + p_2(1 − p_2)))
So lassen Sie ChatGPT rechnen
Sie sind ein Assistent für die Planung von A/B-Tests. Führen Sie die folgende Berechnung aus, indem Sie tatsächlich Python-Code ausführen, und stützen Sie Ihre Antwort ausschließlich auf die Zahlen aus dem Ausführungsergebnis (nicht im Kopf rechnen und nicht schätzen).

Die CVR der aktuellen Seite (Basis-CVR) beträgt 3 %. Mit Variante B möchte ich einen relativen Uplift von 10 % nachweisen können (eine CVR von 3,3 %).
Ermitteln Sie bei einem Signifikanzniveau von 5 % (zweiseitiger Test) und einer Teststärke von 80 % Folgendes:
1. Die Ziel-CVR p2 (p2 = p1 × (1 + 10/100))
2. Die Stichprobe pro Variante n (Formel des z-Tests für zwei Anteile: n = (z_{α/2}·√(2p̄(1−p̄)) + z_β·√(p1(1−p1)+p2(1−p2)))² ÷ (p2−p1)², mit p̄ = (p1+p2)/2, aufgerundet) und die Stichprobe für A und B zusammen
3. Die nötigen Tage (aufgerundet) bei 2.000 Besuchen pro Tag (A und B zusammen)
4. Die Teststärke, wenn nur 30.000 Besuche pro Variante zur Verfügung stehen (1−β = Φ((|p2−p1|·√n − z_{α/2}·√(2p̄(1−p̄))) ÷ √(p1(1−p1)+p2(1−p2))))

Verwenden Sie statistics.NormalDist für die z-Werte und die Verteilungsfunktion und zeigen Sie die verwendeten Formeln und die Zahlen aus dem Ausführungsergebnis.
Anleitung
-
1Werte eingebenTragen Sie die Zahlen, mit denen Sie rechnen möchten, in die Eingabefelder ein
-
2BerechnenKlicken Sie auf die Schaltfläche „Berechnen“
-
3Ergebnis ansehenDas Ergebnis erscheint sofort. Auf derselben Seite finden Sie auch den Rechenweg und die Erklärung der Formel
Die Vorteile von DataChef

Kein Fachwissen nötig – einfach und intuitiv

Keine persönlichen Daten erforderlich

Die Datei wird nach dem Download automatisch gelöscht


Keine Quellenangabe nötig

Keine vorherige Genehmigung erforderlich
Verwandte Funktionen
Stichprobengröße berechnen – Stichprobenumfang und Fehlertoleranz
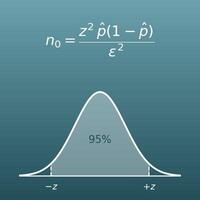
Berechnet aus Konfidenzniveau, Fehlertoleranz und Anteil, wie viele Personen eine Umfrage braucht – wenn Sie einen einzelnen Anteil genau messen wollen
p-Wert berechnen: z-Wert in p-Wert umrechnen und zurück
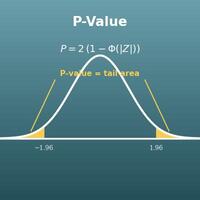
Berechnet den p-Wert aus einem z-Wert und erklärt, wann ein- und wann zweiseitig getestet wird – das Gegenstück zum Signifikanzniveau α auf dieser Seite
Conversion-Rate berechnen – CVR, nötige Besucher und erwartete Conversions
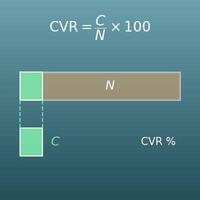
Berechnet aus zwei der Werte Besuche, Conversions und Conversion-Rate den dritten – damit ermitteln Sie die Basis-CVR für diese Seite
A/B-Test Signifikanz berechnen – Conversion-Rates vergleichen mit p-Wert und Konfidenzintervall
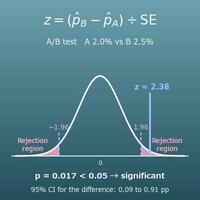
Prüft aus Besuchen und Conversions von A und B mit p-Wert und Konfidenzintervall, ob die Differenz mehr als Zufall ist – für die Auswertung nach dem Test