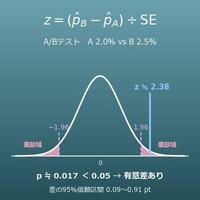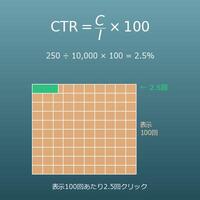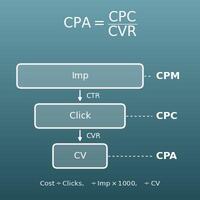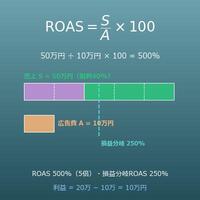
「必要サンプル数を求める」では、ベースCVR・検出したい改善幅(MDE)・有意水準・検出力を入力して「計算する」を押してください。A/Bの各群に必要なサンプル数(切り上げ)と合計を計算し、1日あたりの流入数を入れると必要日数も表示します。「検出力を求める」に切り替えると、各群のサンプル数を固定して検出力 1−β を逆算します。
このページでできること
- ベースCVR(今のA案の転換率)・検出したい改善幅(MDE。相対%か絶対ポイントで指定)・有意水準 \(\alpha\)(両側/片側)・検出力 \(1-\beta\) を入れるだけで、A/Bテストの各群に必要なサンプル数(切り上げ)と合計を計算します
- 「CVR3%のページで10%の改善(3%→3.3%)を検出するには、A・Bそれぞれ何人必要?」——テストを始める前の一番大事な疑問がこれ1つで解決します
- 1日あたりの流入数(任意)を入れると、必要な人数が集まるまでの日数(切り上げ)もわかります
- 逆に「各群にこれだけの人数しか集められない」ときは、サンプル数を固定して検出力 \(1-\beta\)(本当に差があるときにそれを見つけられる確率)を逆算できます
- 改善幅を変えると必要サンプル数がどれだけ変わるかのグラフ、式のやさしい解説・Excel/Googleスプレッドシート/Python用のコピペ数式・計算ドリル(演習問題)もこのページにまとまっています
この計算は何の役に立つ?
商品ページのCVRが2%のネットショップで、ボタンの文言を変えて相対10%の改善(2%→2.2%)を検出したいとします。有意水準5%(両側)・検出力80%なら、各群に約80,682人、合計約161,364人の訪問が必要です。
「先週はB案の方が良かった」という数十人・数百人の比較では、偶然の差と本当の差を区別できません。始める前に人数を計算しておくことで、「結果が出ない実験」に何週間も費やすのを防げます。
資料請求のCVRが5%のランディングページで、1ポイントの改善(5%→6%)を検出するには各群8,158人、合計16,316人が必要です。1日300人の訪問なら \(16316 \div 300 \fallingdotseq 54.4\) で55日、曜日のかたよりをそろえるなら8週間が目安になります。
「2週間で結果を出したい」という要望に対して、この計算があれば「2週間(4,200人=各群2,100人)では、改善幅を3ポイント(5%→8%。各群1,059人)程度まで大きく取り直す必要がある」と数字で説明できます。
開封率20%のメールマガジンで、件名を変えて2ポイントの改善(20%→22%)を検出したいなら、各群6,510人、合計13,020人に配信する必要があります(有意水準5%・検出力80%)。
開封率のように率が大きい指標は、CVRが数%の指標よりも少ない人数で差を検出できます。式の \(p(1-p)\) の部分が違うためで、同じ「2ポイント」でも指標によって必要人数が変わることがわかります。
CVR3%のページで相対10%の改善を狙ったテストを各群5,000人で行い、「有意差なし」だったとします。検出力を逆算すると約13.5%しかなく、本当に改善していても8割以上の確率で見逃す設計だったことがわかります。
この場合の正しい結論は「効果がなかった」ではなく「この人数では判断できなかった」です。検出力の逆算は、テスト結果を読み違えて良い案を捨ててしまうことを防ぎます。
翌日継続率が40%のアプリで、チュートリアルを変えて相対10%の改善(40%→44%)を検出したい場合、各群約2,389人、合計約4,778人の新規ユーザーで足ります(有意水準5%・検出力80%)。
継続率のように50%に近い指標はばらつきが大きい分、率の差(4ポイント)も大きいので、CVRが数%のテストより短期間で結果が出ます。指標ごとに必要人数を見積もっておくと、どの改善から手を付けるかの優先順位も決めやすくなります。
価格表示の変更のように「良い案を見逃すと損失が大きい」テストでは、検出力を80%から90%に上げる設計が考えられます。CVR3%・相対10%の改善では、各群の必要人数が53,211人から71,233人に増えます(約1.34倍)。
「何人増やせば見逃しを半分(20%→10%)に減らせるか」がこの計算で具体的にわかるので、テストの重要度に応じて人数と期間を配分できます。
式と図
用語・記号の解説
記号
| \(p_1\) | ピーワン | ベースCVR(A案・現状のコンバージョン率)。\(p\) は proportion(割合)または probability(確率)の頭文字で、式の中では 3% を 0.03 のように小数で扱います。 |
| \(p_2\) | ピーツー | 改善後のCVR(B案に期待するコンバージョン率)。相対%なら \(p_1 (1 + r/100)\)、絶対ポイントなら \(p_1 + d\) です。 |
| \(\bar{p}\) | ピーバー ピーの平均 | 2つのCVRの平均 \((p_1 + p_2) \div 2\) のことです。「差がない」と仮定したときの共通のCVRで、上の横線(バー)は統計で「平均」を表す印です。 |
| \(r\) | アール | 相対%で指定した改善幅(MDE)。ratio(比率)の頭文字で、「ベースCVRの何%改善か」を表します(3%→3.3%なら \(r = 10\))。 |
| \(d\) | ディー | 絶対ポイントで指定した改善幅(MDE)。difference(差)の頭文字で、CVRの差そのものです(3%→3.3%なら \(d = 0.3\) ポイント)。 |
| \(p_2 - p_1\) | ピーツー ひく ピーワン | 検出したい差(絶対ポイントを小数にしたもの。0.3ポイントなら 0.003)。必要サンプル数はこの2乗で割るので、差が小さいほど人数が急に増えます。 |
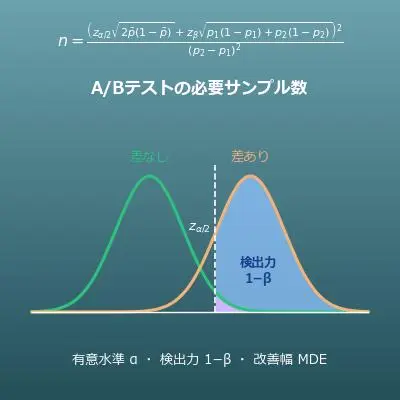
| \(\alpha\) | アルファ | 有意水準。「本当は差がないのに差ありと判定してしまう」確率(第1種の過誤の確率)で、5%(0.05)がよく使われます。ギリシャ文字の1番目で、統計では「1つ目の誤り」の確率に使う慣例です。 |
| \(\beta\) | ベータ | 「本当は差があるのに差なしと判定してしまう(見逃す)」確率(第2種の過誤の確率)。ギリシャ文字の2番目で、「2つ目の誤り」の確率に使う慣例です。 |
| \(1-\beta\) | イチ ひく ベータ | 検出力。本当に差があるときに、それを差ありと判定できる確率です。80%や90%がよく使われます。 |
| \(z_{\alpha/2}\) | ゼット アルファ にぶんのいち ゼット アルファ ハーフ | 両側検定で有意水準 \(\alpha\) に対応する \(z\) 値(標準正規分布の上側 \(\alpha/2\) の点)。5%なら1.9600、1%なら2.5758、10%なら1.6449です。片側検定では \(z_{\alpha}\)(5%なら1.6449)を使います。 |
| \(z_{\beta}\) | ゼット ベータ | 検出力 \(1-\beta\) に対応する \(z\) 値(標準正規分布で下側の確率が \(1-\beta\) になる点)。80%なら0.8416、90%なら1.2816です。 |
| \(z_{1-\beta}\) | ゼット イチ ひく ベータ | 検出力を求める式で、サンプル数から逆算した \(z\) 値。これを \(\Phi\) に入れると検出力になります(\(z_{\beta}\) と同じものを、求める側から見た書き方です)。 |
| \(\Phi\) | ファイ | 標準正規分布の累積分布関数。「\(z\) 値がその値以下になる確率」を返す関数で、\(\Phi(1.96) \fallingdotseq 0.975\)、\(\Phi(0.8416) \fallingdotseq 0.80\) です。ギリシャ文字の大文字ファイで、正規分布の分布関数に使う慣例です。 |
| \(n\) | エヌ | 各群(A案・B案それぞれ)のサンプル数。number(数)の頭文字です。A・B合計は \(2n\) になります。 |
| \(\sqrt{\ \ }\) | ルート | 平方根。2乗するとその数になる正の数で、\(\sqrt{30000} \fallingdotseq 173.205\) です。CVRのばらつき(標準偏差)を求めるときに出てきます。 |
| \(V\) | ブイ | 1日あたりの流入数(テスト対象ページ全体の訪問数=A・B合計)。visits(訪問数)の頭文字です。 |
| \(D\) | ディー | 必要な日数。days(日数)の頭文字です。 |
| \(\lceil\ \rceil\) | てんじょうかんすう | 切り上げを表す記号(天井関数)。中の数以上で最小の整数を返します(\(\lceil 53.211 \rceil = 54\))。 |
用語
| A/Bテスト | エービーテスト | 今の案(A)と新しい案(B)を、訪問者をランダムに分けて同じ期間に見せ、どちらの成果(CVRなど)が高いかを比べる実験。ボタンの色・見出し・価格表示・ランディングページの構成などの改善効果を、思い込みではなくデータで確かめるために使われます。 |
| コンバージョン率 (CVR) |
コンバージョンりつ | 訪問者やクリックのうち、購入・申込などの成果(コンバージョン)に至った割合。Conversion Rate の略で、このページの式ではA案を \(p_1\)、B案を \(p_2\) と書きます。 |
| MDE (最小検出可能効果) |
エムディーイー(さいしょうけんしゅつかのうこうか) | Minimum Detectable Effect。「このくらいの改善なら見つけたい」という改善幅の下限で、A/Bテストの設計で最初に決める値です。小さくするほど必要サンプル数が急に増える(差の2乗に反比例)ため、「事業として意味のある最小の改善」を選ぶのがコツです。 |
| 有意水準 | ゆういすいじゅん | 「本当は差がないのに、偶然の差を見て差ありと判定してしまう」失敗をどこまで許すかの確率 \(\alpha\) のことです。5%が一般的で、「20回に1回は勘違いを許す」という意味です。厳しくする(1%)と必要サンプル数が増えます。 |
| 検出力 | けんしゅつりょく | 「本当に差があるときに、それを差ありと判定できる」確率 \(1-\beta\) のことです。80%が一般的で、「本当の改善を5回に1回は見逃す」ことを許した水準です。検出力が低いテストで「差なし」と出ても、それは「差がない証拠」にはなりません。 |
| 第1種の過誤 | だいいっしゅのかご | 「本当は差がないのに、差ありと言ってしまう」誤り。この誤りを許す確率が有意水準 \(\alpha\) です。第2種の過誤(見逃し)と裏表の関係にあり、片方を減らそうとするともう片方が増えます。両方を小さくする最も基本的な方法がサンプル数を増やすことです。 |
| 第2種の過誤 | だいにしゅのかご | 「本当は差があるのに、見逃してしまう」誤り。この誤りの確率が \(\beta\) で、\(1-\beta\) が検出力です。第1種の過誤(差がないのに差ありと言う)と裏表の関係にあり、片方を減らそうとするともう片方が増えます。両方を小さくする最も基本的な方法がサンプル数を増やすことです。 |
| 帰無仮説 | きむかせつ | 「A案とB案のCVRに差はない」という、検定で否定したい側の仮説。検定は、帰無仮説が正しいとしたら今のデータはどれくらい珍しいかを調べ、十分珍しければ帰無仮説を捨てて「差あり」と判定します。 |
| 対立仮説 | たいりつかせつ | 「A案とB案のCVRに差がある」という、検定で示したい側の仮説。帰無仮説(差はない)が捨てられたときに採用されます。 |
| 両側検定 | りょうがわけんてい | 「B案が高い」「低い」の両方を差として検出する検定。どちらに転ぶかわからない普通のA/Bテストで使います。片側検定より必要サンプル数は多くなりますが、B案の悪化も検出できます。 |
| 片側検定 | かたがわけんてい | 「B案が高い」だけを検出する検定。両側検定より必要サンプル数は少なくなりますが、B案が悪化していても検出できないので、テストを始める前に決めておく必要があります(結果を見てから片側に変えるのは不適切です)。 |
| 2標本比率の差の検定 (z検定) |
にひょうほんひりつのさのけんてい(ゼットけんてい) | 2つのグループの割合(CVRなど)に差があるかを、差を標準化した \(z\) 値と標準正規分布で判定する検定。このページの式はこの検定で必要サンプル数を求めるもので、各群のCV数が少なすぎない(目安として5〜10件以上)ときに正規分布で近似できます。 |
| 標準正規分布 | ひょうじゅんせいきぶんぷ | 平均0・標準偏差1の正規分布(左右対称のベル型)。\(z\) 値はこの分布の横軸の値で、「1.96より右の面積が2.5%」のように確率と1対1で対応します。 |
| 累積分布関数 | るいせきぶんぷかんすう | 「ある値以下になる確率」を返す関数。標準正規分布のものを \(\Phi\) と書き、検出力を求める式の最後に出てきます。Excelでは NORM.S.DIST(第2引数 TRUE)、Pythonでは NormalDist().cdf で計算できます。 |
| 標準偏差 (ばらつき) |
ひょうじゅんへんさ | データの散らばりの大きさ。割合 \(p\) のばらつきは \(\sqrt{p(1-p)}\) に比例し、式に出てくる \(\sqrt{2\bar{p}(1-\bar{p})}\) と \(\sqrt{p_1(1-p_1)+p_2(1-p_2)}\) は「2群のCVRの差のばらつき」です。 |
| 多重比較 | たじゅうひかく | 複数のB案や複数の指標を同時に比べること。比較の回数が増えるほど「どれか1つは偶然有意になる」確率が上がるため、有意水準を回数で割る(ボンフェローニ補正)などの調整が必要です。 |
| のぞき見 (早期停止) |
のぞきみ(そうきていし) | 必要サンプル数が集まる前に何度も結果を見て、有意差が出た瞬間にテストをやめること。偶然の差を拾いやすくなり、有意水準5%のつもりが実際にはずっと高い確率で誤判定になります。必要サンプル数を先に決め、集まるまで待つのがこのページの式の前提です。 |
前提として理解しておくといいこと
このページの計算を「意味がわかって」使えるようになるために、前提として理解しておくといいことをまとめました。
つまずいたら、この表の内容に戻って復習するのが近道です。
| 割合・百分率(小学5年) |
|
| 平方根(中学3年) |
|
| 確率の基本(中学2年〜高校 数学A) |
|
| 正規分布と標準化(高校 数学B) |
|
| 仮説検定の考え方(高校 数学B〜大学初級) |
|
| 切り上げ(小学4年) |
|
Excelで計算する方法
| ベースCVR p1(%) | 3 |
| 相対改善幅 r(%) | 10 |
| 改善後のCVR p2(%) | =B1*(1+B2/100) |
| ベースCVR p1(%) | 3 |
| 改善後のCVR p2(%) | 3.3 |
| 有意水準 α(%・両側) | 5 |
| 検出力 1−β(%) | 80 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| z_β | =NORM.S.INV(B4/100) |
| 平均のCVR p̄ | =(B1+B2)/2/100 |
| 各群の必要サンプル数 n(切り上げ) | =ROUNDUP((B5*SQRT(2*B7*(1-B7))+B6*SQRT(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2,0) |
| 各群の必要サンプル数 n | 53211 |
| 1日あたりの流入数 V(両群合計) | 2000 |
| 必要な日数 D(切り上げ) | =ROUNDUP(2*B1/B2,0) |
| ベースCVR p1(%) | 3 |
| 改善後のCVR p2(%) | 3.3 |
| 有意水準 α(%・両側) | 5 |
| 各群のサンプル数 n | 30000 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| 平均のCVR p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ABS(B2-B1)/100*SQRT(B4)-B5*SQRT(2*B6*(1-B6)))/SQRT(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| 検出力 1−β(%) | =NORM.S.DIST(B7,TRUE)*100 |
1つ目の表はB3に3.3(改善後のCVR 3.3%)、2つ目の表はB8に53211(各群の必要サンプル数)、3つ目の表はB3に54(必要な日数)、4つ目の表はB8に約55.71(検出力55.71%)と表示されます。
NORM.S.INV は「確率→z値」、NORM.S.DIST(第2引数 TRUE)は「z値→確率」の関数です。片側検定にしたいときは、z_α/2 の式の「/2」を消して =NORM.S.INV(1-B3/100) にしてください。ROUNDUP(…,0) が切り上げです。
Googleスプレッドシートで計算する方法
| ベースCVR p1(%) | 3 |
| 相対改善幅 r(%) | 10 |
| 改善後のCVR p2(%) | =B1*(1+B2/100) |
| ベースCVR p1(%) | 3 |
| 改善後のCVR p2(%) | 3.3 |
| 有意水準 α(%・両側) | 5 |
| 検出力 1−β(%) | 80 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| z_β | =NORM.S.INV(B4/100) |
| 平均のCVR p̄ | =(B1+B2)/2/100 |
| 各群の必要サンプル数 n(切り上げ) | =ROUNDUP((B5*SQRT(2*B7*(1-B7))+B6*SQRT(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2,0) |
| 各群の必要サンプル数 n | 53211 |
| 1日あたりの流入数 V(両群合計) | 2000 |
| 必要な日数 D(切り上げ) | =ROUNDUP(2*B1/B2,0) |
| ベースCVR p1(%) | 3 |
| 改善後のCVR p2(%) | 3.3 |
| 有意水準 α(%・両側) | 5 |
| 各群のサンプル数 n | 30000 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| 平均のCVR p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ABS(B2-B1)/100*SQRT(B4)-B5*SQRT(2*B6*(1-B6)))/SQRT(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| 検出力 1−β(%) | =NORM.S.DIST(B7,TRUE)*100 |
Pythonで計算する方法
from math import sqrt, ceil
from statistics import NormalDist

base_cvr = 3.0          # ベースCVR(%)
relative_mde = 10.0     # 検出したい改善幅(相対%)
alpha = 0.05            # 有意水準(両側)
power = 0.80            # 検出力
daily_visits = 2000     # 1日あたりの流入数(両群合計)

p1 = base_cvr / 100
p2 = p1 * (1 + relative_mde / 100)          # 改善後のCVR
z_alpha = NormalDist().inv_cdf(1 - alpha / 2)  # 片側検定なら 1 - alpha
z_beta = NormalDist().inv_cdf(power)
p_bar = (p1 + p2) / 2

n_exact = (z_alpha * sqrt(2 * p_bar * (1 - p_bar))
           + z_beta * sqrt(p1 * (1 - p1) + p2 * (1 - p2))) ** 2 / (p2 - p1) ** 2
n_per_group = ceil(n_exact)                  # 各群の必要サンプル数(切り上げ)
days = ceil(2 * n_per_group / daily_visits)  # 必要な日数

print(f"改善後のCVR: {p2 * 100:.4g}%")
print(f"各群の必要サンプル数: {n_per_group}(合計 {2 * n_per_group})")
print(f"必要な日数: {days}日")

# 逆問題:各群30000人のときの検出力
n_fixed = 30000
z_power = (abs(p2 - p1) * sqrt(n_fixed) - z_alpha * sqrt(2 * p_bar * (1 - p_bar))) \
          / sqrt(p1 * (1 - p1) + p2 * (1 - p2))
print(f"各群{n_fixed}人のときの検出力: {NormalDist().cdf(z_power) * 100:.2f}%")
数式記述言語(LaTeX等)での書き方(コピペ可)
p₂ = p₁ × (1 + r/100)
p_2 = p_1 \left(1 + \dfrac{r}{100}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mi>p</mi><mn>2</mn></msub>
    <mo>=</mo>
    <msub><mi>p</mi><mn>1</mn></msub>
    <mo>(</mo><mn>1</mn><mo>+</mo><mfrac><mi>r</mi><mn>100</mn></mfrac><mo>)</mo>
  </mrow>
</math>
p_2 = p_1 (1 + r/100)
p1*(1 + r/100)
p2 := p1*(1 + r/100);
p2 = p1*(1 + r/100);
p_2 = p_1 (1 + r/100)
n = (z_α/2 √(2p̄(1 − p̄)) + z_β √(p₁(1 − p₁) + p₂(1 − p₂)))² ÷ (p₂ − p₁)²
n = \dfrac{\left( z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})} + z_{\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2 - p_1)^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msup>
<mrow>
<mo>(</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
<mo>+</mo>
<msub><mi>z</mi><mi>β</mi></msub>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
<mo>)</mo>
</mrow>
<mn>2</mn>
</msup>
<msup>
<mrow><mo>(</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mfrac>
</mrow>
</math>
n = (z_(alpha/2) sqrt(2 bar p (1 - bar p)) + z_beta sqrt(p_1(1 - p_1) + p_2(1 - p_2)))^2 / (p_2 - p_1)^2
Ceiling[(za*Sqrt[2*pbar*(1 - pbar)] + zb*Sqrt[p1*(1 - p1) + p2*(1 - p2)])^2/(p2 - p1)^2]
n := ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = (z_(α/2) √(2p̄(1 − p̄)) + z_β √(p_1(1 − p_1) + p_2(1 − p_2)))^2/(p_2 − p_1)^2
D = ⌈2n ÷ V⌉
D = \left\lceil \dfrac{2n}{V} \right\rceil
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>D</mi>
<mo>=</mo>
<mo>⌈</mo>
<mfrac><mrow><mn>2</mn><mi>n</mi></mrow><mi>V</mi></mfrac>
<mo>⌉</mo>
</mrow>
</math>
D = |~ (2n)/V ~|
Ceiling[2*n/v]
days := ceil(2*n/V);
D = ceil(2*n/V);
D = ⌈2n/V⌉
1 − β = Φ((|p₂ − p₁|√n − z_α/2 √(2p̄(1 − p̄))) ÷ √(p₁(1 − p₁) + p₂(1 − p₂)))
1 - \beta = \Phi\left( \dfrac{|p_2 - p_1|\sqrt{n} - z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})}}{\sqrt{p_1(1-p_1)+p_2(1-p_2)}} \right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mn>1</mn><mo>−</mo><mi>β</mi>
<mo>=</mo>
<mi>Φ</mi>
<mo>(</mo>
<mfrac>
<mrow>
<mo>|</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>|</mo>
<msqrt><mi>n</mi></msqrt>
<mo>−</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
</mrow>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
</mfrac>
<mo>)</mo>
</mrow>
</math>
1 - beta = Phi((|p_2 - p_1| sqrt(n) - z_(alpha/2) sqrt(2 bar p (1 - bar p))) / sqrt(p_1(1 - p_1) + p_2(1 - p_2)))
CDF[NormalDistribution[0, 1], (Abs[p2 - p1]*Sqrt[n] - za*Sqrt[2*pbar*(1 - pbar)])/Sqrt[p1*(1 - p1) + p2*(1 - p2)]]
power := Statistics[CDF](Normal(0, 1), (abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
power = normcdf((abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
1 − β = Φ((|p_2 − p_1| √n − z_(α/2) √(2p̄(1 − p̄)))/√(p_1(1 − p_1) + p_2(1 − p_2)))
ChatGPT に聞いて計算してもらう方法
あなたはA/Bテスト設計のアシスタントです。次の計算を、必ずPythonコードを実際に実行して行い、実行結果の数値だけを根拠に回答してください(暗算や推測で答えないでください)。

現在のページのCVR(ベースCVR)は3%です。B案で相対10%の改善(CVR 3.3%)があれば検出したいと考えています。
有意水準5%(両側検定)、検出力80%として、次の値をそれぞれ求めてください。
1. 改善後のCVR p2(p2 = p1 × (1 + 10/100))
2. 各群の必要サンプル数 n(2標本比率の差の検定の式:n = (z_{α/2}·√(2p̄(1−p̄)) + z_β·√(p1(1−p1)+p2(1−p2)))² ÷ (p2−p1)²、p̄ = (p1+p2)/2、端数は切り上げ)と、A・B合計のサンプル数
3. 1日あたりの流入数が2000(両群合計)のときの必要な日数(切り上げ)
4. 各群30000人しか集められない場合の検出力(1−β = Φ((|p2−p1|·√n − z_{α/2}·√(2p̄(1−p̄))) ÷ √(p1(1−p1)+p2(1−p2))))

z値と累積分布関数には statistics.NormalDist を使い、計算に使った式と実行結果の数値を示してください。
計算ドリル(演習問題)
このページの式を、自分の手で計算できるようになるための演習問題です。
答えと解説は解答ページにあります。
使い方
-
1数値を入力計算したい数値を入力欄に入力します
-
2計算「計算する」ボタンを押します
-
3結果を確認計算結果がその場に表示されます。計算の考え方や式の解説も同じページで確認できます
DataChefの特徴

専門知識不要、直感的で簡単な操作
個人情報を登録することなく使用できます
「ダウンロード」押下でファイルを自動削除
クレジット表記不要
商用利用許諾の連絡も不要です
関連機能
サンプルサイズ計算機(アンケート・調査)
信頼水準・許容誤差・母比率から、アンケートや調査に必要な人数を計算します。「1つの割合を精度よく知りたい」ときはこちらです
P値計算機(有意確率)
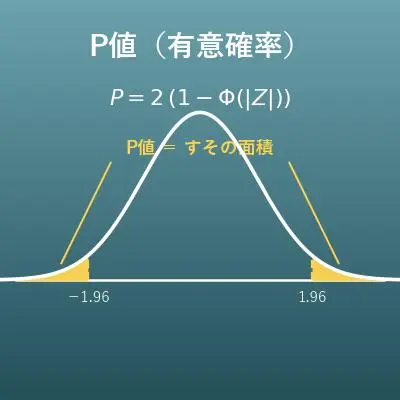
Z値からP値を計算し、両側・片側検定の使い分けを解説します。このページの有意水準 α と対になる考え方です
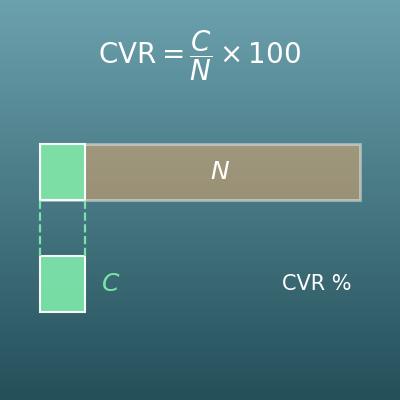
コンバージョン率(CVR)の計算と逆算
流入数・CV数・CVRのうち2つから残りを計算します。このページに入れる「ベースCVR」を出すときに使えます