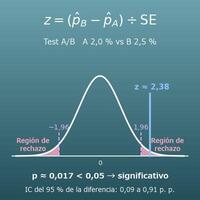

Para calcular la muestra, introduce la CVR de partida, el MDE, el nivel de significación y la potencia, y pulsa «Calcular». Obtienes la muestra por grupo para A y B (redondeada hacia arriba) y el total, y también los días necesarios si introduces las visitas diarias. Cambia «Qué calcular» a potencia para fijar la muestra por grupo y obtener en su lugar la potencia 1 − β.
Índice
-
Qué puedes hacer en esta página
-
¿Para qué sirve este cálculo?
-
Cómo usar
-
Fórmulas y figuras
-
Símbolos y términos
-
Conviene saber antes de empezar
-
Cómo calcularlo en Excel
-
Cómo calcularlo en Hojas de cálculo de Google
-
Cómo calcularlo en Python
-
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
-
Cómo pedirle el cálculo a ChatGPT
-
Las ventajas de DataChef
-
Funciones relacionadas
-
Lista de calculadoras de NumberChef
Qué puedes hacer en esta página
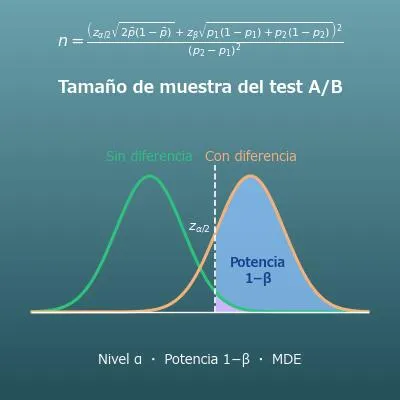
- Con solo introducir la CVR de partida (la tasa de conversión de tu versión A actual), el efecto mínimo detectable (MDE, en % relativo o en puntos porcentuales), el nivel de significación \(\alpha\) (bilateral o unilateral) y la potencia \(1-\beta\), calcula el tamaño de muestra que necesita cada grupo de tu test A/B (redondeado hacia arriba) y el total
- «Mi página convierte al 3 %. ¿Cuántas visitas necesitan A y B para detectar una mejora del 10 % (del 3 % al 3,3 %)?». Esta página responde a la pregunta más importante antes de empezar un test
- Si introduces las visitas diarias (opcional), también verás cuántos días tardas en reunir esa muestra (redondeado hacia arriba)
- Si solo puedes conseguir un número fijo de visitas por grupo, fija la muestra y calcula al revés la potencia \(1-\beta\) (la probabilidad de encontrar una diferencia cuando existe de verdad)
- En esta página tienes además una gráfica de cómo cambia la muestra según el MDE, una explicación sencilla de las fórmulas y fórmulas para copiar y pegar en Excel, Hojas de cálculo de Google y Python
¿Para qué sirve este cálculo?
Supongamos que la página de producto de una tienda online convierte al 2 % y quieres detectar una mejora relativa del 10 % (del 2 % al 2,2 %) con un nuevo texto en el botón. Con un nivel de significación del 5 % (bilateral) y una potencia del 80 %, necesitas unas 80.682 visitas por grupo, unas 161.364 en total.
Comparar unas decenas o unos cientos de visitas («la semana pasada B fue mejor») no permite distinguir una diferencia casual de una real. Calcular la muestra antes de empezar evita pasarte semanas con un test que no puede dar una respuesta.
Una landing page consigue solicitudes de demo con una CVR del 5 %. Para detectar una mejora de 1 punto (del 5 % al 6 %), necesitas 8158 visitas por grupo, 16.316 en total. Con 300 visitas al día son \(16316 \div 300 \approx 54{,}4\), es decir, 55 días, u 8 semanas si quieres igualar los días de la semana.
Si alguien te pide resultados en 2 semanas, este cálculo te permite explicarlo con números: «En 2 semanas (4200 visitas, 2100 por grupo) necesitaríamos un MDE mucho mayor, de unos 3 puntos (del 5 % al 8 %, que necesita 1059 por grupo)».
Si tu newsletter tiene una tasa de apertura del 20 % y quieres detectar una mejora de 2 puntos (del 20 % al 22 %) con un asunto nuevo, necesitas enviarla a 6510 personas por grupo, 13.020 en total (nivel de significación del 5 %, potencia del 80 %).
Una métrica con una tasa alta, como la de apertura, necesita menos personas para mostrar una diferencia que una CVR de pocos puntos. Se debe a que la parte \(p(1-p)\) de la fórmula es distinta: los mismos «2 puntos» necesitan una muestra distinta según la métrica.
Supongamos que un test que buscaba una mejora relativa del 10 % en una página con una CVR del 3 % se hizo con 5000 visitas por grupo y mostró «ninguna diferencia significativa». Si calculas al revés la potencia, sale solo de un 13,5 % aproximadamente. El test estaba montado para dejar escapar una mejora real más de 8 veces de cada 10.
La conclusión correcta aquí no es «no ha servido de nada», sino «con esta muestra no se podía saber». Calcular la potencia al revés evita malinterpretar un test y tirar a la basura una buena idea.
Una app tiene una retención al día siguiente del 40 %. Para detectar una mejora relativa del 10 % (del 40 % al 44 %) con un nuevo tutorial, bastan unos 2389 usuarios nuevos por grupo, unos 4778 en total (nivel de significación del 5 %, potencia del 80 %).
Una métrica cercana al 50 %, como la retención, tiene mucha dispersión, pero la diferencia de tasas (4 puntos) también es grande, así que los resultados llegan antes que en un test sobre una CVR de pocos puntos. Estimar la muestra de cada métrica también te ayuda a decidir qué mejora abordar primero.
En un test en el que dejar escapar una buena idea saldría caro, como un cambio en la forma de mostrar los precios, puedes subir la potencia del 80 % al 90 %. Con una CVR del 3 % y una mejora relativa del 10 %, la muestra por grupo pasa de 53.211 a 71.233 (unas 1,34 veces).
Este cálculo muestra exactamente cuántas visitas más hacen falta para reducir a la mitad lo que se te escapa (del 20 % al 10 %), así que puedes ajustar la muestra y la duración del test a lo importante que sea.
Fórmulas y figuras
Símbolos y términos
Símbolos
| \(p_1\) | p subíndice 1 | La CVR de partida (la tasa de conversión de la versión A actual). \(p\) viene de «proporción» o «probabilidad». En las fórmulas, el 3 % se escribe como el decimal 0,03. |
| \(p_2\) | p subíndice 2 | La CVR objetivo (la tasa de conversión que esperas que alcance la versión B). Es \(p_1 (1 + r/100)\) en % relativo y \(p_1 + d\) en puntos porcentuales. |
| \(\bar{p}\) | p barra | La media de las dos CVR, \((p_1 + p_2) \div 2\). Es la CVR común que se supone cuando no hay diferencia. En estadística, la barra de arriba indica una media. |
| \(r\) | erre | El MDE dado en % relativo. Viene de «ratio» e indica en qué porcentaje mejora la CVR de partida (del 3 % al 3,3 %, \(r = 10\)). |
| \(d\) | de | El MDE dado en puntos porcentuales. Viene de «diferencia» y es la diferencia de CVR tal cual (del 3 % al 3,3 %, \(d = 0{,}3\) puntos). |
| \(p_2 - p_1\) | p subíndice 2 menos p subíndice 1 | La diferencia que detectar, en puntos porcentuales escritos como decimal (0,3 puntos son 0,003). La muestra se divide entre su cuadrado, así que cuanto menor es la diferencia, más rápido crece la muestra. |
| \(\alpha\) | alfa | El nivel de significación: la probabilidad de dar por real una diferencia que no existe (la probabilidad de un error de tipo I). Lo habitual es un 5 % (0,05). Alfa es la primera letra griega, y en estadística se usa para la probabilidad del «primer» tipo de error. |
| \(\beta\) | beta | La probabilidad de no ver una diferencia que sí existe (la probabilidad de un error de tipo II). Beta es la segunda letra griega y se usa para la probabilidad del «segundo» tipo de error. |
| \(1-\beta\) | uno menos beta | La potencia: la probabilidad de encontrar una diferencia cuando existe de verdad. Lo habitual es un 80 % o un 90 %. |
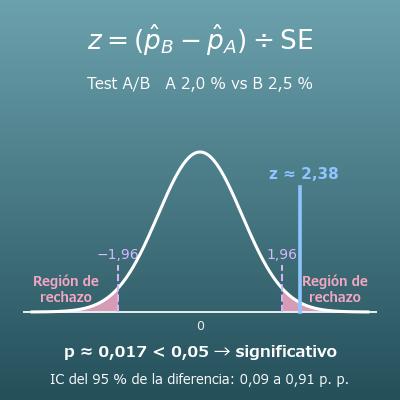
| \(z_{\alpha/2}\) | zeta subíndice alfa medios | El valor z del nivel de significación \(\alpha\) en un contraste bilateral (el punto que deja por encima \(\alpha/2\) de la distribución normal estándar). Es 1,9600 al 5 %, 2,5758 al 1 % y 1,6449 al 10 %. Un contraste unilateral usa \(z_{\alpha}\) (1,6449 al 5 %). |
| \(z_{\beta}\) | zeta subíndice beta | El valor z de la potencia \(1-\beta\) (el punto que deja por debajo una probabilidad \(1-\beta\) de la distribución normal estándar). Es 0,8416 al 80 % y 1,2816 al 90 %. |
| \(z_{1-\beta}\) | zeta subíndice uno menos beta | En la fórmula de la potencia, el valor z obtenido al revés a partir de la muestra. Si lo metes en \(\Phi\), obtienes la potencia. (Es lo mismo que \(z_{\beta}\), escrito desde el lado del valor que se calcula). |
| \(\Phi\) | fi mayúscula | La función de distribución de la distribución normal estándar. Devuelve la probabilidad de que un valor z sea igual o menor que un valor dado: \(\Phi(1{,}96) \approx 0{,}975\) y \(\Phi(0{,}8416) \approx 0{,}80\). La letra griega fi mayúscula es el símbolo habitual de esta función. |
| \(n\) | ene | La muestra por grupo (para cada una de las versiones A y B). Viene de «número». El total de A y B es \(2n\). |
| \(\sqrt{\ \ }\) | raíz cuadrada | La raíz cuadrada: el número positivo que, elevado al cuadrado, da el número de dentro; por ejemplo, \(\sqrt{30000} \approx 173{,}205\). Aparece al calcular la dispersión (desviación típica) de una CVR. |
| \(V\) | uve | Las visitas diarias (todas las visitas de la página que se prueba, A y B juntos). Viene de «visitas». |
| \(D\) | de | Los días necesarios. Viene de «días». |
| \(\lceil\ \rceil\) | función techo | El símbolo de redondear hacia arriba (la función techo). Da el menor número entero mayor o igual que el número de dentro (\(\lceil 53{,}211 \rceil = 54\)). |
Términos
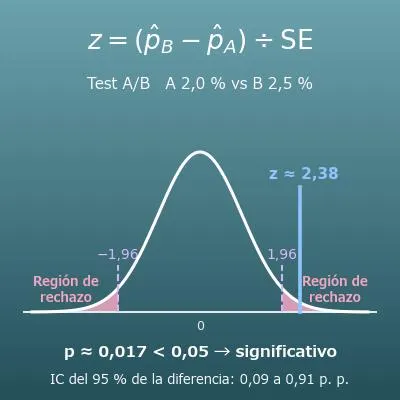
| test A/B | Experimento que reparte al azar a los visitantes entre la versión actual (A) y una nueva (B) durante el mismo periodo, para ver cuál funciona mejor (por ejemplo, cuál tiene mayor CVR). Sirve para comprobar con datos, y no por intuición, si un cambio como el color de un botón, un titular, la forma de mostrar un precio o el diseño de una landing page ayuda de verdad. |
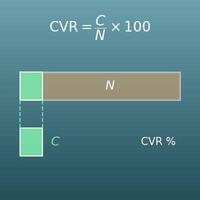
| CVR (tasa de conversión) | La proporción de visitantes o clics que terminan en una acción objetivo (una conversión), como una compra o un alta. Son las siglas del inglés conversion rate. En las fórmulas de esta página, la CVR de la versión A es \(p_1\) y la de la B, \(p_2\). |
| MDE (efecto mínimo detectable) | La mejora más pequeña que quieres poder detectar (en inglés, minimum detectable effect). Es lo primero que hay que decidir al planificar un test A/B. Cuanto más pequeño, más rápido crece la muestra (es inversamente proporcional al cuadrado de la diferencia), así que elige la mejora más pequeña que de verdad importe para tu negocio. |
| nivel de significación | La probabilidad \(\alpha\) del error que estás dispuesto a aceptar: ver una diferencia casual y darla por real cuando no hay diferencia. Lo habitual es un 5 %, que permite una falsa alarma más o menos 1 vez de cada 20. Un nivel más exigente (1 %) necesita una muestra mayor. |
| potencia estadística | La probabilidad \(1-\beta\) de encontrar una diferencia cuando existe de verdad (también, potencia del contraste). Lo habitual es un 80 %, que acepta que se escape una mejora real más o menos 1 vez de cada 5. Si un test de poca potencia dice «no hay diferencia», eso no demuestra que no la haya. |
| error de tipo I | El error de dar por real una diferencia que no existe (un falso positivo). La probabilidad que admites para él es el nivel de significación \(\alpha\). Es la otra cara del error de tipo II (no ver una diferencia): si bajas uno, el otro tiende a subir. La forma más básica de reducir los dos es una muestra mayor. |
| error de tipo II | El error de no ver una diferencia que sí existe (un falso negativo). Su probabilidad es \(\beta\), y \(1-\beta\) es la potencia. Es la otra cara del error de tipo I (una falsa alarma): si bajas uno, el otro tiende a subir. La forma más básica de reducir los dos es una muestra mayor. |
| hipótesis nula | La hipótesis «las versiones A y B tienen la misma CVR» que el contraste intenta rechazar. El contraste se pregunta lo raros que serían los datos si la hipótesis nula fuera cierta. Si son lo bastante raros, se rechaza y el resultado es «hay diferencia». |
| hipótesis alternativa | La hipótesis «las versiones A y B tienen distinta CVR» que el contraste intenta demostrar. Se acepta cuando se rechaza la hipótesis nula (no hay diferencia). |
| contraste bilateral | Contraste que cuenta como diferencia tanto «B es mayor» como «B es menor». Es el de un test A/B normal, en el que no sabes hacia dónde irá. Necesita una muestra mayor que un contraste unilateral, pero también detecta que B empeore. |
| contraste unilateral | Contraste que solo busca «B es mayor». Necesita una muestra menor que un contraste bilateral, pero no detecta que B empeore, así que hay que elegirlo antes de empezar el test. (Pasar a unilateral después de ver los resultados no es válido). |
| contraste z de dos proporciones | Contraste que comprueba si dos grupos tienen distinta proporción (por ejemplo, distinta CVR) usando un valor z (la diferencia tipificada) y la distribución normal estándar. Las fórmulas de esta página calculan la muestra para este contraste. La aproximación normal funciona cuando cada grupo tiene suficientes conversiones (como regla práctica, al menos de 5 a 10). |
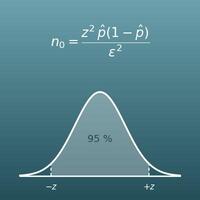
| distribución normal estándar | La distribución normal de media 0 y desviación típica 1 (una campana simétrica). Un valor z es un punto de su eje horizontal, y cada valor z corresponde a una probabilidad, como en «el área a la derecha de 1,96 es un 2,5 %». |
| función de distribución | Función que devuelve la probabilidad de obtener un valor dado o menos. La de la distribución normal estándar se escribe \(\Phi\) y aparece al final de la fórmula de la potencia. En Excel es DISTR.NORM.ESTAND.N (con VERDADERO como segundo argumento), y en Python, NormalDist().cdf. |
| desviación típica | Mide lo dispersos que están los datos (su dispersión). La dispersión de una proporción \(p\) es proporcional a \(\sqrt{p(1-p)}\). Las expresiones \(\sqrt{2\bar{p}(1-\bar{p})}\) y \(\sqrt{p_1(1-p_1)+p_2(1-p_2)}\) de las fórmulas son la dispersión de la diferencia entre las CVR de los dos grupos. |
| comparaciones múltiples | Comparar a la vez varias versiones B o varias métricas. Cuantas más comparaciones, más probable es que al menos una parezca significativa por azar, así que hace falta un ajuste, como dividir el nivel de significación entre el número de comparaciones (la corrección de Bonferroni). |
| peeking | Mirar los resultados una y otra vez antes de llegar a la muestra necesaria y parar el test en cuanto parece significativo (parar antes de tiempo). Así es fácil quedarse con diferencias casuales, y un test pensado con un nivel de significación del 5 % se equivoca en realidad mucho más a menudo. Las fórmulas de esta página suponen que fijas la muestra de antemano y esperas a alcanzarla. |
Conviene saber antes de empezar
Esto es lo que te ayuda a usar el cálculo de esta página entendiendo lo que haces, no solo pulsando el botón.
Si te atascas, repasar estos temas es el camino más rápido.
| Porcentajes (5.º y 6.º de Primaria, 10-12 años) |
|
| Raíces cuadradas (1.º y 2.º de ESO, 12-14 años) |
|
| Probabilidad básica (2.º a 4.º de ESO, 13-16 años) |
|
| La distribución normal y la puntuación z (1.º y 2.º de Bachillerato, 16-18 años) |
|
| La idea del contraste de hipótesis (Bachillerato o primeros cursos de universidad, 17 años o más) |
|
| Redondear hacia arriba (4.º de Primaria, 9-10 años) |
|
Cómo calcularlo en Excel
| CVR de partida p1 (%) | 3 |
| Mejora relativa r (%) | 10 |
| CVR objetivo p2 (%) | =B1*(1+B2/100) |
| CVR de partida p1 (%) | 3 |
| CVR objetivo p2 (%) | 3,3 |
| Nivel de significación α (%, bilateral) | 5 |
| Potencia 1−β (%) | 80 |
| z_α/2 | =INV.NORM.ESTAND(1-B3/100/2) |
| z_β | =INV.NORM.ESTAND(B4/100) |
| CVR media p̄ | =(B1+B2)/2/100 |
| Muestra por grupo n (redondeada hacia arriba) | =REDONDEAR.MAS((B5*RAIZ(2*B7*(1-B7))+B6*RAIZ(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2;0) |
| Muestra por grupo n | 53211 |
| Visitas diarias V (total A + B) | 2000 |
| Días necesarios D (redondeado hacia arriba) | =REDONDEAR.MAS(2*B1/B2;0) |
| CVR de partida p1 (%) | 3 |
| CVR objetivo p2 (%) | 3,3 |
| Nivel de significación α (%, bilateral) | 5 |
| Muestra por grupo n | 30000 |
| z_α/2 | =INV.NORM.ESTAND(1-B3/100/2) |
| CVR media p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ABS(B2-B1)/100*RAIZ(B4)-B5*RAIZ(2*B6*(1-B6)))/RAIZ(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| Potencia 1−β (%) | =DISTR.NORM.ESTAND.N(B7;VERDADERO)*100 |
La primera tabla muestra 3,3 en B3 (una CVR objetivo del 3,3 %), la segunda 53211 en B8 (la muestra por grupo), la tercera 54 en B3 (los días necesarios) y la cuarta unos 55,71 en B8 (una potencia del 55,71 %).
INV.NORM.ESTAND convierte una probabilidad en un valor z, y DISTR.NORM.ESTAND.N (con VERDADERO como segundo argumento) convierte un valor z en una probabilidad. Para un contraste unilateral, borra el «/2» de la fórmula de z_α/2 para que quede =INV.NORM.ESTAND(1-B3/100). REDONDEAR.MAS(…;0) redondea hacia arriba.
Cómo calcularlo en Hojas de cálculo de Google
| CVR de partida p1 (%) | 3 |
| Mejora relativa r (%) | 10 |
| CVR objetivo p2 (%) | =B1*(1+B2/100) |
| CVR de partida p1 (%) | 3 |
| CVR objetivo p2 (%) | 3,3 |
| Nivel de significación α (%, bilateral) | 5 |
| Potencia 1−β (%) | 80 |
| z_α/2 | =DISTR.NORM.ESTAND.INV(1-B3/100/2) |
| z_β | =DISTR.NORM.ESTAND.INV(B4/100) |
| CVR media p̄ | =(B1+B2)/2/100 |
| Muestra por grupo n (redondeada hacia arriba) | =REDONDEAR.MAS((B5*RAIZ(2*B7*(1-B7))+B6*RAIZ(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2;0) |
| Muestra por grupo n | 53211 |
| Visitas diarias V (total A + B) | 2000 |
| Días necesarios D (redondeado hacia arriba) | =REDONDEAR.MAS(2*B1/B2;0) |
| CVR de partida p1 (%) | 3 |
| CVR objetivo p2 (%) | 3,3 |
| Nivel de significación α (%, bilateral) | 5 |
| Muestra por grupo n | 30000 |
| z_α/2 | =DISTR.NORM.ESTAND.INV(1-B3/100/2) |
| CVR media p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ABS(B2-B1)/100*RAIZ(B4)-B5*RAIZ(2*B6*(1-B6)))/RAIZ(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| Potencia 1−β (%) | =DISTR.NORM.ESTAND(B7)*100 |
Cómo calcularlo en Python
from math import sqrt, ceil
from statistics import NormalDist

base_cvr = 3.0          # CVR de partida (%)
relative_mde = 10.0     # MDE que detectar (% relativo)
alpha = 0.05            # nivel de significación (bilateral)
power = 0.80            # potencia
daily_visits = 2000     # visitas diarias (total A + B)

p1 = base_cvr / 100
p2 = p1 * (1 + relative_mde / 100)          # CVR objetivo
z_alpha = NormalDist().inv_cdf(1 - alpha / 2)  # para un contraste unilateral, usa 1 - alpha
z_beta = NormalDist().inv_cdf(power)
p_bar = (p1 + p2) / 2

n_exact = (z_alpha * sqrt(2 * p_bar * (1 - p_bar))
           + z_beta * sqrt(p1 * (1 - p1) + p2 * (1 - p2))) ** 2 / (p2 - p1) ** 2
n_per_group = ceil(n_exact)                  # muestra por grupo (redondeada hacia arriba)
days = ceil(2 * n_per_group / daily_visits)  # días necesarios

print(f"CVR objetivo: {p2 * 100:.4g} %")
print(f"Muestra por grupo: {n_per_group} (total {2 * n_per_group})")
print(f"Días necesarios: {days}")

# Al revés: potencia con 30.000 visitas por grupo
n_fixed = 30000
z_power = (abs(p2 - p1) * sqrt(n_fixed) - z_alpha * sqrt(2 * p_bar * (1 - p_bar))) \
          / sqrt(p1 * (1 - p1) + p2 * (1 - p2))
print(f"Potencia con {n_fixed} por grupo: {NormalDist().cdf(z_power) * 100:.2f} %")
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
p₂ = p₁ × (1 + r/100)
p_2 = p_1 \left(1 + \dfrac{r}{100}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mi>p</mi><mn>2</mn></msub>
    <mo>=</mo>
    <msub><mi>p</mi><mn>1</mn></msub>
    <mo>(</mo><mn>1</mn><mo>+</mo><mfrac><mi>r</mi><mn>100</mn></mfrac><mo>)</mo>
  </mrow>
</math>
p_2 = p_1 (1 + r/100)
p1*(1 + r/100)
p2 := p1*(1 + r/100);
p2 = p1*(1 + r/100);
p_2 = p_1 (1 + r/100)
n = (z_α/2 √(2p̄(1 − p̄)) + z_β √(p₁(1 − p₁) + p₂(1 − p₂)))² ÷ (p₂ − p₁)²
n = \dfrac{\left( z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})} + z_{\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2 - p_1)^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msup>
<mrow>
<mo>(</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
<mo>+</mo>
<msub><mi>z</mi><mi>β</mi></msub>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
<mo>)</mo>
</mrow>
<mn>2</mn>
</msup>
<msup>
<mrow><mo>(</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mfrac>
</mrow>
</math>
n = (z_(alpha/2) sqrt(2 bar p (1 - bar p)) + z_beta sqrt(p_1(1 - p_1) + p_2(1 - p_2)))^2 / (p_2 - p_1)^2
Ceiling[(za*Sqrt[2*pbar*(1 - pbar)] + zb*Sqrt[p1*(1 - p1) + p2*(1 - p2)])^2/(p2 - p1)^2]
n := ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = (z_(α/2) √(2p̄(1 − p̄)) + z_β √(p_1(1 − p_1) + p_2(1 − p_2)))^2/(p_2 − p_1)^2
D = ⌈2n ÷ V⌉
D = \left\lceil \dfrac{2n}{V} \right\rceil
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>D</mi>
<mo>=</mo>
<mo>⌈</mo>
<mfrac><mrow><mn>2</mn><mi>n</mi></mrow><mi>V</mi></mfrac>
<mo>⌉</mo>
</mrow>
</math>
D = |~ (2n)/V ~|
Ceiling[2*n/v]
days := ceil(2*n/V);
D = ceil(2*n/V);
D = ⌈2n/V⌉
1 − β = Φ((|p₂ − p₁|√n − z_α/2 √(2p̄(1 − p̄))) ÷ √(p₁(1 − p₁) + p₂(1 − p₂)))
1 - \beta = \Phi\left( \dfrac{|p_2 - p_1|\sqrt{n} - z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})}}{\sqrt{p_1(1-p_1)+p_2(1-p_2)}} \right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mn>1</mn><mo>−</mo><mi>β</mi>
<mo>=</mo>
<mi>Φ</mi>
<mo>(</mo>
<mfrac>
<mrow>
<mo>|</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>|</mo>
<msqrt><mi>n</mi></msqrt>
<mo>−</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
</mrow>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
</mfrac>
<mo>)</mo>
</mrow>
</math>
1 - beta = Phi((|p_2 - p_1| sqrt(n) - z_(alpha/2) sqrt(2 bar p (1 - bar p))) / sqrt(p_1(1 - p_1) + p_2(1 - p_2)))
CDF[NormalDistribution[0, 1], (Abs[p2 - p1]*Sqrt[n] - za*Sqrt[2*pbar*(1 - pbar)])/Sqrt[p1*(1 - p1) + p2*(1 - p2)]]
power := Statistics[CDF](Normal(0, 1), (abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
power = normcdf((abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
1 − β = Φ((|p_2 − p_1| √n − z_(α/2) √(2p̄(1 − p̄)))/√(p_1(1 − p_1) + p_2(1 − p_2)))
Cómo pedirle el cálculo a ChatGPT
Eres un asistente para planificar tests A/B. Haz el siguiente cálculo ejecutando de verdad código Python y basa tu respuesta solo en los números del resultado de la ejecución (no respondas con cálculo mental ni con estimaciones).

La CVR de la página actual (CVR de partida) es del 3 %. Quiero poder detectar con la versión B una mejora relativa del 10 % (una CVR del 3,3 %).
Con un nivel de significación del 5 % (contraste bilateral) y una potencia del 80 %, calcula lo siguiente:
1. La CVR objetivo p2 (p2 = p1 × (1 + 10/100))
2. La muestra por grupo n (fórmula del contraste z de dos proporciones: n = (z_{α/2}·√(2p̄(1−p̄)) + z_β·√(p1(1−p1)+p2(1−p2)))² ÷ (p2−p1)², con p̄ = (p1+p2)/2, redondeando hacia arriba) y la muestra total de A y B
3. Los días necesarios (redondeando hacia arriba) con 2000 visitas diarias (A y B juntos)
4. La potencia si solo se pueden conseguir 30.000 visitas por grupo (1−β = Φ((|p2−p1|·√n − z_{α/2}·√(2p̄(1−p̄))) ÷ √(p1(1−p1)+p2(1−p2))))

Usa statistics.NormalDist para los valores z y la función de distribución, y muestra las fórmulas que has usado y los números del resultado de la ejecución.
Cómo usar
-
1Introduce los datosEscribe en las casillas los números con los que quieres calcular
-
2CalculaPulsa el botón «Calcular»
-
3Consulta el resultadoEl resultado aparece al instante. En la misma página tienes también la idea del cálculo y la explicación de la fórmula
Las ventajas de DataChef

Sin conocimientos técnicos: fácil e intuitivo
Sin necesidad de dar datos personales
Los archivos se borran automáticamente tras la descarga
Sin necesidad de atribución
Sin necesidad de pedir permiso
Funciones relacionadas
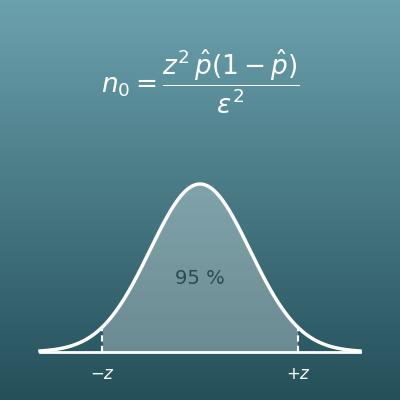
Calculadora del tamaño de la muestra y del margen de error
Calcula cuántas personas necesita una encuesta a partir del nivel de confianza, el margen de error y la proporción. Para medir con precisión un solo porcentaje
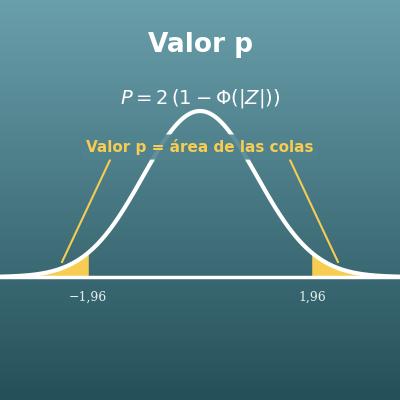
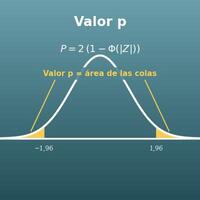
Calculadora de p-valor: de z al p-valor y al revés
Calcula el p-valor a partir de z y explica cuándo usar un contraste bilateral o unilateral. Es la otra cara del nivel de significación α de esta página
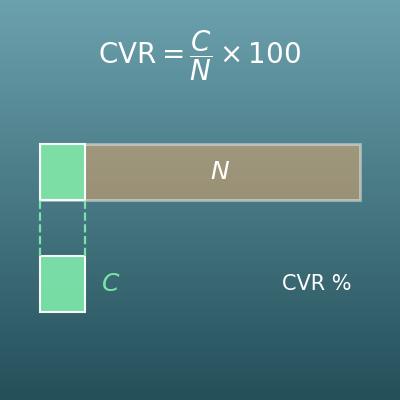
Calculadora de la tasa de conversión (CVR, visitas necesarias y conversiones previstas)
Con dos datos entre visitas, conversiones y tasa de conversión, calcula el tercero. Sirve para obtener la CVR de partida de esta página