
Calculadora del coeficiente de correlación y la covarianza (con nube de puntos y recta de regresión)
Escribe los dos grupos de datos cuya relación quieres estudiar, cada uno separado por punto y coma (;). Se calculan el coeficiente de correlación r, la covarianza y la ecuación de la recta de regresión, y la recta se dibuja sobre la nube de puntos.
Índice
-
Qué puedes hacer en esta página
-
¿Para qué sirve este cálculo?
-
Cómo usar
-
Fórmulas y figuras
-
Símbolos y términos
-
Conviene saber antes de empezar
-
Cómo calcularlo en Excel
-
Cómo calcularlo en Hojas de cálculo de Google
-
Cómo calcularlo en Python
-
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
-
Cómo pedirle el cálculo a ChatGPT
-
Las ventajas de DataChef
-
Funciones relacionadas
-
Lista de calculadoras de NumberChef
Qué puedes hacer en esta página
- Escribe los datos por parejas de \(x\) e \(y\) (dos variables) y obtén al momento el coeficiente de correlación \(r\) y la covarianza \(s_{xy}\)
- Calcula a la vez la media, la varianza y la desviación típica de \(x\) y de \(y\), y la ecuación de la recta de regresión (mínimos cuadrados) \(y = ax + b\)
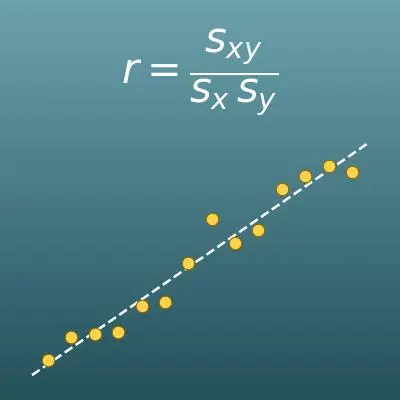
- Dibuja la nube de puntos con la recta de regresión y el punto medio encima, así que ves de un vistazo cómo se relacionan los dos datos (si suben, si bajan o si no siguen ningún patrón)
- Te da también una interpretación orientativa del valor, como «correlación positiva fuerte» o «correlación casi nula»
- En la misma página tienes la explicación sencilla de las fórmulas y las fórmulas listas para copiar en Excel, Hojas de cálculo de Google y Python
¿Para qué sirve este cálculo?
Un uso típico del coeficiente de correlación es comprobar con datos, y no a ojo, si «estudiar más sube la nota». Calculas \(r\) con las parejas de horas de estudio y nota de cada alumno, y un solo número te dice lo fuerte que es la relación.
En los institutos y academias a veces se mira la correlación entre asignaturas en los simulacros de examen (¿a quien se le dan bien las matemáticas también le va bien en física?) para orientar las clases. Pero recuerda que una correlación no demuestra la causa, como en «con solo estudiar más horas, la nota siempre sube».
Se sabe que las ventas de helados y bebidas frías tienen una correlación positiva con la temperatura, y las de caldos y chocolate caliente, una negativa. Las tiendas y los bares miran la correlación en sus datos pasados de «temperatura y unidades vendidas» y ajustan los pedidos y lo que exponen según la previsión del tiempo.
Si das un paso más y calculas la recta de regresión, puedes hacer una estimación concreta, como «si mañana se esperan 30 °C, venderemos unas tantas unidades».
En inversión, el coeficiente de correlación entre los movimientos de precio de activos como acciones, bonos u oro es una herramienta básica para diversificar. Si combinas activos con correlación baja (o negativa), cuando uno baja es menos probable que el otro baje también, y el conjunto de la cartera sube y baja menos.
Los fondos de pensiones y los fondos de inversión analizan siempre las correlaciones entre activos antes de decidir cómo repartir el dinero.
Cuando en una fábrica aumentan los defectos, calcular el coeficiente de correlación entre el porcentaje de piezas defectuosas y condiciones como la temperatura de proceso, la humedad o las horas de funcionamiento de la máquina ayuda a acotar qué condiciones se mueven a la par que los defectos. Es un método tan básico que el diagrama de dispersión que se usa para ello es una de las «siete herramientas básicas de la calidad».
Cuando aparece una condición con correlación fuerte, el siguiente paso es un experimento que cambie esa condición para confirmar la relación causa-efecto, y a partir de ahí se mejora.
La investigación sobre hábitos de vida y salud, como «ejercicio y tensión arterial» o «tabaco y riesgo de una enfermedad», también empieza comprobando la correlación en los datos.
Y es donde se aprende a no saltar de la correlación a la causa. Un ejemplo famoso: las ventas de helados y los ahogamientos tienen una correlación positiva, pero los dos simplemente aumentan con un factor común, el calor. La investigación médica usa muchos métodos para quitar el efecto de esos terceros factores y acercarse a la verdadera relación causa-efecto.
Fórmulas y figuras
Símbolos y términos
Símbolos
| \(x_i,\ y_i\) | equis sub i, i griega sub i | El valor de \(x\) y el de \(y\) de la pareja número \(i\) (por ejemplo, las horas de estudio \(x_3\) y la nota \(y_3\) del 3.er alumno). La \(i\) se usa mucho para indicar una posición (un índice). |
| \(n\) | ene | El número de parejas de datos (la inicial de «número»). Por ejemplo, con las parejas de 5 alumnos, \(n = 5\). |
| \(\bar{x},\ \bar{y}\) | equis barra, i griega barra | Las medias de \(x\) y de \(y\). La barra encima de una letra es la forma habitual de indicar una media. |
| \(x_i - \bar{x}\) | equis sub i menos equis barra | La desviación de \(x\): cuánto se aleja cada dato de la media de \(x\). \(y_i - \bar{y}\) es la desviación de \(y\). |
| \(s_{xy}\) | ese sub equis i griega | La covarianza de \(x\) e \(y\), la media de los productos de las desviaciones. Indica la tendencia de los dos datos a moverse juntos. En los libros de Bachillerato se escribe \(\sigma_{xy}\). |
| \(s_x,\ s_y\) | ese sub equis, ese sub i griega | Las desviaciones típicas de \(x\) y de \(y\) (cuánto se dispersa cada una). Son las raíces cuadradas de las varianzas. En los libros de Bachillerato se escriben \(\sigma_x\) y \(\sigma_y\). |
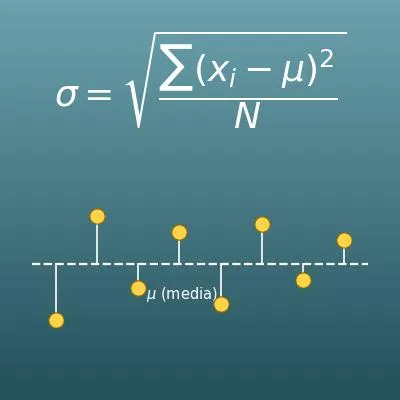
| \(s_x^2,\ s_y^2\) | ese sub equis al cuadrado, ese sub i griega al cuadrado | Las varianzas de \(x\) y de \(y\): la media de las desviaciones al cuadrado (dividiendo entre \(n\)). |
| \(r\) | erre | El coeficiente de correlación. Se dice que la \(r\) viene de «relación» (en inglés, relation o correlation). Siempre está entre \(-1\) y \(1\). |
| \(\sum\) | sigma (símbolo de sumatorio) | Símbolo que significa «sumarlo todo». \(\sum_{i=1}^{n}\) se lee «sumatorio desde \(i = 1\) hasta \(n\)». |
| \(a,\ b\) | a, be | La pendiente y la ordenada en el origen de la recta de regresión \(y = ax + b\). Hacen el mismo papel que \(m\) y \(n\) en la función lineal \(y = mx + n\). |
Términos
| correlación | Tendencia lineal entre dos datos, en la que uno aumenta cuando el otro aumenta (o disminuye). Cuanto más fuerte es, más cerca de una recta quedan los puntos de la nube de puntos. |
| correlación positiva (correlación directa) | Tendencia de \(y\) a aumentar cuando aumenta \(x\). La nube de puntos sube hacia la derecha y el coeficiente de correlación es positivo. |
| correlación negativa (correlación inversa) | Tendencia de \(y\) a disminuir cuando aumenta \(x\). La nube de puntos baja hacia la derecha y el coeficiente de correlación es negativo. |
| coeficiente de correlación | Un único número entre \(-1\) y \(1\) que indica la fuerza y el sentido de una correlación (también se llama coeficiente de correlación lineal de Pearson). Se obtiene dividiendo la covarianza entre el producto de las desviaciones típicas de \(x\) y de \(y\). Como no depende de las unidades, permite comparar la fuerza de la relación entre datos distintos. |
| covarianza | La media de los productos de las desviaciones de \(x\) y de \(y\). Si es positiva, la tendencia es a subir hacia la derecha; si es negativa, a bajar. En esta página se divide entre el número de parejas \(n\), como en Bachillerato. |
| nube de puntos (diagrama de dispersión) | Gráfico en el que cada pareja de datos \((x ; y)\) se dibuja como un punto en unos ejes de coordenadas. Por cómo se colocan los puntos se ve de un vistazo el sentido y la fuerza de la correlación. |
| variable estadística | Cada cantidad que se mide como dato, como la estatura, la nota o la temperatura. Esta página estudia la relación entre dos variables, \(x\) e \(y\) (una variable estadística bidimensional). |
| desviación | La diferencia entre un dato y la media. Si es positiva, el dato está por encima de la media; si es negativa, por debajo. La covarianza, la varianza y la desviación típica se construyen con las desviaciones. |
| varianza | La media de las desviaciones al cuadrado. Indica cuánto se dispersan los datos. Aparece en el denominador de la pendiente de la recta de regresión. |
| desviación típica | La raíz cuadrada de la varianza. Tiene las mismas unidades que los datos, así que es cómoda como medida de la dispersión. Aparece en el denominador del coeficiente de correlación. |
| recta de regresión | La recta \(y = ax + b\) que mejor se ajusta a la nube de puntos (la recta de regresión de \(y\) sobre \(x\)). Sirve para estimar el valor de \(y\) a partir del de \(x\). |
| método de mínimos cuadrados | Forma de elegir la pendiente y la ordenada en el origen de una recta para que la suma de los cuadrados de las distancias verticales (errores) entre cada punto y la recta sea la menor posible. La recta de regresión es la recta elegida así. |
| valor atípico | Un valor muy alejado de los demás puntos. Al coeficiente de correlación le afectan mucho los valores atípicos, así que conviene mirarlo siempre junto con la nube de puntos. |
| relación estadística | Relación en la que dos cantidades se mueven juntas (cuando una aumenta, la otra aumenta o disminuye). Aunque haya correlación, no tiene por qué ser que una sea la causa de la otra (causalidad): puede que haya detrás una causa común a las dos (un tercer factor). |
| causalidad (relación causa-efecto) | Relación en la que una cosa es la causa y la otra su efecto. Una relación estadística (moverse juntas) no basta para demostrar causalidad: puede haber detrás una causa común a las dos (un tercer factor). |
Conviene saber antes de empezar
Esto es lo que te ayuda a usar el cálculo de esta página entendiendo lo que hace, no solo pulsando el botón.
Si te atascas, repasar estos temas es el camino más corto.
| La media (5.º-6.º de Primaria, 10-12 años) |
|
| Números enteros (1.º de ESO, 12-13 años) |
|
| Coordenadas y funciones lineales (1.º-3.º de ESO, 12-15 años) |
|
| Raíces cuadradas (1.º-2.º de ESO, 12-14 años) |
|
| Estadística bidimensional (1.º de Bachillerato, 16-17 años) |
|
Cómo calcularlo en Excel
| x de la pareja 1 | 1 |
| x de la pareja 2 | 2 |
| x de la pareja 3 | 3 |
| x de la pareja 4 | 4 |
| x de la pareja 5 | 5 |
| y de la pareja 1 | 2 |
| y de la pareja 2 | 4 |
| y de la pareja 3 | 4 |
| y de la pareja 4 | 4 |
| y de la pareja 5 | 6 |
| Covarianza s_xy (entre n) | =COVARIANZA.P(B1:B5;B6:B10) |
| (Referencia) covarianza muestral, entre n−1 | =COVARIANZA.M(B1:B5;B6:B10) |
| x de la pareja 1 | 1 |
| x de la pareja 2 | 2 |
| x de la pareja 3 | 3 |
| x de la pareja 4 | 4 |
| x de la pareja 5 | 5 |
| y de la pareja 1 | 2 |
| y de la pareja 2 | 4 |
| y de la pareja 3 | 4 |
| y de la pareja 4 | 4 |
| y de la pareja 5 | 6 |
| Coeficiente de correlación r | =COEF.DE.CORREL(B1:B5;B6:B10) |
| (Referencia) el mismo valor con PEARSON | =PEARSON(B1:B5;B6:B10) |
| x de la pareja 1 | 1 |
| x de la pareja 2 | 2 |
| x de la pareja 3 | 3 |
| x de la pareja 4 | 4 |
| x de la pareja 5 | 5 |
| y de la pareja 1 | 2 |
| y de la pareja 2 | 4 |
| y de la pareja 3 | 4 |
| y de la pareja 4 | 4 |
| y de la pareja 5 | 6 |
| Pendiente a | =PENDIENTE(B6:B10;B1:B5) |
| Ordenada en el origen b | =INTERSECCION.EJE(B6:B10;B1:B5) |
| x de la pareja 1 | 1 |
| x de la pareja 2 | 2 |
| x de la pareja 3 | 3 |
| x de la pareja 4 | 4 |
| x de la pareja 5 | 5 |
| y de la pareja 1 | 2 |
| y de la pareja 2 | 4 |
| y de la pareja 3 | 4 |
| y de la pareja 4 | 4 |
| y de la pareja 5 | 6 |
| Media de x x̄ | =PROMEDIO(B1:B5) |
| Media de y ȳ | =PROMEDIO(B6:B10) |
| Varianza de x s_x² | =VARP(B1:B5) |
| Desviación típica de x s_x | =DESVESTP(B1:B5) |
| Varianza de y s_y² | =VARP(B6:B10) |
| Desviación típica de y s_y | =DESVESTP(B6:B10) |
La covarianza de la primera tabla es 1,6 (la muestral es 2), el coeficiente de correlación de la segunda es de unos 0,8944, y la tercera da una pendiente de 0,8 y una ordenada en el origen de 1,6.
Cuidado: hay dos funciones de covarianza. COVARIANZA.P es la que divide entre n (igual que esta calculadora y que en Bachillerato), y COVARIANZA.M es la muestral, que divide entre n − 1. En versiones antiguas de Excel (2007 y anteriores), usa COVAR en lugar de COVARIANZA.P.
COEF.DE.CORREL y PEARSON dan el mismo coeficiente de correlación (r sale igual dividiendo entre n o entre n − 1, así que no hay que elegir).
PENDIENTE e INTERSECCION.EJE piden primero el rango de y y después el de x (ojo, x no va primero).
Si tienes otro número de parejas, añade (o quita) filas de números y cambia «B1:B5» y «B6:B10» en las fórmulas por tus rangos reales.
Cómo calcularlo en Hojas de cálculo de Google
| x de la pareja 1 | 1 |
| x de la pareja 2 | 2 |
| x de la pareja 3 | 3 |
| x de la pareja 4 | 4 |
| x de la pareja 5 | 5 |
| y de la pareja 1 | 2 |
| y de la pareja 2 | 4 |
| y de la pareja 3 | 4 |
| y de la pareja 4 | 4 |
| y de la pareja 5 | 6 |
| Covarianza s_xy (entre n) | =COVAR(B1:B5;B6:B10) |
| x de la pareja 1 | 1 |
| x de la pareja 2 | 2 |
| x de la pareja 3 | 3 |
| x de la pareja 4 | 4 |
| x de la pareja 5 | 5 |
| y de la pareja 1 | 2 |
| y de la pareja 2 | 4 |
| y de la pareja 3 | 4 |
| y de la pareja 4 | 4 |
| y de la pareja 5 | 6 |
| Coeficiente de correlación r | =COEF.DE.CORREL(B1:B5;B6:B10) |
| x de la pareja 1 | 1 |
| x de la pareja 2 | 2 |
| x de la pareja 3 | 3 |
| x de la pareja 4 | 4 |
| x de la pareja 5 | 5 |
| y de la pareja 1 | 2 |
| y de la pareja 2 | 4 |
| y de la pareja 3 | 4 |
| y de la pareja 4 | 4 |
| y de la pareja 5 | 6 |
| Pendiente a | =PENDIENTE(B6:B10;B1:B5) |
| Ordenada en el origen b | =INTERSECCION.EJE(B6:B10;B1:B5) |
En Hojas de cálculo de Google, la covarianza que divide entre n se calcula con la función COVAR (la misma definición que esta calculadora; COVARIANZA.P llama a la misma función). Para el coeficiente de correlación se usa COEF.DE.CORREL, igual que en Excel.
Cómo calcularlo en Python
import statistics

xs = [1, 2, 3, 4, 5]      # datos de x (ejemplo: horas de estudio)
ys = [2, 4, 4, 4, 6]      # datos de y (ejemplo: nota del control)

n = len(xs)
mean_x = statistics.mean(xs)      # media de x
mean_y = statistics.mean(ys)      # media de y

# covarianza s_xy (dividiendo entre n, como en Bachillerato)
covariance = sum((x - mean_x) * (y - mean_y) for x, y in zip(xs, ys)) / n

sd_x = statistics.pstdev(xs)      # desviación típica de x (entre n)
sd_y = statistics.pstdev(ys)      # desviación típica de y (entre n)

r = covariance / (sd_x * sd_y)    # coeficiente de correlación

slope = covariance / statistics.pvariance(xs)   # pendiente a de la recta de regresión
intercept = mean_y - slope * mean_x             # ordenada en el origen b de la recta de regresión

print(f"Covarianza s_xy: {covariance}")
print(f"Coeficiente de correlación r: {r}")
# la ordenada en el origen puede salir con error de coma flotante (1.5999...), así que se redondea a 10 cifras significativas
print(f"Recta de regresión: y = {slope:.10g}x + {intercept:.10g}")
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
s_xy = {(x₁ − x̄)(y₁ − ȳ) + … + (xₙ − x̄)(yₙ − ȳ)} ÷ n
s_{xy} = \dfrac{1}{n}\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y})
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
<mo>=</mo>
<mfrac><mn>1</mn><mi>n</mi></mfrac>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>1</mn></mrow>
<mi>n</mi>
</munderover>
<mrow>
<mo>(</mo><msub><mi>x</mi><mi>i</mi></msub><mo>−</mo><mover><mi>x</mi><mo>¯</mo></mover><mo>)</mo>
<mo>(</mo><msub><mi>y</mi><mi>i</mi></msub><mo>−</mo><mover><mi>y</mi><mo>¯</mo></mover><mo>)</mo>
</mrow>
</mrow>
</math>
s_(xy) = (1/n) sum_(i=1)^n (x_i - bar x)(y_i - bar y)
Covariance[xdata, ydata]*(Length[xdata] - 1)/Length[xdata] (* Covariance divide entre n-1; así se pasa al valor dividido entre n *)
s_xy := add((x[i] - x_bar)*(y[i] - y_bar), i = 1 .. n)/n;
s_xy = mean((x - mean(x)).*(y - mean(y)));
s_xy = (1/n) ∑_(i=1)^n (x_i − x̄)(y_i − ȳ)
r = s_xy ÷ (s_x × s_y)
r = \dfrac{s_{xy}}{s_x\, s_y}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>r</mi>
    <mo>=</mo>
    <mfrac>
      <msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
      <mrow><msub><mi>s</mi><mi>x</mi></msub><msub><mi>s</mi><mi>y</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
r = s_(xy) / (s_x s_y)
Correlation[xdata, ydata]
r := s_xy/(s_x*s_y);
R = corrcoef(x, y); r = R(1, 2);
r = s_xy/(s_x s_y)
y = ax + b, a = s_xy ÷ s_x², b = ȳ − a·x̄
y = ax + b, \quad a = \dfrac{s_{xy}}{s_x^{2}}, \quad b = \bar{y} - a\bar{x}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>y</mi><mo>=</mo><mi>a</mi><mi>x</mi><mo>+</mo><mi>b</mi>
<mo>,</mo><mspace width="1em"/>
<mi>a</mi><mo>=</mo>
<mfrac>
<msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
<msubsup><mi>s</mi><mi>x</mi><mn>2</mn></msubsup>
</mfrac>
<mo>,</mo><mspace width="1em"/>
<mi>b</mi><mo>=</mo>
<mover><mi>y</mi><mo>¯</mo></mover>
<mo>−</mo>
<mi>a</mi><mover><mi>x</mi><mo>¯</mo></mover>
</mrow>
</math>
y = a x + b, a = s_(xy)/s_x^2, b = bar y - a bar x
lm = LinearModelFit[Transpose[{xdata, ydata}], t, t]; lm["BestFitParameters"]
a := s_xy/s_x^2; b := y_bar - a*x_bar;
p = polyfit(x, y, 1); % p(1) = pendiente a, p(2) = ordenada en el origen b
y = ax + b, a = s_xy/s_x^2, b = ȳ − ax̄
Cómo pedirle el cálculo a ChatGPT
Eres un asistente de cálculo estadístico. Haz el siguiente cálculo ejecutando de verdad código de Python y basa tu respuesta solo en los números del resultado de la ejecución (no respondas calculando de cabeza ni a ojo).

Para las parejas de datos siguientes, calcula cada uno de estos valores.
x: 1 ; 2 ; 3 ; 4 ; 5
y: 2 ; 4 ; 4 ; 4 ; 6
1. Las medias de x y de y, y sus varianzas y desviaciones típicas dividiendo entre n
2. La covarianza s_xy (la suma de los productos de las desviaciones dividida entre el número de parejas n; no dividas entre n − 1)
3. El coeficiente de correlación r
4. La pendiente a y la ordenada en el origen b de la recta de regresión y = ax + b (mínimos cuadrados)

Indica las fórmulas que has usado y los números del resultado de la ejecución.
Cómo usar
-
1Introduce los datosEscribe en las casillas los números con los que quieres calcular
-
2CalculaPulsa el botón «Calcular»
-
3Consulta el resultadoEl resultado aparece al instante. En la misma página tienes también la idea del cálculo y la explicación de la fórmula
Las ventajas de DataChef

Sin conocimientos técnicos: fácil e intuitivo
Sin necesidad de dar datos personales
Los archivos se borran automáticamente tras la descarga
Sin necesidad de atribución
Sin necesidad de pedir permiso
Funciones relacionadas
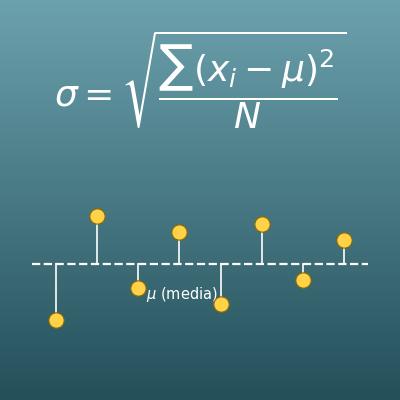
Calculadora de desviación típica poblacional y muestral
Calcula de una vez la desviación típica, la varianza y la suma de cuadrados de las desviaciones de una lista de números
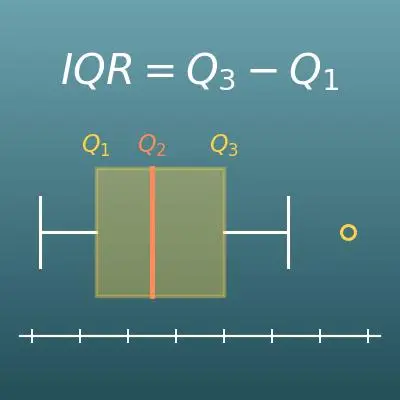
Calculadora de cuartiles y diagrama de caja (Q1, Q2, Q3, rango intercuartílico y valores atípicos)
Calcula los cuartiles Q1, Q2 y Q3 y el rango intercuartílico de tus datos, y dibuja el diagrama de caja