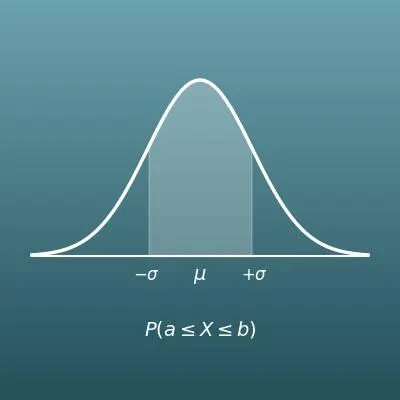
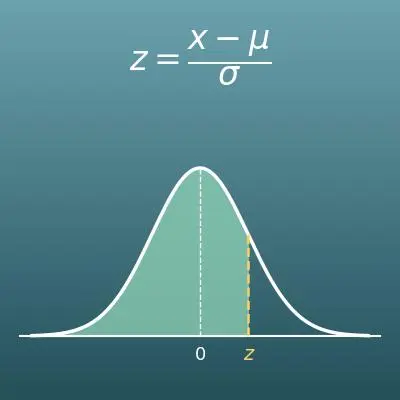

Hay tres formas de usar esta calculadora. ① Calcular la puntuación z a partir de un valor, la media y la desviación típica. ② Pasar de puntuación z a probabilidad o al revés (rellena una sola casilla). ③ Calcular la probabilidad entre dos puntuaciones z. Rellena solo las casillas del grupo que quieras usar.
Índice
-
Qué puedes hacer en esta página
-
¿Para qué sirve este cálculo?
-
Cómo usar
-
Fórmulas y gráficas
-
Símbolos y términos
-
Conviene saber antes de empezar
-
Cómo calcularlo en Excel
-
Cómo calcularlo en Hojas de cálculo de Google
-
Cómo calcularlo en Python
-
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
-
Cómo pedirle el cálculo a ChatGPT
-
Las ventajas de DataChef
-
Funciones relacionadas
-
Lista de calculadoras de NumberChef
Qué puedes hacer en esta página
- Escribe un valor \(x\), la media \(\mu\) y la desviación típica \(\sigma\) y obtén de una vez la puntuación z (puntuación típica) y la probabilidad de obtener un valor menor
- En lugar de buscar en la tabla de la normal N(0, 1), pasa de puntuación z a probabilidad y de probabilidad a puntuación z
- También calcula al momento la probabilidad entre dos puntuaciones z (por ejemplo, entre −1,96 y 1,96)
- En la misma página tienes la explicación sencilla de las fórmulas y las fórmulas listas para copiar en Excel, Hojas de cálculo de Google y Python
¿Para qué sirve este cálculo?
En un examen sobre 100 con media 65 y desviación típica 5, un 75 es \(z = 2\). Si las notas siguen una distribución normal, estás más o menos en el 2,3 % de arriba (\(1 - \Phi(2) \approx 0{,}0228\)), es decir, hacia el percentil 97,7. El cociente intelectual se construye directamente a partir de la puntuación z (CI \(= 100 + 15 \times z\)), así que un CI de 130 está en la misma posición.
Es el uso más cercano de la puntuación z: pasar una nota a percentil y ver cuánto supone de verdad una diferencia de unos pocos puntos, incluso entre exámenes con notas máximas y medias distintas.
«80 en inglés (media 70, desviación típica 10)» y «65 en matemáticas (media 50, desviación típica 15)»: en bruto parece mejor la nota de inglés, pero pasadas a puntuación z las dos son \(z = 1\), la misma posición.
Aunque cambien las unidades, la nota máxima o lo exigente que sea la corrección, con la puntuación z se compara de forma justa «cuánto destaca» cada nota dentro de su grupo. La misma idea se usa para ajustar puntuaciones entre distintos modelos de examen y para normalizar evaluaciones de desempeño en las empresas.
En las curvas de crecimiento que usa el pediatra (como las de la OMS), la estatura y el peso se valoran con la puntuación z, que indica a cuántas desviaciones típicas (DE) está el niño de la media.
Más o menos el 2,3 % de los niños queda fuera de cada una de las líneas de ±2 DE (\(z = \pm 2\)), que corresponden a los percentiles 2,3 y 97,7. Son una de las referencias para decidir si conviene vigilar el crecimiento (cada niño crece a su ritmo y el pediatra decide viendo la evolución). Saber qué significa la línea de «−2 DE» ayuda a entender lo que te explican en la revisión.
Las medidas y el peso de los productos suelen variar de forma parecida a una distribución normal, así que, si pasas los límites superior e inferior de la especificación a puntuación z, puedes estimar el porcentaje de piezas defectuosas. Si los límites están en la media \(\pm 3\sigma\), queda fuera más o menos el 0,3 % (\(2 \times (1 - \Phi(3)) \approx 0{,}0027\)).
El nombre del método de mejora de la calidad «Seis Sigma» también viene de esta idea de la puntuación z (cuántas σ de distancia).
Los bancos y las gestoras miden el riesgo de pérdidas de sus carteras con una medida llamada valor en riesgo (VaR). Si se supone que las rentabilidades siguen una distribución normal, el límite en el que «con un 99 % de probabilidad la pérdida no pasa de aquí» es la puntuación z \(\Phi^{-1}(0{,}99) \approx 2{,}33\), es decir, a 2,33 desviaciones típicas de la media.
Este paso de «probabilidad a puntuación z» está en la base de los cálculos de riesgo de las entidades financieras de todo el mundo.
Fórmulas y gráficas
Símbolos y términos
Símbolos
| \(z\) | zeta (puntuación z) | Número que indica a cuántas desviaciones típicas está un valor de la media; se calcula con \(z = (x - \mu) \div \sigma\). Si es positivo, el valor está por encima de la media, y si es negativo, por debajo. En esta página, la puntuación z que tú indicas, como en ② y ③, se escribe con \(Z\) mayúscula. |
| \(x\) | equis | El valor que has medido, como la nota de un examen o una estatura. Es el valor de partida que quieres pasar a puntuación z. |
| \(\mu\) | mu | La media. Es donde está el centro de la campana. Es una letra griega que corresponde a nuestra m. |
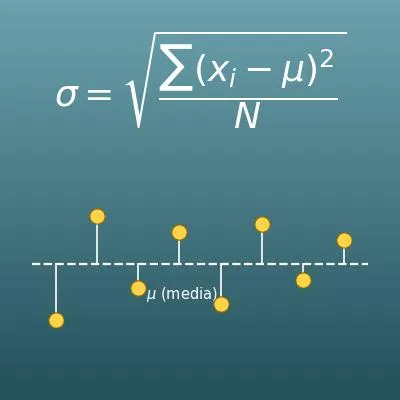
| \(\sigma\) | sigma | La desviación típica, el tamaño de la dispersión de los datos. Cuanto mayor es, más baja y ancha es la campana. Es una letra griega que corresponde a nuestra s. |
| \(\Phi(Z)\) | fi de zeta | La función de distribución de la distribución normal estándar (media 0, desviación típica 1). Da la probabilidad de un valor menor que \(Z\), que es el área bajo la curva a la izquierda de \(Z\). |
| \(\Phi^{-1}\) | fi a la menos uno (inversa de Φ) | La función que hace lo contrario que \(\Phi\): a partir de una probabilidad (un área) da la puntuación z correspondiente. (Por ejemplo, \(\Phi^{-1}(0{,}975) \approx 1{,}96\).) |
| \(Z_1,\ Z_2\) | zeta sub uno, zeta sub dos | Las dos puntuaciones z que escribes en ③. \(Z_1\) es el límite de la izquierda (el menor) y \(Z_2\) el de la derecha (el mayor). |
Términos
| puntuación z (puntuación típica) | Número sin unidades que indica a cuántas desviaciones típicas está un valor de la media. También se llama puntuación tipificada, valor z o, en inglés, z-score. Su gran ventaja es que pone en la misma regla datos con unidades o notas máximas distintas. |
| tipificación | Pasar un valor a puntuación z (en otros textos, estandarización). Una vez tipificados, los datos de cualquier distribución normal se manejan con una sola distribución normal estándar de media 0 y desviación típica 1. |
| distribución normal estándar (normal tipificada) | La distribución normal de media 0 y desviación típica 1, \(N(0, 1)\). Es la distribución de las puntuaciones z y sirve de regla común para calcular probabilidades con cualquier distribución normal. |
| distribución normal | Distribución repartida de forma simétrica alrededor de la media, con forma de campana (la campana de Gauss). Muchos datos reales, como las notas de un examen, la estatura o el peso de los productos, se acercan a esta forma. |
| función de distribución | Función que da la probabilidad de obtener ese valor o uno menor. La de la distribución normal estándar se escribe \(\Phi\) (fi). Va sumando (acumulando) el área de la parte izquierda de la curva. |
| tabla de la normal N(0, 1) | Tabla que recoge las puntuaciones z y los valores (áreas) de \(\Phi\) que les corresponden. Viene al final de los libros de Bachillerato y de estadística. La forma ② de esta página sirve para sustituirla. |
| puntuación T | Una puntuación z reescalada para que la media sea 50 y cada desviación típica valga 10 (puntuación T \(= 50 + 10 \times z\)). Se usa en muchos tests psicológicos y educativos. El cociente intelectual funciona igual, con media 100 y 15 puntos por desviación típica. |
Conviene saber antes de empezar
Esto es lo que te ayuda a usar el cálculo de esta página entendiendo lo que hace, no solo pulsando el botón.
| La media (5.º-6.º de Primaria, 10-12 años) |
|
| Operaciones con números negativos (1.º de ESO, 12-13 años) |
|
| Parámetros de dispersión y desviación típica (4.º de ESO a 1.º de Bachillerato, 15-17 años) |
|
| La distribución normal y las áreas (Bachillerato, 16-18 años) |
|
Cómo calcularlo en Excel
| Valor x | 75 |
| Media μ | 65 |
| Desviación típica σ | 5 |
| Puntuación z | =(B1-B2)/B3 |
| Puntuación z Z | 2 |
| P(x<Z) | =DISTR.NORM.ESTAND.N(B1;VERDADERO) |
| Puntuación z Z | 1,96 |
| Φ(Z) | =DISTR.NORM.ESTAND.N(B1;VERDADERO) |
| Probabilidad entre −Z y Z | =2*B2-1 |
| Z1 (izquierda) | -1 |
| Z2 (derecha) | 0 |
| Φ(Z1) | =DISTR.NORM.ESTAND.N(B1;VERDADERO) |
| Φ(Z2) | =DISTR.NORM.ESTAND.N(B2;VERDADERO) |
| Probabilidad entre Z1 y Z2 | =B4-B3 |
En la primera tabla, cambia el valor, la media y la desviación típica (B1 a B3) y B4 muestra la puntuación z (con los valores del ejemplo, B4 vale 2). La segunda calcula la probabilidad (B2) a partir de la puntuación z (B1); con el valor del ejemplo, B2 vale unos 0,97725 (97,7 %).
En la tercera, con la puntuación z 1,96 obtienes la probabilidad entre −1,96 y 1,96 (B3), unos 0,95 (95 %). La cuarta es la probabilidad entre dos puntuaciones z; con los valores del ejemplo (−1 y 0), B5 vale unos 0,34134 (34,1 %).
Para ir al revés, «de una probabilidad a una puntuación z», usa «=INV.NORM.ESTAND(probabilidad)» (por ejemplo, `=INV.NORM.ESTAND(0,975)` da unos 1,95996).
Cómo calcularlo en Hojas de cálculo de Google
| Valor x | 75 |
| Media μ | 65 |
| Desviación típica σ | 5 |
| Puntuación z | =(B1-B2)/B3 |
| Puntuación z Z | 2 |
| P(x<Z) | =DISTR.NORM.ESTAND(B1) |
| Puntuación z Z | 1,96 |
| Φ(Z) | =DISTR.NORM.ESTAND(B1) |
| Probabilidad entre −Z y Z | =2*B2-1 |
| Z1 (izquierda) | -1 |
| Z2 (derecha) | 0 |
| Φ(Z1) | =DISTR.NORM.ESTAND(B1) |
| Φ(Z2) | =DISTR.NORM.ESTAND(B2) |
| Probabilidad entre Z1 y Z2 | =B4-B3 |
Los resultados son los mismos que en Excel: la primera tabla da una puntuación z de 2 con 75, 65 y 5, y la segunda una probabilidad de unos 0,97725 con una puntuación z de 2.
Para calcular una puntuación z a partir de una probabilidad, usa «=DISTR.NORM.ESTAND.INV(probabilidad)» (por ejemplo, `=DISTR.NORM.ESTAND.INV(0,975)` da unos 1,95996).
Cómo calcularlo en Python
import math

def phi(z):
    # Función de distribución de la normal estándar, Φ(z) (se calcula con la función de error erf)
    return 0.5 * (1 + math.erf(z / math.sqrt(2)))

x = 75       # valor
mean = 65    # media
sd = 5       # desviación típica

z_score = (x - mean) / sd             # puntuación z
p_less_than_z = phi(z_score)          # probabilidad de un valor menor que la puntuación z, P(x<Z)

z = 1.96
p_between_minus_z_and_z = 2 * phi(z) - 1   # probabilidad entre -z y z

z1, z2 = -1, 0
p_between_z1_z2 = phi(z2) - phi(z1)        # probabilidad entre z1 y z2

print(f"Puntuación z: {z_score}")
print(f"P(x<Z): {p_less_than_z}")
print(f"Probabilidad entre -z y z: {p_between_minus_z_and_z}")
print(f"Probabilidad entre z1 y z2: {p_between_z1_z2}")
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
z = (x − μ) ÷ σ
z = \dfrac{x - \mu}{\sigma}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi>
<mo>=</mo>
<mfrac>
<mrow><mi>x</mi><mo>−</mo><mi>μ</mi></mrow>
<mi>σ</mi>
</mfrac>
</mrow>
</math>
z = (x - mu)/sigma
(x - mu)/sigma
z := (x - mu)/sigma;
z = (x - mu)/sigma;
z = (x-μ)/σ
P(x<Z) = Φ(Z)
P(x<Z) = \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>x</mi><mo><</mo><mi>Z</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P(x<Z) = Phi(Z)
CDF[NormalDistribution[0, 1], Z]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), Z);
p = normcdf(Z);
P(x<Z) = Φ(Z)
P(−Z<x<Z) = 2Φ(Z) − 1
P(-Z<x<Z) = 2\Phi(Z) - 1
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mo>−</mo><mi>Z</mi><mo><</mo><mi>x</mi><mo><</mo><mi>Z</mi><mo>)</mo>
<mo>=</mo>
<mn>2</mn><mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo><mo>−</mo><mn>1</mn>
</mrow>
</math>
P(-Z<x<Z) = 2 Phi(Z) - 1
2 CDF[NormalDistribution[0, 1], Z] - 1
with(Statistics): 2*CDF(RandomVariable(Normal(0, 1)), Z) - 1;
p = 2*normcdf(Z) - 1;
P(-Z<x<Z) = 2Φ(Z) - 1
P(Z₁<x<Z₂) = Φ(Z₂) − Φ(Z₁)
P(Z_1<x<Z_2) = \Phi(Z_2) - \Phi(Z_1)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><msub><mi>Z</mi><mn>1</mn></msub><mo><</mo><mi>x</mi><mo><</mo><msub><mi>Z</mi><mn>2</mn></msub><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><msub><mi>Z</mi><mn>2</mn></msub><mo>)</mo>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><msub><mi>Z</mi><mn>1</mn></msub><mo>)</mo>
</mrow>
</math>
P(Z_1<x<Z_2) = Phi(Z_2) - Phi(Z_1)
CDF[NormalDistribution[0, 1], Z2] - CDF[NormalDistribution[0, 1], Z1]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), Z2) - CDF(RandomVariable(Normal(0, 1)), Z1);
p = normcdf(Z2) - normcdf(Z1);
P(Z1<x<Z2) = Φ(Z2) - Φ(Z1)
Cómo pedirle el cálculo a ChatGPT
Eres un asistente de cálculo estadístico. Haz el siguiente cálculo ejecutando de verdad código de Python y basa tu respuesta solo en los números del resultado de la ejecución (no respondas calculando de cabeza ni a ojo).

Una persona ha sacado 75 puntos en un examen sobre 100 con una media de 65 puntos y una desviación típica de 5 puntos.
1. Calcula su puntuación z.
2. Calcula la probabilidad de sacar menos que ese valor, P(x<Z) (usa la función de distribución Φ de la normal estándar; puedes usar la biblioteca estándar de Python, como math.erf o statistics.NormalDist).
3. Calcula también la probabilidad de que una puntuación z quede entre −1,96 y 1,96.

Indica las fórmulas que has usado y los números del resultado de la ejecución.
Cómo usar
-
1Introduce los datosEscribe en las casillas los números con los que quieres calcular
-
2CalculaPulsa el botón «Calcular»
-
3Consulta el resultadoEl resultado aparece al instante. En la misma página tienes también la idea del cálculo y la explicación de la fórmula
Las ventajas de DataChef

Sin conocimientos técnicos: fácil e intuitivo
Sin necesidad de dar datos personales
Los archivos se borran automáticamente tras la descarga
Sin necesidad de atribución
Sin necesidad de pedir permiso
Funciones relacionadas
Calculadora de probabilidades de la distribución normal
Con la media y la desviación típica, calcula la probabilidad de caer en un intervalo o qué porcentaje queda por encima
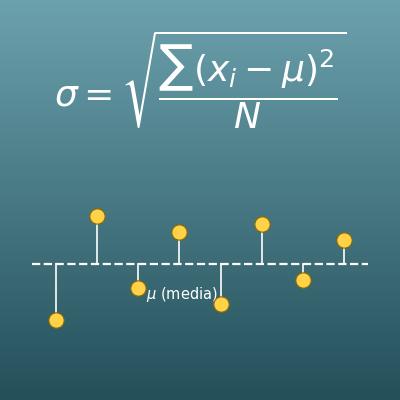
Calculadora de desviación típica poblacional y muestral
A partir de una lista de números, calcula la desviación típica poblacional y muestral, la varianza y la media