




























































































Hay dos formas de usar esta calculadora. 1) Escribe el nivel de confianza, la proporción y el margen de error para hallar el tamaño de la muestra que necesitas. 2) Escribe el nivel de confianza, la proporción y el tamaño de la muestra para hallar el margen de error. Escribe el tamaño de la población solo si lo conoces.
Índice
-
Qué puedes hacer en esta página
-
¿Para qué sirve este cálculo?
-
Cómo usar
-
Fórmula
-
Tamaño de muestra necesario (cuando la población es muy grande)
-
Corrección para poblaciones finitas del tamaño de la muestra (cuando conoces el tamaño de la población \(N\))
-
Margen de error (cuando la población es muy grande)
-
Corrección para poblaciones finitas del margen de error (cuando conoces el tamaño de la población \(N\))
-
-
Símbolos y términos
-
Qué conviene saber de antemano
-
Cómo calcularlo con Excel
-
Cómo calcularlo con Hojas de cálculo de Google
-
Cómo calcularlo con Python
-
La fórmula en LaTeX y otras notaciones matemáticas (para copiar)
-
Cómo pedirle a ChatGPT que haga el cálculo
-
Las ventajas de DataChef
-
Funciones relacionadas
-
Todas las calculadoras de NumberChef
Qué puedes hacer en esta página
- «¿A cuántas personas necesito encuestar para un nivel de confianza del 95 % y un margen de error de ±5 %?» Obtén al instante el tamaño de la muestra que necesita tu encuesta
- Al revés, «¿cuánta precisión, en más o en menos, tiene una encuesta a 1000 personas?» Halla el margen de error en la misma página
- Si conoces el tamaño de la población (500 empleados, 1000 socios, etc.), la corrección para poblaciones finitas te acota el número que necesitas de verdad
- En esta misma página encontrarás también una explicación sencilla de las fórmulas y las fórmulas listas para copiar en Excel, Hojas de cálculo de Google y Python
¿Para qué sirve este cálculo?
Las encuestas de opinión de ámbito nacional suelen entrevistar a entre 1000 y 4000 personas elegidas al azar entre decenas de millones de personas adultas (el barómetro del CIS, por ejemplo, ronda las 4000 entrevistas). Con un nivel de confianza del 95 %, un margen de error de ±3 % y una proporción del 50 %, el tamaño de muestra necesario es \(1{,}96^2 \times 0{,}25 \div 0{,}03^2 \approx 1067{,}1\) (unas 1068 personas). Esta fórmula responde a la pregunta «¿pueden unas 1000 personas decirnos de verdad lo que piensan cientos de miles o millones?».
Al revés, puedes ver que si «un apoyo del 45 % frente a un 47 %» está dentro de un margen de error de ±3 puntos, no puedes afirmar con seguridad que exista una diferencia estadística.
«¿A cuántos de nuestros 1000 socios necesitamos preguntar?» es un caso clásico de corrección para poblaciones finitas. Con un nivel de confianza del 95 %, un margen de error de ±5 % y una proporción del 50 %, el valor antes de la corrección, 384,16, baja a \(384{,}16 \div (1 + 383{,}16 \div 1000) \approx 277{,}7\) (278 personas tras redondear hacia arriba).
Si decides de antemano cuántas respuestas bastan para la precisión que necesitas, antes de enviar recordatorio tras recordatorio a todo el mundo, puedes equilibrar con números el coste y la precisión de la encuesta.
Esta fórmula también se usa para estimar la tasa de defectos de piezas fabricadas en serie sin inspeccionarlas todas. Si los registros anteriores indican una tasa de defectos de alrededor del 10 %, un nivel de confianza del 90 % y un margen de error de ±4 % dan \(1{,}65^2 \times 0{,}1 \times 0{,}9 \div 0{,}04^2 \approx 153{,}1\), así que basta una muestra de unas 154 piezas.
El ejemplo también muestra que cuanto más lejos está la proporción del 50 %, menor es la dispersión \(\hat{p}(1-\hat{p})\) y menos unidades necesitas.
En un estudio epidemiológico sobre «la proporción de personas de una zona que tienen esta enfermedad», el plan del estudio debe indicar cuántos participantes hacen falta. Si estudios anteriores sugieren una prevalencia de alrededor del 20 %, un nivel de confianza del 95 % y un margen de error de ±3 % dan \(1{,}96^2 \times 0{,}2 \times 0{,}8 \div 0{,}03^2 \approx 683{,}0\), unas 683 personas.
La investigación clínica real usa también métodos más precisos que se ajustan al diseño del estudio (como el análisis de potencia). Esta fórmula es la forma básica de la que parten.
Las audiencias de televisión se estiman a partir de un panel de hogares con audímetro que forman una muestra, no de todos los hogares. Como ejemplo simplificado (los métodos reales de medición de audiencias son más complejos), toma un panel de 2700 hogares y un programa visto en el 10 % de ellos. Con un nivel de confianza del 95 %, el margen de error es \(1{,}96 \times \sqrt{0{,}1 \times 0{,}9 \div 2700} \approx 0{,}0113\) (aproximadamente ±1,1 %).
Así puedes ver que «la diferencia entre una audiencia del 9,5 % y una del 10,5 % puede estar dentro del margen de error» y leer los números de las noticias un paso más a fondo.
Fórmula
Símbolos y términos
Símbolos
| \(n\) | ene | El tamaño de la muestra. En una encuesta, es el número de personas cuyas respuestas recoges; en una inspección, el número de unidades que compruebas. |
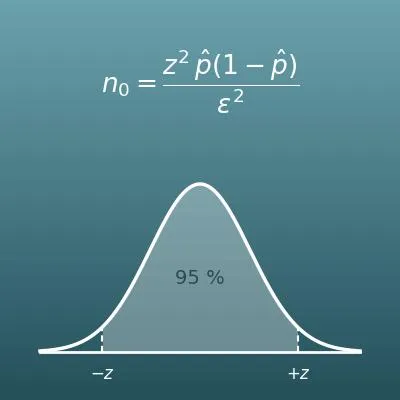
| \(n_0\) | n sub cero | El tamaño de muestra necesario calculado cuando la población se considera muy grande. Es el valor antes de la corrección para poblaciones finitas. |
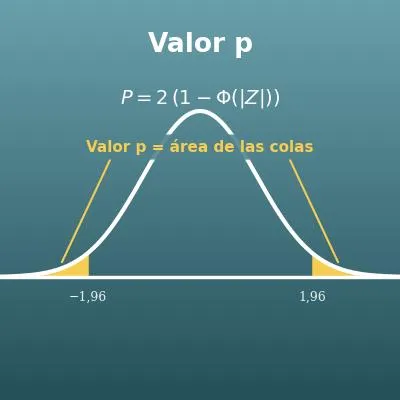
| \(z\) | zeta | El valor z (un valor de la distribución normal estándar) del nivel de confianza. Los valores habituales son 1,96 para el 95 % y 2,58 para el 99 %. |
| \(\hat{p}\) | p sombrero | La proporción (como la parte de respuestas «sí» que quieres conocer). Para hallar el tamaño de la muestra, usa tu valor esperado; para hallar el margen de error, usa la proporción que has obtenido de verdad en la encuesta (la proporción muestral). Escríbela como decimal de 0 a 1 (0,5 para el 50 %). |
| \(\varepsilon\) | épsilon | El margen de error, la diferencia que permites entre el resultado de la encuesta y el valor verdadero. Se muestra con ±, como en «±5 %». En Bachillerato se llama también error máximo admisible. |
| \(N\) | N mayúscula | El tamaño de la población, el número de personas o de unidades del grupo entero que quieres estudiar (ejemplo: los 500 empleados de una empresa). |
Términos
| población | El grupo entero sobre el que de verdad quieres saber, como «todas las personas con derecho a voto del país» o «los 500 empleados». |
| muestra | La parte de la población que eliges para estudiarla de verdad. El número de personas o de unidades de la muestra se llama tamaño de la muestra. |
| muestreo aleatorio | Elegir la muestra de modo que todas las personas de la población tengan la misma probabilidad de ser elegidas, como sacar nombres de un sombrero. Las fórmulas de esta página suponen un muestreo aleatorio y no sirven para encuestas en las que solo responden las personas que quieren. |
| proporción poblacional | La proporción que de verdad quieres conocer, como la parte de «sí» en toda la población. La proporción que obtienes de una muestra se llama proporción muestral, para distinguirlas. |
| nivel de confianza | El grado de seguridad que puedes tener: si repitieras la misma encuesta muchas veces, el porcentaje de veces en que el resultado caería dentro del margen de error. El 95 % es el que más se usa. |
| intervalo de confianza | El intervalo que obtienes cuando muestras el resultado de una encuesta con una cierta anchura, como en «52 % ± 3 % (del 49 % al 55 %)». El margen de error ±ε de esta página es esa anchura. |
| margen de error (error máximo admisible) | La diferencia que permites entre el resultado de la encuesta y el valor verdadero. Es lo que quieren decir las encuestas de opinión de las noticias con «un margen de error de ±3 puntos». |
| corrección para poblaciones finitas | Una corrección que reduce el tamaño de muestra necesario o el margen de error cuando sabes que la población tiene un tamaño limitado. Refleja el hecho de que cuanta más parte de la población estudias, más seguro es el resultado. |
Qué conviene saber de antemano
Esto es lo que te ayuda a usar el cálculo de esta página entendiendo de verdad lo que haces, y no solo pulsando el botón.
| Porcentajes y proporciones (5.º y 6.º de Primaria, 10-12 años) |
|
| Raíces cuadradas (2.º de ESO, 13-14 años) |
|
| Muestreo aleatorio (3.º de ESO, 14-15 años) |
|
| La distribución normal y la inferencia estadística (2.º de Bachillerato, 17-18 años) |
|
Cómo calcularlo con Excel
| Valor z (1,96 para el 95 %) | 1,96 |
| Proporción esperada (%) | 50 |
| Margen de error (%) | 5 |
| Valor calculado n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Tamaño de muestra necesario (redondeado hacia arriba) | =REDONDEAR.MAS(B4;0) |
| Valor z (1,96 para el 95 %) | 1,96 |
| Proporción esperada (%) | 50 |
| Margen de error (%) | 5 |
| Tamaño de la población N | 500 |
| Valor antes de la corrección n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Tamaño de muestra necesario (corregido, redondeado hacia arriba) | =REDONDEAR.MAS(B5/(1+(B5-1)/B4);0) |
| Valor z (1,96 para el 95 %) | 1,96 |
| Proporción obtenida en la encuesta (%) | 60 |
| Tamaño de la muestra n | 100 |
| Margen de error (%) | =B1*RAIZ(B2/100*(1-B2/100)/B3)*100 |
| Valor z (1,96 para el 95 %) | 1,96 |
| Proporción obtenida en la encuesta (%) | 30 |
| Tamaño de la muestra n | 200 |
| Tamaño de la población N | 1000 |
| Margen de error antes de la corrección (%) | =B1*RAIZ(B2/100*(1-B2/100)/B3)*100 |
| Margen de error corregido (%) | =B5*RAIZ((B4-B3)/(B4-1)) |
En la primera tabla, B4 muestra 384,16 y B5 muestra 385. La respuesta de la segunda tabla es 218, la de la tercera, aproximadamente 9,60 (%) y la de la cuarta, aproximadamente 5,68 (%).
«^» es una potencia (al cuadrado), «RAIZ» es la raíz cuadrada y «REDONDEAR.MAS» es la función para redondear hacia arriba.
Ten en cuenta que la calculadora de esta página suma uno más por seguridad incluso cuando el valor calculado es exactamente un número entero, así que en esos valores redondos puede diferir de REDONDEAR.MAS de Excel en 1.
Cómo calcularlo con Hojas de cálculo de Google
| Valor z (1,96 para el 95 %) | 1,96 |
| Proporción esperada (%) | 50 |
| Margen de error (%) | 5 |
| Valor calculado n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Tamaño de muestra necesario (redondeado hacia arriba) | =REDONDEAR.MAS(B4;0) |
| Valor z (1,96 para el 95 %) | 1,96 |
| Proporción esperada (%) | 50 |
| Margen de error (%) | 5 |
| Tamaño de la población N | 500 |
| Valor antes de la corrección n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Tamaño de muestra necesario (corregido, redondeado hacia arriba) | =REDONDEAR.MAS(B5/(1+(B5-1)/B4);0) |
| Valor z (1,96 para el 95 %) | 1,96 |
| Proporción obtenida en la encuesta (%) | 60 |
| Tamaño de la muestra n | 100 |
| Margen de error (%) | =B1*RAIZ(B2/100*(1-B2/100)/B3)*100 |
| Valor z (1,96 para el 95 %) | 1,96 |
| Proporción obtenida en la encuesta (%) | 30 |
| Tamaño de la muestra n | 200 |
| Tamaño de la población N | 1000 |
| Margen de error antes de la corrección (%) | =B1*RAIZ(B2/100*(1-B2/100)/B3)*100 |
| Margen de error corregido (%) | =B5*RAIZ((B4-B3)/(B4-1)) |
Cómo calcularlo con Python
import math

# Tabla rápida del nivel de confianza (%) al valor z (valores redondeados de uso común)
z_table = {80: 1.28, 85: 1.44, 90: 1.65, 95: 1.96, 98: 2.33, 99: 2.58}

# ---- Forma 1: hallar el tamaño de muestra necesario ----
confidence_level = 95    # nivel de confianza (%)
population_ratio = 50    # proporción esperada (%)
margin_of_error = 5      # margen de error (%)
population_size = None   # tamaño de la población (None si no se conoce o es muy grande)

z = z_table[confidence_level]
p = population_ratio / 100
e = margin_of_error / 100

raw_size = z ** 2 * p * (1 - p) / e ** 2   # valor antes de la corrección
if population_size is not None:
    raw_size = raw_size / (1 + (raw_size - 1) / population_size)   # corrección para poblaciones finitas
required_size = math.floor(raw_size) + 1   # el menor número entero por encima del valor calculado (redondeado hacia arriba por seguridad)
print(f"Tamaño de muestra necesario: {required_size}")

# ---- Forma 2: hallar el margen de error ----
sample_size = 1000       # tamaño de la muestra encuestada de verdad
sample_ratio = 50 / 100  # proporción obtenida en la encuesta (0,5 para el 50 %)

error_ratio = z * math.sqrt(sample_ratio * (1 - sample_ratio) / sample_size)
print(f"Margen de error: ±{error_ratio * 100:.2f} %")
La fórmula en LaTeX y otras notaciones matemáticas (para copiar)
n₀ = z² × p̂(1 − p̂) ÷ ε²
n_0 = \dfrac{z^2 \, \hat{p}(1-\hat{p})}{\varepsilon^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>n</mi><mn>0</mn></msub>
<mo>=</mo>
<mfrac>
<mrow>
<msup><mi>z</mi><mn>2</mn></msup>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<msup><mi>ε</mi><mn>2</mn></msup>
</mfrac>
</mrow>
</math>
n_0 = (z^2 hat(p)(1 - hat(p)))/(epsilon^2)
z^2*p*(1 - p)/err^2
n0 := z^2*p*(1 - p)/err^2;
n0 = z^2*p*(1 - p)/err^2;
n_0 = (z^2 p̂(1 − p̂))/ε^2
n = n₀ ÷ (1 + (n₀ − 1) ÷ N)
n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msub><mi>n</mi><mn>0</mn></msub>
<mrow>
<mn>1</mn><mo>+</mo>
<mfrac>
<mrow><msub><mi>n</mi><mn>0</mn></msub><mo>−</mo><mn>1</mn></mrow>
<mi>N</mi>
</mfrac>
</mrow>
</mfrac>
</mrow>
</math>
n = n_0/(1 + (n_0 - 1)/N)
n0/(1 + (n0 - 1)/nPop)
n := n0/(1 + (n0 - 1)/N);
n = n0/(1 + (n0 - 1)/N);
n = n_0/(1 + (n_0 − 1)/N)
ε = z × √(p̂(1 − p̂) ÷ n)
\varepsilon = z \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<mi>z</mi>
<msqrt>
<mfrac>
<mrow>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<mi>n</mi>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = z sqrt((hat(p)(1 - hat(p)))/n)
z*Sqrt[p*(1 - p)/n]
err := z*sqrt(p*(1 - p)/n);
err = z*sqrt(p*(1 - p)/n);
ε = z√((p̂(1 − p̂))/n)
ε = ε₀ × √((N − n) ÷ (N − 1))
\varepsilon = \varepsilon_0 \sqrt{\dfrac{N-n}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<msub><mi>ε</mi><mn>0</mn></msub>
<msqrt>
<mfrac>
<mrow><mi>N</mi><mo>−</mo><mi>n</mi></mrow>
<mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = epsilon_0 sqrt((N - n)/(N - 1))
err0*Sqrt[(nPop - n)/(nPop - 1)]
err := err0*sqrt((N - n)/(N - 1));
err = err0*sqrt((N - n)/(N - 1));
ε = ε_0 √((N − n)/(N − 1))
Cómo pedirle a ChatGPT que haga el cálculo
Eres un asistente de cálculo para encuestas estadísticas. Haz el siguiente cálculo ejecutando realmente código de Python y basa tu respuesta solo en los números del resultado de la ejecución (no respondas con cálculo mental ni suposiciones).

Un servicio con 1000 socios hace una encuesta de satisfacción. Usa un nivel de confianza del 95 % (valor z 1,96), una proporción esperada del 50 % y un margen de error de ±5 %.
Halla cada uno de estos valores:
1. El tamaño de muestra necesario cuando la población se considera muy grande (el valor calculado y el número de personas tras redondear hacia arriba)
2. El tamaño de muestra necesario con la corrección para poblaciones finitas para una población de 1000
3. El margen de error (con la corrección para poblaciones finitas, en %) si solo responden 200 personas

Muestra las fórmulas que has usado y los números del resultado de la ejecución.
Cómo usar
-
1Introduce los númerosEscribe en los campos los números con los que quieres calcular
-
2CalculaHaz clic en el botón «Calcular»
-
3Consulta el resultadoEl resultado aparece al instante. En la misma página también encontrarás el desarrollo del cálculo y la explicación de la fórmula
Las ventajas de DataChef

Sin conocimientos técnicos: fácil e intuitivo

Sin necesidad de dar datos personales

Los archivos se borran automáticamente tras la descarga


Sin necesidad de atribución

Sin necesidad de pedir permiso
Funciones relacionadas
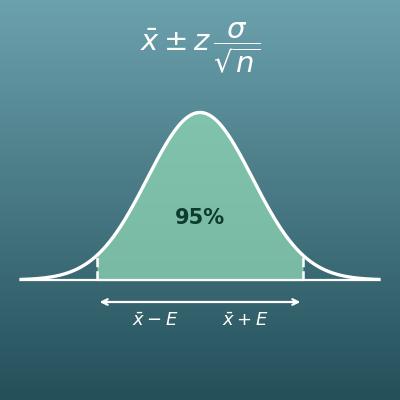
Calculadora de intervalo de confianza para la media poblacional
Halla un intervalo de confianza (como un intervalo de confianza del 95 %) para una media
Calculadora de puntuación z: de z a probabilidad y al revés
Halla el valor z a partir de un valor, la media y la desviación típica, y conviértelo en probabilidad y al revés

Calculadora de probabilidad de la distribución normal
A partir de la media y la desviación típica, calcula la probabilidad de caer en un intervalo dado