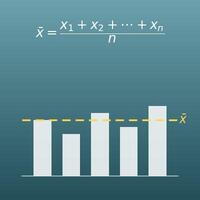

Escribe los números cuya dispersión quieres medir, separados por punto y coma (;). Se calculan a la vez la desviación típica poblacional σ y la muestral s, junto con la media, las varianzas y la suma de cuadrados de las desviaciones.
Índice
-
Qué puedes hacer en esta página
-
¿Para qué sirve este cálculo?
-
Cómo usar
-
Fórmulas y figuras
-
Símbolos y términos
-
Conviene saber antes de empezar
-
Cómo calcularlo en Excel
-
Cómo calcularlo en Hojas de cálculo de Google
-
Cómo calcularlo en Python
-
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
-
Cómo pedirle el cálculo a ChatGPT
-
Las ventajas de DataChef
-
Funciones relacionadas
-
Lista de calculadoras de NumberChef
Qué puedes hacer en esta página
- Escribe los datos separados por punto y coma (;) y obtienes al momento la desviación típica (también llamada desviación estándar)
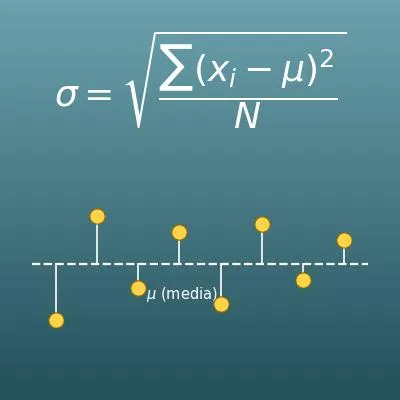
- Muestra a la vez la desviación típica poblacional \(\sigma\) (se divide entre \(N\)) y la muestral \(s\) (se divide entre \(N-1\))
- También calcula la media \(\mu\), la suma de cuadrados de las desviaciones \(\sum (x_i-\mu)^2\) y las varianzas \(\sigma^2\) y \(s^2\), así que puedes seguir cada paso de un vistazo
- En la misma página tienes la explicación sencilla de las fórmulas y las fórmulas listas para copiar en Excel, Hojas de cálculo de Google y Python
¿Para qué sirve este cálculo?
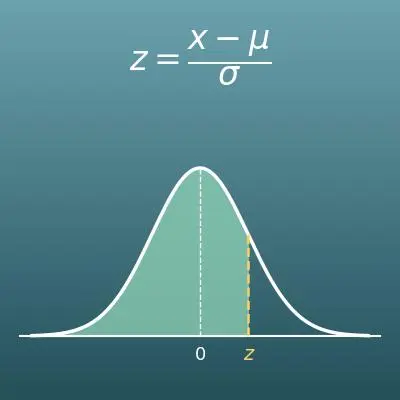
La puntuación z (o puntuación típica) dice a cuántas desviaciones típicas está una nota de la media: \(z = \dfrac{x - \text{media}}{\text{desviación típica}}\). La desviación típica está justo en el denominador.
Si en un examen la media de la clase es un 6 y la desviación típica es 1,5, un 8,4 tiene \(z = (8{,}4 - 6) \div 1{,}5 = 1{,}6\): está 1,6 desviaciones típicas por encima de la media. Así se explica por qué la misma nota destaca más en un examen en el que casi todos sacan notas parecidas (poca dispersión).
Por muy precisa que sea la fabricación, la longitud de los tornillos o el peso de las piezas varía un poco. En las fábricas se mide esa variación con la desviación típica y se controla el proceso para que «la media ± 3 desviaciones típicas» quede dentro de las especificaciones del cliente.
Cuanto menor es la desviación típica, más uniformes y mejores son los productos. Es una medida tan básica que mejorar la calidad consiste, casi literalmente, en hacerla más pequeña.
Dos inversiones pueden tener la misma rentabilidad media, un 5 %, pero la que tiene mayor desviación típica en sus rentabilidades tendrá años de grandes subidas y años de grandes caídas, así que se considera más arriesgada.
En finanzas, la desviación típica de las rentabilidades se llama volatilidad y es la medida de riesgo más habitual (aparece, por ejemplo, en la ficha de los fondos de inversión). Para decidir bien con el dinero, mira la dispersión además de la media.
Dos ciudades pueden tener la misma temperatura media anual. Si la desviación típica de sus temperaturas mensuales es pequeña, el clima es suave todo el año (como en la costa); si es grande, hay mucha diferencia entre el verano y el invierno (como en el interior peninsular).
La desviación típica convierte en un número «estable o cambiante», algo que la media sola no muestra. Se usa para comparar climas y para planificar cultivos y turismo.
Los valores de referencia que aparecen en un análisis de sangre se fijan a veces con los datos de muchas personas sanas, tomando más o menos «la media ± 2 desviaciones típicas» (en la práctica, cada prueba usa un método adaptado a la forma de su distribución).
Conocer la desviación típica ayuda a mantener la calma: salirse un poco del rango de referencia no significa estar enfermo, porque una parte de las personas sanas también queda fuera.
Fórmulas y figuras
Símbolos y términos
Símbolos
| \(x_1, x_2, \ldots, x_N\) | x sub uno, x sub dos, …, x sub ene | Cada uno de los datos cuya dispersión quieres medir (por ejemplo, las notas de un examen de 8 alumnos). |
| \(N\) | ene | El número de datos (por ejemplo, con 8 alumnos, \(N = 8\)). |
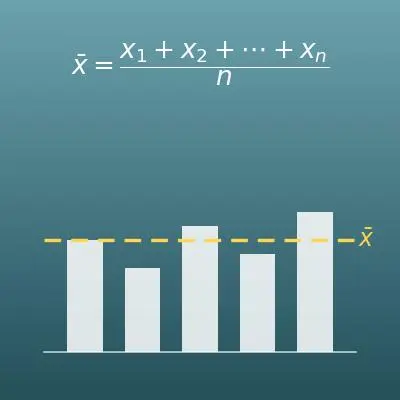
| \(\mu\) | mu | La media. Esta letra griega representa la media de una población. La de una muestra se escribe \(\bar{x}\) («x barra»), pero se calcula igual. |
| \(x_i - \mu\) | x sub i menos mu | La desviación. Indica cuánto se aleja cada dato de la media. |
| \(S\) | ese | La suma de cuadrados de las desviaciones, \(\sum (x_i-\mu)^2\): cada desviación al cuadrado y todas sumadas. De ella salen la varianza y la desviación típica. |
| \(\sigma^2\) | sigma al cuadrado | La varianza poblacional: la suma de cuadrados de las desviaciones dividida entre el número de datos \(N\). |
| \(\sigma\) | sigma | La desviación típica poblacional, raíz cuadrada de la varianza poblacional. Es el símbolo más conocido de la dispersión. |
| \(s^2\) | ese al cuadrado | La varianza muestral (cuasivarianza): la suma de cuadrados de las desviaciones dividida entre \(N-1\). |
| \(s\) | ese | La desviación típica muestral, raíz cuadrada de la varianza muestral. |
| \(\sum\) | sumatorio (sigma mayúscula) | Símbolo que significa «sumar todo». \(\sum_{i=1}^{N} x_i\) es la suma desde \(x_1\) hasta \(x_N\). |
Términos
| desviación típica | Número que indica cuánto se dispersan los datos alrededor de la media. Es la raíz cuadrada de la varianza y tiene la misma unidad que los datos, así que sirve muy bien como «separación típica respecto a la media». Es la medida de dispersión más usada. También se llama desviación estándar. |
| varianza | La media de las desviaciones al cuadrado (las diferencias entre cada dato y la media). Mide el tamaño de la dispersión, pero su unidad está al cuadrado, así que lo normal es sacar la raíz cuadrada y usar la desviación típica. |
| desviación | La diferencia entre un dato y la media (\(x_i - \mu\)). Si es positiva, el dato está por encima de la media; si es negativa, por debajo. Sumadas tal cual siempre dan 0, por eso se elevan al cuadrado antes de usarlas. |
| suma de cuadrados de las desviaciones | Las desviaciones elevadas al cuadrado y sumadas. La varianza y la desviación típica salen todas de este valor. |
| población | Todo el grupo que quieres estudiar. Si tus datos son el grupo completo, usa la desviación típica poblacional \(\sigma\). |
| muestra | Parte de los datos tomada de una población (el grupo completo). Para estimar la dispersión del grupo completo a partir de una muestra, usa la desviación típica muestral \(s\). |
| cuasivarianza | La varianza que se usa para estimar la de una población a partir de una muestra (también llamada varianza muestral corregida). Se divide la suma de cuadrados de las desviaciones entre \(N-1\): dividir entre \(N\) daría una dispersión de la población demasiado pequeña, y dividir entre un número una unidad menor lo corrige. |
| corrección de Bessel | Dividir entre \(N-1\) en lugar de entre \(N\) al calcular la varianza muestral. A \(N-1\) también se le llama grados de libertad. |
Conviene saber antes de empezar
Esto es lo que te ayuda a usar el cálculo de esta página entendiendo lo que hace, no solo pulsando el botón.
| La media (5.º-6.º de Primaria, 10-12 años) |
|
| Números enteros y paréntesis (1.º de ESO, 12-13 años) |
|
| Potencias (1.º de ESO, 12-13 años) |
|
| Raíces cuadradas (1.º-2.º de ESO, 12-14 años) |
|
| Estadística, parámetros de dispersión (de 3.º de ESO a Bachillerato, 14-18 años) |
|
Cómo calcularlo en Excel
| Dato 1 | 10 |
| Dato 2 | 12 |
| Dato 3 | 23 |
| Dato 4 | 23 |
| Dato 5 | 16 |
| Dato 6 | 23 |
| Dato 7 | 21 |
| Dato 8 | 16 |
| Número de datos N | =CONTAR(B1:B8) |
| Suma Σx | =SUMA(B1:B8) |
| Media μ | =PROMEDIO(B1:B8) |
| Dato 1 | 10 |
| Dato 2 | 12 |
| Dato 3 | 23 |
| Dato 4 | 23 |
| Dato 5 | 16 |
| Dato 6 | 23 |
| Dato 7 | 21 |
| Dato 8 | 16 |
| Suma de cuadrados de las desviaciones S | =DESVIA2(B1:B8) |
| Dato 1 | 10 |
| Dato 2 | 12 |
| Dato 3 | 23 |
| Dato 4 | 23 |
| Dato 5 | 16 |
| Dato 6 | 23 |
| Dato 7 | 21 |
| Dato 8 | 16 |
| Varianza poblacional σ² | =VARP(B1:B8) |
| Desviación típica poblacional σ | =DESVESTP(B1:B8) |
| Dato 1 | 10 |
| Dato 2 | 12 |
| Dato 3 | 23 |
| Dato 4 | 23 |
| Dato 5 | 16 |
| Dato 6 | 23 |
| Dato 7 | 21 |
| Dato 8 | 16 |
| Varianza muestral s² | =VAR(B1:B8) |
| Desviación típica muestral s | =DESVEST(B1:B8) |
En la primera tabla, la media μ sale 18. En la tercera, la desviación típica poblacional σ es de unos 4,899, y en la cuarta, la muestral s es de unos 5,237.
Si tienes otro número de datos, añade (o quita) filas y cambia «B1:B8» en las fórmulas por tu rango real (con 10 datos, B1:B10).
DESVESTP y VARP, con «P», son para una población (entre N). DESVEST y VAR, sin «P», son para una muestra (entre N − 1). DESVIA2 da la suma de cuadrados de las desviaciones de una vez.
Cómo calcularlo en Hojas de cálculo de Google
| Dato 1 | 10 |
| Dato 2 | 12 |
| Dato 3 | 23 |
| Dato 4 | 23 |
| Dato 5 | 16 |
| Dato 6 | 23 |
| Dato 7 | 21 |
| Dato 8 | 16 |
| Número de datos N | =CONTAR(B1:B8) |
| Suma Σx | =SUMA(B1:B8) |
| Media μ | =PROMEDIO(B1:B8) |
| Dato 1 | 10 |
| Dato 2 | 12 |
| Dato 3 | 23 |
| Dato 4 | 23 |
| Dato 5 | 16 |
| Dato 6 | 23 |
| Dato 7 | 21 |
| Dato 8 | 16 |
| Suma de cuadrados de las desviaciones S | =DESVIA2(B1:B8) |
| Dato 1 | 10 |
| Dato 2 | 12 |
| Dato 3 | 23 |
| Dato 4 | 23 |
| Dato 5 | 16 |
| Dato 6 | 23 |
| Dato 7 | 21 |
| Dato 8 | 16 |
| Varianza poblacional σ² | =VARP(B1:B8) |
| Desviación típica poblacional σ | =DESVESTP(B1:B8) |
| Dato 1 | 10 |
| Dato 2 | 12 |
| Dato 3 | 23 |
| Dato 4 | 23 |
| Dato 5 | 16 |
| Dato 6 | 23 |
| Dato 7 | 21 |
| Dato 8 | 16 |
| Varianza muestral s² | =VAR(B1:B8) |
| Desviación típica muestral s | =DESVEST(B1:B8) |
También aquí DESVESTP y VARP sirven para una población, y DESVEST y VAR para una muestra.
Cómo calcularlo en Python
import statistics

numbers = [10, 12, 23, 23, 16, 23, 21, 16]  # los datos cuya dispersión quieres medir

mean = statistics.mean(numbers)               # media μ
pstdev = statistics.pstdev(numbers)           # desviación típica poblacional σ (entre N)
pvariance = statistics.pvariance(numbers)     # varianza poblacional σ²
sstdev = statistics.stdev(numbers)            # desviación típica muestral s (entre N-1)
svariance = statistics.variance(numbers)      # varianza muestral s²

print(f"Número de datos: {len(numbers)} / Suma: {sum(numbers)} / Media: {mean}")
print(f"Varianza poblacional σ²: {pvariance} / Desviación típica poblacional σ: {pstdev}")
print(f"Varianza muestral s²: {svariance} / Desviación típica muestral s: {sstdev}")
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
μ = Σxᵢ ÷ N
\mu = \frac{x_1 + x_2 + \cdots + x_N}{N}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>μ</mi>
<mo>=</mo>
<mfrac>
<mrow>
<msub><mi>x</mi><mn>1</mn></msub>
<mo>+</mo>
<msub><mi>x</mi><mn>2</mn></msub>
<mo>+</mo>
<mo>⋯</mo>
<mo>+</mo>
<msub><mi>x</mi><mi>N</mi></msub>
</mrow>
<mi>N</mi>
</mfrac>
</mrow>
</math>
mu = (x_1 + x_2 + cdots + x_N) / N
Mean[data]
mu := add(x[i], i = 1 .. N)/N;
mu = mean(x);
μ = (x_1 + x_2 + ⋯ + x_N)/N
S = Σ(xᵢ − μ)²
S = \sum_{i=1}^{N} (x_i - \mu)^2
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>S</mi>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>1</mn></mrow>
<mi>N</mi>
</munderover>
<msup>
<mrow><mo>(</mo><msub><mi>x</mi><mi>i</mi></msub><mo>−</mo><mi>μ</mi><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mrow>
</math>
S = sum_(i=1)^N (x_i - mu)^2
Total[(data - Mean[data])^2]
S := add((x[i] - mu)^2, i = 1 .. N);
S = sum((x - mean(x)).^2);
S = ∑_(i=1)^N (x_i − μ)^2
σ² = S ÷ N ; s² = S ÷ (N − 1)
\sigma^2 = \frac{S}{N}, \qquad s^2 = \frac{S}{N-1}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msup><mi>σ</mi><mn>2</mn></msup>
<mo>=</mo>
<mfrac><mi>S</mi><mi>N</mi></mfrac>
<mo>,</mo>
<mspace width="1em"/>
<msup><mi>s</mi><mn>2</mn></msup>
<mo>=</mo>
<mfrac><mi>S</mi><mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow></mfrac>
</mrow>
</math>
sigma^2 = S/N, s^2 = S/(N-1)
popVar = S/n; sampleVar = Variance[data] (* N es una función propia de Mathematica, así que el número de datos se llama n *)
sigma2 := S/N; s2 := S/(N - 1);
popVar = S/N; sampleVar = var(x);
σ^2 = S/N, s^2 = S/(N−1)
σ = √(σ²) ; s = √(s²)
\sigma = \sqrt{\sigma^2} = \sqrt{\dfrac{S}{N}}, \qquad s = \sqrt{s^2} = \sqrt{\dfrac{S}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>σ</mi>
<mo>=</mo>
<msqrt><mfrac><mi>S</mi><mi>N</mi></mfrac></msqrt>
<mo>,</mo>
<mspace width="1em"/>
<mi>s</mi>
<mo>=</mo>
<msqrt><mfrac><mi>S</mi><mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow></mfrac></msqrt>
</mrow>
</math>
sigma = sqrt(S/N), s = sqrt(S/(N-1))
popSD = Sqrt[S/n]; sampleSD = StandardDeviation[data] (* N es una función propia de Mathematica, así que el número de datos se llama n *)
sigma := sqrt(S/N); s := sqrt(S/(N - 1));
popSD = sqrt(S/numel(x)); sampleSD = std(x);
σ = √(S/N), s = √(S/(N−1))
Cómo pedirle el cálculo a ChatGPT
Eres un asistente de cálculo estadístico. Haz el siguiente cálculo ejecutando de verdad código de Python y basa tu respuesta solo en los números del resultado de la ejecución (no respondas calculando de cabeza ni a ojo).

Para los datos siguientes, calcula cada uno de estos valores.
Datos: 10 ; 12 ; 23 ; 23 ; 16 ; 23 ; 21 ; 16
1. El número de datos, la suma y la media
2. La suma de cuadrados de las desviaciones (la diferencia de cada dato con la media, al cuadrado y sumadas)
3. La varianza poblacional σ² (entre N) y la desviación típica poblacional σ
4. La varianza muestral s² (entre N − 1) y la desviación típica muestral s

Indica las fórmulas que has usado y los números del resultado de la ejecución.
Cómo usar
-
1Introduce los datosEscribe en las casillas los números con los que quieres calcular
-
2CalculaPulsa el botón «Calcular»
-
3Consulta el resultadoEl resultado aparece al instante. En la misma página tienes también la idea del cálculo y la explicación de la fórmula
Las ventajas de DataChef

Sin conocimientos técnicos: fácil e intuitivo
Sin necesidad de dar datos personales
Los archivos se borran automáticamente tras la descarga
Sin necesidad de atribución
Sin necesidad de pedir permiso
Funciones relacionadas
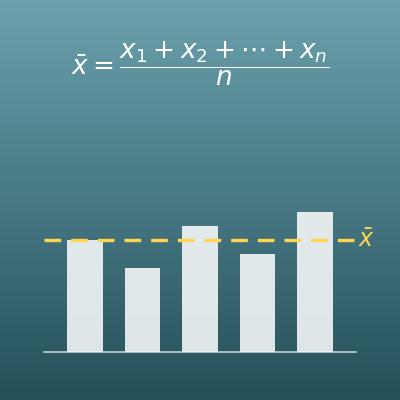
Calculadora de la media (media aritmética)
Calcula la media, la mediana, la media geométrica y más a partir de una lista de números
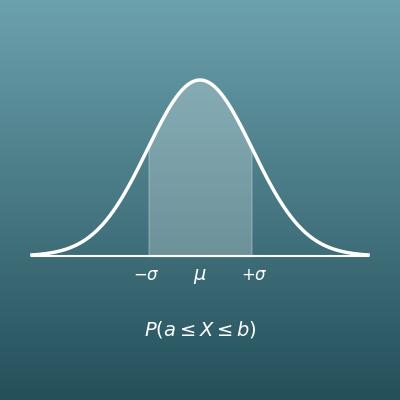
Calculadora de probabilidades de la distribución normal
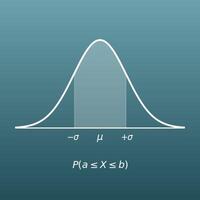
Calcula la probabilidad de caer en un intervalo a partir de la media y la desviación típica
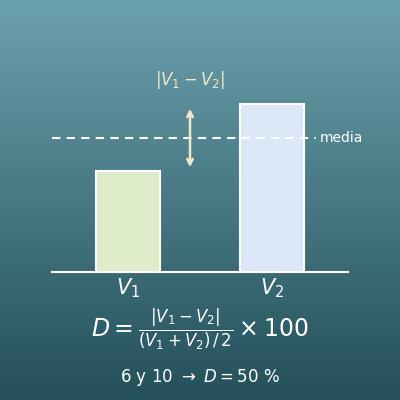
Calculadora de diferencia porcentual
Expresa la diferencia entre dos valores como porcentaje de su media