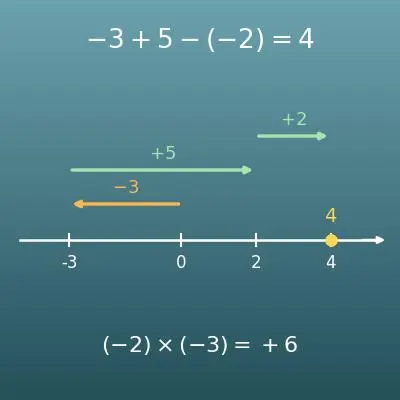
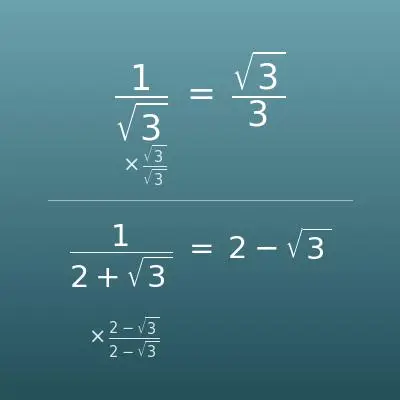
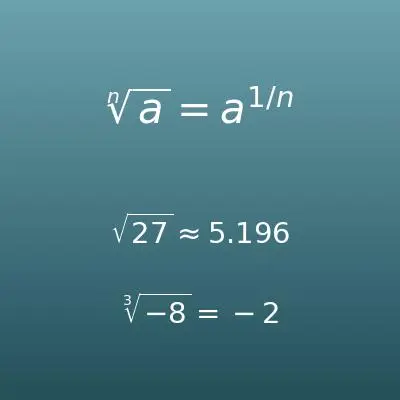
散らばり(ばらつき)を調べたい数値を、カンマ(,)区切りで入力してください。母標準偏差σと標本標準偏差sを、平均・分散・偏差平方和と一緒にまとめて計算します。
このページでできること
- 数値をカンマ(,)区切りで入れるだけで、標準偏差がその場でわかります
- 母標準偏差 \(\sigma\)(\(N\) で割る)と標本標準偏差 \(s\)(\(N-1\) で割る)を、両方まとめて表示します
- 平均 \(\mu\)・偏差平方和 \(\sum (x_i-\mu)^2\)・分散 \(\sigma^2,\ s^2\) も同時に計算するので、求め方の途中まで一目で追えます
- 式のやさしい解説・Excel/Googleスプレッドシート/Python用のコピペ数式・計算ドリル(演習問題)もこのページにまとまっています
この計算は何の役に立つ?
受験でおなじみの偏差値は、\(\text{偏差値} = 50 + 10 \times \dfrac{x - \text{平均}}{\text{標準偏差}}\) という式で計算され、標準偏差がそのまま分母に入っています。
「平均から標準偏差1つ分だけ上」なら偏差値60、というしくみです。標準偏差がわかると、同じ点数でもテストの難しさ(散らばり)によって偏差値が変わる理由が腑に落ちます。
ねじの長さや部品の重さは、どんなに精密に作っても少しずつばらつきます。工場ではこのばらつきを標準偏差で測り、「平均 ± 標準偏差3つ分」がお客様の規格に収まるように工程を管理します。
標準偏差が小さいほど「揃った良い製品」であり、品質改善とは標準偏差を小さくしていく活動そのもの、といえるほど基本の指標です。
同じ「平均リターン5%」の2つの投資先でも、値動きの標準偏差が大きいほうは、大きく増える年もあれば大きく減る年もあり、リスクが高いと判断されます。
金融では、このリターンの標準偏差を「ボラティリティ(変動の大きさ)」と呼び、リスクの代表的なものさしとして使います。平均だけ見て決めず、標準偏差=ばらつきもあわせて見るのが、お金の大事な判断のコツです。
年間の平均気温が同じ2つの都市でも、月ごとの気温の標準偏差が小さい都市は1年を通じて穏やか、大きい都市は夏と冬の差が激しい、とわかります。
平均だけでは見えない「安定しているか・変動が大きいか」を数字にできるのが標準偏差で、気候の比較や作物・観光の計画づくりにも使われます。
健康診断の血液検査などで示される「基準範囲」は、多くの健康な人のデータを集め、その平均と標準偏差をもとに「平均 ± 標準偏差2つ分」あたりの幅として決められることがあります(実際には検査項目ごとに、分布の形に応じた方法が使われます)。
標準偏差を知っておくと、「基準範囲を少し外れた=ただちに病気」ではなく「健康な人でも一部は外れうる幅」だと落ち着いて受け止めやすくなります。
式と図
用語・記号の解説
記号
| \(x_1, x_2, \ldots, x_N\) | エックスいち、エックスに、…、エックスエヌ | 散らばりを調べたい1つ1つのデータ。(例:8人分のテストの点数) |
| \(N\) | エヌ | データの個数。(例:8人分なら \(N = 8\)) |
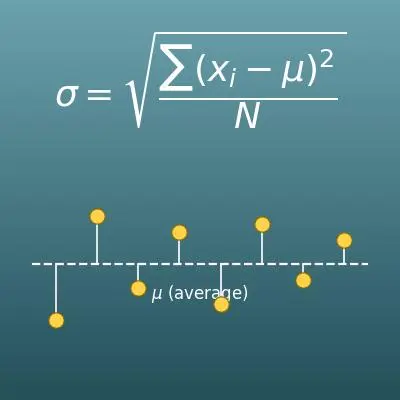
| \(\mu\) | ミュー | 平均。母集団の平均を表すギリシャ文字です。標本の平均は \(\bar{x}\)(エックスバー)と書きますが、計算のしかたは同じです。 |
| \(x_i - \mu\) | エックスアイ引くミュー | 偏差。各データが平均からどれだけ離れているか(ずれ)を表します。 |
| \(S\) | エス | 偏差平方和。各偏差を2乗して全部足した値 \(\sum (x_i-\mu)^2\) で、分散・標準偏差の材料になります。 |
| \(\sigma^2\) | シグマ2乗 | 母分散。偏差平方和を個数 \(N\) で割った値です。 |
| \(\sigma\) | シグマ | 母標準偏差。母分散の平方根で、ばらつきを表す代表的な記号です。 |
| \(s^2\) | エス2乗 | 標本分散(不偏分散)。偏差平方和を \(N-1\) で割った値です。 |
| \(s\) | エス | 標本標準偏差。標本分散の平方根です。 |
| \(\sum\) | シグマ(和の記号) | 「全部足す」という意味の記号。\(\sum_{i=1}^{N} x_i\) は \(x_1\) から \(x_N\) までの合計を表します。 |
用語
| 標準偏差 | ひょうじゅんへんさ | データが平均の周りでどれくらい散らばっているかを表す値。分散の平方根で、単位がデータと同じに戻るため「平均からの普通のずれ幅」の目安として使いやすい代表的な指標です。 |
| 分散 | ぶんさん | 偏差(各データと平均の差)を2乗して平均した値。ばらつきの大きさを表しますが、単位が2乗になるので、平方根を取って標準偏差に直して使うのが一般的です。 |
| 偏差 | へんさ | 各データと平均との差(\(x_i - \mu\))。プラスなら平均より大きい、マイナスなら小さいことを表します。そのまま全部足すと0になるため、2乗してから使います。 |
| 偏差平方和 | へんさへいほうわ | 偏差を2乗して全部足した値。分散・標準偏差はすべてこの値から作られます。 |
| 母集団 | ぼしゅうだん | 調べたい対象の全体のこと。手元のデータがこの全体そのものなら、母標準偏差 \(\sigma\) を使います。 |
| 標本 | ひょうほん | 母集団(全体)から抜き出した一部のデータ。標本から全体のばらつきを推し量るときは、標本標準偏差 \(s\) を使います。 |
| 不偏分散 | ふへんぶんさん | 標本から母集団の分散を推定するときに使う分散。偏差平方和を \(N-1\) で割ります。\(N\) で割ると母集団のばらつきを小さく見積もってしまうため、1小さい数で割って補正した値です。 |
| ベッセル補正 | ベッセルほせい | 標本分散で \(N\) ではなく \(N-1\) で割る補正のこと。\(N-1\) は自由度とも呼ばれます。 |
前提として理解しておくといいこと
このページの計算を「意味がわかって」使えるようになるために、前提として理解しておくといいことをまとめました。
| 平均(小学5年) |
|
| 正負の数・かっこの計算(中学1年) |
|
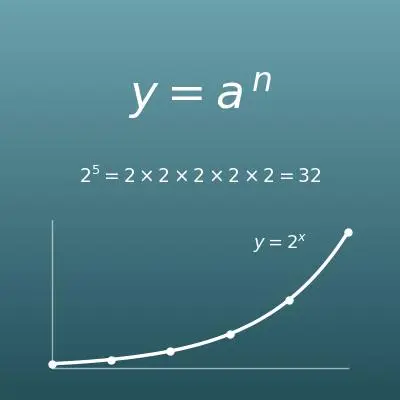
| 累乗(中学1年) |
|
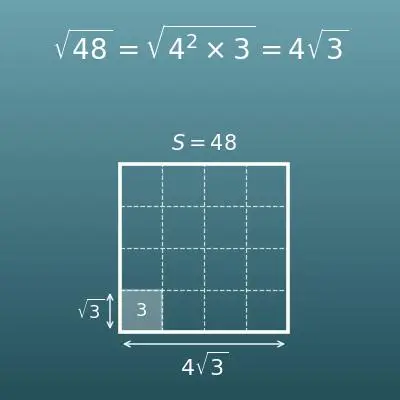
| 平方根(中学3年) |
|
| データの分布・散らばり(中学1年〜高校 数学I) |
|
Excelで計算する方法
| 1つ目の数 | 10 |
| 2つ目の数 | 12 |
| 3つ目の数 | 23 |
| 4つ目の数 | 23 |
| 5つ目の数 | 16 |
| 6つ目の数 | 23 |
| 7つ目の数 | 21 |
| 8つ目の数 | 16 |
| 個数 N | =COUNT(B1:B8) |
| 合計 Σx | =SUM(B1:B8) |
| 平均 μ | =AVERAGE(B1:B8) |
| 1つ目の数 | 10 |
| 2つ目の数 | 12 |
| 3つ目の数 | 23 |
| 4つ目の数 | 23 |
| 5つ目の数 | 16 |
| 6つ目の数 | 23 |
| 7つ目の数 | 21 |
| 8つ目の数 | 16 |
| 偏差平方和 S | =DEVSQ(B1:B8) |
| 1つ目の数 | 10 |
| 2つ目の数 | 12 |
| 3つ目の数 | 23 |
| 4つ目の数 | 23 |
| 5つ目の数 | 16 |
| 6つ目の数 | 23 |
| 7つ目の数 | 21 |
| 8つ目の数 | 16 |
| 母分散 σ² | =VARP(B1:B8) |
| 母標準偏差 σ | =STDEVP(B1:B8) |
| 1つ目の数 | 10 |
| 2つ目の数 | 12 |
| 3つ目の数 | 23 |
| 4つ目の数 | 23 |
| 5つ目の数 | 16 |
| 6つ目の数 | 23 |
| 7つ目の数 | 21 |
| 8つ目の数 | 16 |
| 標本分散 s² | =VAR(B1:B8) |
| 標本標準偏差 s | =STDEV(B1:B8) |
1つ目の表では、平均μに18が表示されます。3つ目の表の母標準偏差σは約4.899、4つ目の表の標本標準偏差sは約5.237です。
データの個数を変えたいときは、数値の行を増やし(減らし)てから、式の「B1:B8」の部分を実際のデータ範囲(例:10個なら B1:B10)に書き換えてください。
「P」が付くSTDEVP・VARPが母集団用(N で割る)、付かないSTDEV・VARが標本用(N−1 で割る)です。DEVSQは偏差平方和を一発で出す関数です。
Googleスプレッドシートで計算する方法
| 1つ目の数 | 10 |
| 2つ目の数 | 12 |
| 3つ目の数 | 23 |
| 4つ目の数 | 23 |
| 5つ目の数 | 16 |
| 6つ目の数 | 23 |
| 7つ目の数 | 21 |
| 8つ目の数 | 16 |
| 個数 N | =COUNT(B1:B8) |
| 合計 Σx | =SUM(B1:B8) |
| 平均 μ | =AVERAGE(B1:B8) |
| 1つ目の数 | 10 |
| 2つ目の数 | 12 |
| 3つ目の数 | 23 |
| 4つ目の数 | 23 |
| 5つ目の数 | 16 |
| 6つ目の数 | 23 |
| 7つ目の数 | 21 |
| 8つ目の数 | 16 |
| 偏差平方和 S | =DEVSQ(B1:B8) |
| 1つ目の数 | 10 |
| 2つ目の数 | 12 |
| 3つ目の数 | 23 |
| 4つ目の数 | 23 |
| 5つ目の数 | 16 |
| 6つ目の数 | 23 |
| 7つ目の数 | 21 |
| 8つ目の数 | 16 |
| 母分散 σ² | =VARP(B1:B8) |
| 母標準偏差 σ | =STDEVP(B1:B8) |
| 1つ目の数 | 10 |
| 2つ目の数 | 12 |
| 3つ目の数 | 23 |
| 4つ目の数 | 23 |
| 5つ目の数 | 16 |
| 6つ目の数 | 23 |
| 7つ目の数 | 21 |
| 8つ目の数 | 16 |
| 標本分散 s² | =VAR(B1:B8) |
| 標本標準偏差 s | =STDEV(B1:B8) |
Googleスプレッドシートでも、母集団用はSTDEVP/VARP、標本用はSTDEV/VARで同じように計算できます。
Pythonで計算する方法
import statistics

numbers = [10, 12, 23, 23, 16, 23, 21, 16]  # ばらつきを調べたい数値

mean = statistics.mean(numbers)               # 平均 μ
pstdev = statistics.pstdev(numbers)           # 母標準偏差 σ(N で割る)
pvariance = statistics.pvariance(numbers)     # 母分散 σ²
sstdev = statistics.stdev(numbers)            # 標本標準偏差 s(N−1 で割る)
svariance = statistics.variance(numbers)      # 標本分散(不偏分散)s²

print(f"個数: {len(numbers)} / 合計: {sum(numbers)} / 平均: {mean}")
print(f"母分散 σ²: {pvariance} / 母標準偏差 σ: {pstdev}")
print(f"標本分散 s²: {svariance} / 標本標準偏差 s: {sstdev}")
数式記述言語(LaTeX等)での書き方(コピペ可)
μ = Σxᵢ ÷ N
\mu = \frac{x_1 + x_2 + \cdots + x_N}{N}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>μ</mi>
<mo>=</mo>
<mfrac>
<mrow>
<msub><mi>x</mi><mn>1</mn></msub>
<mo>+</mo>
<msub><mi>x</mi><mn>2</mn></msub>
<mo>+</mo>
<mo>⋯</mo>
<mo>+</mo>
<msub><mi>x</mi><mi>N</mi></msub>
</mrow>
<mi>N</mi>
</mfrac>
</mrow>
</math>
mu = (x_1 + x_2 + cdots + x_N) / N
Mean[data]
mu := add(x[i], i = 1 .. N)/N;
mu = mean(x);
μ = (x_1 + x_2 + ⋯ + x_N)/N
S = Σ(xᵢ − μ)²
S = \sum_{i=1}^{N} (x_i - \mu)^2
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>S</mi>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>1</mn></mrow>
<mi>N</mi>
</munderover>
<msup>
<mrow><mo>(</mo><msub><mi>x</mi><mi>i</mi></msub><mo>−</mo><mi>μ</mi><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mrow>
</math>
S = sum_(i=1)^N (x_i - mu)^2
Total[(data - Mean[data])^2]
S := add((x[i] - mu)^2, i = 1 .. N);
S = sum((x - mean(x)).^2);
S = ∑_(i=1)^N (x_i − μ)^2
σ² = S ÷ N / s² = S ÷ (N − 1)
\sigma^2 = \frac{S}{N}, \qquad s^2 = \frac{S}{N-1}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msup><mi>σ</mi><mn>2</mn></msup>
<mo>=</mo>
<mfrac><mi>S</mi><mi>N</mi></mfrac>
<mo>,</mo>
<mspace width="1em"/>
<msup><mi>s</mi><mn>2</mn></msup>
<mo>=</mo>
<mfrac><mi>S</mi><mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow></mfrac>
</mrow>
</math>
sigma^2 = S/N, s^2 = S/(N-1)
popVar = S/n; sampleVar = Variance[data] (* N(数値化関数)はMathematicaの予約語のため、データ数は n にしている *)
sigma2 := S/N; s2 := S/(N - 1);
popVar = S/N; sampleVar = var(x);
σ^2 = S/N, s^2 = S/(N−1)
σ = √(σ²) / s = √(s²)
\sigma = \sqrt{\sigma^2} = \sqrt{\dfrac{S}{N}}, \qquad s = \sqrt{s^2} = \sqrt{\dfrac{S}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>σ</mi>
<mo>=</mo>
<msqrt><mfrac><mi>S</mi><mi>N</mi></mfrac></msqrt>
<mo>,</mo>
<mspace width="1em"/>
<mi>s</mi>
<mo>=</mo>
<msqrt><mfrac><mi>S</mi><mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow></mfrac></msqrt>
</mrow>
</math>
sigma = sqrt(S/N), s = sqrt(S/(N-1))
popSD = Sqrt[S/n]; sampleSD = StandardDeviation[data] (* N(数値化関数)はMathematicaの予約語のため、データ数は n にしている *)
sigma := sqrt(S/N); s := sqrt(S/(N - 1));
popSD = sqrt(S/numel(x)); sampleSD = std(x);
σ = √(S/N), s = √(S/(N−1))
ChatGPT に聞いて計算してもらう方法
あなたは統計計算のアシスタントです。次の計算を、必ずPythonコードを実際に実行して行い、実行結果の数値だけを根拠に回答してください(暗算や推測で答えないでください)。

次のデータについて、以下の値をそれぞれ求めてください。
データ: 10, 12, 23, 23, 16, 23, 21, 16
1. 個数・合計・平均
2. 偏差平方和(各データと平均の差を2乗して全部足した値)
3. 母分散 σ²(N で割る)と母標準偏差 σ
4. 標本分散 s²(N−1 で割る)と標本標準偏差 s

計算に使った式と、実行結果の数値を示してください。
計算ドリル(演習問題)
このページの式を、自分の手で計算できるようになるための演習問題です。
答えと解説は解答ページにあります。
使い方
-
1数値を入力計算したい数値を入力欄に入力します
-
2計算「計算する」ボタンを押します
-
3結果を確認計算結果がその場に表示されます。計算の考え方や式の解説も同じページで確認できます
DataChefの特徴

専門知識不要、直感的で簡単な操作
個人情報を登録することなく使用できます
「ダウンロード」押下でファイルを自動削除
クレジット表記不要
商用利用許諾の連絡も不要です
関連機能
平均計算機(算術平均)
カンマ区切りの数値から平均・中央値・幾何平均などをまとめて計算します
正規分布の確率
平均と標準偏差から、指定した範囲に入る確率を計算します

パーセント差
2つの値の差を、平均で割って百分率(%)で表します