
























































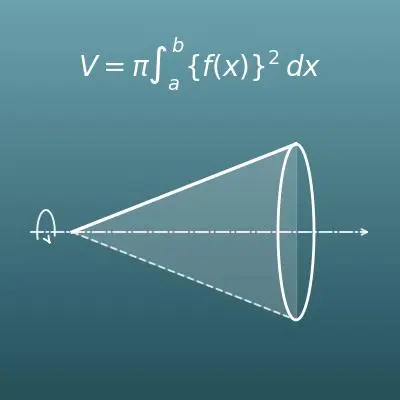


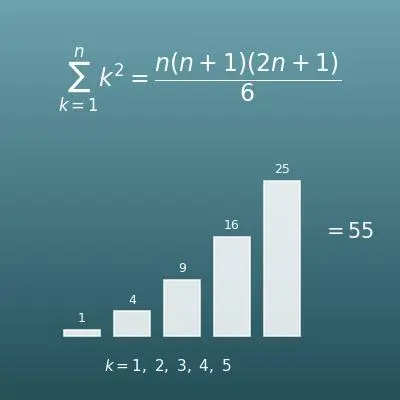






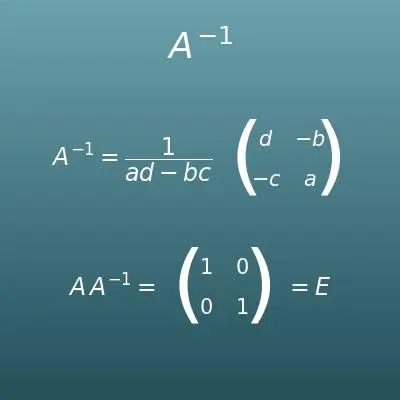






























































Bookmarks    
P値の計算    
比の計算    
行列式    
逆行列    
円の計算    
球の体積    
年齢計算    
日数計算    
曜日計算    
時差計算    
複利計算    
単利計算    
利息計算    
ROIの計算    
IRRの計算    
GDPの計算    
CAGR計算    
BMI計算機    
TDEE計算機    
1RM計算機    
露点温度    
進数変換    
給与換算    
燃費計算    
生コン量    
外壁面積    
   追加
確率・ランダムの計算ツール
2つの独立な事象の確率
2つの独立な事象の確率
2つの事象の確率(逆算)
2つの事象の確率(逆算)
くり返したときの確率
くり返したときの確率
条件付き確率・ベイズの定理
条件付き確率・ベイズの定理
期待値計算機
期待値計算機
二項分布の計算機
二項分布の計算機
順列・組み合わせ
順列・組み合わせ
円順列・じゅず順列
円順列・じゅず順列
重複順列・重複組合せ
重複順列・重複組合せ
乱数ジェネレーター
乱数ジェネレーター
平均・統計の計算ツール
平均計算機
平均計算機
代表値計算機(最頻値ほか)
代表値計算機(最頻値ほか)
標準偏差計算機
標準偏差計算機
四分位数計算機
四分位数計算機
度数分布表 計算機
度数分布表 計算機
相関係数計算機
相関係数計算機
正規分布の確率
正規分布の確率
Zスコアの計算
Zスコアの計算
信頼区間の計算
信頼区間の計算
サンプルサイズの計算
サンプルサイズの計算
標本調査の計算
標本調査の計算
P値の計算
P値の計算
割合・パーセントの計算ツール
割合・パーセントの計算
割合・パーセントの計算
増減率の計算
増減率の計算
パーセント差
パーセント差
誤差率の計算
誤差率の計算
比の計算
比の計算
割引計算機
割引計算機
消費税の計算
消費税の計算
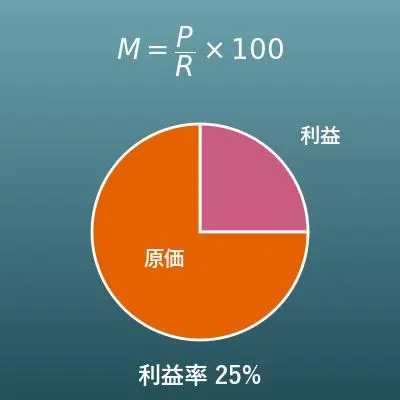
利益率計算機
利益率計算機
速さの計算ツール
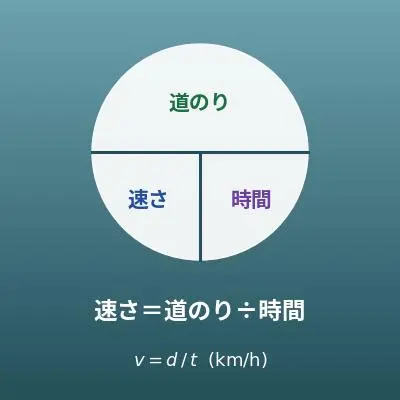
速さ計算機
速さ計算機
密度・濃度の計算ツール
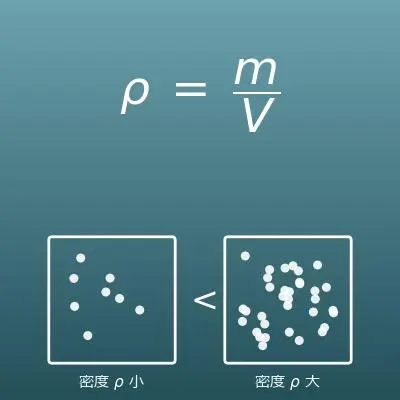
密度計算機
密度計算機
モル濃度計算機
モル濃度計算機
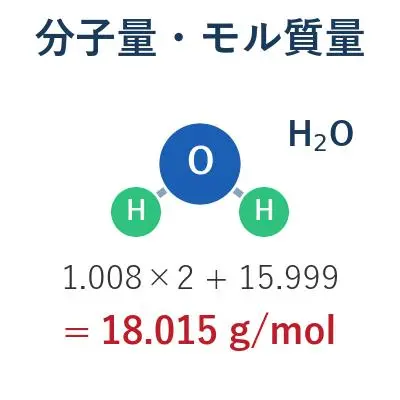
分子量・モル質量
分子量・モル質量
物理・電気工学の計算ツール
オームの法則の計算
オームの法則の計算
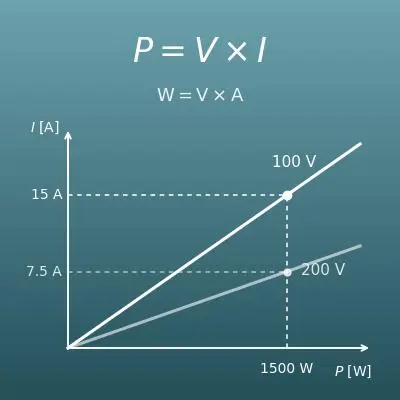
W・A・V の相互換算
W・A・V の相互換算
抵抗器カラーコードの計算
抵抗器カラーコードの計算
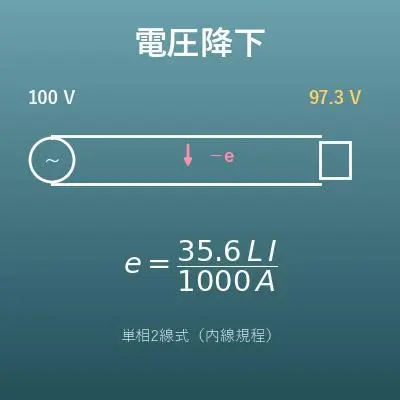
電圧降下の計算
電圧降下の計算
単位の換算の計算ツール
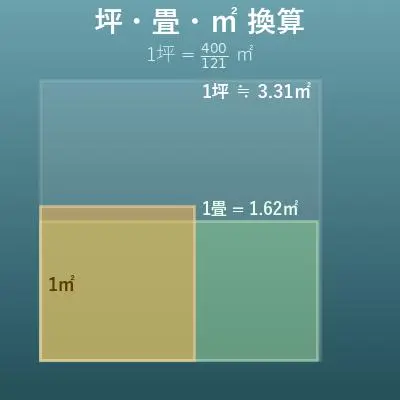
坪・畳・㎡換算
坪・畳・㎡換算
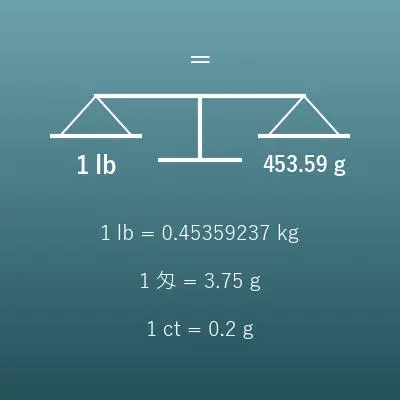
重さの単位換算
重さの単位換算
靴サイズの変換
靴サイズの変換
整数・正負の数の計算ツール
割り算の筆算(商と余り)
割り算の筆算(商と余り)
最小公倍数計算機
最小公倍数計算機
最大公約数
最大公約数
正負の数の計算機
正負の数の計算機
素因数分解
素因数分解
一次不定方程式計算機
一次不定方程式計算機
合同式・余りの計算機
合同式・余りの計算機
約数計算機
約数計算機
ローマ数字変換
ローマ数字変換
分数・小数・端数処理の計算ツール
分数計算機
分数計算機
帯分数計算機
帯分数計算機
約分計算機
約分計算機
分数から小数への変換
分数から小数への変換
小数から分数への変換
小数から分数への変換
四捨五入・切り上げ・切り捨て
四捨五入・切り上げ・切り捨て
方程式・不等式の計算ツール
一次方程式計算機
一次方程式計算機
連立方程式計算機
連立方程式計算機
二次方程式の解の公式
二次方程式の解の公式
絶対値の方程式・不等式
絶対値の方程式・不等式
二次不等式 計算機
二次不等式 計算機
三次方程式計算機
三次方程式計算機
多項式・式の展開の計算ツール
文字式の計算機
文字式の計算機
因数分解計算機
因数分解計算機
式の展開 計算機
式の展開 計算機
多項式の割り算計算機
多項式の割り算計算機
二項定理の計算機
二項定理の計算機
平方根・n乗根の計算ツール
根号の簡約
根号の簡約
分母の有理化
分母の有理化
累乗根の計算
累乗根の計算
指数・対数の計算ツール
べき乗計算機
べき乗計算機
対数計算機
対数計算機
常用対数と桁数
常用対数と桁数
科学的記数法
科学的記数法
科学的記数法の計算
科学的記数法の計算
半減期計算機
半減期計算機
複素数の計算ツール
複素数計算機
複素数計算機
複素数の極形式変換
複素数の極形式変換
ド・モアブルの定理
ド・モアブルの定理
関数・グラフの計算ツール
直線の傾きの計算
直線の傾きの計算
一次関数計算機
一次関数計算機
比例・反比例 計算機
比例・反比例 計算機
二次関数 y=ax² 計算機
二次関数 y=ax² 計算機
2点間の距離の計算
2点間の距離の計算
3D空間の2点間の距離の計算
3D空間の2点間の距離の計算
内分点・外分点の計算
内分点・外分点の計算
点と直線の距離 計算機
点と直線の距離 計算機
緯度経度の距離計算
緯度経度の距離計算
平方完成 計算機
平方完成 計算機
円の方程式 計算機
円の方程式 計算機
二次曲線計算機
二次曲線計算機
極座標と直交座標の変換
極座標と直交座標の変換
微分・積分の計算ツール
極限計算機
極限計算機
導関数計算機
導関数計算機
微分公式の計算機
微分公式の計算機
接線・法線 計算機
接線・法線 計算機
定積分計算機
定積分計算機
不定積分計算機
不定積分計算機
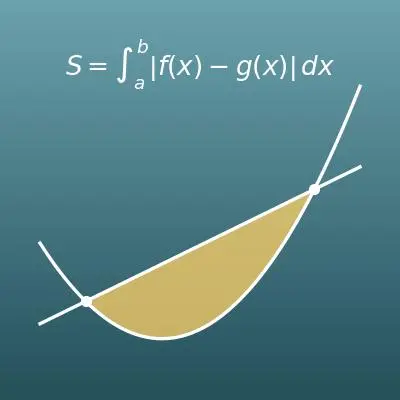
2曲線間の面積
2曲線間の面積
回転体の体積 計算機
回転体の体積 計算機
数列の計算ツール
等差数列の計算
等差数列の計算
等比数列の計算
等比数列の計算
Σ(シグマ)計算機
Σ(シグマ)計算機
フィボナッチ数列の計算
フィボナッチ数列の計算
漸化式計算機
漸化式計算機
ベクトルの計算ツール
ベクトルの計算
ベクトルの計算
外積の計算
外積の計算
行列の計算ツール
行列の計算
行列の計算
行列式
行列式
逆行列
逆行列
平面図形の計算ツール
三角比の計算
三角比の計算
度とラジアンの変換
度とラジアンの変換
三角関数の合成
三角関数の合成
三角形計算機
三角形計算機
三角形の面積計算機
三角形の面積計算機
直角三角形の計算
直角三角形の計算
三平方の定理の計算
三平方の定理の計算
多角形の内角・外角
多角形の内角・外角
相似比・面積比・体積比
相似比・面積比・体積比
平行線と角
平行線と角
長方形の面積
長方形の面積
平行四辺形の面積
平行四辺形の面積
台形の面積
台形の面積
円の計算
円の計算
扇形の面積
扇形の面積
円周角の定理
円周角の定理
楕円の面積
楕円の面積
空間図形の計算ツール
立方体の体積
立方体の体積
立方体の表面積
立方体の表面積
直方体の体積
直方体の体積
直方体の表面積
直方体の表面積
円柱の体積
円柱の体積
円柱の表面積
円柱の表面積
球の体積
球の体積
球の表面積
球の表面積
球欠(球冠)の体積
球欠(球冠)の体積
球冠の表面積
球冠の表面積
楕円体の体積
楕円体の体積
楕円体の表面積
楕円体の表面積
四角錐の体積
四角錐の体積
四角錐の表面積
四角錐の表面積
円錐の体積
円錐の体積
円錐の表面積
円錐の表面積
円錐台の体積
円錐台の体積
円錐台の表面積
円錐台の表面積
パイプ(管)の体積
パイプ(管)の体積
カプセル形の体積
カプセル形の体積
カプセルの表面積
カプセルの表面積
日付・時間の計算ツール
年齢計算
年齢計算
日数計算
日数計算
○日後・○日前の日付
○日後・○日前の日付
○時間後・○時間前の日時
○時間後・○時間前の日時
曜日計算
曜日計算
時間の足し算・引き算
時間の足し算・引き算
時差計算
時差計算
勤務時間計算
勤務時間計算
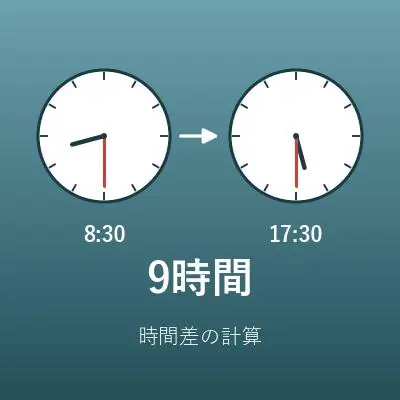
時間差の計算
時間差の計算
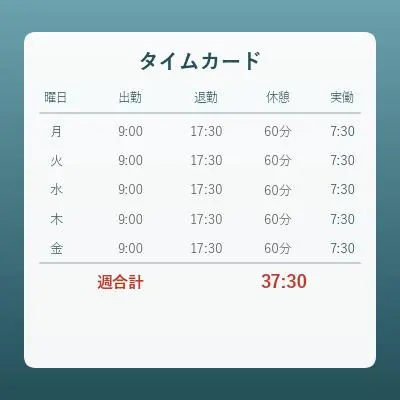
タイムカード計算
タイムカード計算
金融・経済の計算ツール
複利計算
複利計算
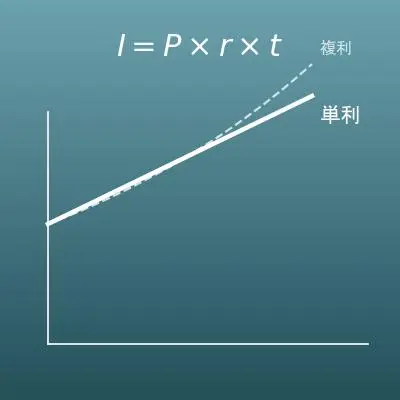
単利計算
単利計算
利息計算
利息計算
ファイナンス計算機
ファイナンス計算機
現在価値の計算
現在価値の計算
将来価値の計算
将来価値の計算
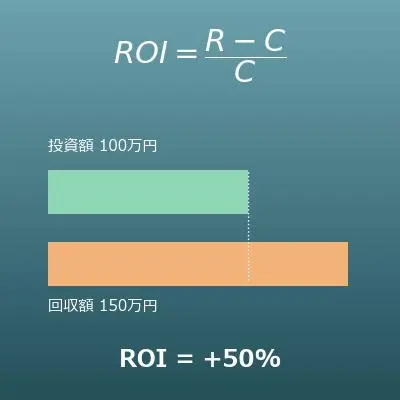
ROIの計算
ROIの計算
IRRの計算
IRRの計算
回収期間の計算
回収期間の計算
平均リターンの計算
平均リターンの計算
GDPの計算
GDPの計算
Webマーケ・広告指標の計算ツール
クリック率(CTR)の計算
クリック率(CTR)の計算
コンバージョン率(CVR)の計算
コンバージョン率(CVR)の計算
CPC・CPM・CPA計算機
CPC・CPM・CPA計算機
ROAS(広告費用対効果)の計算
ROAS(広告費用対効果)の計算
損益分岐CPA・許容CPA計算機
損益分岐CPA・許容CPA計算機
顧客生涯価値(LTV)の計算
顧客生涯価値(LTV)の計算
顧客獲得コスト(CAC)とLTV/CAC比
チャーン率(解約率)と平均継続期間
チャーン率(解約率)と平均継続期間
A/Bテストの有意差判定
A/Bテストの有意差判定
A/Bテストの必要サンプル数
A/Bテストの必要サンプル数
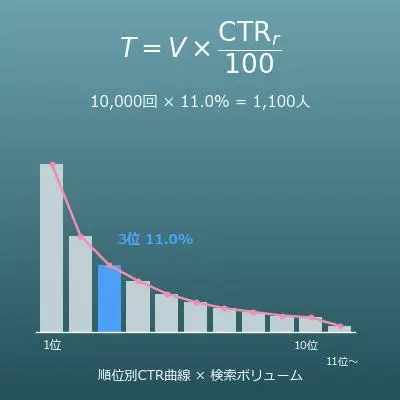
検索順位別CTRからの想定流入数
検索順位別CTRからの想定流入数
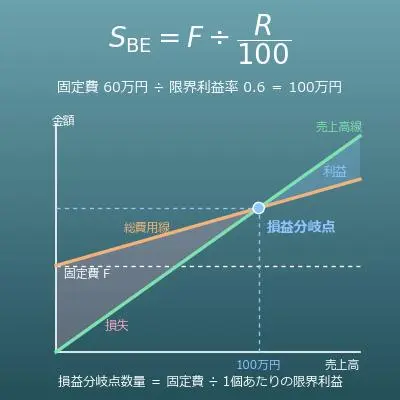
損益分岐点計算機
損益分岐点計算機
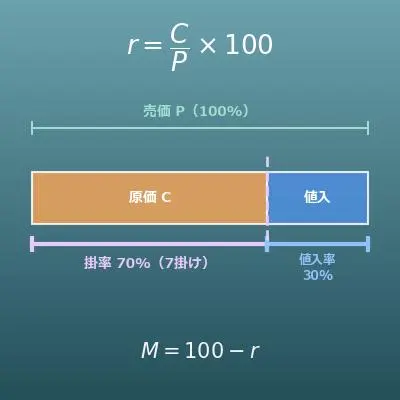
値入率・掛率換算
値入率・掛率換算
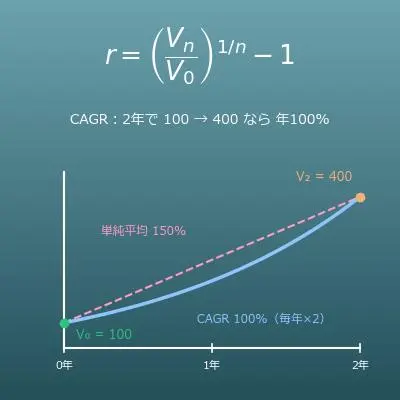
CAGR計算
CAGR計算
健康・フィットネスの計算ツール
BMI計算機
BMI計算機
睡眠サイクル計算
睡眠サイクル計算
カロリー計算機
カロリー計算機
基礎代謝量計算機
基礎代謝量計算機
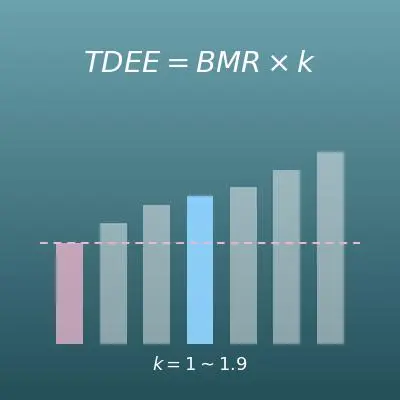
TDEE計算機
TDEE計算機
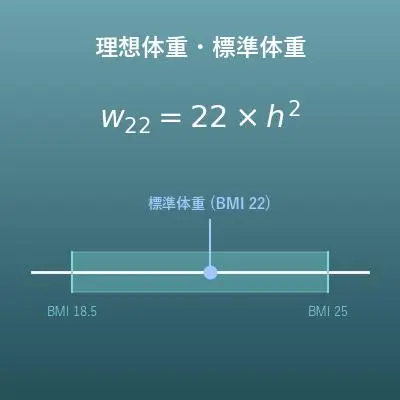
理想体重計算機
理想体重計算機
体脂肪率計算機
体脂肪率計算機
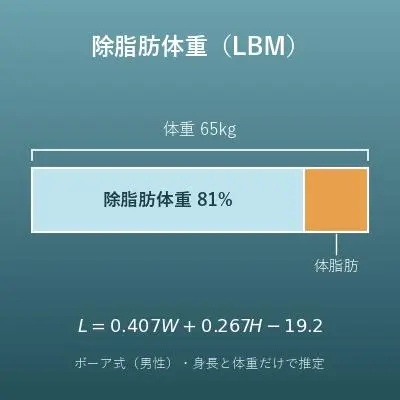
除脂肪体重計算機
除脂肪体重計算機
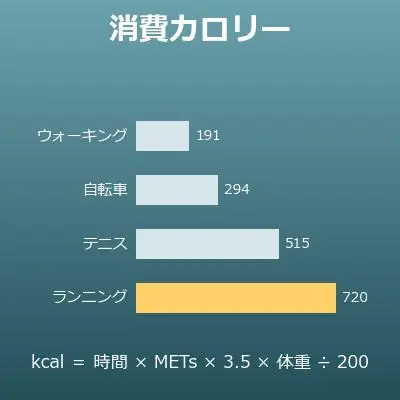
消費カロリー計算機
消費カロリー計算機
たんぱく質摂取量計算機
たんぱく質摂取量計算機
PFCバランス計算機
PFCバランス計算機
炭水化物摂取量計算機
炭水化物摂取量計算機
脂質摂取量計算機
脂質摂取量計算機
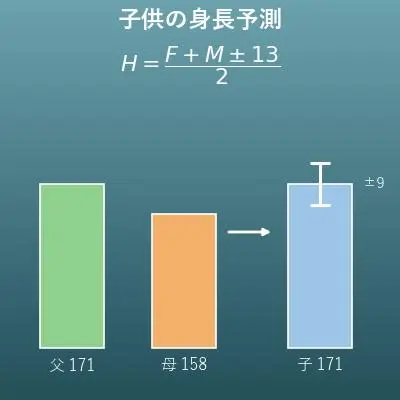
子供の身長予測
子供の身長予測
スポーツの計算ツール
ゴルフハンディキャップ
ゴルフハンディキャップ
ペース計算機
ペース計算機
1RM計算機
1RM計算機
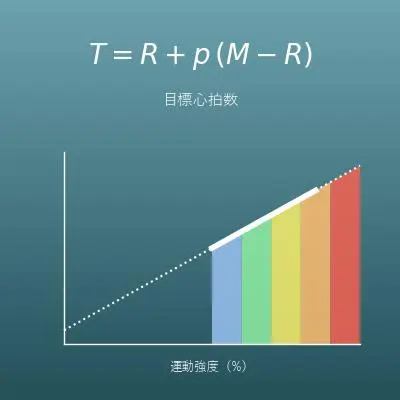
目標心拍数計算機
目標心拍数計算機
気象の計算ツール
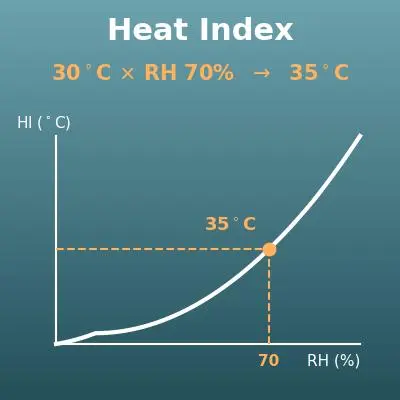
ヒートインデックス
ヒートインデックス
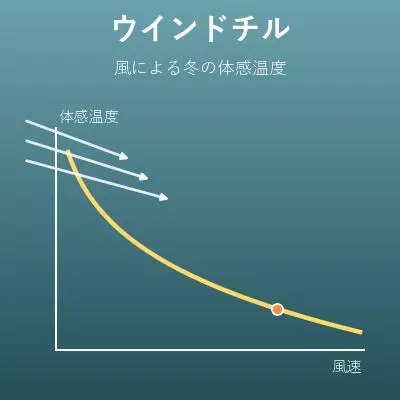
ウインドチル
ウインドチル
露点温度
露点温度
コンピュータの計算ツール
進数変換
進数変換
IPサブネット計算機
IPサブネット計算機
帯域幅・ダウンロード時間の計算機
帯域幅・ダウンロード時間の計算機
家計・光熱費の計算ツール
電気代計算
電気代計算
kWh→電気代・逆算
kWh→電気代・逆算
年間消費電力量→電気代
年間消費電力量→電気代
エアコン畳数・能力
エアコン畳数・能力
エアコンの電気代計算
エアコンの電気代計算
暖房の電気代比較
暖房の電気代比較
ガスと電気の光熱費比較
ガスと電気の光熱費比較
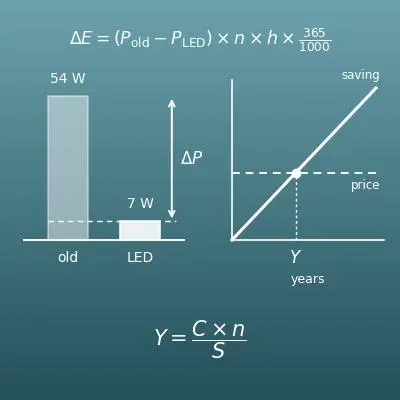
LED交換の節約額
LED交換の節約額
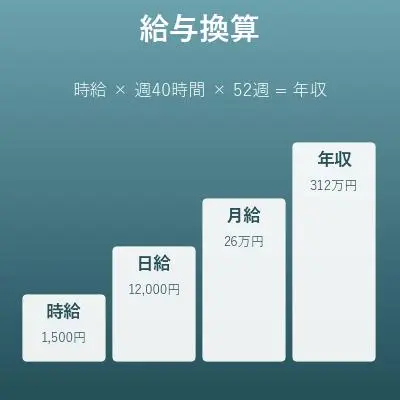
給与換算
給与換算
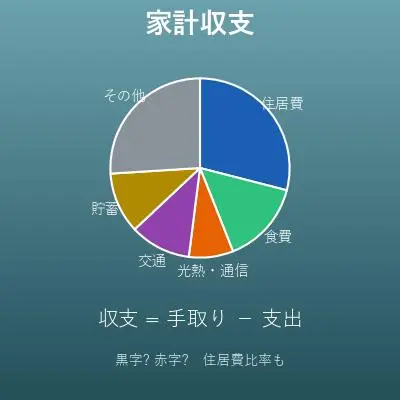
家計収支の計算
家計収支の計算
自動車の計算ツール
ガソリン代計算
ガソリン代計算
EV充電コスト
EV充電コスト
EVとガソリン車の燃料費比較
EVとガソリン車の燃料費比較
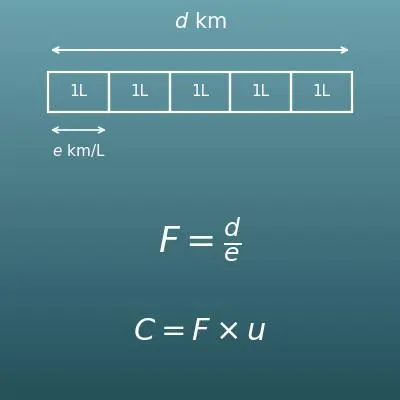
燃費計算
燃費計算
タイヤサイズ計算
タイヤサイズ計算
太陽光発電・蓄電池の計算ツール
太陽光発電の発電量
太陽光発電の発電量
太陽光パネルの枚数と面積
太陽光パネルの枚数と面積
太陽光発電の回収年数
太陽光発電の回収年数
蓄電池の必要容量と持ち時間
蓄電池の必要容量と持ち時間
住まい・DIYの計算ツール
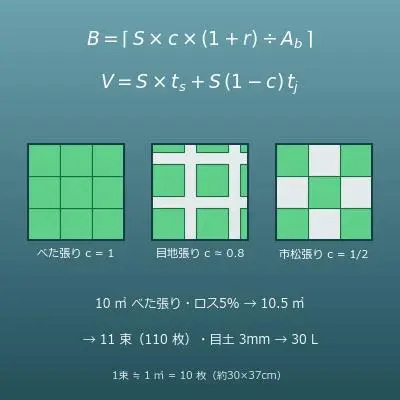
タイル枚数
タイル枚数
階段の寸法
階段の寸法
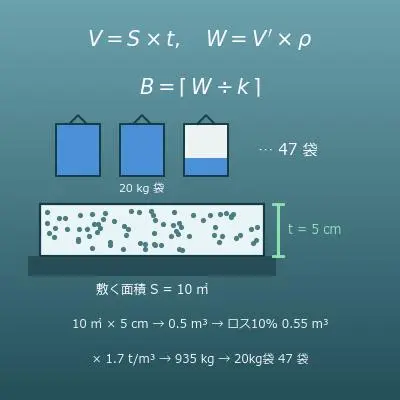
生コン量
生コン量
壁・天井・床の面積
壁・天井・床の面積
壁紙の必要量
壁紙の必要量
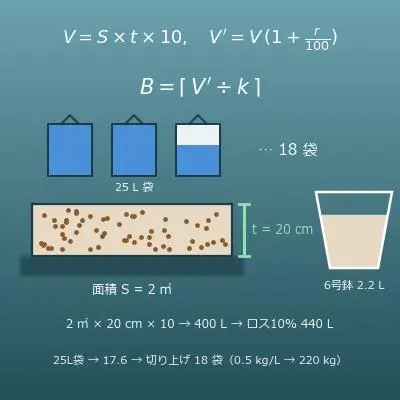
塗料の必要量
塗料の必要量
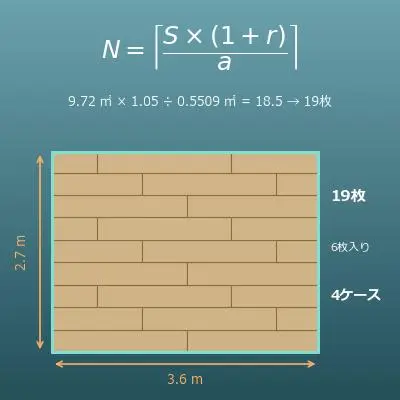
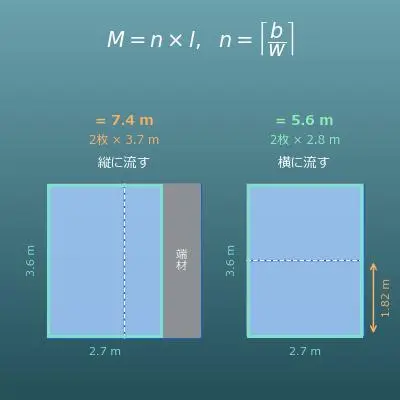
フローリング枚数
フローリング枚数
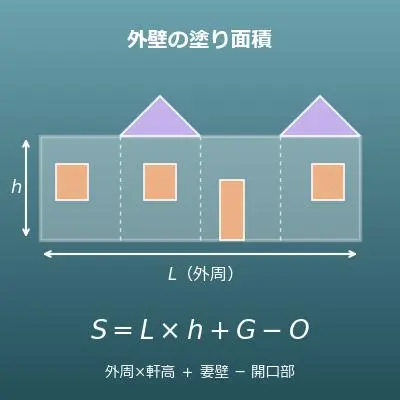
外壁面積
外壁面積
砂利の必要量
砂利の必要量
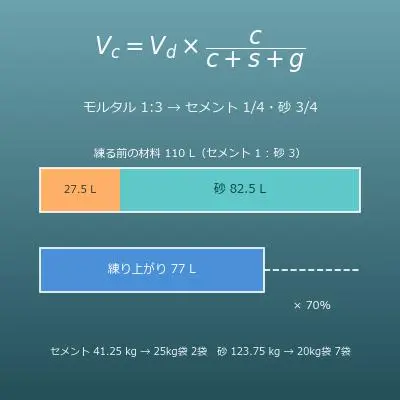
モルタルの配合
モルタルの配合
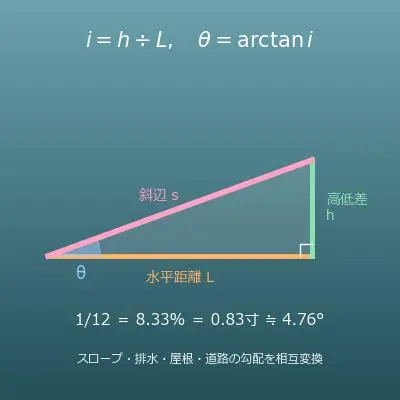
勾配の計算
勾配の計算
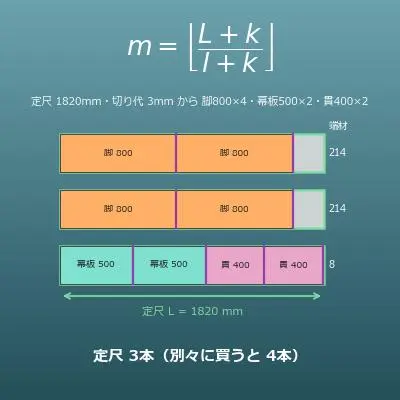
木材の取り数
木材の取り数
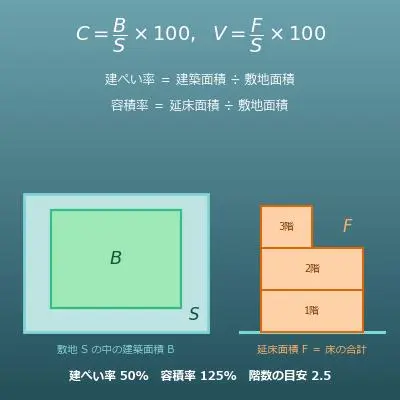
建ぺい率・容積率
建ぺい率・容積率
クッションフロア必要量
クッションフロア必要量
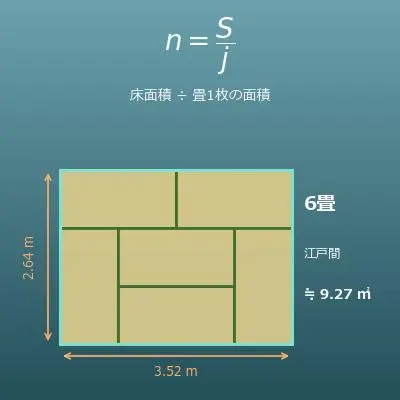
畳の枚数と広さ
畳の枚数と広さ
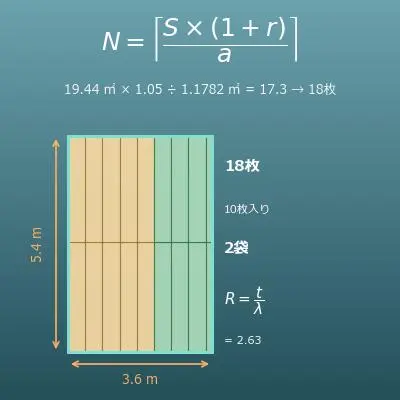
断熱材の必要量
断熱材の必要量
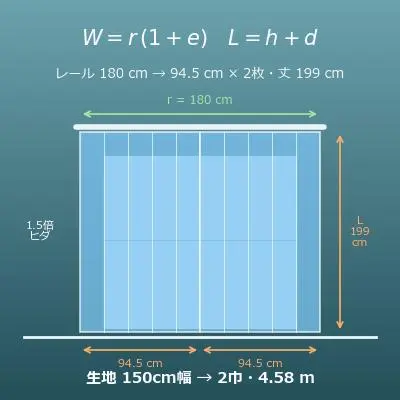
カーテンのサイズ
カーテンのサイズ
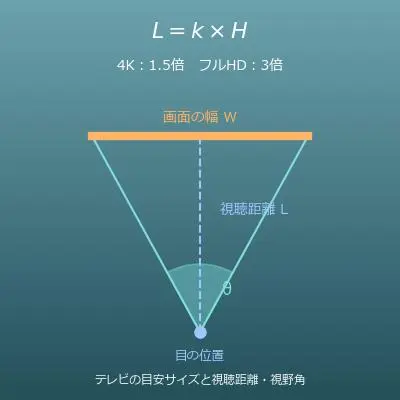
テレビのサイズと視聴距離
テレビのサイズと視聴距離
土・培養土の必要量
土・培養土の必要量
芝生の必要枚数
芝生の必要枚数
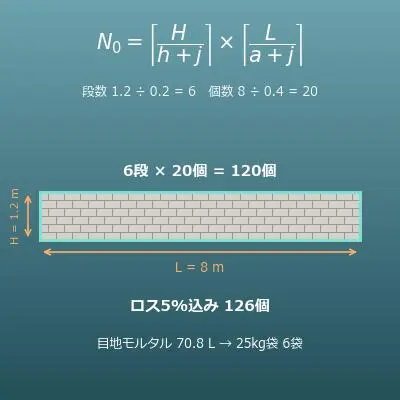
ブロック塀の個数
ブロック塀の個数
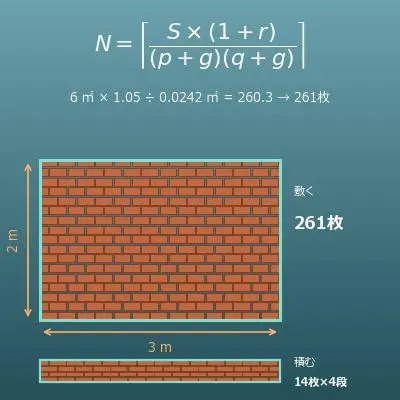
レンガの必要枚数
レンガの必要枚数
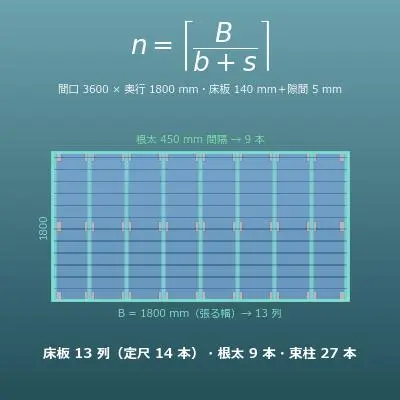
ウッドデッキの材料
ウッドデッキの材料
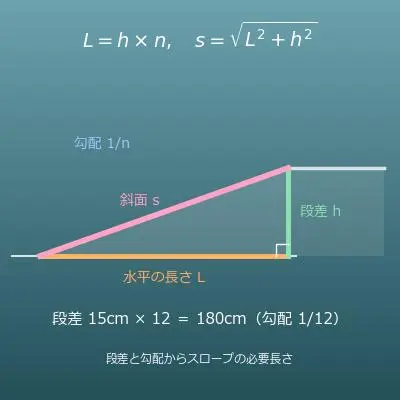
スロープの必要長さ
スロープの必要長さ
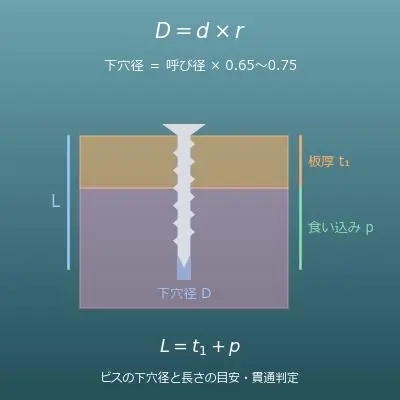
ネジの下穴径と長さ
ネジの下穴径と長さ
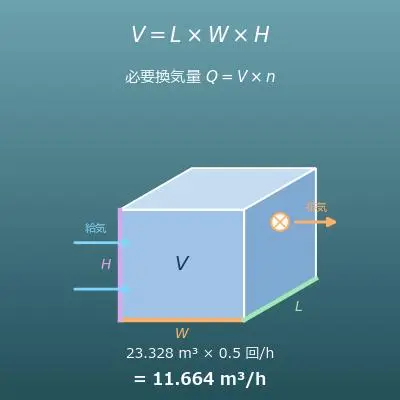
容積と必要換気量
容積と必要換気量
塗料の希釈計算
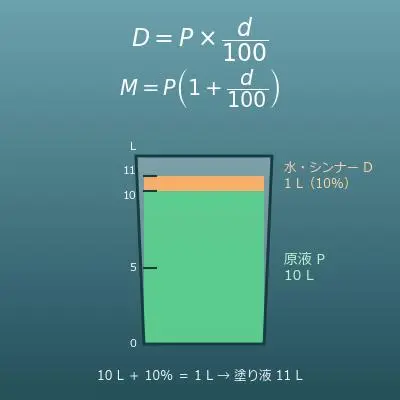
塗料の希釈計算
巾木・廻り縁の長さ
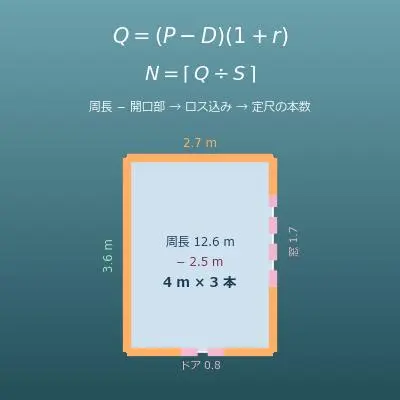
巾木・廻り縁の長さ
ブラインドの採寸
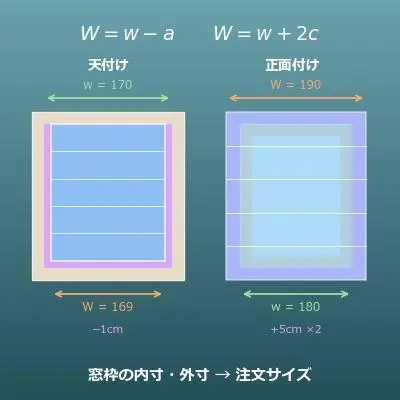
ブラインドの採寸
額縁の取り付け高さと配置
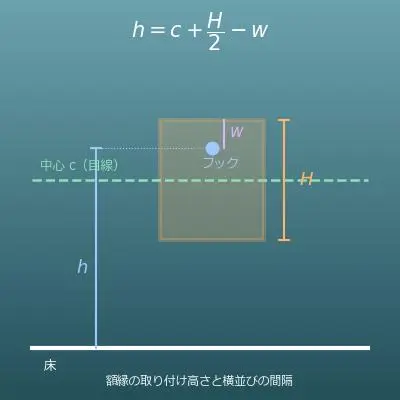
額縁の取り付け高さと配置
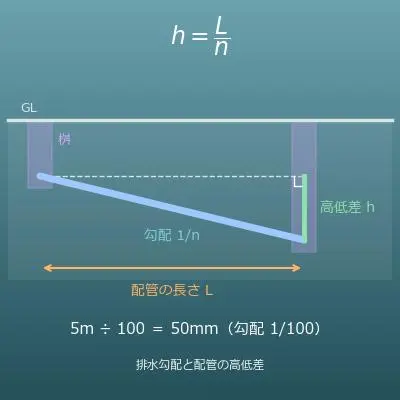
排水勾配と高低差
排水勾配と高低差
ビス・釘の必要本数
ビス・釘の必要本数
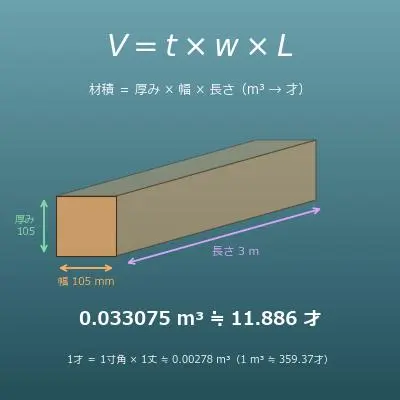
木材の材積(m³・才)
木材の材積(m³・才)
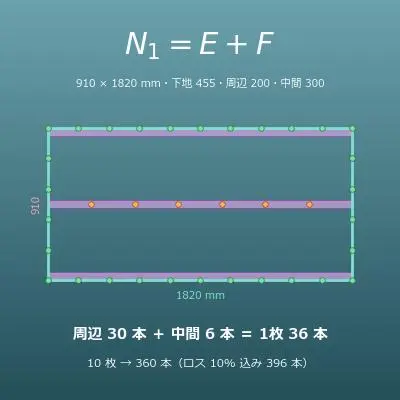
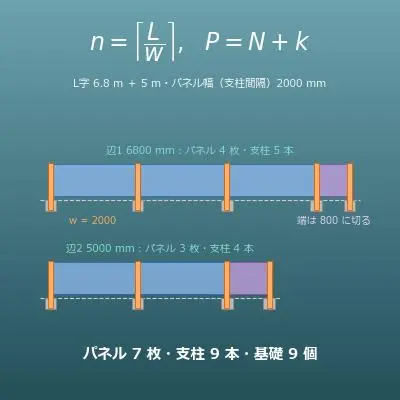
フェンスの本数
フェンスの本数
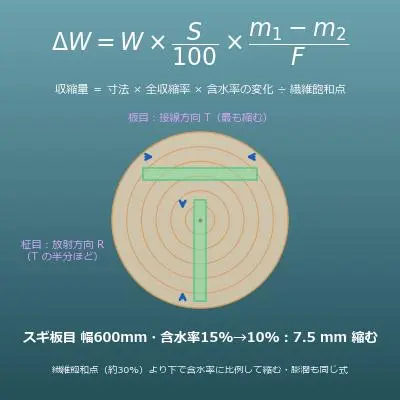
木材の収縮量(含水率変化)
木材の収縮量(含水率変化)
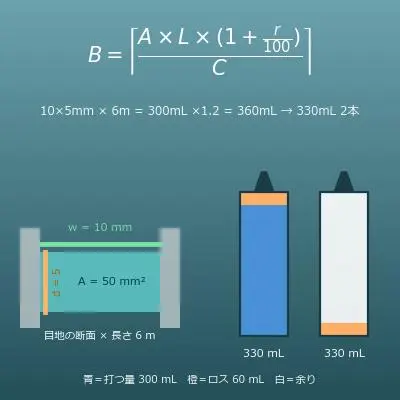
接着剤・コーキングの必要量
接着剤・コーキングの必要量
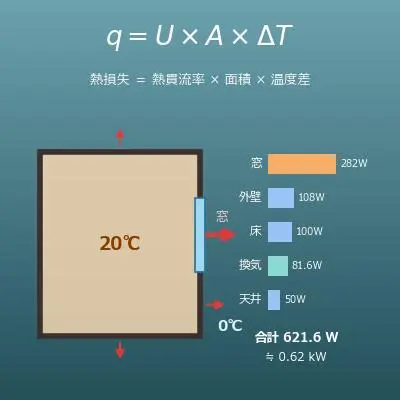
部屋の熱損失の目安
部屋の熱損失の目安
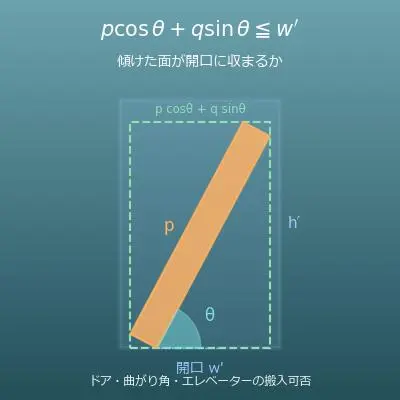
家具の搬入可否
家具の搬入可否
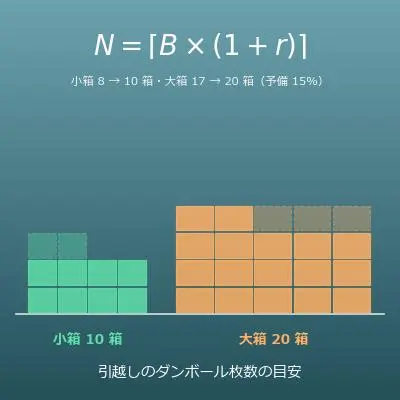
引越しのダンボール枚数
引越しのダンボール枚数
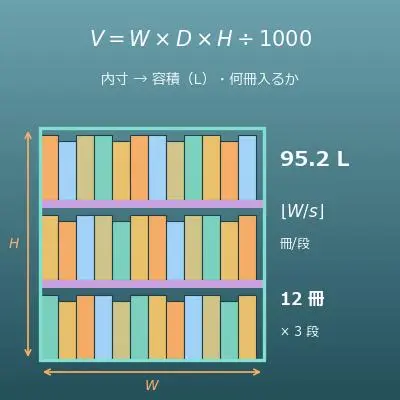
収納・棚の容量
収納・棚の容量
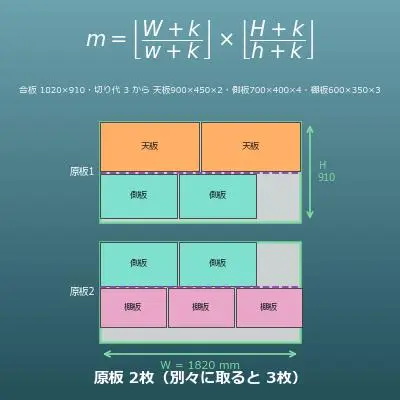
板取り計算
板取り計算
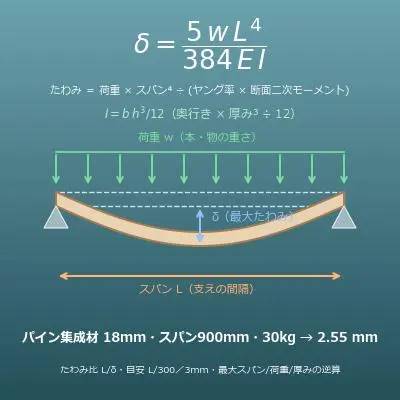
棚板のたわみと耐荷重
棚板のたわみと耐荷重

二項分布の計算機(ちょうどk回の確率・累積確率・期待値と分散)

試行回数 n・1回で成功する確率 p・成功する回数 k を入力してください。ちょうど k 回の確率、k 回以下・k 回以上の累積確率、期待値・分散・標準偏差と、分布全体の棒グラフをまとめて表示します。

数値は半角で入力してください。確率 p は 0〜1 の小数(例:25%なら 0.25)か 1/4 のような分数、n は 1〜50 の整数、k は 0〜n の整数です。
計算結果・グラフ
左の入力欄に回数と確率を入れて「計算する」を押すと、ここに結果と分布の棒グラフが表示されます。

このページでできること

  • 「確率 \(p\) のことを \(n\) 回くり返して、ちょうど \(k\) 回起こる確率」\(P(X = k) = {}_{n}\mathrm{C}_{k}\, p^{k} (1-p)^{n-k}\) を、3つの数値を入れるだけでその場で計算できます
  • 答えは \(\dfrac{3}{8}\) のような約分済みの分数(厳密値)と小数・パーセントの両方で表示。組み合わせの数 \({}_{n}\mathrm{C}_{k}\) の途中式も見られます
  • 「\(k\) 回以下になる確率 \(P(X \leqq k)\)」「\(k\) 回以上になる確率 \(P(X \geqq k)\)」の累積確率も同時に計算します
  • 期待値 \(E(X) = np\)・分散 \(V(X) = np(1-p)\)・標準偏差 \(\sigma\) と、正規分布で近似できるかの目安判定も表示します
  • 起こる回数が0回から \(n\) 回までの分布全体を棒グラフで描くので、「どのあたりの回数が起こりやすいか」がひと目でわかります
使えるのは「毎回同じ確率で、毎回の結果が互いに影響しない(独立な)」くり返しです。引いたくじを戻さずに続けて引く場合のように、回ごとに確率が変わるものには使えません。

この計算は何の役に立つ?

ガチャ・くじの「n回中k回当たる」を見積もる(ゲーム・娯楽)

提供割合1%のガチャを100回引いたときの当たりの回数は、二項分布 \(B(100,\ 0.01)\) に従います(各回の確率が同じで独立、と公表されている場合)。1回も当たらない確率は \(0.99^{100} \fallingdotseq 36.6\%\) もあり、「100回引けば1%でもほぼ確実」という直感が危ないことが分布から読み取れます。
課金の予算を考えるときの「期待値 \(np\) 回+ばらつき」という見積もりは、まさにこのページの計算です。

抜き取り検査の合格基準を設計する(製造・品質管理)

工場では全数検査の代わりに「ロットから \(n\) 個抜き取り、不良が \(c\) 個以下なら合格」という抜き取り検査が使われます。不良率 \(p\) のロットが合格する確率は二項分布の累積確率 \(P(X \leqq c)\) そのもので、例えば不良率1%のロットから20個抜いて不良0個なら合格とすると、合格する確率は \(0.99^{20} \fallingdotseq 81.8\%\) です。
「どのくらいの不良率までなら高い確率で合格させ、悪いロットは落とせるか」という検査基準の設計に、この計算が使われています。

選択式テストの「まぐれ当たり」を見積もる(教育・資格試験)

4択問題20問を全部あてずっぽうで答えると、正解数は二項分布 \(B(20,\ 0.25)\) に従い、期待値は \(20 \times 0.25 = 5\) 問です。8問以上まぐれで正解できる確率は約10%しかなく、「勘だけでは合格ラインに届きにくい」ことが確率で裏付けられます。
試験を作る側も、合格ラインをまぐれで超えにくいように、この分布を意識して問題数や基準を決めています。

スポーツの成功回数のばらつきを読む(バスケットボール等)

成功率70%のフリースローの選手が10本投げたとき、ちょうど7本決まる確率は \({}_{10}\mathrm{C}_{7} \times 0.7^{7} \times 0.3^{3} \fallingdotseq 26.7\%\) しかありません(各回が独立で成功率が一定と見なした場合)。「7割の選手が10本中7本決める」のは意外と当たり前ではなく、6本や8本になることも普通に起こります。
好調・不調に見える結果のどこまでが「確率的に普通のばらつき」なのかを見分けるのに、二項分布が使われます。

世論調査・視聴率調査の誤差の根拠(統計調査)

「支持率」や「視聴率」の調査では、調査対象 \(n\) 人のうち該当する人数が二項分布に従うと考えます。誤差の目安として使われる「±数ポイント」は、標準偏差 \(\sqrt{np(1-p)}\) と正規分布による近似から計算されたものです。
「何人に聞けば誤差をどこまで小さくできるか」というサンプルサイズの設計は、二項分布の性質そのものが根拠になっています。

式とグラフ

二項分布の確率(ちょうど \(k\) 回起こる確率)
グラフ
数学表記 (一般的な数式)
\(P(X = k)\) \(=\) \({}_{n}\mathrm{C}_{k}\) \(\times\) \(p\) \(k\) \(\times\) \((1 - p)\) \(n - k\)
日本語表記 (記号を日本語に置き換えた式)
⑥ ちょうど \(k\) 回起こる確率 \(P(X = k)\) \(=\) ⑤ どの回で成功するかの並び方の数 \({}_{n}\mathrm{C}_{k}\) \(\times\) ① 成功する確率 \(p\) ② 成功する回数 \(k\) \(\times\) ③ 失敗する確率 \(1 - p\) ④ 失敗する回数 \(n - k\)
式を日本語で読むと
① 成功する確率 \(p\) を
② 成功する回数 \(k\) の分だけくり返し掛け
③ 失敗する確率 \(1 - p\) を
④ 失敗する回数 \(n - k\) の分だけくり返し掛け
⑤ どの回で成功するかの並び方の数 \({}_{n}\mathrm{C}_{k}\) を掛けると
⑥ ちょうど \(k\) 回起こる確率 \(P(X = k)\) になる
簡単な例
コイン(表が出る確率 \(\dfrac{1}{2}\))を4回投げて、表がちょうど2回出る確率は
ちょうど2回出る確率 \(P(X = 2)\) \(=\) 並び方の数 \({}_{4}\mathrm{C}_{2}\) \(\times\) 表の確率 \(\dfrac{1}{2}\) を2回分 \(\times\) 裏の確率 \(\dfrac{1}{2}\) を2回分
\({}_{4}\mathrm{C}_{2} = \dfrac{4 \times 3}{2 \times 1} = 6\)
\(P(X = 2) = 6 \times \left(\dfrac{1}{2}\right)^{2} \times \left(\dfrac{1}{2}\right)^{2} = \dfrac{6}{16} = \dfrac{3}{8}\ \ (37.5\%)\)
考え方のポイント
「成功が \(k\) 回・失敗が \(n-k\) 回」という並び1通りの確率は \(p^{k} (1-p)^{n-k}\) です。この並び方(何回目に成功するかの選び方)が \({}_{n}\mathrm{C}_{k}\) 通りあるので、それを掛けたものが答えになります。数学Aで習う「反復試行の確率」と同じ式です。 起こる回数 \(X\) が取る値(0回、1回、…、\(n\) 回)それぞれの確率をひとまとめにした分布を二項分布といい、\(B(n,\ p)\) と書きます。このページの計算機は、その分布全体を棒グラフで描きます。
累積確率(\(k\) 回以下・\(k\) 回以上になる確率)
数学表記 (一般的な数式)
\(P(X \leqq k)\) \(=\) \(P(X=0) + P(X=1) + \cdots + P(X=k)\)
\(P(X \geqq k)\) \(=\) \(1\) \(-\) \(P(X \leqq k - 1)\)
日本語表記 (記号を日本語に置き換えた式)
② \(k\) 回以下になる確率 \(P(X \leqq k)\) \(=\) ① ちょうど0回〜ちょうど \(k\) 回の確率の合計
⑤ \(k\) 回以上になる確率 \(P(X \geqq k)\) \(=\) ③ 全体の確率 \(1\) \(-\) ④ \(k-1\) 回以下になる確率
式を日本語で読むと
① ちょうど0回、ちょうど1回、…、ちょうど \(k\) 回の確率 を全部足すと
② \(k\) 回以下になる確率 \(P(X \leqq k)\) になる
③ 「\(k\) 回以上」は余事象を使うと計算が短く、 全体の確率 \(1\) から
④ \(k-1\) 回以下になる確率 \(P(X \leqq k-1)\) を引くと
⑤ \(k\) 回以上になる確率 \(P(X \geqq k)\) になる
簡単な例
コインを4回投げたとき、表が2回以下になる確率と、2回以上になる確率は
2回以下になる確率 \(P(X \leqq 2)\) \(=\) 0回・1回・2回の確率の合計
\(P(X \leqq 2) = \dfrac{1}{16} + \dfrac{4}{16} + \dfrac{6}{16} = \dfrac{11}{16}\ \ (68.75\%)\)
\(P(X \geqq 2) = 1 - P(X \leqq 1) = 1 - \dfrac{5}{16} = \dfrac{11}{16}\ \ (68.75\%)\)
考え方のポイント
「以下」「以上」はその回数自身を含みます(2回以下=0回・1回・2回)。「\(k\) 回以下」はちょうどの確率を足すだけ、「\(k\) 回以上」は全体の1から「\(k-1\) 回以下」を引く(余事象)のが定石です。 「少なくとも1回起こる確率」は \(P(X \geqq 1) = 1 - P(X = 0)\) のことで、余事象の一番よく出る使い方です。
二項分布の期待値・分散・標準偏差
数学表記 (一般的な数式)
\(E(X)\) \(=\) \(n\) \(\times\) \(p\)
\(V(X)\) \(=\) \(n\) \(\times\) \(p\) \(\times\) \((1 - p)\)
\(\sigma\) \(=\) \(\sqrt{V(X)}\)
日本語表記 (記号を日本語に置き換えた式)
③ 期待値(平均して起こる回数)\(E(X)\) \(=\) ① 試行回数 \(n\) \(\times\) ② 成功する確率 \(p\)
⑤ 分散(ばらつきの大きさ)\(V(X)\) \(=\) 試行回数 \(n\) \(\times\) 成功する確率 \(p\) \(\times\) ④ 失敗する確率 \(1 - p\)
⑦ 標準偏差(ばらつきの目安)\(\sigma\) \(=\) ⑥ 分散 \(V(X)\) にルートを付けたもの
式を日本語で読むと
① 試行回数 \(n\) に
② 成功する確率 \(p\) を掛けると
③ 期待値(平均して起こる回数)\(E(X)\) になり
④ さらに 失敗する確率 \(1 - p\) を掛けると
⑤ 分散(ばらつきの大きさ)\(V(X)\) になる
⑥ 分散 \(V(X)\) にルート(平方根)を付けたもの が
⑦ 標準偏差(ばらつきの目安)\(\sigma\) になる
簡単な例
サイコロを30回投げて1の目が出る回数(\(n = 30\)、\(p = \dfrac{1}{6}\))では
期待値 \(E(X)\) \(=\) 試行回数 \(30\) \(\times\) 1の目の確率 \(\dfrac{1}{6}\)
\(E(X) = 30 \times \dfrac{1}{6} = 5\)
\(V(X) = 30 \times \dfrac{1}{6} \times \dfrac{5}{6} = \dfrac{25}{6}\)
\(\sigma = \sqrt{\dfrac{25}{6}} = \dfrac{5}{\sqrt{6}} = \dfrac{5\sqrt{6}}{6} \fallingdotseq 2.04\)
考え方のポイント
期待値 \(np\) は「確率 \(\dfrac{1}{6}\) のことを30回やれば、平均すると \(30 \times \dfrac{1}{6} = 5\) 回くらい起こる」という直感そのままの式です。 分散・標準偏差は「実際の回数が期待値からどれくらいずれやすいか」の目安です。標準偏差が約2なら、「5回ちょうど」ではなく「だいたい3〜7回におさまることが多い」と読めます。 同じ \(n\) なら、分散 \(np(1-p)\) は \(p = \dfrac{1}{2}\) のとき最大になります(成功と失敗が半々のときが一番結果を予想しにくい、ということです)。
正規分布による近似(\(np \geqq 5\) かつ \(n(1-p) \geqq 5\) が目安)
グラフ
数学表記 (一般的な数式)
日本語表記 (記号を日本語に置き換えた式)
\(B(n,\ p)\) \(\fallingdotseq\) \(N(np,\ np(1 - p))\)
① 二項分布 \(B(n,\ p)\) \(\fallingdotseq\) ② 平均 \(np\)・分散 \(np(1-p)\) の正規分布
式を日本語で読むと
① 二項分布 \(B(n,\ p)\) は、\(np \geqq 5\) かつ \(n(1-p) \geqq 5\) が目安のとき
② 平均 \(np\)・分散 \(np(1-p)\) の正規分布 \(N(np,\ np(1-p))\) でおおよそ置き換えられる
簡単な例
コインを20回投げて表が出る回数(\(n = 20\)、\(p = \dfrac{1}{2}\))は
二項分布 \(B(20,\ \dfrac{1}{2})\) \(\fallingdotseq\) 正規分布 \(N(10,\ 5)\)
\(np = 20 \times \dfrac{1}{2} = 10 \geqq 5,\quad n(1 - p) = 20 \times \dfrac{1}{2} = 10 \geqq 5\)
\(B\left(20,\ \dfrac{1}{2}\right) \fallingdotseq N(10,\ 5)\)
考え方のポイント
\(n\) を大きくしていくと、二項分布の棒グラフは左右対称の釣り鐘型に近づき、正規分布とほとんど同じ形になります。だから \(n\) が大きいときは、二項分布の面倒な足し算を正規分布の表(やZスコア)で置き換えて計算できます。これが正規近似で、\(np \geqq 5\) かつ \(n(1-p) \geqq 5\) はそのための代表的な目安です。 \(N(np,\ np(1-p))\) の括弧の中は「平均、分散」の順です。近似したあとの「〇回以上になる確率」などの計算は、当サイトの「正規分布の確率」ページでできます。
二項分布は「確率 \(p\) のことを \(n\) 回くり返したときに起こる回数」の分布で、ちょうど \(k\) 回の確率は \(P(X = k) = {}_{n}\mathrm{C}_{k}\, p^{k} (1-p)^{n-k}\)、期待値は \(np\)、分散は \(np(1-p)\) です。\(n\) が大きいときは正規分布 \(N(np,\ np(1-p))\) で近似できます。

用語・記号の解説

記号

\(X\) エックス 「起こる回数」を表す確率変数。結果が確率で決まる数には、アルファベットの終わりの方の大文字 \(X,\ Y,\ Z\) を使う慣例があります。
\(P(X = k)\) ピー・エックス・イコール・ケー 起こる回数 \(X\) がちょうど \(k\) 回になる確率。\(P\) は probability(確率)の頭文字です。
\({}_{n}\mathrm{C}_{k}\) エヌ・シー・ケー コンビネーション \(n\) 個から \(k\) 個を選ぶ組み合わせの数。\(C\) は combination(組み合わせ)の頭文字です。海外や大学の本では \(\dbinom{n}{k}\) とも書きます。
\(n\) エヌ 試行回数(くり返す回数)。回数や個数には number(数)の頭文字 \(n\) がよく使われます。
\(p\) ピー 1回の試行で成功する確率。probability(確率)の頭文字で、小文字は「1回分の確率」に使うことが多い文字です。
\(1 - p\) いち・ひく・ピー 1回の試行で失敗する確率(成功しない確率)。成功と失敗のどちらかは必ず起こるので、全体の \(1\) から \(p\) を引いた残りです。\(q\) と書くこともあります。
\(k\) ケー 成功する回数。\(0\) から \(n\) までの整数です。「何回起こるか」を指定する文字として \(k\) がよく使われます。
\(P(X \leqq k)\) ピー・エックス・しょうなりイコール・ケー 起こる回数が \(k\) 回以下(0回〜\(k\) 回のどれか)になる確率。「ちょうどの確率」を \(k\) 回まで足し合わせた累積確率です。
\(P(X \geqq k)\) ピー・エックス・だいなりイコール・ケー 起こる回数が \(k\) 回以上(\(k\) 回〜\(n\) 回のどれか)になる確率。全体の \(1\) から \(P(X \leqq k-1)\) を引くと(余事象)、足し算を短くして求められます。
\(E(X)\) イー・エックス 期待値(平均して起こる回数)。\(E\) は expectation(期待値)の頭文字です。二項分布では \(E(X) = np\) になります。
\(V(X)\) ブイ・エックス 分散(ばらつきの大きさ)。\(V\) は variance(分散)の頭文字です。二項分布では \(V(X) = np(1-p)\) になります。
\(\sigma\) シグマ 標準偏差。ギリシャ文字の小文字シグマで、standard deviation の s にあたる文字です。分散の平方根 \(\sigma = \sqrt{V(X)}\) で、期待値からのずれの目安を表します。
\(B(n,\ p)\) ビー・エヌ・ピー 試行回数 \(n\)・成功確率 \(p\) の二項分布。\(B\) は binomial(二項の)の頭文字です。「\(X\) は二項分布に従う」を \(X \sim B(n,\ p)\) と書きます。
\(N(\mu,\ \sigma^2)\) エヌ・ミュー・シグマじじょう 平均 \(\mu\)・分散 \(\sigma^2\) の正規分布。\(N\) は normal distribution(正規分布)の頭文字です。括弧の中は「平均、分散」の順で書く慣例です。
\(\fallingdotseq\) ニアリーイコール おおよそ等しいことを表す記号。このページでは「二項分布が正規分布でおおよそ置き換えられる」ことを表すのに使っています。

用語

二項分布 にこうぶんぷ 「確率 \(p\) のことを \(n\) 回くり返したとき、何回起こるか」の確率の分布。名前は、式に出てくる \({}_{n}\mathrm{C}_{k}\) が二項係数(二項定理の係数)と同じものであることに由来します。高校では数学Bの「統計的な推測」で学びます。
確率変数 かくりつへんすう 値が確率で決まる変数のこと。このページでは「起こる回数」が確率変数で、0回から始まって最大でn回までの値を、それぞれ決まった確率で取ります。
試行 しこう コインを投げる・くじを1回引くなど、結果が偶然で決まる実験や観察の1回分のこと。
反復試行 はんぷくしこう 同じ試行を、毎回同じ確率で、互いの結果に影響しないように(独立に)くり返すこと。二項分布は反復試行での「成功回数」の分布です。
独立 どくりつ ある試行の結果が、別の試行の結果に影響しないこと。サイコロの1回目と2回目は独立ですが、引いたくじを戻さずに引き続ける場合は独立ではありません(前の結果で残りの当たりの数が変わるため)。
組み合わせ くみあわせ \(n\) 個から \(k\) 個を「順番を区別せずに」選ぶ選び方。その総数が \({}_{n}\mathrm{C}_{k}\) です。二項分布では「\(n\) 回のうちどの回で成功するか」の選び方の数として登場します。
累積確率 るいせきかくりつ 「ちょうど \(k\) 回」の確率を、ある回数まで足し合わせた確率。「\(k\) 回以下になる確率」\(P(X \leqq k)\) がその代表です。
余事象 よじしょう ある出来事が「起こらない」方の事象。確率の合計は必ず1なので、「\(k\) 回以上」のような確率は、1から反対側(\(k-1\) 回以下)の確率を引くと簡単に求められます。
期待値 きたいち その試行を何度も行ったときの平均の値。二項分布では「平均して何回起こるか」で、\(np\) というシンプルな式になります。
分散 ぶんさん 実際の値が期待値からどれくらいずれやすいか(ばらつき)を表す量。ずれの2乗の平均として定義されます。
標準偏差 ひょうじゅんへんさ 分散の平方根。分散は「2乗」の単位になってしまうので、平方根をとって元の単位(このページでは回数)に戻した、ばらつきの目安です。
正規分布 せいきぶんぷ 平均の近くが最も起こりやすく、平均から離れるほど起こりにくくなる、左右対称の釣り鐘型の分布。身長や測定誤差など世の中の多くの量がこの形に近く、二項分布も \(n\) が大きいと正規分布に近づきます。
正規近似 せいききんじ \(n\) が大きいときに、二項分布を正規分布 \(N(np,\ np(1-p))\) で置き換えて計算すること。\(np \geqq 5\) かつ \(n(1-p) \geqq 5\) が代表的な目安です。

前提として理解しておくといいこと

このページの計算を「意味がわかって」使えるようになるために、前提として理解しておくといいことをまとめました。
つまずいたら、この表の内容に戻って復習するのが近道です。

確率の基本(中学2年)
  • 確率が「起こりやすさ」を0から1までの数で表したものだとわかること(0.25 = 25% のような読み替えを含む)
  • 起こりうるすべての場合の確率を足すと必ず1になることがわかること
分数の計算(小学5年〜中学1年)
  • 分数の掛け算(\(\dfrac{1}{2} \times \dfrac{1}{2} = \dfrac{1}{4}\))と約分・通分ができること
  • 答えを分数のまま扱うことに慣れていること(\(\dfrac{3}{8}\) を 0.375 と直せること)
累乗・指数(中学1年〜高校 数学I)
  • \(p^{3} = p \times p \times p\) のように、右上の小さい数(指数)が「掛ける回数」を表すとわかること
  • \(\left(\dfrac{1}{2}\right)^{4} = \dfrac{1}{16}\) のような分数のべき乗が計算できること
場合の数・組み合わせ(高校 数学A)
  • \({}_{n}\mathrm{C}_{k}\) が「\(n\) 個から \(k\) 個を順番を区別せずに選ぶ選び方の数」だとわかること
  • \({}_{4}\mathrm{C}_{2} = \dfrac{4 \times 3}{2 \times 1} = 6\) のように計算できること
反復試行の確率・余事象(高校 数学A)
  • 「毎回同じ確率で独立にくり返す」という反復試行の設定がわかること
  • 「少なくとも1回」を \(1 - P(X = 0)\) で求める余事象の考え方が使えること
確率変数と期待値・分散(高校 数学B)
  • 確率変数(値が確率で決まる変数)と確率分布という言葉の意味がわかること
  • 期待値が「平均の値」、分散・標準偏差が「ばらつきの大きさ」を表すとわかること
正規分布(高校 数学B)
  • 正規分布が「平均の近くが起こりやすい左右対称の釣り鐘型の分布」だと知っていること(正規近似のカードを読むのに必要です)
  • \(N(\mu,\ \sigma^2)\) の括弧の中が「平均、分散」の順だと知っていること

Excelで計算する方法

Excelファイルをダウンロード
式ごとにシートが分かれたExcelファイルです。貼り付け場所を気にせず、開いてすぐ使えます。
下の表を丸ごとコピーして、ExcelのA1セルに貼り付けるとそのまま使えます。
「ちょうど k 回起こる確率」を求める表
試行回数 n 4
1回で成功する確率 p 0.5
成功する回数 k 2
ちょうど k 回起こる確率 P(X=k) =BINOM.DIST(B3,B1,B2,FALSE)
「累積確率(k 回以下・k 回以上)」を求める表
試行回数 n 4
1回で成功する確率 p 0.5
成功する回数 k 2
k 回以下になる確率 P(X≦k) =BINOM.DIST(B3,B1,B2,TRUE)
k 回以上になる確率 P(X≧k) =1-BINOM.DIST(B3-1,B1,B2,TRUE)
「期待値・分散・標準偏差」を求める表
試行回数 n 30
1回で成功する確率 p =1/6
期待値 E(X) = np =B1*B2
分散 V(X) = np(1-p) =B1*B2*(1-B2)
標準偏差 σ =SQRT(B4)
「正規分布による近似の目安」を確かめる表
試行回数 n 20
1回で成功する確率 p 0.5
np =B1*B2
n(1-p) =B1*(1-B2)
目安の判定 =IF(AND(B3>=5,B4>=5),"目安を満たす","目安を満たさない")
貼り付けると、上の行(n・p・k)が入力欄になり、下の行が自動計算の結果になります。
BINOM.DIST は二項分布の関数で、引数は「成功回数, 試行回数, 成功確率, 累積かどうか」の順です。最後を FALSE にすると「ちょうどの確率」、TRUE にすると「その回数以下の累積確率」になります。
1つ目の表はコインを4回投げて表がちょうど2回出る例で、答えは 0.375(= 3/8)になります。
2つ目の表の答えはどちらも 0.6875 です。「k 回以上」は「k−1 回以下」を1から引いて求めています(k に 0 を入れるとこの式はエラーになりますが、0回以上になる確率は必ず 1 です)。
3つ目の表はサイコロ30回で1の目が出る回数の例で、期待値 5・分散 4.1667・標準偏差 2.0412 になります。
4つ目の表は np と n(1−p) の両方が 5 以上かどうかで、正規分布による近似の目安を判定します。

Googleスプレッドシートで計算する方法

Excelファイルをダウンロード
上のExcelファイルをダウンロードし、Googleドライブにアップロードして開くと、そのままスプレッドシートとして使えます。
下の表を丸ごとコピーして、GoogleスプレッドシートのA1セルに貼り付けるとそのまま使えます。
「ちょうど k 回起こる確率」を求める表
試行回数 n 4
1回で成功する確率 p 0.5
成功する回数 k 2
ちょうど k 回起こる確率 P(X=k) =BINOMDIST(B3,B1,B2,FALSE)
「累積確率(k 回以下・k 回以上)」を求める表
試行回数 n 4
1回で成功する確率 p 0.5
成功する回数 k 2
k 回以下になる確率 P(X≦k) =BINOMDIST(B3,B1,B2,TRUE)
k 回以上になる確率 P(X≧k) =1-BINOMDIST(B3-1,B1,B2,TRUE)
「期待値・分散・標準偏差」を求める表
試行回数 n 30
1回で成功する確率 p =1/6
期待値 E(X) = np =B1*B2
分散 V(X) = np(1-p) =B1*B2*(1-B2)
標準偏差 σ =SQRT(B4)
「正規分布による近似の目安」を確かめる表
試行回数 n 20
1回で成功する確率 p 0.5
np =B1*B2
n(1-p) =B1*(1-B2)
目安の判定 =IF(AND(B3>=5,B4>=5),"目安を満たす","目安を満たさない")
Googleスプレッドシートでは関数名が BINOMDIST になります(引数の順番はExcelのBINOM.DISTと同じ「成功回数, 試行回数, 成功確率, 累積かどうか」です)。表を丸ごとコピーしてA1セルに貼り付け、n・p・k を自分の数値に書き換えてください。
「k 回以上」の式は k に 0 を入れるとエラーになる点もExcelと同じです(0回以上になる確率は必ず 1 です)。

Pythonで計算する方法

from fractions import Fraction
from math import comb, sqrt

trial_count = 4                  # 試行回数 n
success_prob = Fraction(1, 2)    # 1回で成功する確率 p(0.3 のような小数でも可)
success_count = 2                # 成功する回数 k

failure_prob = 1 - success_prob

# ちょうど k 回起こる確率 P(X=k) = nCk × p^k × (1−p)^(n−k)
exact_prob = (comb(trial_count, success_count)
              * success_prob ** success_count
              * failure_prob ** (trial_count - success_count))
print(f"ちょうど{success_count}回の確率: {exact_prob} = {float(exact_prob)}")

# 累積確率(k 回以下・k 回以上)
prob_le = sum(comb(trial_count, i) * success_prob ** i * failure_prob ** (trial_count - i)
              for i in range(success_count + 1))
prob_ge = 1 - prob_le + exact_prob
print(f"{success_count}回以下の確率: {prob_le} = {float(prob_le)}")
print(f"{success_count}回以上の確率: {prob_ge} = {float(prob_ge)}")

# 期待値・分散・標準偏差
mean = trial_count * success_prob
variance = mean * failure_prob
print(f"期待値: {mean}  分散: {variance}  標準偏差: {sqrt(variance)}")
標準ライブラリだけで動きます。fractions モジュールを使うと、小数の丸め誤差なしの厳密な分数のまま計算できます(comb は組み合わせの数 nCk)。この例はコインを4回投げて表がちょうど2回出るケースで、実行すると確率 3/8 = 0.375、2回以下・2回以上はどちらも 11/16 = 0.6875、期待値 2・分散 1・標準偏差 1.0 が表示されます。n・p・k の3つの数値を書き換えて実行してください。

数式記述言語(LaTeX等)での書き方(コピペ可)

二項分布の確率(ちょうど \(k\) 回起こる確率)
P(X = k) = nCk pᵏ (1 − p)ⁿ⁻ᵏ
P(X = k) = \binom{n}{k} p^{k} (1 - p)^{n - k}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>P</mi><mo>(</mo><mi>X</mi><mo>=</mo><mi>k</mi><mo>)</mo>
    <mo>=</mo>
    <mrow>
      <mo>(</mo>
      <mfrac linethickness="0"><mi>n</mi><mi>k</mi></mfrac>
      <mo>)</mo>
    </mrow>
    <msup><mi>p</mi><mi>k</mi></msup>
    <msup>
      <mrow><mo>(</mo><mn>1</mn><mo>&#x2212;</mo><mi>p</mi><mo>)</mo></mrow>
      <mrow><mi>n</mi><mo>&#x2212;</mo><mi>k</mi></mrow>
    </msup>
  </mrow>
</math>
P(X = k) = C(n,k) p^k (1-p)^(n-k)
PDF[BinomialDistribution[n, p], k]
binomial(n, k)*p^k*(1-p)^(n-k);
binopdf(k, n, p)
P(X=k) = C(n,k) p^k (1-p)^(n-k)
累積確率(\(k\) 回以下・\(k\) 回以上になる確率)
P(X ≦ k) = Σ[i=0→k] nCi pⁱ (1 − p)ⁿ⁻ⁱ
P(X \leqq k) = \sum_{i=0}^{k} \binom{n}{i} p^{i} (1 - p)^{n - i}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>P</mi><mo>(</mo><mi>X</mi><mo>&#x2266;</mo><mi>k</mi><mo>)</mo>
    <mo>=</mo>
    <munderover>
      <mo>&#x2211;</mo>
      <mrow><mi>i</mi><mo>=</mo><mn>0</mn></mrow>
      <mi>k</mi>
    </munderover>
    <mrow>
      <mo>(</mo>
      <mfrac linethickness="0"><mi>n</mi><mi>i</mi></mfrac>
      <mo>)</mo>
    </mrow>
    <msup><mi>p</mi><mi>i</mi></msup>
    <msup>
      <mrow><mo>(</mo><mn>1</mn><mo>&#x2212;</mo><mi>p</mi><mo>)</mo></mrow>
      <mrow><mi>n</mi><mo>&#x2212;</mo><mi>i</mi></mrow>
    </msup>
  </mrow>
</math>
P(X <= k) = sum_(i=0)^k C(n,i) p^i (1-p)^(n-i)
CDF[BinomialDistribution[n, p], k]
add(binomial(n, i)*p^i*(1-p)^(n-i), i = 0..k);
binocdf(k, n, p)
P(X≤k) = Σ_(i=0)^k C(n,i) p^i (1-p)^(n-i)
二項分布の期待値・分散・標準偏差
E(X) = np,  V(X) = np(1 − p),  σ = √(np(1 − p))
E(X) = np, \quad V(X) = np(1 - p), \quad \sigma = \sqrt{np(1 - p)}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>E</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo><mi>n</mi><mi>p</mi>
    <mo>,</mo>
    <mi>V</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo>
    <mi>n</mi><mi>p</mi>
    <mrow><mo>(</mo><mn>1</mn><mo>&#x2212;</mo><mi>p</mi><mo>)</mo></mrow>
    <mo>,</mo>
    <mi>&#x3C3;</mi><mo>=</mo>
    <msqrt><mi>n</mi><mi>p</mi><mrow><mo>(</mo><mn>1</mn><mo>&#x2212;</mo><mi>p</mi><mo>)</mo></mrow></msqrt>
  </mrow>
</math>
E(X) = np, V(X) = np(1-p), sigma = sqrt(np(1-p))
{Mean[BinomialDistribution[n, p]], Variance[BinomialDistribution[n, p]], StandardDeviation[BinomialDistribution[n, p]]}
n*p; n*p*(1-p); sqrt(n*p*(1-p));
[m, v] = binostat(n, p); s = sqrt(v);
E(X) = np, V(X) = np(1-p), σ = √(np(1-p))
正規分布による近似(\(np \geqq 5\) かつ \(n(1-p) \geqq 5\) が目安)
B(n, p) ≒ N(np, np(1 − p))
B(n,\ p) \approx N(np,\ np(1 - p))
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>B</mi><mo>(</mo><mi>n</mi><mo>,</mo><mi>p</mi><mo>)</mo>
    <mo>&#x2252;</mo>
    <mi>N</mi><mo>(</mo><mi>n</mi><mi>p</mi><mo>,</mo>
    <mi>n</mi><mi>p</mi>
    <mrow><mo>(</mo><mn>1</mn><mo>&#x2212;</mo><mi>p</mi><mo>)</mo></mrow>
    <mo>)</mo>
  </mrow>
</math>
B(n, p) ~~ N(np, np(1-p))
NormalDistribution[n p, Sqrt[n p (1 - p)]]
Normal(n*p, sqrt(n*p*(1-p)));
pd = makedist('Normal', 'mu', n*p, 'sigma', sqrt(n*p*(1-p)));
B(n, p) ≈ N(np, np(1-p))

ChatGPT に聞いて計算してもらう方法

あなたは数学(確率・統計)の計算アシスタントです。次の計算を、必ずPythonコードを実際に実行して行い、実行結果の数値だけを根拠に回答してください(暗算や推測で答えないでください)。

当たり確率 1/6 のくじを10回引くとき、当たりの回数の二項分布について次を求めてください。
1. ちょうど2回当たる確率 P(X=2)(約分済みの分数と小数の両方で)
2. 2回以下になる確率 P(X≦2) と、2回以上になる確率 P(X≧2)
3. 期待値 E(X)・分散 V(X)・標準偏差 σ
4. np ≧ 5 かつ n(1−p) ≧ 5 という正規分布による近似の目安を満たすかどうか

Pythonでは標準ライブラリの fractions と math.comb を使って厳密に計算し、計算に使った式と実行結果の数値を示してください。

計算ドリル(演習問題)

このページの式を、自分の手で計算できるようになるための演習問題です。
答えと解説は解答ページにあります。


使い方
  1. 1
    数値を入力
    計算したい数値を入力欄に入力します
  2. 2
    計算
    「計算する」ボタンを押します
  3. 3
    結果を確認
    計算結果がその場に表示されます。計算の考え方や式の解説も同じページで確認できます
  DataChefの特徴
簡単・無料
無料で回数無制限の変換
専門知識不要、直感的で簡単な操作
会員登録不要
アクセス直後に利用可能
個人情報を登録することなく使用できます
安全・安心
通信を高度に暗号化
「ダウンロード」押下でファイルを自動削除
高速
ストレスのない快適な表示速度・変換速度
透かしなし
ウォーターマークなし
クレジット表記不要
商用利用可能
無料で商用利用可能
商用利用許諾の連絡も不要です