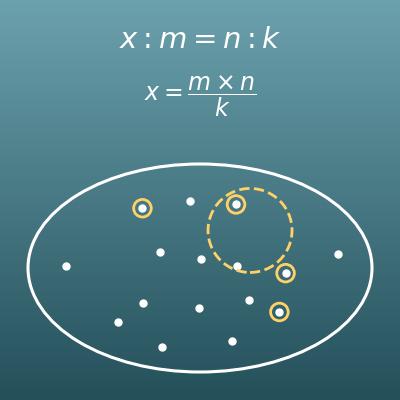
標本の大きさ・標本平均・標準偏差・信頼水準を入力してください。母平均の信頼区間(下限・上限)と誤差の範囲、主な信頼水準の一覧表を計算します。
このページでできること
- 標本の大きさ \(n\)・標本平均 \(\bar{x}\)・標準偏差 \(\sigma\)・信頼水準(%)を入れるだけで、母平均の信頼区間(下限・上限)がその場でわかります
- 誤差の範囲 \(E\)(±いくつまでずれうるか)・標準誤差・信頼水準に応じたz値も同時に計算します
- 90%・95%・99%など主な信頼水準の信頼区間を一覧表でまとめて確認でき、区間の広がり方をグラフでも確かめられます
- 式のやさしい解説・Excel/Googleスプレッドシート/Python用のコピペ数式・計算ドリル(演習問題)もこのページにまとまっています
この計算は何の役に立つ?
「内閣支持率45%(誤差±2.5ポイント)」のような調査結果の「誤差」は、まさにこのページの誤差の範囲 \(E\) です。支持率45%・回答者1600人の調査なら、ばらつきは \(\sigma = \sqrt{0.45 \times 0.55} \fallingdotseq 0.497\) なので、95%信頼水準で \(E = 1.96 \times 0.497 \div \sqrt{1600} \fallingdotseq 0.024\)(約±2.4ポイント)になります(回答の割合を正規分布で近似できるとした場合の計算です。報道の「±2.5ポイント」は、ばらつきが最大になる支持率50%として見積もった値にあたります)。
「支持率が1ポイント動いた」というニュースが誤差の範囲内かどうか、自分で判断できるようになります。
全部のペットボトルを開けて量るわけにはいかないので、工場では一部を抜き取って検査します。50本の平均が500.2mL・ばらつき(標準偏差)が2mLなら、全生産品の平均内容量の95%信頼区間は約499.65~500.75mLと見積もれます。
「表示量を下回っていないか」を、抜き取り検査だけで統計的に確認する——食品・飲料・薬品などの製造現場で毎日使われている計算です。
「新薬で血圧が平均8.0mmHg下がった(95%信頼区間:5.6~10.4)」のように、医学論文の結果はほぼ必ず信頼区間つきで報告されます(100人の試験で、低下量のばらつきが標準偏差12mmHgの場合、\(E = 1.96 \times 12 \div \sqrt{100} \fallingdotseq 2.4\) です)。
区間全体がプラス側(0をまたがない)なら「効果があった」と判断する材料になり、区間が0をまたぐなら「偶然かもしれない」と読みます。健康情報を自分で吟味するときの、一番大事な読み方の一つです。
全国の児童全員を調べるのは大変なので、体力・学力などの全国調査の一部は標本調査で行われます。例えば400人の標本で50m走の平均が9.2秒・標準偏差0.8秒なら、全体の平均タイムの95%信頼区間は約9.12~9.28秒と、わずか400人からかなり狭い幅で見積もれます。
国の統計(労働力調査・家計調査など)も標本調査が中心で、その精度の裏づけにこの計算が使われています。
サイトの平均滞在時間が180秒から184秒に伸びたとき、それは改善の効果でしょうか、それともたまたまでしょうか。訪問者2500人・標準偏差90秒なら平均滞在時間の95%信頼区間は約176.5~183.5秒で、幅が約±3.5秒あるとわかります。
変化が信頼区間の幅と同じくらいなら「まだ偶然と区別がつかない」と判断できます。ABテストの結果を読み違えないための土台になる考え方です。
式とグラフ
用語・記号の解説
記号
| \(n\) | エヌ | 標本の大きさ(サンプルサイズ)。実際に調べた個数・人数です。(例:50本量ったら \(n = 50\)) |
| \(\bar{x}\) | エックス・バー | 標本平均。調べた標本の平均値です。上の横棒(バー)は「平均」を表す記号です。 |
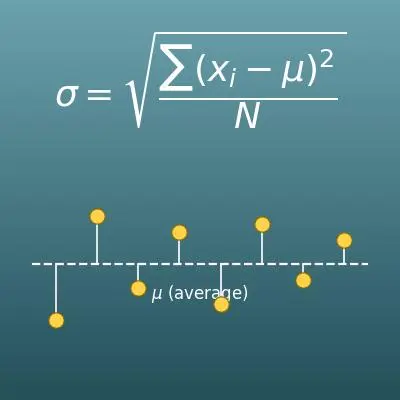
| \(\sigma\) | シグマ | 母標準偏差。母集団全体でのばらつきの大きさです。ギリシャ文字で、英語のsにあたります。標本が十分大きければ、標本から求めた標準偏差で代用できます。 |
| \(\sqrt{n}\) | ルート・エヌ | 標本の大きさの平方根。(例:\(\sqrt{25} = 5\))標準誤差の分母に現れ、データを4倍にしても誤差が半分にしかならない理由がこの平方根です。 |
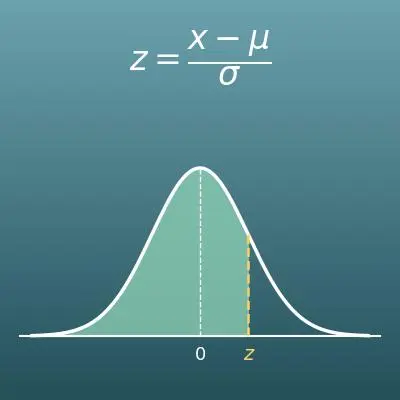
| \(z\) | ゼット(z値) | 信頼水準に応じて決まる倍率。標準正規分布で「まん中に信頼水準の分がちょうど収まる境界の位置」です。95%なら約1.96です。 |
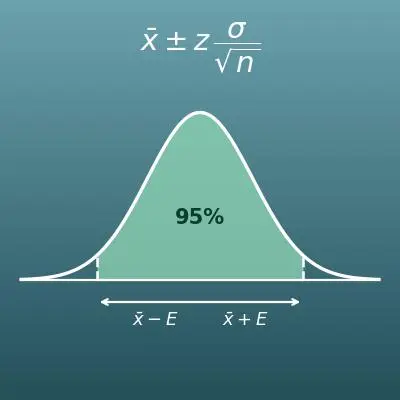
| \(E\) | イー | 誤差の範囲(誤差限界)。信頼区間の半分の幅で、「標本平均が母平均から±いくつまでずれうるか」の目安です。margin of error の頭文字です。 |
| \(L,\ U\) | エル・ユー | 信頼区間の下限(Lower)と上限(Upper)。\(L = \bar{x} - E\)、\(U = \bar{x} + E\) で求めます。 |
| \(\Phi^{-1}\) | ファイ・インバース(Φの逆関数) | 標準正規分布の累積分布関数 \(\Phi\) の逆向きの関数。「確率(面積)」から「そうなるz値」を返します。(例:\(\Phi^{-1}(0.975) \fallingdotseq 1.96\)) |
| \(C\) | シー | 信頼水準を小数で表したもの。95%なら \(C = 0.95\) です。 |
用語
| 信頼区間 | しんらいくかん | 標本のデータから「母平均はこの範囲にありそうだ」と見積もった区間。標本平均を中心に、誤差の範囲だけ上下に広げて作ります。 |
| 信頼水準 | しんらいすいじゅん | 区間の確からしさの度合い。「同じ方法で区間を作る作業をくり返したとき、区間が母平均を含む割合」で、95%が最もよく使われます。信頼係数とも呼ばれます。 |
| 母集団 | ぼしゅうだん | 本当は全部調べたい対象の全体。(例:工場で作られる全ペットボトル、全国の有権者全員) |
| 標本 | ひょうほん | 母集団から実際に抜き出して調べた一部分。サンプルとも呼びます。標本から母集団の姿を推し量るのが統計の推定です。 |
| 母平均 | ぼへいきん | 母集団全体の平均。全部は調べられないので正確な値はわかりません。この「わからない値」の居場所を見積もるのが信頼区間です。記号は \(\mu\)(ミュー)を使うのが一般的です。 |
| 標本平均 | ひょうほんへいきん | 標本の平均 \(\bar{x}\) のこと。母平均の「一番もっともらしい1点の見積もり(点推定)」ですが、標本の取り方によって毎回少しずつ変わります。 |
| 標準誤差 | ひょうじゅんごさ | 標本平均そのもののばらつきの大きさ。\(\sigma \div \sqrt{n}\) で求めます。データ1個1個のばらつき(標準偏差)と混同しやすいので注意してください。 |
| 区間推定 | くかんすいてい | 母平均などのわからない値を、1点ではなく「幅を持った区間」で見積もる方法。1点で見積もる点推定に対して、外れうる誤差まで込みで示せるのが長所です。 |
| t分布 | ティーぶんぷ | 標本が小さく母標準偏差もわからないときに、正規分布(z)の代わりに使う分布。このページの計算機はz方式のみ対応しています。標本が大きくなるほどt分布は正規分布に近づき、結果はほぼ同じになります。 |
前提として理解しておくといいこと
このページの計算を「意味がわかって」使えるようになるために、前提として理解しておくといいことをまとめました。
| 平均(小学5年) |
|
| 平方根(中学3年) |
|
| 標本調査(中学3年) |
|
| データの分析・標準偏差(高校 数学I) |
|
| 正規分布と区間推定(高校 数学B/統計) |
|
Excelで計算する方法
| 信頼水準(%) | 95 |
| z値 | =NORM.S.INV((1+B1/100)/2) |
| z値 | 1.96 |
| 標準偏差 σ | 2 |
| 標本の大きさ n | 25 |
| 誤差の範囲 E | =B1*B2/SQRT(B3) |
| 標本の大きさ n | 50 |
| 標本平均 x̄ | 500.2 |
| 標準偏差 σ | 2 |
| 信頼水準(%) | 95 |
| z値 | =NORM.S.INV((1+B4/100)/2) |
| 誤差の範囲 E | =B5*B3/SQRT(B1) |
| 信頼区間の下限 | =B2-B6 |
| 信頼区間の上限 | =B2+B6 |
1つ目の表は信頼水準(B1)だけからz値を求める表で、95と入れるとB2は約1.959964になります。2つ目の表は誤差の範囲で、例の値だとB4は0.784です。
3つ目の表は入力からまとめて信頼区間を出す表で、例の値(n=50、x̄=500.2、σ=2、95%)だと下限(B7)は約499.6456、上限(B8)は約500.7544になります。B1〜B4を自分の数値に書き換えるだけで使えます。
Googleスプレッドシートで計算する方法
| 信頼水準(%) | 95 |
| z値 | =NORMSINV((1+B1/100)/2) |
| z値 | 1.96 |
| 標準偏差 σ | 2 |
| 標本の大きさ n | 25 |
| 誤差の範囲 E | =B1*B2/SQRT(B3) |
| 標本の大きさ n | 50 |
| 標本平均 x̄ | 500.2 |
| 標準偏差 σ | 2 |
| 信頼水準(%) | 95 |
| z値 | =NORMSINV((1+B4/100)/2) |
| 誤差の範囲 E | =B5*B3/SQRT(B1) |
| 信頼区間の下限 | =B2-B6 |
| 信頼区間の上限 | =B2+B6 |
表を丸ごとコピーしてA1セルに貼り付け、B列の数字を自分の数値に書き換えて使ってください。値の出方はExcel版と同じで、3つ目の表なら下限が約499.6456、上限が約500.7544になります。
Pythonで計算する方法
import math
from statistics import NormalDist

sample_size = 50        # 標本の大きさ n
sample_mean = 500.2     # 標本平均 x̄
sd = 2                  # 標準偏差 σ
confidence_level = 95   # 信頼水準(%)

z = NormalDist().inv_cdf((1 + confidence_level / 100) / 2)  # 信頼水準に応じたz値
standard_error = sd / math.sqrt(sample_size)                # 標準誤差 σ ÷ √n
margin_of_error = z * standard_error                        # 誤差の範囲 E
lower = sample_mean - margin_of_error                       # 信頼区間の下限
upper = sample_mean + margin_of_error                       # 信頼区間の上限

print(f"z値: {z}")
print(f"誤差の範囲 E: {margin_of_error}")
print(f"{confidence_level}%信頼区間: {lower} ~ {upper}")
数式記述言語(LaTeX等)での書き方(コピペ可)
E = z × σ ÷ √n
E = z \times \dfrac{\sigma}{\sqrt{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi>
<mo>=</mo>
<mi>z</mi>
<mo>×</mo>
<mfrac>
<mi>σ</mi>
<msqrt><mi>n</mi></msqrt>
</mfrac>
</mrow>
</math>
E = z sigma / sqrt(n)
z*sigma/Sqrt[n]
E := z*sigma/sqrt(n);
E = z*sigma/sqrt(n);
E = zσ/√n
L = x̄ − E, U = x̄ + E
L = \bar{x} - E,\quad U = \bar{x} + E
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>L</mi>
<mo>=</mo>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>−</mo>
<mi>E</mi>
<mo>,</mo>
<mspace width="1em"/>
<mi>U</mi>
<mo>=</mo>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>+</mo>
<mi>E</mi>
</mrow>
</math>
L = bar x - E, U = bar x + E
{xbar - e, xbar + e}
L := xbar - E; U := xbar + E;
L = xbar - E; U = xbar + E;
L = x̄ - E, U = x̄ + E
z = Φ⁻¹((1 + C) ÷ 2)
z = \Phi^{-1}\!\left(\dfrac{1+C}{2}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi>
<mo>=</mo>
<msup><mi>Φ</mi><mrow><mo>−</mo><mn>1</mn></mrow></msup>
<mrow>
<mo>(</mo>
<mfrac>
<mrow><mn>1</mn><mo>+</mo><mi>C</mi></mrow>
<mn>2</mn>
</mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
z = Phi^-1((1 + C)/2)
InverseCDF[NormalDistribution[0, 1], (1 + c)/2]
with(Statistics): Quantile(RandomVariable(Normal(0, 1)), (1 + c)/2);
z = norminv((1 + c)/2);
z = Φ^(-1)((1+C)/2)
ChatGPT に聞いて計算してもらう方法
あなたは統計の計算アシスタントです。次の計算を、必ずPythonコードを実際に実行して行い、実行結果の数値だけを根拠に回答してください(暗算や推測で答えないでください)。

工場のラインからペットボトル50本を抜き取って内容量を量ったところ、平均は500.2mLでした。充填量のばらつき(母標準偏差)は2mLとわかっています。
1. 信頼水準95%に対応するz値を求めてください(標準正規分布の累積分布関数の逆関数を使ってください。Pythonの標準ライブラリ statistics.NormalDist().inv_cdf が使えます)。
2. 誤差の範囲 E = z × σ ÷ √n を求めてください。
3. 母平均(全ペットボトルの本当の平均内容量)の95%信頼区間(下限と上限)を求めてください。

計算に使った式と、実行結果の数値を示してください。
計算ドリル(演習問題)
このページの式を、自分の手で計算できるようになるための演習問題です。\(z\)値は暗算しやすいように丸めています(実際の95%の \(z\)値は約1.96です)。
答えと解説は解答ページにあります。
使い方
-
1数値を入力計算したい数値を入力欄に入力します
-
2計算「計算する」ボタンを押します
-
3結果を確認計算結果がその場に表示されます。計算の考え方や式の解説も同じページで確認できます
DataChefの特徴

専門知識不要、直感的で簡単な操作
個人情報を登録することなく使用できます
「ダウンロード」押下でファイルを自動削除
クレジット表記不要
商用利用許諾の連絡も不要です
関連機能
サンプルサイズ計算機
許容する誤差と信頼水準から、調査に必要な標本の大きさを逆算します
Zスコアの計算
値・平均・標準偏差からzスコア(標準得点)を計算し、確率と相互変換します
正規分布の確率
平均と標準偏差から、指定した範囲に入る確率を計算します