Geben Sie Stichprobenumfang, Stichprobenmittel, Standardabweichung und Konfidenzniveau ein. Der Rechner bestimmt das Konfidenzintervall für den Mittelwert der Grundgesamtheit (untere und obere Grenze), die Fehlermarge und eine Tabelle für die üblichen Konfidenzniveaus.
Inhaltsverzeichnis
-
Das können Sie auf dieser Seite
-
Wofür braucht man diese Berechnung?
-
Anleitung
-
Formeln und Graphen
-
Symbole und Begriffe
-
Das sollten Sie vorher wissen
-
So berechnen Sie es in Excel
-
So berechnen Sie es in Google Tabellen
-
So berechnen Sie es in Python
-
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
-
So lassen Sie ChatGPT rechnen
-
Die Vorteile von DataChef
-
Verwandte Funktionen
-
Alle Rechner von NumberChef
Das können Sie auf dieser Seite
- Geben Sie den Stichprobenumfang \(n\), das Stichprobenmittel \(\bar{x}\), die Standardabweichung \(\sigma\) und das Konfidenzniveau (%) ein – und Sie sehen sofort das Konfidenzintervall für den Mittelwert der Grundgesamtheit (untere und obere Grenze)
- Gleichzeitig berechnet werden die Fehlermarge \(E\) (um wie viel die Schätzung nach oben oder unten abweichen kann), der Standardfehler und der zum Konfidenzniveau passende z-Wert
- Die Konfidenzintervalle für die üblichen Niveaus 90 %, 95 % und 99 % stehen übersichtlich in einer Tabelle, und ein Graph zeigt, wie das Intervall breiter wird
- Dazu eine verständliche Erklärung der Formeln sowie fertige Formeln zum Kopieren für Excel, Google Tabellen und Python
Wofür braucht man diese Berechnung?
Die „Fehlertoleranz“ in einem Umfrageergebnis wie „45 % sind mit der Bundesregierung zufrieden (Fehlertoleranz ±2,5 Prozentpunkte)“ ist genau die Fehlermarge \(E\) auf dieser Seite. Bei 45 % Zustimmung und 1.600 Befragten ist die Streuung \(\sigma = \sqrt{0{,}45 \times 0{,}55} \approx 0{,}497\), beim Konfidenzniveau 95 % also \(E = 1{,}96 \times 0{,}497 \div \sqrt{1600} \approx 0{,}024\) (etwa ±2,4 Prozentpunkte). Dabei nimmt man an, dass sich der Anteil der Antworten durch eine Normalverteilung annähern lässt. Die „±2,5 Prozentpunkte“ in Medienberichten entsprechen einer Schätzung mit 50 % Zustimmung, bei der die Streuung am größten ist.
So können Sie selbst beurteilen, ob eine Meldung wie „Zustimmung um 1 Prozentpunkt gestiegen“ noch innerhalb der Fehlertoleranz liegt.
Eine Fabrik kann nicht jede Flasche öffnen und nachmessen, deshalb prüft sie eine Stichprobe. Haben 50 Flaschen einen mittleren Inhalt von 500,2 ml bei einer Standardabweichung von 2 ml, so liegt das 95-%-Konfidenzintervall für den mittleren Inhalt der gesamten Produktion bei etwa 499,65 bis 500,75 ml.
Allein mit Stichproben statistisch zu prüfen, dass die angegebene Füllmenge nicht unterschritten wird – diese Rechnung wird in der Lebensmittel-, Getränke- und Arzneimittelherstellung jeden Tag gebraucht.
Ergebnisse in medizinischen Studien werden fast immer mit einem Konfidenzintervall angegeben, etwa „Das neue Medikament senkte den Blutdruck im Mittel um 8,0 mmHg (95-%-Konfidenzintervall: 5,6 bis 10,4)“. In einer Studie mit 100 Personen, in der die Senkung eine Standardabweichung von 12 mmHg hat, ist \(E = 1{,}96 \times 12 \div \sqrt{100} \approx 2{,}4\).
Liegt das ganze Intervall im positiven Bereich (es enthält die 0 nicht), spricht das für eine Wirkung des Medikaments. Enthält das Intervall die 0, kann das Ergebnis auch Zufall sein. Das ist eine der wichtigsten Regeln, um Gesundheitsinformationen selbst zu prüfen.
Alle Schülerinnen und Schüler des Landes zu testen, wäre ein riesiger Aufwand. Deshalb arbeiten bundesweite Studien zu Fitness und Schulleistungen oft mit Stichproben. Läuft eine Stichprobe von 400 Kindern die 50 m im Mittel in 9,2 Sekunden bei einer Standardabweichung von 0,8 Sekunden, so liegt das 95-%-Konfidenzintervall für die mittlere Zeit aller Kinder bei etwa 9,12 bis 9,28 Sekunden. Schon 400 Kinder ergeben einen recht schmalen Bereich.
Auch die amtliche Statistik beruht zu einem großen Teil auf Stichproben – etwa der Mikrozensus des Statistischen Bundesamts, für den rund 1 % der Haushalte in Deutschland befragt wird. Diese Rechnung belegt, wie genau solche Zahlen sind.
Die mittlere Verweildauer auf Ihrer Website steigt von 180 auf 184 Sekunden – ist das die Wirkung Ihrer Änderung oder nur Zufall? Bei 2.500 Besuchern und einer Standardabweichung von 90 Sekunden liegt das 95-%-Konfidenzintervall für die mittlere Verweildauer bei etwa 176,5 bis 183,5 Sekunden, also bei rund ±3,5 Sekunden.
Ist eine Veränderung etwa so groß wie die Breite des Konfidenzintervalls, lässt sie sich noch nicht vom Zufall unterscheiden. Dieser Gedanke ist die Grundlage, um Ergebnisse von A/B-Tests nicht falsch zu lesen.
Formeln und Graphen
Symbole und Begriffe
Symbole
| \(n\) | n | Der Stichprobenumfang: wie viele Stücke oder Personen Sie tatsächlich gemessen haben (Beispiel: 50 Flaschen gemessen, also \(n = 50\)). |
| \(\bar{x}\) | x quer | Das Stichprobenmittel, der Mittelwert der gemessenen Stichprobe. Der Strich darüber ist das Zeichen für einen Mittelwert. |
| \(\sigma\) | Sigma | Die Standardabweichung der Grundgesamtheit, also wie stark die ganze Grundgesamtheit streut. Ein griechischer Buchstabe, der unserem s entspricht. Ist die Stichprobe groß genug, kann man stattdessen die Standardabweichung der Stichprobe verwenden. |
| \(\sqrt{n}\) | Wurzel aus n | Die Quadratwurzel aus dem Stichprobenumfang (Beispiel: \(\sqrt{25} = 5\)). Sie steht im Nenner des Standardfehlers und ist der Grund, warum viermal so viele Daten den Fehler nur halbieren. |
| \(z\) | z (z-Wert) | Der Faktor, der sich aus dem Konfidenzniveau ergibt. Er ist die Grenze auf der Standardnormalverteilung, zwischen der in der Mitte genau das Konfidenzniveau liegt. Für 95 % ist er etwa 1,96. |
| \(E\) | E | Die Fehlermarge (auch Fehlerspanne). Sie ist die halbe Breite des Konfidenzintervalls und ein Richtwert dafür, um wie viel das Stichprobenmittel nach oben oder unten vom Mittelwert der Grundgesamtheit abweichen kann. E steht für „Error“ (Fehler). |
| \(L,\ U\) | L, U | Untere und obere Grenze des Konfidenzintervalls (vom Englischen „lower“ und „upper“). Man berechnet sie mit \(L = \bar{x} - E\) und \(U = \bar{x} + E\). |
| \(\Phi^{-1}\) | Phi hoch minus eins (Umkehrfunktion von Φ) | Die Umkehrfunktion von \(\Phi\), der Verteilungsfunktion der Standardnormalverteilung. Sie nimmt eine Wahrscheinlichkeit (Fläche) und liefert den passenden z-Wert (Beispiel: \(\Phi^{-1}(0{,}975) \approx 1{,}96\)). |
| \(C\) | C | Das Konfidenzniveau als Dezimalzahl. Für 95 % ist \(C = 0{,}95\). |
Begriffe
| Konfidenzintervall | Ein aus Stichprobendaten geschätzter Bereich, in dem der Mittelwert der Grundgesamtheit vermutlich liegt (auch Vertrauensintervall). Man bildet es, indem man das Stichprobenmittel um die Fehlermarge nach oben und unten erweitert. |
| Konfidenzniveau | Wie sicher das Intervall ist. Es ist der Anteil der Intervalle, die den Mittelwert der Grundgesamtheit enthalten würden, wenn man immer wieder auf dieselbe Weise Intervalle bildet. Am häufigsten verwendet man 95 %. Man spricht auch von Vertrauensniveau. |
| Grundgesamtheit | Die gesamte Gruppe, die man eigentlich untersuchen möchte (Beispiele: alle Flaschen, die eine Fabrik abfüllt, oder alle Wahlberechtigten in Deutschland). |
| Stichprobe | Der Teil der Grundgesamtheit, den man tatsächlich auswählt und untersucht. Von der Stichprobe auf die Grundgesamtheit zu schließen, ist die Aufgabe der schließenden Statistik. |
| Stichprobenumfang | Die Anzahl der Werte (Stücke, Personen) in der Stichprobe, kurz \(n\). Im Englischen „sample size“. |
| Mittelwert der Grundgesamtheit | Der Mittelwert der ganzen Grundgesamtheit. Da man nicht alles messen kann, kennt man seinen genauen Wert nicht. Ein Konfidenzintervall schätzt, wo dieser unbekannte Wert liegt. Meist schreibt man ihn \(\mu\) (My). |
| Stichprobenmittel | Der Mittelwert der Stichprobe, \(\bar{x}\). Er ist die plausibelste Schätzung des Mittelwerts der Grundgesamtheit mit einem einzigen Wert (Punktschätzung), ändert sich aber jedes Mal ein wenig, je nachdem, welche Stichprobe man zieht. |
| Standardfehler | Wie stark das Stichprobenmittel selbst streut, berechnet mit \(\sigma \div \sqrt{n}\). Er wird leicht mit der Streuung der einzelnen Werte (der Standardabweichung) verwechselt – achten Sie auf den Unterschied. |
| Intervallschätzung | Eine Methode, einen unbekannten Wert wie den Mittelwert der Grundgesamtheit nicht mit einer einzigen Zahl, sondern mit einem Bereich zu schätzen. Gegenüber der Punktschätzung hat sie den Vorteil, dass sie auch zeigt, wie weit die Schätzung danebenliegen kann. |
| t-Verteilung | Die Verteilung, die man statt der Normalverteilung (z) verwendet, wenn die Stichprobe klein und die Standardabweichung der Grundgesamtheit unbekannt ist. Der Rechner auf dieser Seite arbeitet nur mit z. Je größer die Stichprobe, desto ähnlicher wird die t-Verteilung der Normalverteilung, und die Ergebnisse sind fast gleich. |
Das sollten Sie vorher wissen
Damit Sie die Berechnung auf dieser Seite wirklich verstehen und nicht nur auf die Schaltfläche klicken, hilft Ihnen dieses Vorwissen.
| Der Mittelwert (Klasse 5–6, 10–12 Jahre) |
|
| Quadratwurzeln (Klasse 8–9, 13–15 Jahre) |
|
| Stichproben (Klasse 8–10, 13–16 Jahre) |
|
| Datenanalyse und Standardabweichung (Klasse 10–11, 15–17 Jahre) |
|
| Normalverteilung und Intervallschätzung (Oberstufe, Klasse 11–13, 16–19 Jahre) |
|
So berechnen Sie es in Excel
| Niveau (%) | 95 |
| z | =NORM.S.INV((1+B1/100)/2) |
| z | 1,96 |
| Standardabw. σ | 2 |
| Stichprobenumfang n | 25 |
| Fehlermarge E | =B1*B2/WURZEL(B3) |
| Stichprobenumfang n | 50 |
| Stichprobenmittel x̄ | 500,2 |
| Standardabw. σ | 2 |
| Niveau (%) | 95 |
| z | =NORM.S.INV((1+B4/100)/2) |
| Fehlermarge E | =B5*B3/WURZEL(B1) |
| Untere Grenze | =B2-B6 |
| Obere Grenze | =B2+B6 |
Die erste Tabelle bestimmt z allein aus dem Konfidenzniveau (B1). Bei 95 % ergibt B2 etwa 1,959964. Die zweite Tabelle berechnet die Fehlermarge; mit den Beispielwerten ergibt B4 den Wert 0,784.
Die dritte Tabelle berechnet das Konfidenzintervall aus allen Eingaben auf einmal. Mit den Beispielwerten (n = 50, x̄ = 500,2, σ = 2, 95 %) liegt die untere Grenze (B7) bei etwa 499,6456 und die obere Grenze (B8) bei etwa 500,7544. Ersetzen Sie einfach B1 bis B4 durch Ihre eigenen Werte.
So berechnen Sie es in Google Tabellen
| Niveau (%) | 95 |
| z | =STANDNORMINV((1+B1/100)/2) |
| z | 1,96 |
| Standardabw. σ | 2 |
| Stichprobenumfang n | 25 |
| Fehlermarge E | =B1*B2/WURZEL(B3) |
| Stichprobenumfang n | 50 |
| Stichprobenmittel x̄ | 500,2 |
| Standardabw. σ | 2 |
| Niveau (%) | 95 |
| z | =STANDNORMINV((1+B4/100)/2) |
| Fehlermarge E | =B5*B3/WURZEL(B1) |
| Untere Grenze | =B2-B6 |
| Obere Grenze | =B2+B6 |
Kopieren Sie die ganze Tabelle, fügen Sie sie in Zelle A1 ein und ersetzen Sie die Zahlen in Spalte B durch Ihre eigenen. Die Ergebnisse sind dieselben wie in Excel: In der dritten Tabelle liegt die untere Grenze bei etwa 499,6456 und die obere Grenze bei etwa 500,7544.
So berechnen Sie es in Python
import math
from statistics import NormalDist

sample_size = 50        # Stichprobenumfang n
sample_mean = 500.2     # Stichprobenmittel x̄
sd = 2                  # Standardabweichung σ
confidence_level = 95   # Konfidenzniveau (%)

z = NormalDist().inv_cdf((1 + confidence_level / 100) / 2)  # z-Wert zum Konfidenzniveau
standard_error = sd / math.sqrt(sample_size)                # Standardfehler σ ÷ √n
margin_of_error = z * standard_error                        # Fehlermarge E
lower = sample_mean - margin_of_error                       # untere Grenze des Konfidenzintervalls
upper = sample_mean + margin_of_error                       # obere Grenze des Konfidenzintervalls

print(f"z: {z}")
print(f"Fehlermarge E: {margin_of_error}")
print(f"{confidence_level}-%-Konfidenzintervall: {lower} bis {upper}")
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
E = z × σ ÷ √n
E = z \times \dfrac{\sigma}{\sqrt{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi>
<mo>=</mo>
<mi>z</mi>
<mo>×</mo>
<mfrac>
<mi>σ</mi>
<msqrt><mi>n</mi></msqrt>
</mfrac>
</mrow>
</math>
E = z sigma / sqrt(n)
z*sigma/Sqrt[n]
E := z*sigma/sqrt(n);
E = z*sigma/sqrt(n);
E = zσ/√n
L = x̄ − E, U = x̄ + E
L = \bar{x} - E,\quad U = \bar{x} + E
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>L</mi>
<mo>=</mo>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>−</mo>
<mi>E</mi>
<mo>,</mo>
<mspace width="1em"/>
<mi>U</mi>
<mo>=</mo>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>+</mo>
<mi>E</mi>
</mrow>
</math>
L = bar x - E, U = bar x + E
{xbar - e, xbar + e}
L := xbar - E; U := xbar + E;
L = xbar - E; U = xbar + E;
L = x̄ - E, U = x̄ + E
z = Φ⁻¹((1 + C) ÷ 2)
z = \Phi^{-1}\!\left(\dfrac{1+C}{2}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi>
<mo>=</mo>
<msup><mi>Φ</mi><mrow><mo>−</mo><mn>1</mn></mrow></msup>
<mrow>
<mo>(</mo>
<mfrac>
<mrow><mn>1</mn><mo>+</mo><mi>C</mi></mrow>
<mn>2</mn>
</mfrac>
<mo>)</mo>
</mrow>
</mrow>
</math>
z = Phi^-1((1 + C)/2)
InverseCDF[NormalDistribution[0, 1], (1 + c)/2]
with(Statistics): Quantile(RandomVariable(Normal(0, 1)), (1 + c)/2);
z = norminv((1 + c)/2);
z = Φ^(-1)((1+C)/2)
So lassen Sie ChatGPT rechnen
Sie sind ein Assistent für statistische Berechnungen. Führen Sie die folgende Berechnung aus, indem Sie tatsächlich Python-Code ausführen, und stützen Sie Ihre Antwort ausschließlich auf die Zahlen aus dem Ausführungsergebnis (nicht im Kopf rechnen oder schätzen).

Aus einer Abfüllanlage wurden 50 Flaschen entnommen und ihr Inhalt gemessen. Der Mittelwert betrug 500,2 ml. Die Streuung der Füllmenge (die Standardabweichung der Grundgesamtheit) ist mit 2 ml bekannt.
1. Bestimmen Sie den z-Wert zum Konfidenzniveau 95 % (mit der Umkehrfunktion der Verteilungsfunktion der Standardnormalverteilung; dafür können Sie statistics.NormalDist().inv_cdf aus der Python-Standardbibliothek verwenden).
2. Bestimmen Sie die Fehlermarge E = z × σ ÷ √n.
3. Bestimmen Sie das 95-%-Konfidenzintervall (untere und obere Grenze) für den Mittelwert der Grundgesamtheit (den wahren mittleren Inhalt aller Flaschen).

Zeigen Sie die verwendeten Formeln und die Zahlen aus dem Ausführungsergebnis.
Anleitung
-
1Werte eingebenTragen Sie die Zahlen, mit denen Sie rechnen möchten, in die Eingabefelder ein
-
2BerechnenKlicken Sie auf die Schaltfläche „Berechnen“
-
3Ergebnis ansehenDas Ergebnis erscheint sofort. Auf derselben Seite finden Sie auch den Rechenweg und die Erklärung der Formel
Die Vorteile von DataChef

Kein Fachwissen nötig – einfach und intuitiv

Keine persönlichen Daten erforderlich

Die Datei wird nach dem Download automatisch gelöscht


Keine Quellenangabe nötig

Keine vorherige Genehmigung erforderlich
Verwandte Funktionen
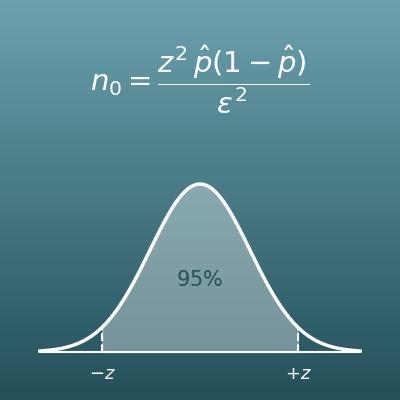
Stichprobengröße berechnen – Stichprobenumfang und Fehlertoleranz
Berechnet aus der zulässigen Fehlermarge und dem Konfidenzniveau, wie groß die Stichprobe einer Umfrage sein muss
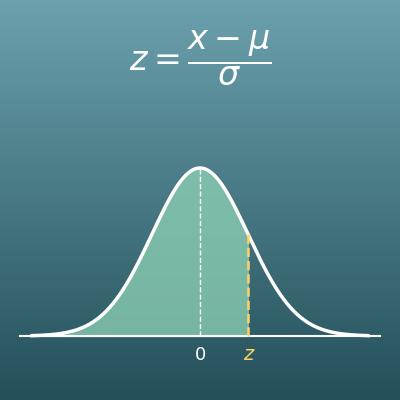
z-Wert berechnen: z-Transformation und Wahrscheinlichkeit in beide Richtungen
Berechnet den z-Wert (standardisierten Wert) aus Wert, Mittelwert und Standardabweichung und rechnet ihn in eine Wahrscheinlichkeit um und zurück
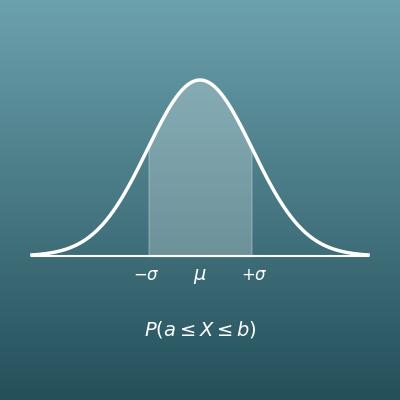
Normalverteilung berechnen – Wahrscheinlichkeit für einen Bereich
Berechnet aus Mittelwert und Standardabweichung die Wahrscheinlichkeit für einen Bereich
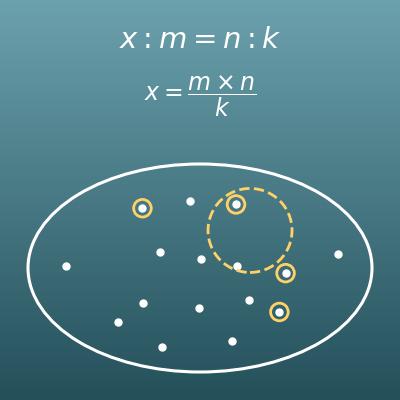
Fang-Wiederfang-Methode und Hochrechnung aus einer Stichprobe
Vom Teil auf das Ganze schließen, wie in der Mittelstufe. Rückfangmethode und Hochrechnung auf die Grundgesamtheit mit Verhältnisgleichung und Rechenweg