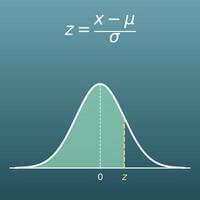
Füllen Sie nur ein Feld aus – entweder Z (die Teststatistik) oder eine der fünf Wahrscheinlichkeiten. Alle übrigen Werte werden berechnet (in beide Richtungen, von Z zum p-Wert und vom p-Wert zu Z).
Inhaltsverzeichnis
-
Das können Sie auf dieser Seite
-
Wofür braucht man diese Berechnung?
-
Anleitung
-
Formeln und Graphen
-
Symbole und Begriffe
-
Das sollten Sie vorher wissen
-
So berechnen Sie es in Excel
-
So berechnen Sie es in Google Tabellen
-
So berechnen Sie es in Python
-
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
-
So lassen Sie ChatGPT rechnen
-
Die Vorteile von DataChef
-
Verwandte Funktionen
-
Alle Rechner von NumberChef
Das können Sie auf dieser Seite
- Geben Sie die Teststatistik Z aus einem z-Test ein – und erhalten Sie auf einmal die p-Werte für den linksseitigen, den rechtsseitigen und den zweiseitigen Test
- Auch der umgekehrte Weg vom p-Wert zu Z ist möglich (z. B. Z = 1,96 zum zweiseitigen p-Wert 0,05). So finden Sie auch die Grenze des Ablehnungsbereichs (den kritischen Wert)
- Die Wahrscheinlichkeiten „zwischen 0 und Z“ und „zwischen −Z und Z“ werden ebenfalls angezeigt – der Rechner ersetzt also auch die Tabelle der Standardnormalverteilung (z-Tabelle)
- Dazu eine verständliche Erklärung der Formeln sowie fertige Formeln zum Kopieren für Excel, Google Tabellen und Python
Wofür braucht man diese Berechnung?
In klinischen Studien zu einem neuen Medikament prüft man mit einem Hypothesentest, ob der Unterschied zwischen der Gruppe mit und der Gruppe ohne Medikament noch im Bereich des Zufalls liegt; der p-Wert ist die Grundlage für diese Entscheidung. Eine Teststatistik von \(Z = 2{,}5\) ergibt zum Beispiel einen zweiseitigen p-Wert von etwa 0,012. Das heißt: „Wirkte das Medikament gar nicht, läge die Chance auf einen so großen Unterschied bei etwa 1,2 %.“
Medizinische Fachartikel auf der ganzen Welt berichten Ergebnisse auf diese Weise. Wer weiß, was ein p-Wert ist, versteht Gesundheitsnachrichten einen Schritt genauer (die eigentliche medizinische Entscheidung treffen Fachleute, die neben dem p-Wert auch die Größe der Wirkung und die Nebenwirkungen abwägen).
„Wir haben die Farbe des Buttons geändert, und die Klickrate ist gestiegen. War das nur Zufall?“ Genau das beantwortet der Test beim A/B-Test. Eine Teststatistik von \(Z = 2{,}17\) ergibt zum Beispiel einen zweiseitigen p-Wert von etwa 0,03. Das ist kleiner als das Signifikanzniveau 0,05, also lässt sich schließen: „eine Verbesserung, die sich kaum mit Zufall erklären lässt“.
Onlinefirmen entscheiden mit diesem p-Wert jeden Tag, ob sie Änderungen an Design und Texten übernehmen.
Mit Daten aus Stichprobenkontrollen prüft man, ob sich das mittlere Gewicht oder Maß der Produkte vom Sollwert entfernt hat. Eine Teststatistik von \(Z = 2\) ergibt zum Beispiel einen zweiseitigen p-Wert von etwa 0,046. Beim Signifikanzniveau 5 % schließt man daraus „im Prozess hat sich etwas verändert“ und sucht die Ursache.
Die Stärke des p-Werts ist, dass er „zufällige Schwankung“ von „echtem Problem“ unterscheidet. So entscheidet man mit Zahlen statt nach Gefühl, ob eine Maschine angehalten wird.
In wissenschaftlichen Artikeln liest man ständig Angaben wie „signifikant bei p < 0,05“ oder „p = 0,003“. Beim zweiseitigen Test entspricht p < 0,05 der Aussage „\(|Z|\) ist größer als 1,96“, p < 0,01 der Aussage „größer als etwa 2,58“.
Wer diesen Zusammenhang kennt, kann statistische Ergebnisse in der Haus-, Bachelor- oder Masterarbeit korrekt angeben und behält beim Lesen von Studien einen wichtigen Punkt im Blick: „Signifikant“ heißt nicht automatisch „wichtig“ (wie groß der Unterschied ist, ist eine andere Frage).
Auch ob eine Meldung wie „Zufriedenheit mit der Bundesregierung steigt gegenüber dem Vormonat um 2 Prozentpunkte“ eine echte Veränderung ist oder nur die Schwankung (der Fehler) der Umfrage, lässt sich mit einem Hypothesentest prüfen. Eine Teststatistik von \(Z = 1\) ergibt zum Beispiel einen zweiseitigen p-Wert von etwa 0,32 – „auch ohne echten Unterschied passiert das etwa jedes dritte Mal zufällig“. Man ordnet es also sinnvollerweise als innerhalb der Fehlertoleranz ein.
Eine praktische Denkweise für den Alltag: Bevor man sich über Zahlen in den Nachrichten freut oder ärgert, fragt man „Ist dieser Unterschied signifikant?“.
Formeln und Graphen
Symbole und Begriffe
Symbole
| \(P\) | P | Der p-Wert: die Wahrscheinlichkeit, rein zufällig ein mindestens so extremes Ergebnis wie das beobachtete zu erhalten, wenn die Nullhypothese stimmt. Je kleiner er ist, desto schwerer lässt sich das Ergebnis mit Zufall erklären. |
| \(Z\) | Z | Die Teststatistik (der z-Wert), aus den Daten berechnet und als standardnormalverteilt angesehen. Auf dieser Seite wird aus Z der p-Wert bestimmt. Wie man den z-Wert selbst berechnet, zeigt die verwandte Seite „z-Wert berechnen“. |
| \(\Phi(Z)\) | Phi von Z | Die Verteilungsfunktion der Standardnormalverteilung (Mittelwert 0, Standardabweichung 1). Sie gibt die Wahrscheinlichkeit für einen Wert unter \(Z\) an, also die Fläche unter der Kurve links von \(Z\). |
| \(\Phi^{-1}\) | Phi hoch minus 1 (Umkehrfunktion von Φ) | Die Umkehrfunktion von \(\Phi\). Sie nimmt eine Wahrscheinlichkeit (Fläche) und gibt das Z zurück, das dazu gehört. Der Rechner nutzt sie für den Weg vom p-Wert zu Z (Beispiel: \(\Phi^{-1}(0{,}975) \approx 1{,}96\)). |
| \(|Z|\) | Betrag von Z | Die Größe von \(Z\) ohne Vorzeichen. Der zweiseitige Test zählt eine Abweichung nach oben und nach unten als gleich „extrem“ und verwendet deshalb den Betrag (Beispiel: \(|-1{,}5| = 1{,}5\)). |
| \(\alpha\) | Alpha | Das Signifikanzniveau: die Grenzwahrscheinlichkeit, die man vorher festlegt, etwa „ist der p-Wert höchstens so groß, wird die Nullhypothese verworfen“. Üblich sind 0,05 (5 %) und 0,01 (1 %). |
Begriffe
| p-Wert | Die Wahrscheinlichkeit, ein mindestens so extremes Ergebnis wie das beobachtete zu erhalten, wenn man annimmt, dass die Nullhypothese stimmt (auch Überschreitungswahrscheinlichkeit). Je kleiner der p-Wert, desto weniger glaubhaft ist es, dass das Ergebnis zufällig zustande kam, und desto stärker spricht es dafür, die Nullhypothese zu verwerfen. |
| Hypothesentest (Signifikanztest) | Ein Verfahren, bei dem man zunächst annimmt „es gibt keinen Unterschied“, mit dem p-Wert misst, wie unwahrscheinlich die tatsächlichen Daten unter dieser Annahme wären, und dann entscheidet, ob man die Annahme verwirft. Das ähnelt einem Widerspruchsbeweis – passiert etwas sehr Seltenes, zweifelt man an der Ausgangsannahme. |
| Nullhypothese | Die Ausgangsannahme H₀, die man widerlegen möchte, etwa „zwischen den beiden Gruppen gibt es keinen Unterschied“ oder „es gibt keine Wirkung“. Der p-Wert wird unter der Annahme berechnet, dass die Nullhypothese stimmt. Ihr Gegenstück ist die Alternativhypothese. |
| Alternativhypothese | Die Gegenbehauptung zur Nullhypothese H₁ („es gibt einen Unterschied“, „es gibt eine Wirkung“), auch Gegenhypothese. Sie wird angenommen, wenn die Nullhypothese verworfen wird. |
| Signifikanzniveau | Die Grenzwahrscheinlichkeit für das Verwerfen der Nullhypothese, Symbol \(\alpha\) (Alpha), auch Irrtumswahrscheinlichkeit. Es wird vor dem Test festgelegt; am verbreitetsten ist 0,05. Ist der p-Wert höchstens so groß wie das Signifikanzniveau, heißt das Ergebnis „statistisch signifikant“. |
| verwerfen | Die Nullhypothese aufgrund des Tests als „kaum glaubhaft“ aufgeben (auch ablehnen). Man verwirft sie, wenn der p-Wert höchstens so groß ist wie das Signifikanzniveau. Wichtig – kann man sie nicht verwerfen, heißt das nicht „die Nullhypothese stimmt“, sondern nur „die Belege reichen nicht aus, um sie zu verwerfen“. |
| zweiseitiger Test | Ein Test, der eine Abweichung in beide Richtungen – zu groß oder zu klein – als Unterschied wertet. Der p-Wert ist die Summe der Flächen an beiden Rändern der Verteilung. Er ist die übliche Wahl, wenn man die Richtung nicht vorher festlegen kann. |
| einseitiger Test | Ein Test, der nur Abweichungen in eine Richtung prüft – nur nach oben (rechtsseitig) oder nur nach unten (linksseitig). Man verwendet ihn, wenn die Richtung aus der Sache heraus vorher feststeht; der p-Wert ist dann nur die Fläche an diesem einen Rand. |
| Teststatistik (Prüfgröße) | Der Wert, den man für einen Test aus den Daten berechnet. Beim z-Test bringt man ihn in eine Form, die als standardnormalverteilt gelten kann (den z-Wert); er gibt an, wie viele Standardabweichungen das Ergebnis vom Mittelwert entfernt ist. |
| Standardnormalverteilung | Die Normalverteilung mit Mittelwert 0 und Standardabweichung 1 (eine symmetrische Glockenkurve). Die Fläche unter der Kurve ist die Wahrscheinlichkeit, die Gesamtfläche ist genau 1. Der p-Wert eines z-Tests ist eine Fläche an den Rändern dieser Verteilung. |
| kritischer Wert | Die Grenze der Teststatistik, ab der man die Nullhypothese verwirft (sie begrenzt den Ablehnungsbereich). Beim zweiseitigen Test mit dem Signifikanzniveau 5 % ist er \(|Z| \approx 1{,}96\), bei 1 % \(|Z| \approx 2{,}576\). Mit diesem Rechner können Sie das nachprüfen, indem Sie vom p-Wert auf Z zurückrechnen. |
Das sollten Sie vorher wissen
Damit Sie die Rechnung auf dieser Seite nicht nur per Knopfdruck, sondern mit Verständnis nutzen, ist hier zusammengefasst, was Sie vorher wissen sollten.
| Grundlagen der Wahrscheinlichkeit (Klasse 7–8, 12–14 Jahre) |
|
| Daten auswerten und Standardabweichung (Klasse 9–10, 14–16 Jahre) |
|
| Normalverteilung und Flächen lesen (Oberstufe, 16–19 Jahre) |
|
| Die Idee des Hypothesentests (Oberstufe, 16–19 Jahre) |
|
So berechnen Sie es in Excel
| Z (Teststatistik) | -1,5 |
| Linksseitig P(x<Z) | =NORM.S.VERT(B1;WAHR) |
| Z (Teststatistik) | 2 |
| Rechtsseitig P(x>Z) | =1-NORM.S.VERT(B1;WAHR) |
| Z (Teststatistik) | 1,96 |
| Zweiseitiger p-Wert | =2*(1-NORM.S.VERT(ABS(B1);WAHR)) |
„NORM.S.VERT(Wert;WAHR)“ ist die Funktion für die Verteilungsfunktion \(\Phi\) (die Fläche links von Z); WAHR bedeutet „kumulierten Wert (Fläche links) zurückgeben“. „ABS“ liefert den Betrag (die Größe ohne Vorzeichen).
In B2 erscheint in der ersten Tabelle etwa 0,0668 (etwa 6,7 %), in der zweiten etwa 0,02275 (etwa 2,3 %) und in der dritten etwa 0,05 (5 %). Ersetzen Sie einfach B1 durch Ihr eigenes Z.
Für den umgekehrten Weg, vom p-Wert zu Z, nehmen Sie „=NORM.S.INV(Wahrscheinlichkeit)“ (Beispiel: Das Z zum zweiseitigen p-Wert 0,05 ist `=NORM.S.INV(1-0,05/2)`, etwa 1,95996).
So berechnen Sie es in Google Tabellen
| Z (Teststatistik) | -1,5 |
| Linksseitig P(x<Z) | =STANDNORMVERT(B1) |
| Z (Teststatistik) | 2 |
| Rechtsseitig P(x>Z) | =1-STANDNORMVERT(B1) |
| Z (Teststatistik) | 1,96 |
| Zweiseitiger p-Wert | =2*(1-STANDNORMVERT(ABS(B1))) |
Die Ergebnisse sind dieselben wie in Excel: etwa 0,0668 in der ersten Tabelle, etwa 0,02275 in der zweiten und etwa 0,05 in der dritten.
Um Z aus einem p-Wert zu berechnen, nehmen Sie „=STANDNORMINV(Wahrscheinlichkeit)“ (Beispiel: `=STANDNORMINV(1-0,05/2)` ergibt etwa 1,95996).
So berechnen Sie es in Python
import math

def phi(z):
    # Verteilungsfunktion der Standardnormalverteilung Φ(z) (berechnet mit der Fehlerfunktion erf)
    return 0.5 * (1 + math.erf(z / math.sqrt(2)))

z = 1.96  # Z (Teststatistik)

p_left = phi(z)                       # linksseitiger p-Wert P(x<Z)
p_right = 1 - phi(z)                  # rechtsseitiger p-Wert P(x>Z)
p_two_sided = 2 * (1 - phi(abs(z)))   # zweiseitiger p-Wert

print(f"Linksseitiger p-Wert: {p_left}")
print(f"Rechtsseitiger p-Wert: {p_right}")
print(f"Zweiseitiger p-Wert: {p_two_sided}")
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
P = Φ(Z)
P = \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P = Phi(Z)
CDF[NormalDistribution[0, 1], z]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), z);
p = normcdf(z);
P = Φ(Z)
P = 1 − Φ(Z)
P = 1 - \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mn>1</mn>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P = 1 - Phi(Z)
1 - CDF[NormalDistribution[0, 1], z]
with(Statistics): 1 - CDF(RandomVariable(Normal(0, 1)), z);
p = 1 - normcdf(z);
P = 1 - Φ(Z)
P = 2(1 − Φ(|Z|))
P = 2\left(1 - \Phi(|Z|)\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mn>2</mn>
<mo>(</mo>
<mn>1</mn>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>Z</mi><mo>|</mo><mo>)</mo>
<mo>)</mo>
</mrow>
</math>
P = 2(1 - Phi(|Z|))
2 (1 - CDF[NormalDistribution[0, 1], Abs[z]])
with(Statistics): 2*(1 - CDF(RandomVariable(Normal(0, 1)), abs(z)));
p = 2*(1 - normcdf(abs(z)));
P = 2(1 - Φ(|Z|))
So lassen Sie ChatGPT rechnen
Sie sind ein Rechenassistent für Statistik. Führen Sie die folgende Berechnung aus, indem Sie tatsächlich Python-Code ausführen, und stützen Sie Ihre Antwort nur auf die Zahlen aus dem Ausführungsergebnis (nicht im Kopf rechnen oder schätzen).

Ein z-Test hat die Teststatistik Z = 2,5 ergeben. Nehmen Sie an, dass die Teststatistik standardnormalverteilt ist (Sie dürfen die Python-Standardbibliothek verwenden, etwa math.erf oder statistics.NormalDist).
Bestimmen Sie:
1. Den linksseitigen p-Wert P(x<Z)
2. Den rechtsseitigen p-Wert P(x>Z)
3. Den zweiseitigen p-Wert P(x<−Z oder x>Z)
4. Ob die Nullhypothese bei einem zweiseitigen Test mit dem Signifikanzniveau 0,05 verworfen werden kann

Zeigen Sie die verwendeten Formeln und die Zahlen aus dem Ausführungsergebnis.
Anleitung
-
1Werte eingebenTragen Sie die Zahlen, mit denen Sie rechnen möchten, in die Eingabefelder ein
-
2BerechnenKlicken Sie auf die Schaltfläche „Berechnen“
-
3Ergebnis ansehenDas Ergebnis erscheint sofort. Auf derselben Seite finden Sie auch den Rechenweg und die Erklärung der Formel
Die Vorteile von DataChef

Kein Fachwissen nötig – einfach und intuitiv

Keine persönlichen Daten erforderlich

Die Datei wird nach dem Download automatisch gelöscht


Keine Quellenangabe nötig

Keine vorherige Genehmigung erforderlich
Verwandte Funktionen
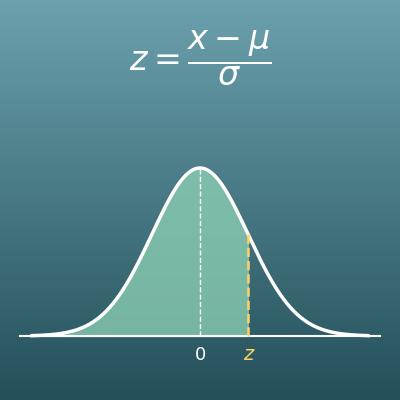
z-Wert berechnen: z-Transformation und Wahrscheinlichkeit in beide Richtungen
Berechnet den z-Wert aus Wert, Mittelwert und Standardabweichung. Ersetzt auch die z-Tabelle
Normalverteilung berechnen – Wahrscheinlichkeit für einen Bereich
Berechnet aus Mittelwert und Standardabweichung die Wahrscheinlichkeit für einen Bereich oder für die obersten Prozent
Konfidenzintervall berechnen für den Mittelwert
Berechnet aus Stichprobenmittel, Standardabweichung und Stichprobenumfang das Konfidenzintervall für den Mittelwert der Grundgesamtheit