Z値(検定統計量)または5種類の確率のうち、どれか1つの欄だけに入力してください。残りの値をすべて計算します(Z値→P値、P値→Z値のどちらの向きにも変換できます)。
このページでできること
- Z検定などで求めた検定統計量(Z値)を入れるだけで、左片側・右片側・両側検定のP値(有意確率)をまとめて計算します
- P値からZ値への逆算もできます(例:両側P値0.05に対応するZ値1.96を求める)。棄却域の境界(臨界値)を調べるのにも使えます
- 「0とZの間」「−ZとZの間」の確率も同時に出るので、標準正規分布表(z表)の代わりとしても使えます
- 式のやさしい解説・Excel/Googleスプレッドシート/Python用のコピペ数式・計算ドリル(演習問題)もこのページにまとまっています
この計算は何の役に立つ?
新薬の臨床試験では、「薬を使った群と使わない群の差は偶然の範囲か」を仮説検定で調べ、その判断材料としてP値が使われます。例えば検定統計量が \(Z = 2.5\) なら両側P値は約0.012で、「効果がないのに偶然この差が出る確率は約1.2%」と読めます。
世界中の医学論文がこの仕組みで効果を報告しており、P値の意味がわかると健康情報のニュースを一歩深く読めるようになります(実際の医療上の判断は、P値だけでなく効果の大きさや副作用も含めて専門家が総合的に行います)。
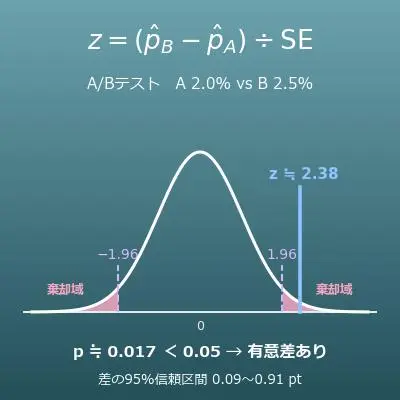
「ボタンの色を変えたらクリック率が上がった。でもそれは偶然では?」を確かめるのがA/Bテストの検定です。例えば検定統計量が \(Z = 2.17\) なら両側P値は約0.03で、有意水準0.05より小さいので「偶然とは考えにくい改善」と判断できます。
ネット企業では日々このP値を使って、デザインや文言の変更を採用するかどうかを決めています。
製品の重さや寸法の平均が目標からズレていないかを、抜き取り検査のデータで検定します。例えば検定統計量が \(Z = 2\) なら両側P値は約0.046で、有意水準5%なら「工程に何か変化が起きた」と判断して原因を調べます。
「たまたまのばらつき」と「本当の異常」を区別できるのがP値の強みで、機械を止めるかどうかの判断を感覚ではなく数字で行えます。
学術論文には「p < 0.05 で有意」「p = 0.003」のような表記が頻繁に出てきます。これは両側検定なら「\(|Z|\) が1.96を超えた」ことに対応し、p < 0.01 なら約2.58超えに対応します。
この対応関係を知っていると、卒論・レポートで統計結果を正しく報告したり、「有意=重要とは限らない(差の大きさは別問題)」という論文読解の注意点も理解しやすくなります。
「内閣支持率が先月より2ポイント上昇」のような変化が、本当の変化なのか調査のばらつき(誤差)なのかも仮説検定で調べられます。例えば検定統計量が \(Z = 1\) なら両側P値は約0.32で、「差がなくても3回に1回くらいは偶然起こる程度」なので、誤差の範囲と判断するのが自然です。
ニュースの数字に一喜一憂する前に「その差は有意なのか」と考えられるようになる、身近で役立つ統計の見方です。
式とグラフ
用語・記号の解説
記号
| \(P\) | ピー | P値(有意確率)。帰無仮説が正しいとしたとき、観測結果と同じかそれ以上に極端な結果が偶然得られる確率です。小さいほど「偶然とは考えにくい」ことを表します。 |
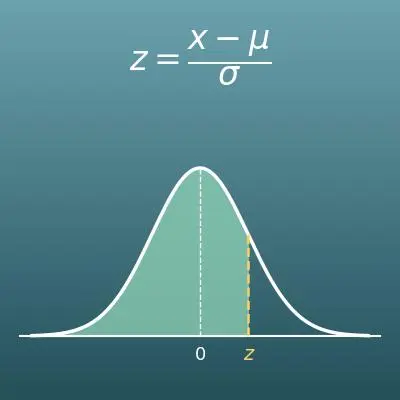
| \(Z\) | ゼット | 検定統計量(Z値)。データから計算した、標準正規分布に従うとみなせる値です。このページではZ値からP値を求めます。zスコアの計算そのものは関連ページ「Zスコア計算機」で扱っています。 |
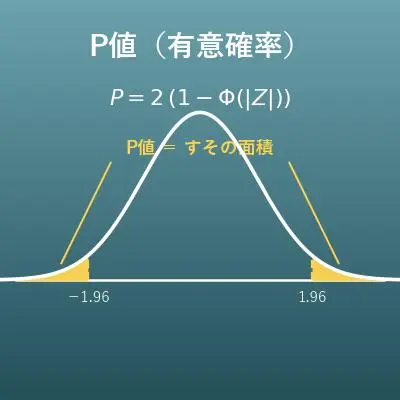
| \(\Phi(Z)\) | ファイ・ゼット | 標準正規分布(平均0・標準偏差1)の累積分布関数。「\(Z\) より小さい値になる確率」=曲線の \(Z\) より左側の面積を返します。 |
| \(\Phi^{-1}\) | ファイ・インバース(Φの逆関数) | \(\Phi\) の逆向きの関数。「確率(面積)」から「そうなるZ値」を返します。この計算機のP値→Z値の逆算に使われています。(例:\(\Phi^{-1}(0.975) \fallingdotseq 1.96\)) |
| \(|Z|\) | ゼットの絶対値 | \(Z\) の符号を取った大きさ。両側検定では、プラス側・マイナス側どちらのはみ出しも同じ「極端さ」として数えるため、絶対値を使います。(例:\(|-1.5| = 1.5\)) |
| \(\alpha\) | アルファ | 有意水準。「P値がこの値以下なら帰無仮説を棄却する」とあらかじめ決めておく基準の確率で、慣習的に0.05(5%)や0.01(1%)がよく使われます。 |
用語
| P値 (有意確率) |
ピーち(ゆういかくりつ) | 帰無仮説が正しいと仮定したとき、観測された結果と同じかそれ以上に極端な結果が得られる確率。P値が小さいほど「この結果が偶然出たとは考えにくい」ことを意味し、帰無仮説を棄却する根拠が強くなります。 |
| 統計的仮説検定 | とうけいてきかせつけんてい | 「差がない」という仮説をいったん立て、実際のデータがその仮説のもとでどれくらい起こりにくいかをP値で測って、仮説を捨てるかどうかを判断する手続きです。めったに起こらないことが起きたら元の仮説を疑う、という背理法に似た考え方をします。 |
| 帰無仮説 | きむかせつ | 「2つの群に差はない」「効果はない」のような、否定したい(無に帰したい)デフォルトの仮定。P値はこの帰無仮説が正しいという前提で計算されます。 |
| 対立仮説 | たいりつかせつ | 帰無仮説の反対側の主張(「差がある」「効果がある」)。帰無仮説が棄却されたときに採択される仮説です。 |
| 有意水準 | ゆういすいじゅん | 帰無仮説を棄却する基準となる確率で、記号は \(\alpha\)(アルファ)。検定を行う前に決めておくのがルールで、0.05が最も広く使われます。P値が有意水準以下なら「統計的に有意」といいます。 |
| 棄却 | ききゃく | 検定の結果、帰無仮説を「正しいとは考えにくい」として捨てること。P値が有意水準以下のときに棄却します。棄却できないときは「帰無仮説が正しい」ではなく「棄却する根拠が足りない」という意味になる点に注意が必要です。 |
| 両側検定 | りょうがわけんてい (「りょうそくけんてい」とも読まれます) | 「大きすぎる」「小さすぎる」のどちらの向きのズレも差とみなす検定。P値は分布の両側のすその面積を足したものになります。向きを事前に決められない場合の標準的な選択です。 |
| 片側検定 | かたがわけんてい (「かたそくけんてい」とも読まれます) | 「大きい方だけ」(右片側)または「小さい方だけ」(左片側)のズレを調べる検定。調べたい向きが理論的に決まっている場合に使い、P値は片側のすその面積だけになります。 |
| 検定統計量 | けんていとうけいりょう | 検定のためにデータから計算する値。Z検定では標準正規分布に従うとみなせる形(Z値)に直したもので、平均から標準偏差いくつ分離れているかを表します。 |
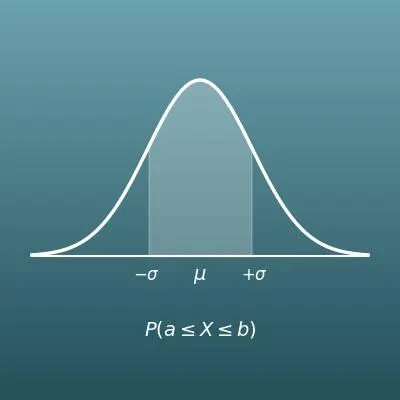
| 標準正規分布 | ひょうじゅんせいきぶんぷ | 平均0・標準偏差1の正規分布(左右対称の釣り鐘型)。曲線の下の面積が確率を表し、全体の面積はちょうど1です。Z検定のP値はこの分布のすその面積として計算されます。 |
| 臨界値 | りんかいち | 「ここを超えたら帰無仮説を棄却する」という検定統計量の境界の値。有意水準5%の両側検定なら \(|Z| \fallingdotseq 1.96\)、1%なら \(|Z| \fallingdotseq 2.576\) です。この計算機でP値からZ値を逆算すると確かめられます。 |
前提として理解しておくといいこと
このページの計算を「意味がわかって」使えるようになるために、前提として理解しておくといいことをまとめました。
| 確率の基礎(中学2年) |
|
| データの分析・標準偏差(高校 数学I) |
|
| 正規分布と面積の見方(高校 数学B/統計) |
|
| 仮説検定の考え方(高校 数学B・統計的な推測) |
|
Excelで計算する方法
| Z値(検定統計量) | -1.5 |
| 左側P値 P(x<Z) | =NORM.S.DIST(B1,TRUE) |
| Z値(検定統計量) | 2 |
| 右側P値 P(x>Z) | =1-NORM.S.DIST(B1,TRUE) |
| Z値(検定統計量) | 1.96 |
| 両側P値 | =2*(1-NORM.S.DIST(ABS(B1),TRUE)) |
「NORM.S.DIST(値, TRUE)」が累積分布関数 \(\Phi\)(Zより左側の面積)にあたる関数で、TRUEは「累積(左側の面積)で返す」という意味です。「ABS」は絶対値(符号を取った大きさ)を返す関数です。
1つ目の表はB2に約0.0668(約6.7%)、2つ目の表は約0.02275(約2.3%)、3つ目の表は約0.05(5%)と表示されます。B1を自分のZ値に書き換えるだけで使えます。
逆に「P値からZ値を知りたい」ときは「=NORM.S.INV(確率)」を使います(例:両側P値0.05に対応するZ値は `=NORM.S.INV(1-0.05/2)` で約1.95996)。
Googleスプレッドシートで計算する方法
| Z値(検定統計量) | -1.5 |
| 左側P値 P(x<Z) | =NORMSDIST(B1) |
| Z値(検定統計量) | 2 |
| 右側P値 P(x>Z) | =1-NORMSDIST(B1) |
| Z値(検定統計量) | 1.96 |
| 両側P値 | =2*(1-NORMSDIST(ABS(B1))) |
値の出方はExcel版と同じで、1つ目の表は約0.0668、2つ目の表は約0.02275、3つ目の表は約0.05になります。
逆にP値からZ値を求めるときは「=NORMSINV(確率)」を使います(例:`=NORMSINV(1-0.05/2)` は約1.95996)。
Pythonで計算する方法
import math

def phi(z):
    # 標準正規分布の累積分布関数 Φ(z)(誤差関数 erf を使って計算)
    return 0.5 * (1 + math.erf(z / math.sqrt(2)))

z = 1.96  # Z値(検定統計量)

p_left = phi(z)                       # 左側P値 P(x<Z)
p_right = 1 - phi(z)                  # 右側P値 P(x>Z)
p_two_sided = 2 * (1 - phi(abs(z)))   # 両側P値

print(f"左側P値: {p_left}")
print(f"右側P値: {p_right}")
print(f"両側P値: {p_two_sided}")
数式記述言語(LaTeX等)での書き方(コピペ可)
P = Φ(Z)
P = \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P = Phi(Z)
CDF[NormalDistribution[0, 1], z]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), z);
p = normcdf(z);
P = Φ(Z)
P = 1 − Φ(Z)
P = 1 - \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mn>1</mn>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P = 1 - Phi(Z)
1 - CDF[NormalDistribution[0, 1], z]
with(Statistics): 1 - CDF(RandomVariable(Normal(0, 1)), z);
p = 1 - normcdf(z);
P = 1 - Φ(Z)
P = 2(1 − Φ(|Z|))
P = 2\left(1 - \Phi(|Z|)\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mn>2</mn>
<mo>(</mo>
<mn>1</mn>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>Z</mi><mo>|</mo><mo>)</mo>
<mo>)</mo>
</mrow>
</math>
P = 2(1 - Phi(|Z|))
2 (1 - CDF[NormalDistribution[0, 1], Abs[z]])
with(Statistics): 2*(1 - CDF(RandomVariable(Normal(0, 1)), abs(z)));
p = 2*(1 - normcdf(abs(z)));
P = 2(1 - Φ(|Z|))
ChatGPT に聞いて計算してもらう方法
あなたは統計の計算アシスタントです。次の計算を、必ずPythonコードを実際に実行して行い、実行結果の数値だけを根拠に回答してください(暗算や推測で答えないでください)。

Z検定を行ったところ、検定統計量が Z = 2.5 になりました。検定統計量は標準正規分布に従うとみなせるものとします(math.erfやstatistics.NormalDistなど、Pythonの標準ライブラリを使って構いません)。
次の値をそれぞれ求めてください。
1. 左側P値 P(x<Z)
2. 右側P値 P(x>Z)
3. 両側P値 P(x<−Z または x>Z)
4. 有意水準0.05の両側検定として、帰無仮説を棄却できるかどうか

計算に使った式と、実行結果の数値を示してください。
計算ドリル(演習問題)
このページの式を、自分の手で計算できるようになるための演習問題です。
\(\Phi\)(累積分布関数)の値は問題文に与えてあります。答えと解説は解答ページにあります。
使い方
-
1数値を入力計算したい数値を入力欄に入力します
-
2計算「計算する」ボタンを押します
-
3結果を確認計算結果がその場に表示されます。計算の考え方や式の解説も同じページで確認できます
DataChefの特徴

専門知識不要、直感的で簡単な操作
個人情報を登録することなく使用できます
「ダウンロード」押下でファイルを自動削除
クレジット表記不要
商用利用許諾の連絡も不要です
関連機能
Zスコア計算機(標準得点)
測った値・平均・標準偏差からzスコアを計算します。z表の代わりにも使えます
正規分布の確率
平均と標準偏差から、指定した範囲に入る確率・上位何%かを計算します