






























































































































z값(검정통계량) 또는 5가지 확률 중 한 칸에만 입력하세요. 나머지 값을 모두 계산합니다(z값 → p값, p값 → z값 어느 방향으로도 변환할 수 있습니다).
이 페이지에서 할 수 있는 것
- z검정 등으로 구한 검정통계량(z값)을 넣기만 하면 좌측검정, 우측검정, 양측검정의 p값(유의확률)을 한꺼번에 계산합니다
- p값으로 z값을 역산할 수도 있습니다(예: 양측 p값 0.05에 대응하는 z값 1.96 구하기). 기각역의 경계(임계값)를 알아볼 때도 쓸 수 있습니다
- ‘0과 Z 사이’, ‘−Z와 Z 사이’의 확률도 함께 나오므로 표준정규분포표 대신으로도 쓸 수 있습니다
- 공식의 쉬운 해설과 Excel·Google 스프레드시트·Python에 그대로 복사해 쓸 수 있는 수식도 이 페이지에 정리되어 있습니다
이 계산은 어디에 쓰일까요?
신약의 임상시험에서는 ‘약을 쓴 집단과 쓰지 않은 집단의 차이가 우연의 범위인가’를 가설검정으로 알아보고, 그 판단 근거로 p값을 씁니다. 예를 들어 검정통계량이 \(Z = 2.5\)라면 양측 p값은 약 0.012로, ‘효과가 없는데 우연히 이만큼의 차이가 나올 확률은 약 1.2%’라고 읽을 수 있습니다.
전 세계의 의학 논문이 이 방식으로 효과를 보고하고 있어서, p값의 뜻을 알면 건강 정보 뉴스를 한층 깊이 읽을 수 있습니다(실제 의료상의 판단은 p값뿐만 아니라 효과의 크기나 부작용까지 포함해 전문가가 종합적으로 내립니다).
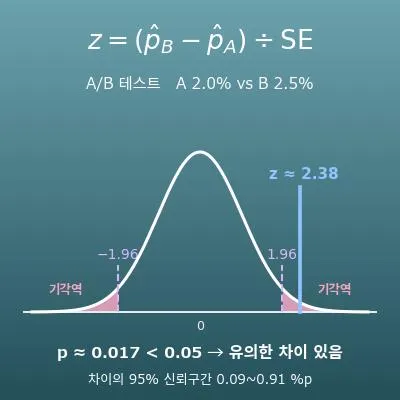
‘버튼 색을 바꿨더니 클릭률이 올랐다. 그런데 그게 우연은 아닐까?’를 확인하는 것이 A/B 테스트의 검정입니다. 예를 들어 검정통계량이 \(Z = 2.17\)이라면 양측 p값은 약 0.03으로, 유의수준 0.05보다 작으므로 ‘우연이라고 보기 어려운 개선’이라고 판단할 수 있습니다.
인터넷 기업에서는 날마다 이 p값을 써서 디자인이나 문구의 변경을 채택할지 결정합니다.
제품의 무게나 치수의 평균이 목표에서 어긋나지 않았는지를 표본 검사의 자료로 검정합니다. 예를 들어 검정통계량이 \(Z = 2\)라면 양측 p값은 약 0.046으로, 유의수준 5%라면 ‘공정에 무언가 변화가 생겼다’고 판단해 원인을 찾습니다.
‘어쩌다 생긴 흩어짐’과 ‘진짜 이상’을 구별할 수 있다는 것이 p값의 강점으로, 기계를 멈출지 말지를 감이 아니라 숫자로 판단할 수 있습니다.
학술 논문에는 ‘p < 0.05에서 유의함’, ‘p = 0.003’ 같은 표기가 자주 나옵니다. 이것은 양측검정이라면 ‘\(|Z|\)가 1.96을 넘었다’는 것에 대응하고, p < 0.01이라면 약 2.58을 넘은 것에 대응합니다.
이 대응 관계를 알고 있으면 졸업 논문이나 보고서에서 통계 결과를 올바르게 보고할 수 있고, ‘유의하다고 해서 중요하다고는 할 수 없다(차이의 크기는 별개의 문제)’는 논문 읽기의 주의점도 이해하기 쉬워집니다.
‘대통령 직무 수행 지지율이 지난달보다 2%p 상승’ 같은 변화가 진짜 변화인지, 조사의 흩어짐(오차)인지도 가설검정으로 알아볼 수 있습니다. 예를 들어 검정통계량이 \(Z = 1\)이라면 양측 p값은 약 0.32로, ‘차이가 없어도 세 번에 한 번쯤은 우연히 일어나는 정도’이므로 오차 범위로 판단하는 것이 자연스럽습니다.
뉴스의 숫자에 일희일비하기 전에 ‘그 차이는 유의한가’를 생각할 수 있게 되는, 가까이에서 쓸모 있는 통계의 관점입니다.
공식과 그래프
용어·기호 해설
기호
| \(P\) | 피 | p값(유의확률)입니다. 귀무가설이 맞다고 할 때, 관측 결과와 같거나 그보다 더 극단적인 결과가 우연히 나올 확률입니다. 작을수록 ‘우연이라고 보기 어렵다’는 뜻입니다. |
| \(Z\) | 제트 | 검정통계량(z값)입니다. 자료로 계산한 값으로, 표준정규분포를 따른다고 볼 수 있는 값입니다. 이 페이지에서는 z값으로 p값을 구합니다. z점수를 계산하는 방법 자체는 관련 페이지인 z점수 계산기에서 다룹니다. |
| \(\Phi(Z)\) | 파이 제트 | 표준정규분포(평균 0, 표준편차 1)의 누적분포함수입니다. ‘\(Z\)보다 작은 값이 될 확률’, 즉 곡선에서 \(Z\)보다 왼쪽의 넓이를 돌려줍니다. |
| \(\Phi^{-1}\) | 파이 인버스(Φ의 역함수) | \(\Phi\)와 반대 방향의 함수입니다. ‘확률(넓이)’을 넣으면 ‘그렇게 되는 z값’을 돌려줍니다. 이 계산기에서 p값으로 z값을 역산할 때 씁니다. (예: \(\Phi^{-1}(0.975) \fallingdotseq 1.96\)) |
| \(|Z|\) | 제트의 절댓값 | \(Z\)에서 부호를 뗀 크기입니다. 양측검정에서는 플러스 쪽과 마이너스 쪽 어느 쪽으로 벗어나든 같은 ‘극단적인 정도’로 세기 때문에 절댓값을 씁니다. (예: \(|-1.5| = 1.5\)) |
| \(\alpha\) | 알파 | 유의수준입니다. ‘p값이 이 값 이하이면 귀무가설을 기각한다’고 미리 정해 두는 기준 확률로, 관례적으로 0.05(5%)나 0.01(1%)을 많이 씁니다. |
용어
| p값 (유의확률) | 귀무가설이 맞다고 가정할 때, 관측된 결과와 같거나 그보다 더 극단적인 결과가 나올 확률입니다. p값이 작을수록 ‘이 결과가 우연히 나왔다고 보기 어렵다’는 뜻이 되어, 귀무가설을 기각할 근거가 강해집니다. |
| 통계적 가설검정 | ‘차이가 없다’는 가설을 일단 세우고, 실제 자료가 그 가설 아래에서 얼마나 일어나기 어려운지를 p값으로 재서 가설을 버릴지 판단하는 절차입니다. 좀처럼 일어나지 않는 일이 일어나면 처음 가설을 의심한다는, 귀류법과 비슷한 사고방식입니다. |
| 귀무가설 | ‘두 집단에 차이가 없다’, ‘효과가 없다’처럼 부정하고 싶은(없던 것으로 돌리고 싶은) 기본 가정입니다. p값은 이 귀무가설이 맞다는 전제로 계산합니다. |
| 대립가설 | 귀무가설과 반대되는 주장(‘차이가 있다’, ‘효과가 있다’)입니다. 귀무가설이 기각되었을 때 채택되는 가설입니다. |
| 유의수준 | 귀무가설을 기각하는 기준이 되는 확률로, 기호는 \(\alpha\)(알파)입니다. 검정을 하기 전에 정해 두는 것이 규칙이며, 0.05를 가장 널리 씁니다. p값이 유의수준 이하이면 ‘통계적으로 유의하다’고 합니다. |
| 기각 | 검정 결과 귀무가설을 ‘맞다고 보기 어렵다’며 버리는 것입니다. p값이 유의수준 이하일 때 기각합니다. 기각하지 못했을 때는 ‘귀무가설이 맞다’가 아니라 ‘기각할 근거가 부족하다’는 뜻이라는 점에 주의해야 합니다. |
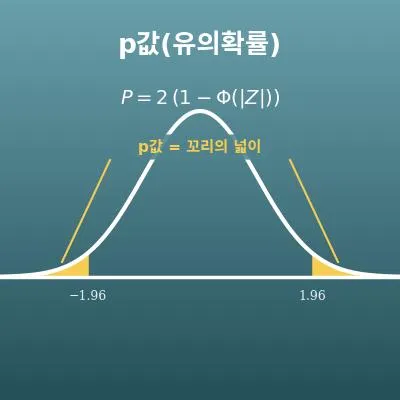
| 양측검정 | ‘너무 크다’, ‘너무 작다’ 어느 방향의 차이든 차이로 보는 검정입니다. p값은 분포 양쪽 꼬리의 넓이를 더한 것이 됩니다. 방향을 미리 정할 수 없을 때의 표준적인 선택입니다. |
| 단측검정 | ‘큰 쪽만’(우측검정) 또는 ‘작은 쪽만’(좌측검정)의 차이를 알아보는 검정입니다. 알아보고 싶은 방향이 이론적으로 정해져 있을 때 쓰며, p값은 한쪽 꼬리의 넓이만이 됩니다. |
| 검정통계량 | 검정을 위해 자료로 계산하는 값입니다. z검정에서는 표준정규분포를 따른다고 볼 수 있는 형태(z값)로 바꾼 것으로, 평균에서 표준편차 몇 개만큼 떨어져 있는지를 나타냅니다. |
| 표준정규분포 | 평균 0, 표준편차 1인 정규분포(좌우 대칭인 종 모양)입니다. 곡선 아래의 넓이가 확률을 나타내며, 전체 넓이는 정확히 1입니다. z검정의 p값은 이 분포의 꼬리 부분 넓이로 계산합니다. |
| 임계값 | ‘여기를 넘으면 귀무가설을 기각한다’는 검정통계량의 경계값입니다. 유의수준 5%의 양측검정이라면 \(|Z| \fallingdotseq 1.96\), 1%라면 \(|Z| \fallingdotseq 2.576\)입니다. 이 계산기에서 p값으로 z값을 역산하면 확인할 수 있습니다. |
먼저 알아 두면 좋은 내용
이 페이지의 계산을 ‘뜻을 이해하고’ 쓸 수 있도록, 미리 알아 두면 좋은 내용을 정리했습니다.
| 확률의 기초(중학교 2학년, 13~14세) |
|
| 자료의 정리와 표준편차(중학교 3학년, 14~15세) |
|
| 정규분포와 넓이 보는 법(고등학교 확률과 통계, 16~18세) |
|
| 가설검정의 사고방식(대학 기초 통계) |
|
Excel로 계산하는 방법
| z값(검정통계량) | -1.5 |
| 왼쪽 p값 P(x<Z) | =NORM.S.DIST(B1,TRUE) |
| z값(검정통계량) | 2 |
| 오른쪽 p값 P(x>Z) | =1-NORM.S.DIST(B1,TRUE) |
| z값(검정통계량) | 1.96 |
| 양측 p값 | =2*(1-NORM.S.DIST(ABS(B1),TRUE)) |
‘NORM.S.DIST(값, TRUE)’가 누적분포함수 \(\Phi\)(Z보다 왼쪽의 넓이)에 해당하는 함수이고, TRUE는 ‘누적(왼쪽의 넓이)으로 돌려준다’는 뜻입니다. ‘ABS’는 절댓값(부호를 뗀 크기)을 돌려주는 함수입니다.
첫 번째 표는 B2에 약 0.0668(약 6.7%), 두 번째 표는 약 0.02275(약 2.3%), 세 번째 표는 약 0.05(5%)가 표시됩니다. B1을 내 z값으로 바꾸기만 하면 됩니다.
반대로 ‘p값으로 z값을 알고 싶을’ 때는 ‘=NORM.S.INV(확률)’을 씁니다(예: 양측 p값 0.05에 대응하는 z값은 `=NORM.S.INV(1-0.05/2)`로 약 1.95996).
Google 스프레드시트로 계산하는 방법
| z값(검정통계량) | -1.5 |
| 왼쪽 p값 P(x<Z) | =NORMSDIST(B1) |
| z값(검정통계량) | 2 |
| 오른쪽 p값 P(x>Z) | =1-NORMSDIST(B1) |
| z값(검정통계량) | 1.96 |
| 양측 p값 | =2*(1-NORMSDIST(ABS(B1))) |
결과는 Excel 버전과 같아서 첫 번째 표는 약 0.0668, 두 번째 표는 약 0.02275, 세 번째 표는 약 0.05가 됩니다.
반대로 p값으로 z값을 구할 때는 ‘=NORMSINV(확률)’을 씁니다(예: `=NORMSINV(1-0.05/2)`는 약 1.95996).
Python으로 계산하는 방법
import math

def phi(z):
    # 표준정규분포의 누적분포함수 Φ(z)(오차함수 erf를 써서 계산)
    return 0.5 * (1 + math.erf(z / math.sqrt(2)))

z = 1.96  # z값(검정통계량)

p_left = phi(z)                       # 왼쪽 p값 P(x<Z)
p_right = 1 - phi(z)                  # 오른쪽 p값 P(x>Z)
p_two_sided = 2 * (1 - phi(abs(z)))   # 양측 p값

print(f"왼쪽 p값: {p_left}")
print(f"오른쪽 p값: {p_right}")
print(f"양측 p값: {p_two_sided}")
LaTeX 등 수식 언어로 쓰는 법(복사 가능)
P = Φ(Z)
P = \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P = Phi(Z)
CDF[NormalDistribution[0, 1], z]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), z);
p = normcdf(z);
P = Φ(Z)
P = 1 − Φ(Z)
P = 1 - \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mn>1</mn>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P = 1 - Phi(Z)
1 - CDF[NormalDistribution[0, 1], z]
with(Statistics): 1 - CDF(RandomVariable(Normal(0, 1)), z);
p = 1 - normcdf(z);
P = 1 - Φ(Z)
P = 2(1 − Φ(|Z|))
P = 2\left(1 - \Phi(|Z|)\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi>
<mo>=</mo>
<mn>2</mn>
<mo>(</mo>
<mn>1</mn>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>Z</mi><mo>|</mo><mo>)</mo>
<mo>)</mo>
</mrow>
</math>
P = 2(1 - Phi(|Z|))
2 (1 - CDF[NormalDistribution[0, 1], Abs[z]])
with(Statistics): 2*(1 - CDF(RandomVariable(Normal(0, 1)), abs(z)));
p = 2*(1 - normcdf(abs(z)));
P = 2(1 - Φ(|Z|))
ChatGPT 에게 물어서 계산하는 방법
당신은 통계 계산 도우미입니다. 다음 계산을 반드시 Python 코드를 실제로 실행해서 하고, 실행 결과의 숫자만을 근거로 답해 주세요(암산이나 추측으로 답하지 마세요).

z검정을 했더니 검정통계량이 Z = 2.5가 되었습니다. 검정통계량은 표준정규분포를 따른다고 볼 수 있다고 합니다(math.erf나 statistics.NormalDist 등 Python의 표준 라이브러리를 써도 됩니다).
다음 값을 각각 구해 주세요.
1. 왼쪽 p값 P(x<Z)
2. 오른쪽 p값 P(x>Z)
3. 양측 p값 P(x<−Z 또는 x>Z)
4. 유의수준 0.05의 양측검정으로 보았을 때 귀무가설을 기각할 수 있는지

계산에 쓴 식과 실행 결과의 숫자를 보여 주세요.
사용법
-
1숫자 입력계산하고 싶은 숫자를 입력란에 입력합니다
-
2계산‘계산’ 버튼을 누릅니다
-
3결과 확인계산 결과가 바로 표시됩니다. 계산의 원리와 공식 해설도 같은 페이지에서 확인할 수 있습니다
DataChef의 특징

전문 지식 없이도 직관적이고 간단하게 사용

개인정보를 등록하지 않고도 이용할 수 있습니다

"다운로드"를 누르면 파일이 자동으로 삭제됩니다


출처 표기 불필요

상업적 이용 허가 연락도 필요 없습니다
관련 기능
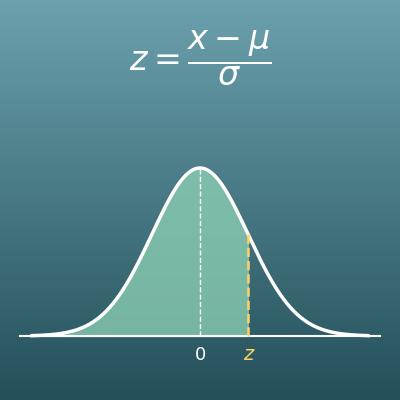
z점수 계산기(z값과 확률 상호 변환)
측정값, 평균, 표준편차로 z점수를 계산합니다. 표준정규분포표 대신으로도 쓸 수 있습니다
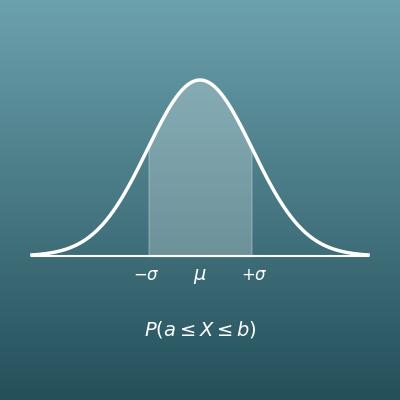
정규분포 확률 계산기
평균과 표준편차로 지정한 범위에 들어갈 확률이나 상위 몇 %인지를 계산합니다