






























































































































자료의 숫자를 쉼표(,)나 공백으로 구분해 입력하세요. 입력 순서는 상관없습니다(계산할 때 작은 순서로 다시 정렬합니다).
이 페이지에서 할 수 있는 것
- 자료의 숫자를 넣기만 하면 제1사분위수 \(Q_1\), 중앙값(제2사분위수) \(Q_2\), 제3사분위수 \(Q_3\), 사분위수 범위 IQR, 사분위편차, 최솟값, 최댓값을 한꺼번에 계산할 수 있습니다
- 계산 결과로 상자그림을 그 자리에서 그립니다(PNG, SVG로 저장할 수 있습니다)
- 이상값(\(Q_1 - 1.5 \times \mathrm{IQR}\)보다 작거나 \(Q_3 + 1.5 \times \mathrm{IQR}\)보다 큰 값)도 자동으로 판정하고, 상자그림에서는 이상값을 따로 점으로 표시합니다
- 사분위수는 중학교 교과서와 같은 방법(중앙값으로 나눈 두 절반 각각의 중앙값)으로 계산하고, 풀이 과정(하위 절반과 상위 절반으로 나누는 방법)도 보여 줍니다
- 공식의 쉬운 해설과 Excel·Google 스프레드시트·Python에 그대로 복사해 쓸 수 있는 수식도 이 페이지에 정리되어 있습니다
이 계산은 어디에 쓰일까요?
시험 점수는 평균 점수만으로는 ‘전체가 어떻게 흩어져 있는지’를 알 수 없습니다. 사분위수를 쓰면 ‘가운데 절반의 학생은 몇 점에서 몇 점 사이인지’, ‘상위 25%에 들려면 몇 점이 필요한지’를 읽어 낼 수 있습니다.
학교 성적 자료나 모의고사 결과 분석에서는 반별·과목별 상자그림을 나란히 놓고 분포의 차이를 한눈에 비교하는 방법을 흔히 씁니다.
월급이나 저축액 같은 자료는 일부의 극단적으로 큰 값에 평균이 끌려가서 ‘평균 = 보통 사람의 값’이 되지 않는 것으로 알려져 있습니다. 이런 자료는 중앙값이나 제1·제3사분위수로 분포를 보는 편이 실감에 가깝고, 통계청의 소득·임금 통계도 평균과 함께 중위값(중앙값)을 발표합니다.
‘나는 전체에서 어느 정도 위치인지’ 알고 싶을 때 사분위수는 평균보다 믿을 만한 잣대입니다.
제품의 치수 자료, 센서의 측정값, 분석하기 전의 데이터에서 ‘의심스러운 값’을 찾을 때 1.5×IQR 규칙은 가장 많이 쓰는 기준 중 하나입니다. 평균이나 표준편차와 달리 이상값 자체의 영향을 잘 받지 않으므로 이상값을 찾는 잣대로 편리합니다.
다만 이상값이 곧 오류라고는 할 수 없으므로, 실무에서는 기계적으로 버리지 않고 원인(입력 실수인지, 정말로 일어난 드문 현상인지)을 확인한 뒤 어떻게 다룰지 정합니다.
육상이나 수영 선수의 기록은 평균적인 빠르기뿐 아니라 ‘안정적인지’도 중요합니다. 여러 선수나 시기별 기록을 상자그림으로 나란히 놓으면 빠르기와 안정감(상자가 얼마나 작은지)을 동시에 비교할 수 있습니다.
기상 분야에서도 도시별·월별 기온이나 강수량이 흩어진 정도를 비교하는 그림으로 상자그림을 자주 씁니다.
공식과 그림
용어·기호 해설
기호
| \(Q_1\) | 큐 원 | 제1사분위수입니다. \(Q\)는 quartile(사분위수)의 머리글자입니다. 자료를 작은 순서로 정렬했을 때 아래에서 4분의 1(약 25%) 위치에 해당하는 값으로, 하위 절반(앞쪽)의 중앙값으로 구합니다. |
| \(Q_2\) | 큐 투 | 제2사분위수입니다. 자료 전체의 딱 한가운데 값, 즉 중앙값 그 자체입니다. 상자그림에서는 상자 안의 칸막이 선에 해당합니다. |
| \(Q_3\) | 큐 스리 | 제3사분위수입니다. 아래에서 4분의 3(약 75%) 위치에 해당하는 값으로, 상위 절반(뒤쪽)의 중앙값으로 구합니다. |
| \(\mathrm{IQR}\) | 아이 큐 알 | 사분위수 범위입니다. interquartile range(사분위수 사이의 범위)의 머리글자로, \(Q_3 - Q_1\)을 말합니다. 가운데 약 50%의 자료가 들어가는 폭을 나타냅니다. |
| \(x\) | 엑스 | 자료의 하나하나의 값을 나타내는 문자입니다. 이 페이지에서는 이상값을 판정하는 식(\(x < Q_1 - 1.5 \times \mathrm{IQR}\) 등)에 나옵니다. |
| \(n\) | 엔 | 자료의 개수입니다. number(수)의 머리글자입니다. 사분위수를 구할 때는 \(n\)이 짝수인지 홀수인지에 따라 중앙값을 다루는 방법이 달라집니다. |
용어
| 사분위수 | 자료를 작은 순서로 정렬해 개수로 4등분했을 때 세 군데의 경계에 해당하는 값입니다. 작은 쪽부터 제1사분위수 \(Q_1\), 제2사분위수 \(Q_2\)(= 중앙값), 제3사분위수 \(Q_3\)라고 합니다. |
| 중앙값 | 자료를 작은 순서로 정렬했을 때 딱 한가운데에 있는 값(메디안)입니다. 자료가 짝수 개일 때는 가운데 두 값의 평균입니다. 평균과 달리 극단적으로 크거나 작은 값의 영향을 잘 받지 않는 대푯값입니다. |
| 하위 절반 | 자료를 중앙값으로 나누었을 때 앞쪽(중앙값보다 작은 쪽)의 자료 모음입니다. 자료가 홀수 개일 때는 중앙값 자체는 넣지 않습니다. 하위 절반의 중앙값이 \(Q_1\)입니다. |
| 상위 절반 | 자료를 중앙값으로 나누었을 때 뒤쪽(중앙값보다 큰 쪽)의 자료 모음입니다. 자료가 홀수 개일 때는 중앙값 자체는 넣지 않습니다. 상위 절반의 중앙값이 \(Q_3\)입니다. |
| 사분위수 범위 (사분위범위) | \(Q_3 - Q_1\)을 말합니다(IQR). 가운데 약 50%의 자료가 들어가는 폭으로, 흩어진 정도를 나타내는 지표로 씁니다. 이상값의 영향을 잘 받지 않는 것이 특징입니다. |
| 사분위편차 | 사분위수 범위를 2로 나눈 값입니다. 중앙값에서 앞뒤로 어느 정도 폭에 가운데 절반의 자료가 흩어져 있는지를 나타내는 기준입니다. |
| 상자그림 (상자 수염 그림) | 최솟값, \(Q_1\), 중앙값, \(Q_3\), 최댓값의 다섯 값(다섯 숫자 요약)을 수직선 위에 ‘상자’와 ‘수염’으로 나타낸 그림입니다. 여러 자료의 흩어진 정도를 나란히 놓고 비교하는 데 알맞으며, 2022 개정 교육과정에서 중학교 3학년 내용으로 새로 들어왔습니다. |
| 수염 | 상자그림의 상자에서 왼쪽과 오른쪽으로 뻗은 선입니다. 기본형에서는 최솟값과 최댓값까지 그립니다. 이상값을 따로 나타내는 방식에서는 이상값을 뺀 최솟값·최댓값까지만 그리고, 이상값은 하나하나 점으로 찍습니다. |
| 이상값 (이상치) | 다른 값들에서 극단적으로 떨어진 값입니다. 자주 쓰는 기준이 1.5×IQR 규칙(\(Q_1 - 1.5 \times \mathrm{IQR}\)보다 작거나 \(Q_3 + 1.5 \times \mathrm{IQR}\)보다 큰 값)입니다. |
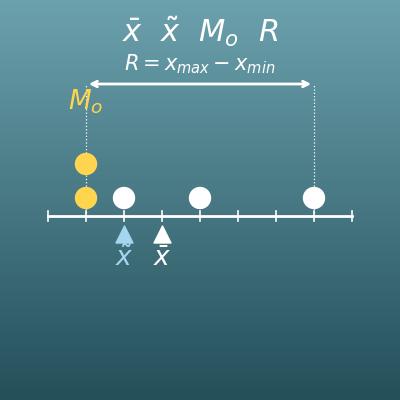
| 대푯값 | 자료 전체의 특징을 하나의 수로 대표하게 한 값입니다. 평균, 중앙값, 최빈값 등이 있습니다. 사분위수는 중앙값의 생각을 ‘4등분하는 경계’로 넓힌 것입니다. |
| 범위 | 최댓값에서 최솟값을 뺀 값입니다. 자료 전체가 퍼진 폭을 나타내지만, 이상값이 하나만 있어도 크게 달라진다는 약점이 있고, 이를 보완하는 것이 사분위수 범위입니다. |
먼저 알아 두면 좋은 내용
이 페이지의 계산을 ‘뜻을 이해하고’ 쓸 수 있도록, 미리 알아 두면 좋은 내용을 정리했습니다.
막히면 이 표의 내용으로 돌아가 복습하는 것이 지름길입니다.
| 수의 크기 비교와 수직선(초등학교~중학교 1학년, 7~13세) |
|
| 평균·중앙값 등의 대푯값(초등학교 5학년~중학교, 10~15세) |
|
| 상자그림과 사분위수 범위(중학교 3학년, 14~15세) |
|
| 소수·분수의 계산(초등학교 5학년~중학교 1학년, 10~13세) |
|
| 산포도와 분포의 모양(중학교, 12~15세) |
|
Excel로 계산하는 방법
| 자료 1(작은 순서로 입력) | 2 |
| 자료 2 | 3 |
| 자료 3 | 4 |
| 자료 4 | 5 |
| 자료 5 | 6 |
| 자료 6 | 7 |
| 자료 7 | 7 |
| 자료 8 | 7 |
| 자료 9 | 8 |
| 자료 10 | 10 |
| 중앙값 Q2(전체의 중앙값) | =MEDIAN(B1:B10) |
| 제1사분위수 Q1(하위 절반 = 앞쪽 5개의 중앙값) | =MEDIAN(B1:B5) |
| 제3사분위수 Q3(상위 절반 = 뒤쪽 5개의 중앙값) | =MEDIAN(B6:B10) |
| 사분위수 범위 IQR | =B13-B12 |
| 사분위편차 | =B14/2 |
| 자료 1 | 2 |
| 자료 2 | 3 |
| 자료 3 | 4 |
| 자료 4 | 5 |
| 자료 5 | 6 |
| 자료 6 | 7 |
| 자료 7 | 7 |
| 자료 8 | 7 |
| 자료 9 | 8 |
| 자료 10 | 10 |
| Q1(QUARTILE.INC) | =QUARTILE.INC(B1:B10,1) |
| Q2(QUARTILE.INC) | =QUARTILE.INC(B1:B10,2) |
| Q3(QUARTILE.INC) | =QUARTILE.INC(B1:B10,3) |
| 제1사분위수 Q1 | 4 |
| 제3사분위수 Q3 | 7 |
| 사분위수 범위 IQR | =B2-B1 |
| 이상값 기준(아래쪽) Q1−1.5×IQR | =B1-1.5*B3 |
| 이상값 기준(위쪽) Q3+1.5×IQR | =B2+1.5*B3 |
두 번째 표의 QUARTILE.INC 함수는 자료 사이를 보간하는 다른 방법을 쓰므로 교과서의 방법과 값이 다를 수 있습니다. 같은 자료로도 QUARTILE.INC는 Q1 = 4.25가 되어 첫 번째 표의 Q1 = 4와 다릅니다(이 예에서는 Q2 = 6.5, Q3 = 7이 우연히 같습니다). 숙제의 답을 확인할 때는 첫 번째 표를 쓰세요.
세 번째 표는 이상값의 기준으로, 아래쪽이 −0.5, 위쪽이 11.5입니다. 아래쪽 기준(−0.5)보다 작거나 위쪽 기준(11.5)보다 큰 자료가 이상값입니다.
Google 스프레드시트로 계산하는 방법
| 자료 1(작은 순서로 입력) | 2 |
| 자료 2 | 3 |
| 자료 3 | 4 |
| 자료 4 | 5 |
| 자료 5 | 6 |
| 자료 6 | 7 |
| 자료 7 | 7 |
| 자료 8 | 7 |
| 자료 9 | 8 |
| 자료 10 | 10 |
| 중앙값 Q2(전체의 중앙값) | =MEDIAN(B1:B10) |
| 제1사분위수 Q1(하위 절반 = 앞쪽 5개의 중앙값) | =MEDIAN(B1:B5) |
| 제3사분위수 Q3(상위 절반 = 뒤쪽 5개의 중앙값) | =MEDIAN(B6:B10) |
| 사분위수 범위 IQR | =B13-B12 |
| 사분위편차 | =B14/2 |
| 자료 1 | 2 |
| 자료 2 | 3 |
| 자료 3 | 4 |
| 자료 4 | 5 |
| 자료 5 | 6 |
| 자료 6 | 7 |
| 자료 7 | 7 |
| 자료 8 | 7 |
| 자료 9 | 8 |
| 자료 10 | 10 |
| Q1(QUARTILE) | =QUARTILE(B1:B10,1) |
| Q2(QUARTILE) | =QUARTILE(B1:B10,2) |
| Q3(QUARTILE) | =QUARTILE(B1:B10,3) |
| 제1사분위수 Q1 | 4 |
| 제3사분위수 Q3 | 7 |
| 사분위수 범위 IQR | =B2-B1 |
| 이상값 기준(아래쪽) Q1−1.5×IQR | =B1-1.5*B3 |
| 이상값 기준(위쪽) Q3+1.5×IQR | =B2+1.5*B3 |
Python으로 계산하는 방법
# 자료(원하는 숫자로 바꾸세요)
data = [3, 7, 7, 4, 10, 8, 6, 5, 7, 2]

def median(sorted_values):
    # 정렬된 리스트의 중앙값(짝수 개면 가운데 두 값의 평균)
    count = len(sorted_values)
    middle = count // 2
    if count % 2 == 1:
        return sorted_values[middle]
    return (sorted_values[middle - 1] + sorted_values[middle]) / 2

values = sorted(data)
n = len(values)
lower_half = values[: n // 2]        # 하위 절반(홀수 개면 중앙값을 뺀 앞쪽 절반)
upper_half = values[(n + 1) // 2:]   # 상위 절반(뒤쪽 절반, 같은 방법)

q1 = median(lower_half)
q2 = median(values)
q3 = median(upper_half)
iqr = q3 - q1
quartile_deviation = iqr / 2
fence_low = q1 - 1.5 * iqr
fence_high = q3 + 1.5 * iqr
outliers = [v for v in values if v < fence_low or v > fence_high]

print(f"Q1 = {q1}, Q2(중앙값) = {q2}, Q3 = {q3}")
print(f"사분위수 범위 IQR = {iqr}, 사분위편차 = {quartile_deviation}")
print(f"이상값(1.5×IQR 기준): {outliers if outliers else '없음'}")
LaTeX 등 수식 언어로 쓰는 법(복사 가능)
Q₂ = Med(전체), Q₁ = Med(하위 절반), Q₃ = Med(상위 절반)
Q_2 = \mathrm{Med}(\text{전체}),\quad Q_1 = \mathrm{Med}(\text{하위 절반}),\quad Q_3 = \mathrm{Med}(\text{상위 절반})
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mi>Q</mi><mn>2</mn></msub><mo>=</mo>
    <mi>Med</mi><mo>(</mo><mtext>전체</mtext><mo>)</mo>
    <mo>,</mo>
    <msub><mi>Q</mi><mn>1</mn></msub><mo>=</mo>
    <mi>Med</mi><mo>(</mo><mtext>하위 절반</mtext><mo>)</mo>
    <mo>,</mo>
    <msub><mi>Q</mi><mn>3</mn></msub><mo>=</mo>
    <mi>Med</mi><mo>(</mo><mtext>상위 절반</mtext><mo>)</mo>
  </mrow>
</math>
Q_2 = "Med"("전체"), Q_1 = "Med"("하위 절반"), Q_3 = "Med"("상위 절반")
q2 = Median[data]; q1 = Median[lower]; q3 = Median[upper] (* lower/upper = 중앙값으로 나눈 앞쪽·뒤쪽 절반 *)
q2 := Statistics:-Median(data); q1 := Statistics:-Median(lower); q3 := Statistics:-Median(upper);
q2 = median(x); q1 = median(lower); q3 = median(upper);
Q_2 = Med(전체), Q_1 = Med(하위 절반), Q_3 = Med(상위 절반)
IQR = Q₃ − Q₁, 사분위편차 = IQR ÷ 2
\mathrm{IQR} = Q_3 - Q_1,\quad \text{사분위편차} = \dfrac{\mathrm{IQR}}{2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>IQR</mi><mo>=</mo>
<msub><mi>Q</mi><mn>3</mn></msub>
<mo>−</mo>
<msub><mi>Q</mi><mn>1</mn></msub>
<mo>,</mo>
<mtext>사분위편차</mtext><mo>=</mo>
<mfrac><mi>IQR</mi><mn>2</mn></mfrac>
</mrow>
</math>
IQR = Q_3 - Q_1, "사분위편차" = IQR / 2
iqr = q3 - q1; quartileDeviation = iqr/2
iqr := q3 - q1; qd := iqr/2;
iqr_value = q3 - q1; qd = iqr_value/2;
IQR = Q_3 − Q_1, 사분위편차 = IQR/2
x < Q₁ − 1.5×IQR 또는 x > Q₃ + 1.5×IQR
x < Q_1 - 1.5 \times \mathrm{IQR} \quad \text{또는} \quad x > Q_3 + 1.5 \times \mathrm{IQR}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>x</mi><mo><</mo>
<msub><mi>Q</mi><mn>1</mn></msub>
<mo>−</mo>
<mn>1.5</mn><mo>×</mo><mi>IQR</mi>
<mtext> 또는 </mtext>
<mi>x</mi><mo>></mo>
<msub><mi>Q</mi><mn>3</mn></msub>
<mo>+</mo>
<mn>1.5</mn><mo>×</mo><mi>IQR</mi>
</mrow>
</math>
x < Q_1 - 1.5 xx IQR " 또는 " x > Q_3 + 1.5 xx IQR
Select[data, # < q1 - 1.5 iqr || # > q3 + 1.5 iqr &]
select(v -> v < q1 - 1.5*iqr or v > q3 + 1.5*iqr, data);
outliers = x(x < q1 - 1.5*iqr | x > q3 + 1.5*iqr);
x < Q_1 − 1.5×IQR 또는 x > Q_3 + 1.5×IQR
ChatGPT 에게 물어서 계산하는 방법
당신은 수학(자료의 분석) 계산 도우미입니다. 다음 계산을 반드시 Python 코드를 실제로 실행해서 하고, 실행 결과의 숫자만을 근거로 답해 주세요(암산이나 추측으로 답하지 마세요).

다음 자료의 사분위수를 우리나라 중학교 교과서의 방법으로 계산해 주세요.
자료: 3, 7, 7, 4, 10, 8, 6, 5, 7, 2

방법: 자료를 작은 순서로 정렬하고 중앙값을 기준으로 하위 절반과 상위 절반으로 나눕니다(자료가 홀수 개일 때는 중앙값을 어느 쪽에도 넣지 않습니다). 하위 절반의 중앙값이 제1사분위수 Q1, 상위 절반의 중앙값이 제3사분위수 Q3입니다. statistics.quantiles처럼 보간하는 함수는 쓰지 마세요.

다음을 각각 보여 주세요.
1. 정렬한 자료와 하위 절반·상위 절반으로 나눈 모습
2. Q1, 중앙값 Q2, Q3의 값
3. 사분위수 범위 IQR과 사분위편차
4. 1.5×IQR 기준의 이상값(Q1 − 1.5×IQR보다 작거나 Q3 + 1.5×IQR보다 큰 값)
사용법
-
1숫자 입력계산하고 싶은 숫자를 입력란에 입력합니다
-
2계산‘계산’ 버튼을 누릅니다
-
3결과 확인계산 결과가 바로 표시됩니다. 계산의 원리와 공식 해설도 같은 페이지에서 확인할 수 있습니다
DataChef의 특징

전문 지식 없이도 직관적이고 간단하게 사용

개인정보를 등록하지 않고도 이용할 수 있습니다

"다운로드"를 누르면 파일이 자동으로 삭제됩니다


출처 표기 불필요

상업적 이용 허가 연락도 필요 없습니다
관련 기능
평균·중앙값·최빈값·범위 계산기(대푯값)
자료의 평균, 중앙값, 최빈값, 범위와 최댓값, 최솟값, 합계를 한꺼번에 계산합니다
표준편차 계산기(모표준편차·표본표준편차)
자료의 흩어진 정도를 나타내는 표준편차와 분산을 모집단(N으로 나눔)과 표본(N−1로 나눔) 두 가지 정의로 계산합니다
평균 계산기(산술평균)
산술평균, 가중평균, 기하평균 등 여러 가지 평균을 풀이 과정과 함께 한꺼번에 계산합니다