






























































































































입력 방법을 고르세요. ‘원자료로 만들기’는 자료의 나열로 도수분포표를 자동으로 만들고, ‘도수분포표 직접 입력’은 이미 있는 표의 값을 그대로 입력합니다.
이 페이지에서 할 수 있는 것
- 키, 시험 점수, 통학 시간 같은 원자료(쉼표나 공백으로 구분)를 붙여 넣고 계급의 크기와 첫 계급의 하한만 정하면 도수분포표(계급, 계급값, 도수, 상대도수, 누적도수, 누적상대도수)를 자동으로 만들 수 있습니다
- 이미 있는 도수분포표(계급의 하한·상한·도수)를 직접 입력해 계산할 수도 있습니다
- 계급값으로 구한 평균의 추정값(‘(계급값 × 도수)의 합 ÷ 도수의 합’)을 기약분수(정확한 값)와 소수 두 가지로 보여 줍니다. 최빈값과 중앙값이 들어 있는 계급도 구합니다
- 히스토그램과 도수분포다각형을 자동으로 그리고 PNG, SVG로 저장할 수 있습니다
- ‘계급, 도수, 상대도수’ 등 중학교 1학년 ‘자료의 정리와 해석’에 나오는 용어의 쉬운 해설과 Excel·Google 스프레드시트·Python에 그대로 복사해 쓸 수 있는 수식도 이 페이지에 정리되어 있습니다
이 계산은 어디에 쓰일까요?
시험 점수를 10점 단위의 계급으로 나눈 도수분포표나 히스토그램은 성적 자료에 늘 쓰입니다. 평균 점수가 똑같이 60점이라도 ‘60점 근처에 봉우리가 하나’인지, ‘30점대와 90점대에 봉우리가 둘’인지에 따라 반의 상황은 전혀 다릅니다.
상대도수로 바꾸면 인원이 다른 반이나 학년끼리도 분포를 공평하게 비교할 수 있습니다. 수능의 등급도 같은 생각으로 정해집니다. 점수가 높은 쪽부터 누적 비율이 4%까지면 1등급, 11%까지면 2등급, 23%까지면 3등급…처럼 누적상대도수로 등급의 경계를 나눕니다.
히스토그램은 제조업의 품질 관리에서 쓰는 기본 도구인 ‘QC 7가지 도구’ 중 하나로 꼽힙니다. 제품의 치수나 무게를 재어 도수분포로 만들면 산포의 중심과 퍼진 정도, ‘규격의 상한·하한을 벗어날 것 같은 경향’을 눈으로 확인할 수 있습니다.
분포의 봉우리가 둘로 갈라져 있다면 ‘기계 두 대의 설정이 서로 어긋난 것은 아닐까’처럼 불량의 원인을 찾는 실마리도 됩니다.
통계청의 인구주택총조사에 나오는 연령별 인구나, 가계금융복지조사의 소득 구간별 가구 분포는 도수분포표의 형태로 발표됩니다. 소득처럼 한쪽으로 치우친 자료는 일부의 큰 값에 끌려 평균이 중앙값보다 높아지는 것으로 알려져 있어, ‘평균 ○○만 원’이라는 숫자만으로는 실제 모습을 잘못 읽을 수 있습니다.
도수분포표라면 ‘어느 계급에 가장 많은 가구가 있는지(최빈값의 계급)’, ‘한가운데 가구는 어느 계급인지(중앙값이 들어 있는 계급)’까지 보이므로 분포의 전체 모습으로 판단할 수 있습니다.
기상 분야에서는 관측한 강수량이나 기온 자료를 계급으로 나누어 ‘시간당 30mm 이상의 매우 강한 비가 1년에 몇 번 있었는지’처럼 정리합니다. 도수분포로 만들면 해마다·지역마다의 경향 차이나 극단적인 계급이 나타나는 횟수의 변화를 비교할 수 있습니다.
방재 계획은 ‘어느 정도 세기의 현상이 얼마나 자주 일어나는지’라는 분포의 정보를 바탕으로 세웁니다.
학교의 학생건강체력평가(PAPS)는 오래달리기, 윗몸 말아 올리기 같은 종목의 기록을 구간으로 나누어 1~5등급으로 평가합니다. 기록을 계급으로 나눈다는 점에서 도수분포표와 같은 생각입니다.
영유아 건강검진에서 쓰는 소아청소년 성장도표(질병관리청)의 백분위수도, 많은 아이의 키와 몸무게의 분포에서 ‘그 값보다 작은 자료가 전체의 몇 %인지’를 나타낸 것으로 누적상대도수와 같은 생각입니다. 건강검진의 키, 몸무게, 혈압 등의 ‘참고 범위’를 정할 때도 많은 사람의 자료의 분포를 조사하는 것이 출발점입니다.
공식과 그래프
용어·기호 해설
기호
| \(n\) | 엔 | 도수의 합(자료 전체의 개수)을 나타낼 때 쓰는 문자입니다. number(수)의 머리글자입니다. |
| \(f\) | 에프 | 도수(그 계급에 들어가는 자료의 개수)를 나타낼 때 쓰는 문자입니다. frequency(도수·빈도)의 머리글자입니다. |
| \(r\) | 알 | 이 페이지의 복사용 수식에서 상대도수를 나타낼 때 쓰는 문자입니다. relative frequency(상대도수)의 머리글자입니다. |
| \(a,\ b\) | 에이, 비 | 계급의 하한(○ 이상의 ○)과 상한(○ 미만의 ○)입니다. ‘정해진 수’를 나타낼 때는 알파벳의 앞쪽 문자 \(a,\ b,\ c\)를 쓰는 관례가 있습니다. |
| \(m\) | 엠 | 이 페이지에서 계급값(계급의 한가운데 값)을 나타낼 때 쓰는 문자입니다. middle(한가운데)이나 midpoint(중점)의 머리글자입니다. |
| \(\bar{x}\) | 엑스 바 | 평균을 나타내는 기호입니다. 자료의 값을 나타내는 문자 \(x\) 위에 평균을 뜻하는 가로 막대(바)를 붙입니다. 통계 분야에서 널리 쓰는 표기입니다. |
용어
| 도수분포표 | 자료를 몇 개의 계급(구간)으로 나누고, 각 계급에 들어가는 자료의 개수(도수)를 세어 정리한 표입니다. 자료 전체의 모습(분포)을 파악하기 위한 통계의 기본 도구입니다. |
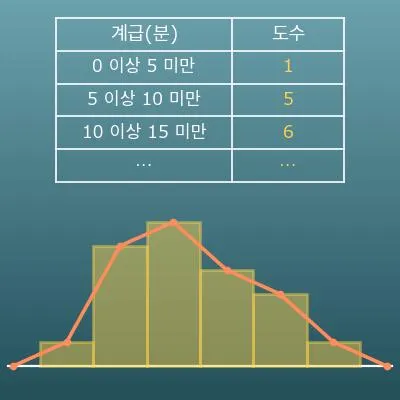
| 계급 | 자료를 나누는 하나하나의 구간을 말합니다. 예를 들어 통학 시간이라면 ‘0분 이상 5분 미만’, ‘5분 이상 10분 미만’, …처럼 같은 크기로 끊김 없이 나누는 것이 보통입니다. |
| 계급의 크기 | 한 계급의 구간의 크기(폭)입니다. ‘10분 이상 15분 미만’이라면 크기는 5분입니다. 크기를 바꾸면 표나 히스토그램의 모양도 달라집니다. |
| 계급값 | 그 계급의 한가운데 값으로, (하한 + 상한) ÷ 2로 구합니다. ‘10분 이상 15분 미만’의 계급값은 12.5분입니다. 도수분포표로 평균을 추정할 때 계급의 대표로 씁니다. |
| 도수 | 그 계급에 들어가는 자료의 개수입니다. 사람 수, 횟수, 개수 등 센 것의 단위로 나타냅니다. |
| 상대도수 | 그 계급의 도수가 전체에서 차지하는 비율입니다. 도수 ÷ 도수의 합으로 구하며 보통 소수로 씁니다. 모든 계급의 상대도수를 더하면 1이 됩니다. |
| 누적도수 | 첫 계급부터 그 계급까지의 도수를 모두 더한 값입니다. ‘○ 미만인 자료가 몇 개인지’를 바로 알 수 있습니다. |
| 누적상대도수 | 첫 계급부터 그 계급까지의 상대도수를 모두 더한 값(누적도수 ÷ 도수의 합)입니다. ‘○ 미만인 자료가 전체의 몇 %인지’를 알 수 있습니다. 마지막 계급에서는 1이 됩니다. |
| 이상 | ‘10 이상’은 10을 포함합니다. 계급의 경계에 있는 자료를 어느 쪽에 넣을지 헷갈리지 않게 하는 약속으로, ‘10 이상 15 미만’인 계급에는 딱 10인 자료가 들어갑니다. |
| 미만 | ‘15 미만’은 15를 포함하지 않습니다. 그래서 ‘10 이상 15 미만’인 계급에는 딱 15인 자료가 들어가지 않고, 하나 위의 ‘15 이상 20 미만’에 들어갑니다. |
| 히스토그램 | 도수분포표를 기둥 모양의 그래프로 나타낸 것입니다. 가로축에 계급, 세로축에 도수를 잡고 직사각형 기둥을 틈 없이 나란히 그립니다. 자료가 흩어진 모양(분포의 모양)을 한눈에 알 수 있습니다. |
| 도수분포다각형 | 히스토그램의 각 기둥 윗변의 한가운데(계급값의 위치)를 차례로 선분으로 이은 그래프입니다. 양 끝은 도수가 0인 계급이 있는 것으로 보고 가로축까지 내립니다. 두 분포를 겹쳐서 비교할 때 편리합니다. |
| 분포 | 자료가 어느 부분에 많고 어느 부분에 적은지, 즉 ‘흩어진 모양’을 말합니다. 도수분포표나 히스토그램은 이 분포를 보기 위한 도구입니다. |
| 대푯값 | 자료 전체의 특징을 하나의 수로 대표하게 한 것입니다. 평균, 중앙값, 최빈값을 자주 씁니다. |
| 평균 | 자료의 값을 모두 더해 자료의 개수로 나눈 값입니다. 도수분포표에서는 (계급값 × 도수)의 합 ÷ 도수의 합으로 추정합니다. |
| 중앙값 | 자료를 작은 순서로 정렬했을 때 딱 한가운데에 오는 값입니다. 자료의 개수가 짝수일 때는 가운데 두 값의 평균입니다. 도수분포표에서는 ‘중앙값이 어느 계급에 들어가는지’를 누적도수로 알아봅니다. |
| 최빈값 | 가장 많이 나타나는 값입니다. 도수분포표에서는 도수가 가장 큰 계급의 계급값을 최빈값으로 합니다. |
| 원자료 | 집계하기 전의, 잰 그대로의 하나하나의 자료를 말합니다. 원자료를 도수분포표로 정리하면 전체의 모습을 보기 쉬워지는 대신 하나하나의 값의 정보는 사라집니다. |
먼저 알아 두면 좋은 내용
이 페이지의 계산을 ‘뜻을 이해하고’ 쓸 수 있도록, 미리 알아 두면 좋은 내용을 정리했습니다.
막히면 이 표의 내용으로 돌아가 복습하는 것이 지름길입니다.
| 이상·미만(초등학교 5학년, 10~11세) |
|
| 평균(초등학교 5학년, 10~11세) |
|
| 비와 비율(초등학교 6학년, 11~12세) |
|
| 분수와 소수(초등학교 3~6학년, 8~12세) |
|
| 대푯값(중학교, 12~15세) |
|
Excel로 계산하는 방법
| 어떤 계급의 도수 f | 6 |
| 도수의 합 n | 20 |
| 상대도수 r = f ÷ n | =B1/B2 |
| 계급의 하한 a | 10 |
| 계급의 상한 b | 15 |
| 계급값 m = (a + b) ÷ 2 | =(B1+B2)/2 |
| 계급값 1(0 이상 5 미만) | 2.5 |
| 계급값 2(5 이상 10 미만) | 7.5 |
| 계급값 3(10 이상 15 미만) | 12.5 |
| 계급값 4(15 이상 20 미만) | 17.5 |
| 계급값 5(20 이상 25 미만) | 22.5 |
| 계급값 6(25 이상 30 미만) | 27.5 |
| 도수 1 | 1 |
| 도수 2 | 5 |
| 도수 3 | 6 |
| 도수 4 | 4 |
| 도수 5 | 3 |
| 도수 6 | 1 |
| (계급값 × 도수)의 합 | =SUMPRODUCT(B1:B6,B7:B12) |
| 도수의 합 n | =SUM(B7:B12) |
| 평균의 추정값 | =B13/B14 |
| 자료 1 | 3 |
| 자료 2 | 5 |
| 자료 3 | 8 |
| 자료 4 | 12 |
| 자료 5 | 14 |
| 자료 6 | 17 |
| 자료 7 | 22 |
| 자료 8 | 26 |
| 0 이상 5 미만의 도수 | =COUNTIFS(B1:B8,">=0",B1:B8,"<5") |
| 5 이상 10 미만의 도수 | =COUNTIFS(B1:B8,">=5",B1:B8,"<10") |
| 10 이상 15 미만의 도수 | =COUNTIFS(B1:B8,">=10",B1:B8,"<15") |
첫 번째 표는 상대도수의 예로, 답은 0.3입니다. 두 번째 표는 계급값의 예로, 답은 12.5입니다.
세 번째 표는 이 페이지 계산기의 예(통학 시간·20명)로 구한 평균의 추정값입니다. SUMPRODUCT는 ‘대응하는 셀끼리 곱해서 더하는’ 함수여서 (계급값 × 도수)의 합을 한 번에 계산할 수 있고, 답은 14입니다.
네 번째 표는 원자료로 각 계급의 도수를 세는 예입니다. COUNTIFS는 ‘조건에 맞는 셀의 개수를 세는’ 함수로, ‘10 이상’과 ‘15 미만’의 두 조건을 나란히 쓰면 그 계급의 도수를 셀 수 있습니다.
Google 스프레드시트로 계산하는 방법
| 어떤 계급의 도수 f | 6 |
| 도수의 합 n | 20 |
| 상대도수 r = f ÷ n | =B1/B2 |
| 계급의 하한 a | 10 |
| 계급의 상한 b | 15 |
| 계급값 m = (a + b) ÷ 2 | =(B1+B2)/2 |
| 계급값 1(0 이상 5 미만) | 2.5 |
| 계급값 2(5 이상 10 미만) | 7.5 |
| 계급값 3(10 이상 15 미만) | 12.5 |
| 계급값 4(15 이상 20 미만) | 17.5 |
| 계급값 5(20 이상 25 미만) | 22.5 |
| 계급값 6(25 이상 30 미만) | 27.5 |
| 도수 1 | 1 |
| 도수 2 | 5 |
| 도수 3 | 6 |
| 도수 4 | 4 |
| 도수 5 | 3 |
| 도수 6 | 1 |
| (계급값 × 도수)의 합 | =SUMPRODUCT(B1:B6,B7:B12) |
| 도수의 합 n | =SUM(B7:B12) |
| 평균의 추정값 | =B13/B14 |
| 자료 1 | 3 |
| 자료 2 | 5 |
| 자료 3 | 8 |
| 자료 4 | 12 |
| 자료 5 | 14 |
| 자료 6 | 17 |
| 자료 7 | 22 |
| 자료 8 | 26 |
| 0 이상 5 미만의 도수 | =COUNTIFS(B1:B8,">=0",B1:B8,"<5") |
| 5 이상 10 미만의 도수 | =COUNTIFS(B1:B8,">=5",B1:B8,"<10") |
| 10 이상 15 미만의 도수 | =COUNTIFS(B1:B8,">=10",B1:B8,"<15") |
Python으로 계산하는 방법
from fractions import Fraction

# 원자료(예: 학생 20명의 통학 시간, 단위는 분)
data_values = [5, 12, 8, 14, 3, 22, 15, 9, 11, 26,
               7, 14, 19, 6, 13, 24, 10, 16, 21, 18]
class_width = Fraction(5)   # 계급의 크기
first_lower = Fraction(0)   # 첫 계급의 하한

data_values = [Fraction(v) for v in data_values]
class_count = max(int((v - first_lower) / class_width) for v in data_values) + 1

# 각 자료를 계급에 나누어 넣기(하한은 포함, 상한은 포함하지 않음)
freqs = [0] * class_count
for v in data_values:
    freqs[int((v - first_lower) / class_width)] += 1

total = sum(freqs)
mid_times_freq_sum = Fraction(0)
print("계급 / 계급값 / 도수 / 상대도수")
for i, f in enumerate(freqs):
    lower = first_lower + i * class_width
    upper = lower + class_width
    midpoint = (lower + upper) / 2
    mid_times_freq_sum += midpoint * f
    print(f"{lower} 이상 {upper} 미만 / {float(midpoint)} / {f} / {float(Fraction(f, total))}")

estimated_mean = mid_times_freq_sum / total
print(f"평균의 추정값(분수): {estimated_mean}")
print(f"평균의 추정값(소수): {float(estimated_mean)}")
print(f"원자료의 평균: {float(sum(data_values) / len(data_values))}")
LaTeX 등 수식 언어로 쓰는 법(복사 가능)
r = f ÷ n
r = \dfrac{f}{n}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>r</mi>
    <mo>=</mo>
    <mfrac><mi>f</mi><mi>n</mi></mfrac>
  </mrow>
</math>
r = f/n
r = f/n
r := f/n;
r = f/n;
r = f/n
m = (a + b) ÷ 2
m = \dfrac{a + b}{2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>m</mi>
    <mo>=</mo>
    <mfrac>
      <mrow><mi>a</mi><mo>+</mo><mi>b</mi></mrow>
      <mn>2</mn>
    </mfrac>
  </mrow>
</math>
m = (a + b)/2
m = (a + b)/2
m := (a + b)/2;
m = (a + b)/2;
m = (a + b)/2
x̄ = (m₁×f₁ + m₂×f₂ + … + mₖ×fₖ) ÷ n
\bar{x} = \dfrac{m_1 f_1 + m_2 f_2 + \cdots + m_k f_k}{n}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>=</mo>
<mfrac>
<mrow>
<msub><mi>m</mi><mn>1</mn></msub><msub><mi>f</mi><mn>1</mn></msub>
<mo>+</mo>
<msub><mi>m</mi><mn>2</mn></msub><msub><mi>f</mi><mn>2</mn></msub>
<mo>+</mo><mo>⋯</mo><mo>+</mo>
<msub><mi>m</mi><mi>k</mi></msub><msub><mi>f</mi><mi>k</mi></msub>
</mrow>
<mi>n</mi>
</mfrac>
</mrow>
</math>
bar x = (m_1 f_1 + m_2 f_2 + cdots + m_k f_k)/n
Total[m*f]/Total[f]
xbar := add(m[i]*f[i], i = 1..k)/n;
xbar = sum(m.*f)/sum(f);
x̄ = (m_1 f_1 + m_2 f_2 + … + m_k f_k)/n
ChatGPT 에게 물어서 계산하는 방법
당신은 수학(자료의 정리와 해석·통계) 계산 도우미입니다. 다음 계산을 반드시 Python 코드를 실제로 실행해서 하고, 실행 결과의 숫자만을 근거로 답해 주세요(암산이나 추측으로 답하지 마세요).

다음 자료로 첫 계급의 하한이 0, 계급의 크기가 5인 도수분포표를 만들어 주세요(계급은 ‘이상~미만’으로 나눕니다).
자료: 5, 12, 8, 14, 3, 22, 15, 9, 11, 26, 7, 14, 19, 6, 13, 24, 10, 16, 21, 18
다음을 각각 보여 주세요.
1. 도수분포표(계급, 계급값, 도수, 상대도수, 누적도수, 누적상대도수)
2. 계급값으로 구한 평균의 추정값(기약분수와 소수 두 가지로)
3. 최빈값과 중앙값이 들어 있는 계급
4. 원자료로 직접 계산한 평균과, 추정값과의 차이

Python에서는 표준 라이브러리의 fractions 모듈로 정확하게 계산하고, 계산에 사용한 공식과 실행 결과의 숫자를 보여 주세요.
사용법
-
1숫자 입력계산하고 싶은 숫자를 입력란에 입력합니다
-
2계산‘계산’ 버튼을 누릅니다
-
3결과 확인계산 결과가 바로 표시됩니다. 계산의 원리와 공식 해설도 같은 페이지에서 확인할 수 있습니다
DataChef의 특징

전문 지식 없이도 직관적이고 간단하게 사용

개인정보를 등록하지 않고도 이용할 수 있습니다

"다운로드"를 누르면 파일이 자동으로 삭제됩니다


출처 표기 불필요

상업적 이용 허가 연락도 필요 없습니다
관련 기능
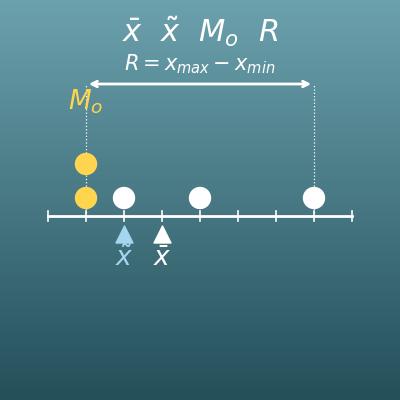
평균·중앙값·최빈값·범위 계산기(대푯값)
원자료로 평균, 중앙값, 최빈값, 범위의 네 가지 대푯값을 한꺼번에 계산하고 언제 무엇을 쓰는지도 해설합니다
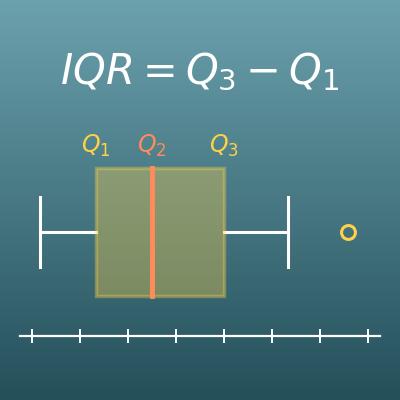
사분위수·상자그림 계산기(Q1·Q2·Q3·사분위수 범위·이상값)
자료의 흩어진 정도를 사분위수와 상자그림으로 나타냅니다. 히스토그램과 함께 ‘분포를 보는’ 도구입니다