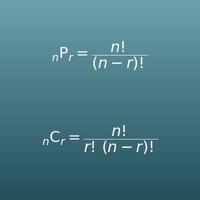































































































































시행 횟수 n, 한 번에 성공할 확률 p, 성공하는 횟수 k를 입력해 주세요. 정확히 k번일 확률, k번 이하·k번 이상의 누적확률, 기댓값·분산·표준편차와 분포 전체의 막대그래프를 한꺼번에 보여 줍니다.
이 페이지에서 할 수 있는 것
- ‘확률이 \(p\)인 일을 \(n\)번 반복할 때 정확히 \(k\)번 일어날 확률’ \(P(X = k) = {}_{n}\mathrm{C}_{k}\, p^{k} (1-p)^{n-k}\)를 숫자 3개만 넣으면 바로 계산할 수 있습니다
- 답은 \(\dfrac{3}{8}\) 같은 기약분수(정확한 값)와 소수·퍼센트로 함께 보여 줍니다. 조합의 수 \({}_{n}\mathrm{C}_{k}\)의 풀이 과정도 볼 수 있습니다
- ‘\(k\)번 이하일 확률 \(P(X \le k)\)’, ‘\(k\)번 이상일 확률 \(P(X \ge k)\)’의 누적확률도 동시에 계산합니다
- 기댓값 \(E(X) = np\), 분산 \(V(X) = np(1-p)\), 표준편차 \(\sigma\)와 정규분포로 근사할 수 있는지에 대한 기준 판정도 보여 줍니다
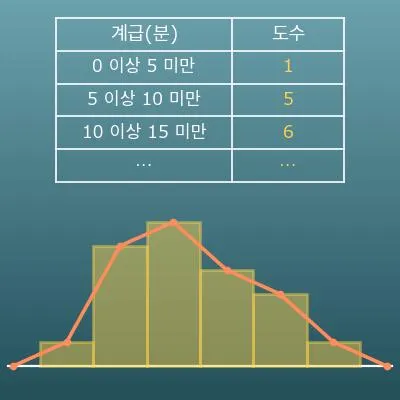
- 일어나는 횟수가 0번부터 \(n\)번까지인 분포 전체를 막대그래프로 그리므로 ‘몇 번쯤이 일어나기 쉬운지’를 한눈에 알 수 있습니다
이 계산은 어디에 쓰일까요?
확률 1%인 가챠를 100번 뽑을 때 당첨 횟수는 이항분포 \(B(100,\ 0.01)\)을 따릅니다(매번 확률이 같고 독립이라고 공개된 경우). 한 번도 당첨되지 않을 확률이 \(0.99^{100} \fallingdotseq 36.6\%\)나 되므로, ‘100번 뽑으면 1%라도 거의 확실하다’는 직관이 위험하다는 것을 분포에서 읽을 수 있습니다.
과금 예산을 생각할 때 ‘기댓값 \(np\)번 + 흩어진 정도’로 어림하는 것이 바로 이 페이지의 계산입니다.
공장에서는 전수 검사 대신 ‘로트에서 \(n\)개를 뽑아 불량이 \(c\)개 이하면 합격’이라는 샘플링 검사(발췌 검사)를 씁니다. 불량률이 \(p\)인 로트가 합격할 확률은 이항분포의 누적확률 \(P(X \le c)\) 그 자체이며, 예를 들어 불량률 1%인 로트에서 20개를 뽑아 불량 0개면 합격으로 하면 합격할 확률은 \(0.99^{20} \fallingdotseq 81.8\%\)입니다.
‘불량률이 어느 정도까지면 높은 확률로 합격시키고, 나쁜 로트는 떨어뜨릴 수 있을까’라는 검사 기준 설계에 이 계산이 쓰입니다.
5지선다 20문제를 모두 찍어서 답하면 정답 수는 이항분포 \(B(20,\ 0.2)\)를 따르고, 기댓값은 \(20 \times 0.2 = 4\)문제입니다. 운으로 8문제 이상 맞힐 확률은 약 3.2%밖에 되지 않아, ‘감만으로는 합격선에 닿기 어렵다’는 것을 확률로 뒷받침할 수 있습니다.
시험을 만드는 쪽도 운으로 합격선을 넘기 어렵도록 이 분포를 의식해서 문제 수나 기준을 정합니다.
자유투 성공률 70%인 선수가 10개를 던질 때 정확히 7개를 넣을 확률은 \({}_{10}\mathrm{C}_{7} \times 0.7^{7} \times 0.3^{3} \fallingdotseq 26.7\%\)밖에 되지 않습니다(매번 독립이고 성공률이 일정하다고 볼 때). ‘7할 선수가 10개 중 7개를 넣는’ 것은 생각만큼 당연하지 않고, 6개나 8개가 되는 일도 흔히 일어납니다.
잘 풀리거나 안 풀리는 것처럼 보이는 결과 중 어디까지가 ‘확률적으로 보통인 흩어짐’인지를 가려내는 데 이항분포가 쓰입니다.
‘지지율’이나 ‘시청률’ 조사에서는 조사 대상 \(n\)명 중 해당하는 사람 수가 이항분포를 따른다고 봅니다. 오차의 기준으로 쓰이는 ‘±몇 %p’는 표준편차 \(\sqrt{np(1-p)}\)와 정규분포에 의한 근사로 계산한 것입니다.
‘몇 명에게 물으면 오차를 어디까지 줄일 수 있을까’라는 표본 크기 설계는 이항분포의 성질 자체가 근거가 됩니다.
공식과 그래프
용어·기호 해설
기호
| \(X\) | 대문자 엑스 | ‘일어나는 횟수’를 나타내는 확률변수입니다. 결과가 확률로 정해지는 수에는 알파벳 끝쪽의 대문자 \(X,\ Y,\ Z\)를 쓰는 관례가 있습니다. |
| \(P(X = k)\) | 피 엑스 이퀄 케이 | 일어나는 횟수 \(X\)가 정확히 \(k\)번이 될 확률입니다. \(P\)는 확률을 뜻하는 영어 probability의 머리글자입니다. |
| \({}_{n}\mathrm{C}_{k}\) | 엔 씨 케이(콤비네이션) | \(n\)개에서 \(k\)개를 고르는 조합의 수입니다. \(C\)는 조합을 뜻하는 영어 combination의 머리글자입니다. 외국이나 대학 교재에서는 \(\dbinom{n}{k}\)로 쓰기도 합니다. |
| \(n\) | 엔 | 시행 횟수(반복하는 횟수)입니다. 횟수나 개수에는 number(수)의 머리글자 \(n\)을 자주 씁니다. |
| \(p\) | 피 | 한 번의 시행에서 성공할 확률입니다. probability(확률)의 머리글자로, 소문자는 ‘한 번의 확률’에 자주 씁니다. |
| \(1 - p\) | 일 빼기 피 | 한 번의 시행에서 실패할 확률(성공하지 않을 확률)입니다. 성공과 실패 중 하나는 반드시 일어나므로 전체 \(1\)에서 \(p\)를 뺀 나머지입니다. \(q\)로 쓰기도 합니다. |
| \(k\) | 케이 | 성공하는 횟수입니다. \(0\)부터 \(n\)까지의 정수입니다. ‘몇 번 일어나는지’를 정하는 문자로 \(k\)를 자주 씁니다. |
| \(P(X \le k)\) | 피 엑스 작거나 같다 케이 | 일어나는 횟수가 \(k\)번 이하(0번~\(k\)번 중 하나)일 확률입니다. ‘정확한 확률’을 \(k\)번까지 더한 누적확률입니다. |
| \(P(X \ge k)\) | 피 엑스 크거나 같다 케이 | 일어나는 횟수가 \(k\)번 이상(\(k\)번~\(n\)번 중 하나)일 확률입니다. 전체 \(1\)에서 \(P(X \le k-1)\)을 빼면(여사건) 덧셈을 줄여서 구할 수 있습니다. |
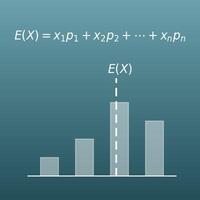
| \(E(X)\) | 이 엑스 | 기댓값(평균적으로 일어나는 횟수)입니다. \(E\)는 기댓값을 뜻하는 영어 expectation의 머리글자입니다. 이항분포에서는 \(E(X) = np\)가 됩니다. |
| \(V(X)\) | 브이 엑스 | 분산(흩어진 정도)입니다. \(V\)는 분산을 뜻하는 영어 variance의 머리글자입니다. 이항분포에서는 \(V(X) = np(1-p)\)가 됩니다. |
| \(\sigma\) | 시그마 | 표준편차입니다. 그리스 문자 시그마의 소문자로, standard deviation의 s에 해당하는 문자입니다. 분산의 제곱근 \(\sigma = \sqrt{V(X)}\)로, 기댓값에서 벗어나는 정도의 기준을 나타냅니다. |
| \(B(n,\ p)\) | 비 엔 피 | 시행 횟수 \(n\), 성공 확률 \(p\)인 이항분포입니다. \(B\)는 binomial(이항의)의 머리글자입니다. ‘\(X\)는 이항분포를 따른다’를 \(X \sim B(n,\ p)\)로 씁니다. |
| \(N(m,\ \sigma^2)\) | 엔 엠 시그마 제곱 | 평균 \(m\), 분산 \(\sigma^2\)인 정규분포입니다. \(N\)은 정규분포를 뜻하는 영어 normal distribution의 머리글자입니다. 괄호 안은 ‘평균, 분산’의 순서로 쓰는 것이 관례입니다(평균을 \(\mu\)로 쓰는 책도 있습니다). |
| \(\fallingdotseq\) | 근사적으로 같다 | 대략 같다는 것을 나타내는 기호입니다. 이 페이지에서는 ‘이항분포를 정규분포로 대략 바꿔 놓을 수 있다’는 것을 나타내는 데 쓰고 있습니다. |
용어
| 이항분포 | ‘확률이 \(p\)인 일을 \(n\)번 반복할 때 몇 번 일어나는가’의 확률분포입니다. 이름은 식에 나오는 \({}_{n}\mathrm{C}_{k}\)가 이항계수(이항정리의 계수)와 같다는 데서 왔습니다. 고등학교 ‘확률과 통계’의 통계 단원에서 배웁니다. |
| 확률변수 | 값이 확률로 정해지는 변수를 말합니다. 이 페이지에서는 ‘일어나는 횟수’가 확률변수이며, 0번부터 최대 n번까지의 값을 각각 정해진 확률로 갖습니다. |
| 시행 | 동전을 던지거나 제비를 한 번 뽑는 것처럼, 결과가 우연히 정해지는 실험이나 관찰의 한 번을 말합니다. |
| 독립시행 | 같은 시행을 매번 같은 확률로, 서로의 결과에 영향을 주지 않도록(독립으로) 반복하는 것을 말합니다. 이항분포는 독립시행에서 ‘성공 횟수’의 분포입니다. |
| 독립 | 어떤 시행의 결과가 다른 시행의 결과에 영향을 주지 않는 것을 말합니다. 주사위의 첫 번째와 두 번째는 독립이지만, 뽑은 제비를 되돌려 놓지 않고 계속 뽑는 경우는 독립이 아닙니다(앞의 결과에 따라 남은 당첨 제비 수가 바뀌기 때문입니다). |
| 조합 | \(n\)개에서 \(k\)개를 ‘순서를 구별하지 않고’ 고르는 방법입니다. 그 총수가 \({}_{n}\mathrm{C}_{k}\)입니다. 이항분포에서는 ‘\(n\)번 중 몇 번째에 성공하는가’를 고르는 방법의 수로 나옵니다. |
| 누적확률 | ‘정확히 \(k\)번’의 확률을 어떤 횟수까지 더한 확률입니다. ‘\(k\)번 이하일 확률’ \(P(X \le k)\)가 대표적입니다. |
| 여사건 | 어떤 일이 ‘일어나지 않는’ 쪽의 사건입니다. 확률의 합은 반드시 1이므로 ‘\(k\)번 이상’ 같은 확률은 1에서 반대쪽(\(k-1\)번 이하)의 확률을 빼면 간단히 구할 수 있습니다. |
| 기댓값 | 그 시행을 여러 번 했을 때의 평균값입니다. 이항분포에서는 ‘평균적으로 몇 번 일어나는가’이며, \(np\)라는 간단한 식이 됩니다. |
| 분산 | 실제 값이 기댓값에서 얼마나 벗어나기 쉬운지(흩어진 정도)를 나타내는 양입니다. 벗어난 정도의 제곱의 평균으로 정의됩니다. |
| 표준편차 | 분산의 제곱근입니다. 분산은 ‘제곱’의 단위가 되어 버리므로, 제곱근을 구해 원래 단위(이 페이지에서는 횟수)로 되돌린 흩어진 정도의 기준입니다. |
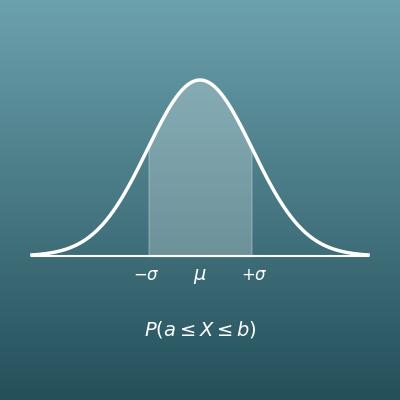
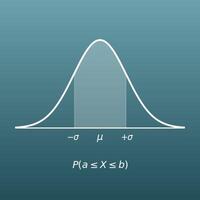
| 정규분포 | 평균 근처가 가장 일어나기 쉽고 평균에서 멀어질수록 일어나기 어려워지는, 좌우 대칭인 종 모양의 분포입니다. 키나 측정 오차 등 세상의 많은 양이 이 모양에 가깝고, 이항분포도 \(n\)이 크면 정규분포에 가까워집니다. |
| 정규근사 | \(n\)이 클 때 이항분포를 정규분포 \(N(np,\ np(1-p))\)로 바꿔 놓고 계산하는 것을 말합니다. \(np \ge 5\) 그리고 \(n(1-p) \ge 5\)가 대표적인 기준입니다. |
먼저 알아 두면 좋은 내용
이 페이지의 계산을 ‘뜻을 알고’ 쓸 수 있도록, 먼저 알아 두면 좋은 내용을 정리했습니다.
막히는 부분이 있으면 이 표의 내용으로 돌아가 복습하는 것이 가장 빠른 길입니다.
| 확률의 기본(중학교 2학년, 13~14세) |
|
| 분수의 계산(초등학교 5학년~중학교 1학년, 10~13세) |
|
| 거듭제곱과 지수(중학교 1학년~고등학교) |
|
| 경우의 수와 조합(고등학교) |
|
| 독립시행의 확률과 여사건(고등학교 ‘확률과 통계’) |
|
| 확률변수와 기댓값·분산(고등학교 ‘확률과 통계’) |
|
| 정규분포(고등학교 ‘확률과 통계’) |
|
Excel로 계산하는 방법
| 시행 횟수 n | 4 |
| 한 번에 성공할 확률 p | 0.5 |
| 성공하는 횟수 k | 2 |
| 정확히 k번 일어날 확률 P(X=k) | =BINOM.DIST(B3,B1,B2,FALSE) |
| 시행 횟수 n | 4 |
| 한 번에 성공할 확률 p | 0.5 |
| 성공하는 횟수 k | 2 |
| k번 이하일 확률 P(X≤k) | =BINOM.DIST(B3,B1,B2,TRUE) |
| k번 이상일 확률 P(X≥k) | =1-BINOM.DIST(B3-1,B1,B2,TRUE) |
| 시행 횟수 n | 30 |
| 한 번에 성공할 확률 p | =1/6 |
| 기댓값 E(X) = np | =B1*B2 |
| 분산 V(X) = np(1-p) | =B1*B2*(1-B2) |
| 표준편차 σ | =SQRT(B4) |
| 시행 횟수 n | 20 |
| 한 번에 성공할 확률 p | 0.5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| 기준 판정 | =IF(AND(B3>=5,B4>=5),"기준 만족","기준 불만족") |
BINOM.DIST는 이항분포의 함수로, 인수는 ‘성공 횟수, 시행 횟수, 성공 확률, 누적 여부’의 순서입니다. 마지막을 FALSE로 하면 ‘정확한 확률’, TRUE로 하면 ‘그 횟수 이하의 누적확률’이 됩니다.
첫 번째 표는 동전을 4번 던져 앞면이 정확히 2번 나오는 예로, 답은 0.375(= 3/8)입니다.
두 번째 표의 답은 둘 다 0.6875입니다. ‘k번 이상’은 ‘k−1번 이하’를 1에서 빼서 구합니다(k에 0을 넣으면 이 식은 오류가 나지만, 0번 이상일 확률은 반드시 1입니다).
세 번째 표는 주사위를 30번 던져 1의 눈이 나오는 횟수의 예로, 기댓값 5, 분산 4.1667, 표준편차 2.0412가 됩니다.
네 번째 표는 np와 n(1−p)가 둘 다 5 이상인지로 정규분포에 의한 근사의 기준을 판정합니다.
Google 스프레드시트로 계산하는 방법
| 시행 횟수 n | 4 |
| 한 번에 성공할 확률 p | 0.5 |
| 성공하는 횟수 k | 2 |
| 정확히 k번 일어날 확률 P(X=k) | =BINOMDIST(B3,B1,B2,FALSE) |
| 시행 횟수 n | 4 |
| 한 번에 성공할 확률 p | 0.5 |
| 성공하는 횟수 k | 2 |
| k번 이하일 확률 P(X≤k) | =BINOMDIST(B3,B1,B2,TRUE) |
| k번 이상일 확률 P(X≥k) | =1-BINOMDIST(B3-1,B1,B2,TRUE) |
| 시행 횟수 n | 30 |
| 한 번에 성공할 확률 p | =1/6 |
| 기댓값 E(X) = np | =B1*B2 |
| 분산 V(X) = np(1-p) | =B1*B2*(1-B2) |
| 표준편차 σ | =SQRT(B4) |
| 시행 횟수 n | 20 |
| 한 번에 성공할 확률 p | 0.5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| 기준 판정 | =IF(AND(B3>=5,B4>=5),"기준 만족","기준 불만족") |
‘k번 이상’의 식은 k에 0을 넣으면 오류가 나는 점도 Excel과 같습니다(0번 이상일 확률은 반드시 1입니다).
Python으로 계산하는 방법
from fractions import Fraction
from math import comb, sqrt

trial_count = 4                  # 시행 횟수 n
success_prob = Fraction(1, 2)    # 한 번에 성공할 확률 p(0.3 같은 소수도 가능)
success_count = 2                # 성공하는 횟수 k

failure_prob = 1 - success_prob

# 정확히 k번 일어날 확률 P(X=k) = nCk × p^k × (1−p)^(n−k)
exact_prob = (comb(trial_count, success_count)
              * success_prob ** success_count
              * failure_prob ** (trial_count - success_count))
print(f"정확히 {success_count}번일 확률: {exact_prob} = {float(exact_prob)}")

# 누적확률(k번 이하·k번 이상)
prob_le = sum(comb(trial_count, i) * success_prob ** i * failure_prob ** (trial_count - i)
              for i in range(success_count + 1))
prob_ge = 1 - prob_le + exact_prob
print(f"{success_count}번 이하일 확률: {prob_le} = {float(prob_le)}")
print(f"{success_count}번 이상일 확률: {prob_ge} = {float(prob_ge)}")

# 기댓값·분산·표준편차
mean = trial_count * success_prob
variance = mean * failure_prob
print(f"기댓값: {mean}  분산: {variance}  표준편차: {sqrt(variance)}")
LaTeX 등 수식 언어로 쓰는 법(복사 가능)
P(X = k) = nCk pᵏ (1 − p)ⁿ⁻ᵏ
P(X = k) = \binom{n}{k} p^{k} (1 - p)^{n - k}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>=</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>k</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>k</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>k</mi></mrow>
</msup>
</mrow>
</math>
P(X = k) = C(n,k) p^k (1-p)^(n-k)
PDF[BinomialDistribution[n, p], k]
binomial(n, k)*p^k*(1-p)^(n-k);
binopdf(k, n, p)
P(X=k) = C(n,k) p^k (1-p)^(n-k)
P(X ≤ k) = Σ[i=0→k] nCi pⁱ (1 − p)ⁿ⁻ⁱ
P(X \le k) = \sum_{i=0}^{k} \binom{n}{i} p^{i} (1 - p)^{n - i}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>≤</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>0</mn></mrow>
<mi>k</mi>
</munderover>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>i</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>i</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>i</mi></mrow>
</msup>
</mrow>
</math>
P(X <= k) = sum_(i=0)^k C(n,i) p^i (1-p)^(n-i)
CDF[BinomialDistribution[n, p], k]
add(binomial(n, i)*p^i*(1-p)^(n-i), i = 0..k);
binocdf(k, n, p)
P(X≤k) = Σ_(i=0)^k C(n,i) p^i (1-p)^(n-i)
E(X) = np, V(X) = np(1 − p), σ = √(np(1 − p))
E(X) = np, \quad V(X) = np(1 - p), \quad \sigma = \sqrt{np(1 - p)}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo><mi>n</mi><mi>p</mi>
<mo>,</mo>
<mi>V</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>,</mo>
<mi>σ</mi><mo>=</mo>
<msqrt><mi>n</mi><mi>p</mi><mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow></msqrt>
</mrow>
</math>
E(X) = np, V(X) = np(1-p), sigma = sqrt(np(1-p))
{Mean[BinomialDistribution[n, p]], Variance[BinomialDistribution[n, p]], StandardDeviation[BinomialDistribution[n, p]]}
n*p; n*p*(1-p); sqrt(n*p*(1-p));
[m, v] = binostat(n, p); s = sqrt(v);
E(X) = np, V(X) = np(1-p), σ = √(np(1-p))
B(n, p) ≒ N(np, np(1 − p))
B(n,\ p) \approx N(np,\ np(1 - p))
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>B</mi><mo>(</mo><mi>n</mi><mo>,</mo><mi>p</mi><mo>)</mo>
<mo>≒</mo>
<mi>N</mi><mo>(</mo><mi>n</mi><mi>p</mi><mo>,</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>)</mo>
</mrow>
</math>
B(n, p) ~~ N(np, np(1-p))
NormalDistribution[n p, Sqrt[n p (1 - p)]]
Normal(n*p, sqrt(n*p*(1-p)));
pd = makedist('Normal', 'mu', n*p, 'sigma', sqrt(n*p*(1-p)));
B(n, p) ≈ N(np, np(1-p))
ChatGPT 에게 물어서 계산하는 방법
당신은 수학(확률·통계) 계산 도우미입니다. 다음 계산은 반드시 Python 코드를 실제로 실행해서 하고, 실행 결과의 숫자만을 근거로 답해 주세요(암산이나 추측으로 답하지 마세요).

당첨 확률이 1/6인 제비를 10번 뽑을 때, 당첨 횟수의 이항분포에 대해 다음을 구해 주세요.
1. 정확히 2번 당첨될 확률 P(X=2)(기약분수와 소수로 모두)
2. 2번 이하일 확률 P(X≤2)와 2번 이상일 확률 P(X≥2)
3. 기댓값 E(X), 분산 V(X), 표준편차 σ
4. np ≥ 5 그리고 n(1−p) ≥ 5라는 정규분포에 의한 근사의 기준을 만족하는지 여부

Python에서는 표준 라이브러리의 fractions와 math.comb로 정확하게 계산하고, 사용한 공식과 실행 결과의 숫자를 보여 주세요.
사용법
-
1숫자 입력계산하고 싶은 숫자를 입력란에 입력합니다
-
2계산‘계산’ 버튼을 누릅니다
-
3결과 확인계산 결과가 바로 표시됩니다. 계산의 원리와 공식 해설도 같은 페이지에서 확인할 수 있습니다
DataChef의 특징

전문 지식 없이도 직관적이고 간단하게 사용

개인정보를 등록하지 않고도 이용할 수 있습니다

"다운로드"를 누르면 파일이 자동으로 삭제됩니다


출처 표기 불필요

상업적 이용 허가 연락도 필요 없습니다
관련 기능
반복 시행의 확률 계산기(n번 연속·적어도 한 번)
n번 연속으로 일어날 확률, 적어도 한 번은 일어날 확률, 한 번도 일어나지 않을 확률을 계산합니다
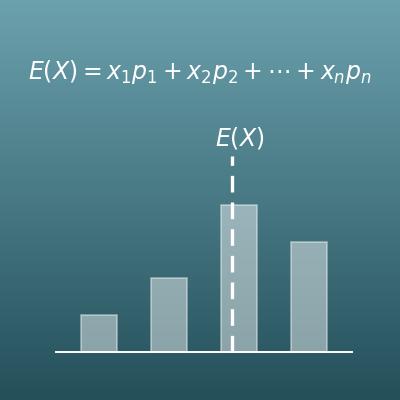
기댓값 계산기(확률변수의 평균·분산·표준편차)
확률분포표로 기댓값 E(X), 분산 V(X), 표준편차를 계산합니다. 이항분포에 한정되지 않는 일반적인 분포용입니다
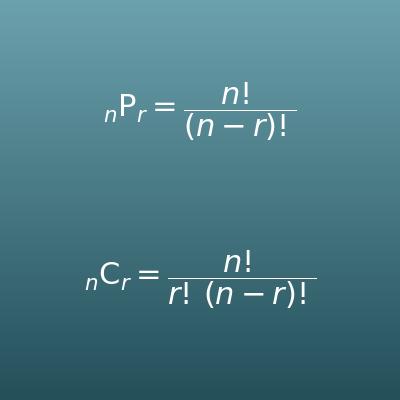
순열·조합 계산기(nPr, nCr)
이항분포 공식에 나오는 조합의 수 nCr(nCk)를 풀이 과정과 함께 따로 계산할 수 있습니다