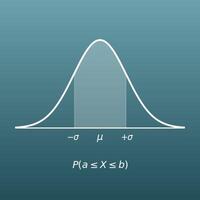
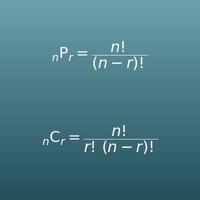Vul het aantal keren n, de kans op succes per keer p en het aantal successen k in. Je krijgt de kans op precies k successen, de cumulatieve kansen op hoogstens k en minstens k, het gemiddelde, de variantie en de standaardafwijking en een staafdiagram van de hele verdeling.
Inhoudsopgave
-
Wat je op deze pagina kunt doen
-
Waarvoor is deze berekening handig?
-
Zo werkt het
-
Formules en grafieken
-
Symbolen en begrippen
-
Handig om vooraf te weten
-
Berekenen met Excel
-
Berekenen met Google Spreadsheets
-
Berekenen met Python
-
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
-
Zo laat je ChatGPT de berekening doen
-
Kenmerken van DataChef
-
Gerelateerde functies
-
Alle rekenmachines van NumberChef
Wat je op deze pagina kunt doen
- Vul maar 3 getallen in om “de kans dat iets met kans \(p\) precies \(k\) keer gebeurt in \(n\) keer” te vinden, \(P(X = k) = {}_{n}\mathrm{C}_{k}\, p^{k} (1-p)^{n-k}\), meteen
- Het antwoord wordt getoond als breuk in de eenvoudigste vorm, zoals \(\dfrac{3}{8}\) (de exacte waarde), en als decimaal getal en percentage. Je ziet ook de stappen voor het aantal combinaties \({}_{n}\mathrm{C}_{k}\)
- Ook de cumulatieve kansen “hoogstens \(k\) keer” \(P(X \le k)\) en “minstens \(k\) keer” \(P(X \ge k)\) worden tegelijk berekend
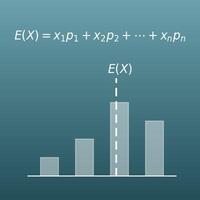
- Het toont de verwachtingswaarde \(E(X) = np\), de variantie \(\mathrm{Var}(X) = np(1-p)\) en de standaardafwijking \(\sigma\) en controleert de vuistregel voor het gebruik van de normale benadering
- De hele verdeling, van 0 tot \(n\) successen, wordt getekend als staafdiagram, dus je ziet in één oogopslag welke aantallen het waarschijnlijkst zijn
Waarvoor is deze berekening handig?
Open je 100 lootboxen met 1% kans op een zeldzaam voorwerp, dan volgt het aantal zeldzame voorwerpen de binomiale verdeling \(B(100;\ 0{,}01)\) (als je ervan uitgaat, zoals gepubliceerd, dat elke keer dezelfde kans geldt en onafhankelijk is). De kans dat je helemaal niets krijgt is \(0{,}99^{100} \approx 36{,}6\%\), dus de verdeling laat zien dat het onderbuikgevoel “100 keer proberen met 1% is bijna zeker raak” riskant is.
Bij het plannen van hoeveel je uitgeeft de “verwachtingswaarde \(np\) plus de spreiding” inschatten is precies de berekening op deze pagina.
In plaats van elk product te controleren, gebruiken fabrieken steekproefcontrole: “neem \(n\) producten uit een partij en accepteer de partij bij \(c\) of minder defecte producten”. De kans dat een partij met uitvalpercentage \(p\) wordt geaccepteerd is precies de cumulatieve binomiale kans \(P(X \le c)\). Neem je bijvoorbeeld 20 producten uit een partij met 1% uitval en accepteer je alleen bij 0 defecte, dan is de kans op acceptatie \(0{,}99^{20} \approx 81{,}8\%\).
Deze berekening wordt gebruikt om controleregels te ontwerpen die goede partijen met hoge kans accepteren en slechte afkeuren.
Gok je bij alle 20 vragen van een toets met 4 antwoordopties, dan volgt het aantal goede antwoorden de binomiale verdeling \(B(20;\ 0{,}25)\) en is de verwachtingswaarde \(20 \times 0{,}25 = 5\) vragen. De kans dat je er door geluk 8 of meer goed hebt is maar ongeveer 10%, wat met kansrekening bevestigt dat alleen gokken zelden een voldoende oplevert.
Toetsmakers houden ook rekening met deze verdeling als ze het aantal vragen en de cesuur (de grens voor een voldoende) vaststellen, zodat slagen door geluk moeilijk is.
Als een basketballer die 70% van zijn vrije worpen raakt 10 keer gooit, is de kans dat precies 7 raak zijn maar \({}_{10}\mathrm{C}_{7} \times 0{,}7^{7} \times 0{,}3^{3} \approx 26{,}7\%\) (als je elke worp als onafhankelijk ziet met een vaste kans). Precies 7 van de 10 raken is dus minder gewoon dan het klinkt. 6 of 8 raken gebeurt voortdurend.
De binomiale verdeling helpt je te beoordelen hoeveel van een “hot streak” of “slump” gewoon normale toevallige variatie is.
Bij peilingen en kijkcijferonderzoek wordt het aantal mensen onder de \(n\) ondervraagden dat een bepaald antwoord geeft gezien als gegeven door een binomiale verdeling. De “plus of min een paar procentpunten” van de foutenmarge wordt berekend uit de standaardafwijking \(\sqrt{np(1-p)}\) en de normale benadering.
Bepalen hoeveel mensen je moet ondervragen om de foutenmarge tot een gewenste grootte te brengen, berust rechtstreeks op de eigenschappen van de binomiale verdeling.
Formules en grafieken
Symbolen en begrippen
Symbolen
| \(X\) | hoofdletter X | De stochast voor het aantal successen. Volgens de gewoonte schrijf je getallen die door het toeval worden bepaald met hoofdletters uit het eind van het alfabet, zoals \(X,\ Y,\ Z\). |
| \(P(X = k)\) | P van X is k | De kans dat het aantal successen \(X\) precies \(k\) is. De \(P\) staat voor “probability” (kans). |
| \({}_{n}\mathrm{C}_{k}\) | n boven k | Het aantal combinaties van \(k\) dingen gekozen uit \(n\). De \(C\) staat voor “combination”. In Nederlandse leerboeken staat vaak \(\dbinom{n}{k}\) (lees: n boven k). |
| \(n\) | n | Het aantal keren dat je het kansexperiment herhaalt. De letter \(n\) wordt vaak voor een aantal gebruikt. |
| \(p\) | p | De kans op succes bij één uitvoering van het kansexperiment. De \(p\) komt van “probability” en de kleine letter gebruik je vaak voor de kans bij één keer. |
| \(1 - p\) | 1 min p | De kans op een mislukking bij één keer (niet slagen). Er gebeurt altijd of succes of mislukking, dus het is wat overblijft als je \(p\) van het totaal \(1\) aftrekt. Ook geschreven als \(q\). |
| \(k\) | k | Het aantal successen, een geheel getal van \(0\) tot \(n\). De letter \(k\) wordt vaak gebruikt om “hoe vaak” aan te geven. |
| \(P(X \le k)\) | P van X kleiner dan of gelijk aan k | De kans op hoogstens \(k\) successen (elk aantal van 0 tot \(k\)). Het is een cumulatieve kans, de exacte kansen opgeteld tot en met \(k\). |
| \(P(X \ge k)\) | P van X groter dan of gelijk aan k | De kans op minstens \(k\) successen (elk aantal van \(k\) tot \(n\)). Door \(P(X \le k-1)\) van het totaal \(1\) af te trekken (het complement) wordt de som korter. |
| \(E(X)\) | E van X | De verwachtingswaarde (het gemiddelde aantal successen). De \(E\) staat voor “expectation” (verwachting). Voor de binomiale verdeling is \(E(X) = np\). Ze heet ook het gemiddelde en wordt geschreven als \(\mu\). |
| \(\mathrm{Var}(X)\) | variantie van X | De variantie (hoe ver de uitkomsten uit elkaar liggen). De \(V\) komt van “variance”. Voor de binomiale verdeling is \(\mathrm{Var}(X) = np(1-p)\). Ze wordt ook geschreven als \(\sigma^2\). |
| \(\sigma\) | sigma | De standaardafwijking. Het is de Griekse kleine letter sigma, de Griekse “s” van “standaardafwijking”. Het is de wortel uit de variantie, \(\sigma = \sqrt{\mathrm{Var}(X)}\), en geeft de gebruikelijke afstand tot de verwachtingswaarde. |
| \(B(n,\ p)\) | B van n en p | De binomiale verdeling met \(n\) keer en kans op succes \(p\). De \(B\) staat voor “binomiaal”. “\(X\) is binomiaal verdeeld” schrijf je als \(X \sim B(n,\ p)\). |
| \(N(\mu,\ \sigma)\) | N van mu en sigma | De normale verdeling met gemiddelde \(\mu\) en standaardafwijking \(\sigma\), zoals je het in Nederlandse leerboeken vaak schrijft. De \(N\) staat voor “normaal”. In engelstalige boeken staat tussen de haakjes vaak \(\mu\) en de variantie \(\sigma^2\). Daarom staan op deze pagina steeds \(\mu\) en \(\sigma^2\) erbij. |
| \(\approx\) | ongeveer gelijk aan | Het symbool voor “ongeveer gelijk aan”. Op deze pagina laat het zien dat de binomiale verdeling bij benadering kan worden vervangen door de normale verdeling. |
Begrippen
| binomiale verdeling | De kansverdeling van “hoe vaak iets met kans \(p\) gebeurt in \(n\) keer”. De naam komt doordat de \({}_{n}\mathrm{C}_{k}\) in de formule gelijk is aan de binomiaalcoëfficiënt (de coëfficiënten in het binomium van Newton). In Nederland komt de binomiale verdeling vooral voor in de bovenbouw van havo en vwo (onder meer bij wiskunde A) en in het hoger onderwijs. |
| stochast | Een variabele waarvan de waarde door het toeval wordt bepaald. Op deze pagina is het aantal successen de stochast. Die neemt de waarden 0 tot en met n aan, elk met een eigen kans. |
| kansexperiment | Eén uitvoering van een experiment of waarneming waarvan de uitkomst van het toeval afhangt, zoals één keer een munt opgooien of één lot trekken. |
| herhaald kansexperiment | Hetzelfde kansexperiment telkens met dezelfde kans herhalen, waarbij de uitkomsten elkaar niet beïnvloeden (onafhankelijk). Je noemt ze ook bernoulli-experimenten. De binomiale verdeling is de verdeling van het aantal successen bij herhaalde kansexperimenten. |
| onafhankelijk | Als de uitkomst van het ene kansexperiment de uitkomst van een ander niet beïnvloedt. De eerste en tweede worp met een dobbelsteen zijn onafhankelijk, maar loten trekken zonder terugleggen is dat niet (de eerdere uitkomsten veranderen hoeveel winnende loten er nog over zijn). |
| combinatie | Een manier om \(k\) van \(n\) dingen te kiezen waarbij de volgorde er niet toe doet. Het totale aantal is \({}_{n}\mathrm{C}_{k}\) (in Nederland ook “n boven k” genoemd). In de binomiale verdeling telt het de manieren om te kiezen bij welke van de \(n\) keren het lukt. |
| cumulatieve kans | De exacte kansen opgeteld tot een bepaald aantal. De kans op hoogstens \(k\), \(P(X \le k)\), is het typische voorbeeld. |
| complement | De gebeurtenis dat iets niet gebeurt. De kansen zijn samen altijd 1, dus een kans als “minstens \(k\)” vind je makkelijk door de tegenovergestelde kant (hoogstens \(k-1\)) van 1 af te trekken. |
| verwachtingswaarde | Het gemiddelde als je het kansexperiment vaak herhaalt. Voor de binomiale verdeling is het het gemiddelde aantal successen, gegeven door de eenvoudige formule \(np\). |
| variantie | Een maat voor hoe ver de werkelijke waarden gewoonlijk van de verwachtingswaarde liggen (de spreiding). Ze wordt gedefinieerd als het gemiddelde van de gekwadrateerde verschillen. |
| standaardafwijking | De wortel uit de variantie. De variantie heeft gekwadrateerde eenheden, dus door de wortel te nemen krijg je weer de oorspronkelijke eenheid (hier het aantal successen) als maat voor de spreiding. |
| normale verdeling | Een symmetrische, klokvormige verdeling waarbij waarden dicht bij het gemiddelde het waarschijnlijkst zijn en waarden verder weg minder waarschijnlijk. Veel grootheden uit de praktijk, zoals lichaamslengte en meetfouten, komen dicht bij deze vorm en ook de binomiale verdeling komt er dichtbij als \(n\) groot is. |
| normale benadering | De binomiale verdeling vervangen door de normale verdeling met \(\mu = np\) en \(\sigma^2 = np(1-p)\) als \(n\) groot is. De gangbare vuistregel is \(np \ge 5\) en \(n(1-p) \ge 5\). |
Handig om vooraf te weten
Dit helpt je om de berekening op deze pagina met echt begrip te gebruiken en niet alleen op de knop te drukken.
Kom je er niet uit, dan kom je het snelst verder door de onderwerpen in deze tabel nog eens door te nemen.
| Basisbegrippen kans (klas 1-2, 12-14 jaar) |
|
| Rekenen met breuken (groep 6-8, 9-12 jaar) |
|
| Machten (klas 1-3, 12-15 jaar) |
|
| Tellen en combinaties (bovenbouw havo/vwo, vanaf 15 jaar) |
|
| Kans bij herhaalde kansexperimenten en het complement (bovenbouw havo/vwo, vanaf 15 jaar) |
|
| Stochasten, verwachtingswaarde en variantie (bovenbouw havo/vwo en hoger onderwijs, vanaf 16 jaar) |
|
| De normale verdeling (bovenbouw havo/vwo en hoger onderwijs, vanaf 16 jaar) |
|
Berekenen met Excel
| Aantal keren n | 4 |
| Kans op succes p | 0,5 |
| Aantal successen k | 2 |
| Kans op precies k keer succes P(X=k) | =BINOM.VERD(B3;B1;B2;ONWAAR) |
| Aantal keren n | 4 |
| Kans op succes p | 0,5 |
| Aantal successen k | 2 |
| Kans op hoogstens k keer succes P(X≤k) | =BINOM.VERD(B3;B1;B2;WAAR) |
| Kans op minstens k keer succes P(X≥k) | =1-BINOM.VERD(B3-1;B1;B2;WAAR) |
| Aantal keren n | 30 |
| Kans op succes p | =1/6 |
| Verwachtingswaarde E(X) = np | =B1*B2 |
| Variantie Var(X) = np(1-p) | =B1*B2*(1-B2) |
| Standaardafwijking σ | =WORTEL(B4) |
| Aantal keren n | 20 |
| Kans op succes p | 0,5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| Vuistregel voldaan? | =EN(B3>=5;B4>=5) |
BINOM.VERD is de functie voor de binomiale verdeling. De argumenten zijn, in volgorde, “aantal successen; aantal keren; kans op succes; cumulatief of niet”. ONWAAR aan het eind geeft de exacte kans en WAAR geeft de cumulatieve kans van dat aantal of minder.
De eerste tabel is het voorbeeld van precies 2 keer kop bij 4 keer een munt opgooien en het antwoord is 0,375 (= 3/8).
Beide antwoorden in de tweede tabel zijn 0,6875. “Minstens k” vind je door “hoogstens k−1” van 1 af te trekken (deze formule geeft een foutmelding als k gelijk is aan 0, maar de kans op 0 of meer is altijd 1).
De derde tabel is het aantal keren dat je 1 gooit bij 30 worpen met een dobbelsteen, met verwachtingswaarde 5, variantie 4,1667 en standaardafwijking 2,0412.
De vierde tabel toont WAAR als zowel np als n(1−p) 5 of meer zijn (de vuistregel voor de normale benadering is dan voldaan) en anders ONWAAR.
Berekenen met Google Spreadsheets
| Aantal keren n | 4 |
| Kans op succes p | 0,5 |
| Aantal successen k | 2 |
| Kans op precies k keer succes P(X=k) | =BINOMIALE.VERD(B3;B1;B2;ONWAAR) |
| Aantal keren n | 4 |
| Kans op succes p | 0,5 |
| Aantal successen k | 2 |
| Kans op hoogstens k keer succes P(X≤k) | =BINOMIALE.VERD(B3;B1;B2;WAAR) |
| Kans op minstens k keer succes P(X≥k) | =1-BINOMIALE.VERD(B3-1;B1;B2;WAAR) |
| Aantal keren n | 30 |
| Kans op succes p | =1/6 |
| Verwachtingswaarde E(X) = np | =B1*B2 |
| Variantie Var(X) = np(1-p) | =B1*B2*(1-B2) |
| Standaardafwijking σ | =WORTEL(B4) |
| Aantal keren n | 20 |
| Kans op succes p | 0,5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| Vuistregel voldaan? | =EN(B3>=5;B4>=5) |
Net als in Excel geeft de formule voor “minstens k” een foutmelding als k gelijk is aan 0 (de kans op 0 of meer is altijd 1).
Berekenen met Python
from fractions import Fraction
from math import comb, sqrt

trial_count = 4                  # aantal keren n
success_prob = Fraction(1, 2)    # kans op succes p (een decimaal getal zoals 0.3 werkt ook)
success_count = 2                # aantal successen k

failure_prob = 1 - success_prob

# kans op precies k successen P(X=k) = nCk × p^k × (1−p)^(n−k)
exact_prob = (comb(trial_count, success_count)
              * success_prob ** success_count
              * failure_prob ** (trial_count - success_count))
print(f"Kans op precies {success_count}: {exact_prob} = {float(exact_prob)}")

# cumulatieve kansen (hoogstens k, minstens k)
prob_le = sum(comb(trial_count, i) * success_prob ** i * failure_prob ** (trial_count - i)
              for i in range(success_count + 1))
prob_ge = 1 - prob_le + exact_prob
print(f"Kans op hoogstens {success_count}: {prob_le} = {float(prob_le)}")
print(f"Kans op minstens {success_count}: {prob_ge} = {float(prob_ge)}")

# gemiddelde, variantie en standaardafwijking
mean = trial_count * success_prob
variance = mean * failure_prob
print(f"Gemiddelde: {mean}  Variantie: {variance}  Standaardafwijking: {sqrt(variance)}")
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
P(X = k) = nCk pᵏ (1 − p)ⁿ⁻ᵏ
P(X = k) = \binom{n}{k} p^{k} (1 - p)^{n - k}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>=</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>k</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>k</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>k</mi></mrow>
</msup>
</mrow>
</math>
P(X = k) = C(n,k) p^k (1-p)^(n-k)
PDF[BinomialDistribution[n, p], k]
binomial(n, k)*p^k*(1-p)^(n-k);
binopdf(k, n, p)
P(X=k) = C(n,k) p^k (1-p)^(n-k)
P(X ≤ k) = Σ[i=0→k] nCi pⁱ (1 − p)ⁿ⁻ⁱ
P(X \le k) = \sum_{i=0}^{k} \binom{n}{i} p^{i} (1 - p)^{n - i}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>≤</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>0</mn></mrow>
<mi>k</mi>
</munderover>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>i</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>i</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>i</mi></mrow>
</msup>
</mrow>
</math>
P(X <= k) = sum_(i=0)^k C(n,i) p^i (1-p)^(n-i)
CDF[BinomialDistribution[n, p], k]
add(binomial(n, i)*p^i*(1-p)^(n-i), i = 0..k);
binocdf(k, n, p)
P(X≤k) = Σ_(i=0)^k C(n,i) p^i (1-p)^(n-i)
E(X) = np, Var(X) = np(1 − p), σ = √(np(1 − p))
E(X) = np, \quad \mathrm{Var}(X) = np(1 - p), \quad \sigma = \sqrt{np(1 - p)}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo><mi>n</mi><mi>p</mi>
<mo>,</mo>
<mi>Var</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>,</mo>
<mi>σ</mi><mo>=</mo>
<msqrt><mi>n</mi><mi>p</mi><mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow></msqrt>
</mrow>
</math>
E(X) = np, Var(X) = np(1-p), sigma = sqrt(np(1-p))
{Mean[BinomialDistribution[n, p]], Variance[BinomialDistribution[n, p]], StandardDeviation[BinomialDistribution[n, p]]}
n*p; n*p*(1-p); sqrt(n*p*(1-p));
[m, v] = binostat(n, p); s = sqrt(v);
E(X) = np, Var(X) = np(1-p), σ = √(np(1-p))
B(n, p) ≈ N(μ = np, σ² = np(1 − p))
B(n,\ p) \approx N(\mu = np,\ \sigma^{2} = np(1 - p))
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>B</mi><mo>(</mo><mi>n</mi><mo>,</mo><mi>p</mi><mo>)</mo>
<mo>≈</mo>
<mi>N</mi><mo>(</mo><mi>μ</mi><mo>=</mo><mi>n</mi><mi>p</mi><mo>,</mo>
<msup><mi>σ</mi><mn>2</mn></msup><mo>=</mo><mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>)</mo>
</mrow>
</math>
B(n, p) ~~ N(mu = np, sigma^2 = np(1-p))
NormalDistribution[n p, Sqrt[n p (1 - p)]]
Normal(n*p, sqrt(n*p*(1-p)));
pd = makedist('Normal', 'mu', n*p, 'sigma', sqrt(n*p*(1-p)));
B(n, p) ≈ N(μ = np, σ² = np(1-p))
Zo laat je ChatGPT de berekening doen
Je bent een rekenassistent voor wiskunde (kansrekening en statistiek). Voer de volgende berekening uit door daadwerkelijk Python-code te draaien en baseer je antwoord alleen op de getallen uit het resultaat van de uitvoering (antwoord niet uit je hoofd of op basis van een gok).

Je doet 10 keer mee aan een prijstrekking en elke keer is de kans op winst 1/6. Bereken voor de binomiale verdeling van het aantal keren winst:
1. De kans op precies 2 keer winst, P(X=2) (als breuk in de eenvoudigste vorm en als decimaal getal)
2. De kans op hoogstens 2 keer winst, P(X≤2), en op minstens 2 keer winst, P(X≥2)
3. Het gemiddelde E(X), de variantie Var(X) en de standaardafwijking σ
4. Of de vuistregel voor de normale benadering, np ≥ 5 en n(1−p) ≥ 5, is voldaan

Reken in Python exact met fractions en math.comb uit de standaardbibliotheek en toon de formules die je hebt gebruikt en de getallen uit het resultaat van de uitvoering.
Zo werkt het
-
1Vul je getallen inTyp de getallen waarmee je wilt rekenen in de invoervelden
-
2BerekenKlik op de knop “Berekenen”
-
3Bekijk het resultaatHet resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
Kenmerken van DataChef

Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Zonder persoonlijke gegevens op te geven

Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt


Geen bronvermelding vereist

Geen toestemming vooraf nodig
Gerelateerde functies
Kans bij herhaling (n keer achter elkaar, minstens één keer)
Vind de kans dat iets n keer achter elkaar gebeurt, minstens één keer of nooit
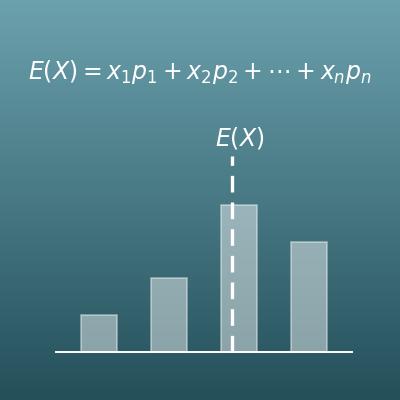
Verwachtingswaarde berekenen (gemiddelde, variantie, standaardafwijking)
Vind de verwachtingswaarde E(X), de variantie Var(X) en de standaardafwijking uit een tabel met de kansverdeling. Werkt voor elke verdeling, niet alleen de binomiale
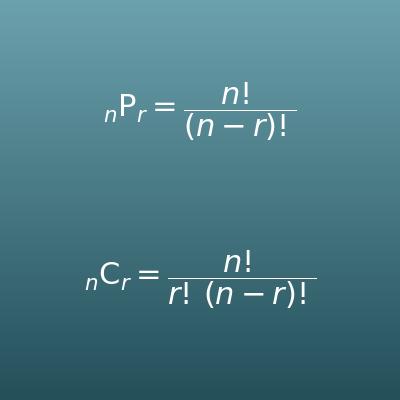
Permutaties en combinaties berekenen (nPr, nCr)
Bereken het aantal combinaties nCr (nCk) uit de formule van de binomiale verdeling apart, met de stappen erbij