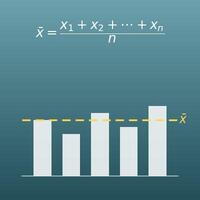Vul de getallen in waarvan je de spreiding wilt weten, gescheiden door puntkomma’s (;). De standaardafwijking van de populatie σ en van de steekproef s worden samen met het gemiddelde, de varianties en de kwadratensom berekend.
Inhoudsopgave
-
Wat je op deze pagina kunt doen
-
Waarvoor is deze berekening handig?
-
Zo werkt het
-
Formules en figuren
-
Symbolen en begrippen
-
Handig om vooraf te weten
-
Berekenen met Excel
-
Berekenen met Google Spreadsheets
-
Berekenen met Python
-
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
-
Zo laat je ChatGPT de berekening doen
-
Kenmerken van DataChef
-
Gerelateerde functies
-
Alle rekenmachines van NumberChef
Wat je op deze pagina kunt doen
- Vul getallen in, gescheiden door puntkomma’s (;), en je ziet meteen de standaardafwijking
- Je ziet de standaardafwijking van de populatie \(\sigma\) (delen door \(N\)) en van de steekproef \(s\) (delen door \(N-1\)) allebei meteen naast elkaar
- Ook het gemiddelde \(\mu\), de kwadratensom \(\sum (x_i-\mu)^2\) en de varianties \(\sigma^2,\ s^2\) worden berekend, zodat je elke stap van de berekening in één oogopslag kunt volgen
- Een heldere uitleg van de formules en formules om te kopiëren voor Excel, Google Spreadsheets en Python vind je ook op deze pagina
Waarvoor is deze berekening handig?
Een z-score (standaardscore) laat zien hoeveel standaardafwijkingen een score van het gemiddelde af ligt: \(z = \dfrac{x - \text{gemiddelde}}{\text{standaardafwijking}}\). De standaardafwijking staat dus in de noemer.
Is het klassengemiddelde 70 en de standaardafwijking 10, dan heeft een score van 85 een z-score van \(z = (85 - 70) \div 10 = 1{,}5\): dat is 1,5 standaardafwijkingen boven het gemiddelde. Leraren die een toets normeren en rapporten van gestandaardiseerde toetsen gebruiken hetzelfde idee. Het verklaart ook waarom dezelfde score meer opvalt bij een toets waarop de scores dicht bij elkaar liggen (kleine spreiding).
Hoe nauwkeurig ze ook worden gemaakt, de lengte van schroeven en het gewicht van onderdelen verschillen altijd een beetje. Fabrieken meten die variatie met de standaardafwijking en sturen het proces zo bij dat “het gemiddelde ± 3 standaardafwijkingen” binnen de specificaties van de klant blijft.
Een kleinere standaardafwijking betekent gelijkmatigere, betere producten. De standaardafwijking is zo fundamenteel dat kwaliteitsverbetering bijna neerkomt op het kleiner maken ervan.
Twee beleggingen kunnen allebei een gemiddeld rendement van 5% hebben, maar bij de belegging waarvan het rendement een grotere standaardafwijking heeft, zitten jaren met grote winsten en jaren met grote verliezen. Die wordt daarom als riskanter gezien.
In de financiële wereld heet de standaardafwijking van het rendement volatiliteit en dat is de meest gebruikte maat voor risico. Kijk bij belangrijke geldbeslissingen dus niet alleen naar het gemiddelde, maar ook naar de spreiding (de standaardafwijking).
Twee steden kunnen dezelfde gemiddelde jaartemperatuur hebben. Is de standaardafwijking van de maandtemperaturen klein, dan is het in die stad het hele jaar mild. Is die groot, dan verschillen zomer en winter sterk.
De standaardafwijking maakt van “stabiel of wisselvallig” een getal, iets wat het gemiddelde alleen niet kan laten zien. Ze wordt gebruikt om klimaten te vergelijken en om teelt en toerisme te plannen.
De referentiewaarden bij een bloeduitslag worden soms bepaald door gegevens van veel gezonde mensen te verzamelen en ongeveer “het gemiddelde ± 2 standaardafwijkingen” te nemen (in de praktijk gebruikt elke test een methode die past bij de vorm van de verdeling).
Weten wat een standaardafwijking is helpt je rustig te blijven: een uitslag net buiten de referentiewaarden betekent niet automatisch dat je ziek bent, want ook sommige gezonde mensen vallen erbuiten. Bespreek een afwijkende uitslag altijd met je huisarts.
Formules en figuren
Symbolen en begrippen
Symbolen
| \(x_1, x_2, \ldots, x_N\) | x met index 1, x met index 2, …, x met index N | De afzonderlijke waarden waarvan je de spreiding wilt meten. (Voorbeeld: de toetspunten van 8 leerlingen) |
| \(N\) | N | Het aantal waarden. (Voorbeeld: bij 8 leerlingen is \(N = 8\)) |
| \(\mu\) | mu | Het gemiddelde. Deze Griekse letter staat voor het gemiddelde van een populatie. Het gemiddelde van een steekproef schrijf je als \(\bar{x}\) (x-streep), maar het wordt op dezelfde manier berekend. |
| \(x_i - \mu\) | x index i min mu | De afwijking. Die laat zien hoe ver elke waarde van het gemiddelde ligt. |
| \(S\) | S | De kwadratensom, \(\sum (x_i-\mu)^2\): je kwadrateert elke afwijking en telt alles op. De variantie en de standaardafwijking worden hieruit berekend. |
| \(\sigma^2\) | sigma kwadraat | De variantie van de populatie: de kwadratensom gedeeld door het aantal \(N\). |
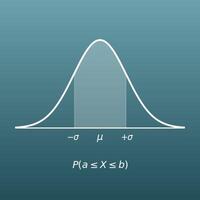
| \(\sigma\) | sigma | De standaardafwijking van de populatie: de wortel uit de variantie van de populatie. Het is het bekendste symbool voor spreiding. |
| \(s^2\) | s kwadraat | De variantie van de steekproef (een zuivere schatter van de variantie van de populatie): de kwadratensom gedeeld door \(N-1\). |
| \(s\) | s | De standaardafwijking van de steekproef: de wortel uit de variantie van de steekproef. |
| \(\sum\) | sigma (sommatieteken) | Een symbool dat “alles optellen” betekent. \(\sum_{i=1}^{N} x_i\) is de som van \(x_1\) tot en met \(x_N\). |
Begrippen
| standaardafwijking | Een getal dat laat zien hoe ver de gegevens rond het gemiddelde verspreid liggen. Het is de wortel uit de variantie en heeft dezelfde eenheid als de gegevens, daarom is het een handige maat voor “de gebruikelijke afstand tot het gemiddelde”. Het is de meest gebruikte maat voor spreiding. |
| variantie | Het gemiddelde van de gekwadrateerde afwijkingen (de verschillen tussen elke waarde en het gemiddelde). Het laat zien hoe groot de spreiding is, maar de eenheid is gekwadrateerd, dus meestal neem je de wortel om de standaardafwijking te krijgen. |
| afwijking | Het verschil tussen een waarde en het gemiddelde (\(x_i - \mu\)). Positief betekent boven het gemiddelde en negatief eronder. Alle afwijkingen bij elkaar opgeteld geven altijd 0, daarom kwadrateer je ze eerst. |
| kwadratensom | De gekwadrateerde afwijkingen, allemaal bij elkaar opgeteld. De variantie en de standaardafwijking worden allebei uit deze waarde berekend. |
| populatie | De hele groep die je wilt onderzoeken. Zijn je gegevens deze hele groep, gebruik dan de standaardafwijking van de populatie \(\sigma\). |
| steekproef | Een deel van de gegevens uit een populatie (de hele groep). Wil je de spreiding van de hele groep schatten met een steekproef, gebruik dan de standaardafwijking van de steekproef \(s\). |
| zuivere schatter | De variantie waarmee je de variantie van een populatie schat met een steekproef. Deel de kwadratensom door \(N-1\). Delen door \(N\) geeft een te kleine spreiding van de populatie, dus delen door één minder corrigeert dat. |
| correctie van Bessel | De correctie waarbij je bij de variantie van een steekproef deelt door \(N-1\) in plaats van \(N\). \(N-1\) heet ook het aantal vrijheidsgraden. |
Handig om vooraf te weten
Dit helpt je om de berekening op deze pagina écht te begrijpen en niet alleen op de knop te drukken.
| Het gemiddelde (groep 7, 10-11 jaar) |
|
| Negatieve getallen en haakjes (klas 1, 12-13 jaar) |
|
| Machten (klas 1–2, 12-14 jaar) |
|
| Wortels (klas 2–3, 13-15 jaar) |
|
| Verdeling en spreiding van gegevens (klas 1 tot en met havo/vwo 4–5, 12-17 jaar) |
|
Berekenen met Excel
| Waarde 1 | 10 |
| Waarde 2 | 12 |
| Waarde 3 | 23 |
| Waarde 4 | 23 |
| Waarde 5 | 16 |
| Waarde 6 | 23 |
| Waarde 7 | 21 |
| Waarde 8 | 16 |
| Aantal N | =AANTAL(B1:B8) |
| Som Σx | =SOM(B1:B8) |
| Gemiddelde μ | =GEMIDDELDE(B1:B8) |
| Waarde 1 | 10 |
| Waarde 2 | 12 |
| Waarde 3 | 23 |
| Waarde 4 | 23 |
| Waarde 5 | 16 |
| Waarde 6 | 23 |
| Waarde 7 | 21 |
| Waarde 8 | 16 |
| Kwadratensom S | =DEV.KWAD(B1:B8) |
| Waarde 1 | 10 |
| Waarde 2 | 12 |
| Waarde 3 | 23 |
| Waarde 4 | 23 |
| Waarde 5 | 16 |
| Waarde 6 | 23 |
| Waarde 7 | 21 |
| Waarde 8 | 16 |
| Variantie van de populatie σ² | =VARP(B1:B8) |
| Standaardafwijking van de populatie σ | =STDEVP(B1:B8) |
| Waarde 1 | 10 |
| Waarde 2 | 12 |
| Waarde 3 | 23 |
| Waarde 4 | 23 |
| Waarde 5 | 16 |
| Waarde 6 | 23 |
| Waarde 7 | 21 |
| Waarde 8 | 16 |
| Variantie van de steekproef s² | =VAR(B1:B8) |
| Standaardafwijking van de steekproef s | =STDEV(B1:B8) |
In de eerste tabel zie je 18 voor het gemiddelde μ. De standaardafwijking van de populatie σ in de derde tabel is ongeveer 4,899 en de standaardafwijking van de steekproef s in de vierde tabel ongeveer 5,237.
Wil je een ander aantal waarden gebruiken, voeg dan rijen met getallen toe (of haal ze weg) en pas “B1:B8” in de formules aan naar je echte gegevensbereik (bij 10 waarden: B1:B10).
STDEVP en VARP, met een “P”, zijn voor een populatie (delen door N). STDEV en VAR, zonder “P”, zijn voor een steekproef (delen door N − 1). DEV.KWAD geeft de kwadratensom in één stap.
Berekenen met Google Spreadsheets
| Waarde 1 | 10 |
| Waarde 2 | 12 |
| Waarde 3 | 23 |
| Waarde 4 | 23 |
| Waarde 5 | 16 |
| Waarde 6 | 23 |
| Waarde 7 | 21 |
| Waarde 8 | 16 |
| Aantal N | =AANTAL(B1:B8) |
| Som Σx | =SOM(B1:B8) |
| Gemiddelde μ | =GEMIDDELDE(B1:B8) |
| Waarde 1 | 10 |
| Waarde 2 | 12 |
| Waarde 3 | 23 |
| Waarde 4 | 23 |
| Waarde 5 | 16 |
| Waarde 6 | 23 |
| Waarde 7 | 21 |
| Waarde 8 | 16 |
| Kwadratensom S | =DEV.KWAD(B1:B8) |
| Waarde 1 | 10 |
| Waarde 2 | 12 |
| Waarde 3 | 23 |
| Waarde 4 | 23 |
| Waarde 5 | 16 |
| Waarde 6 | 23 |
| Waarde 7 | 21 |
| Waarde 8 | 16 |
| Variantie van de populatie σ² | =VARP(B1:B8) |
| Standaardafwijking van de populatie σ | =STDEVP(B1:B8) |
| Waarde 1 | 10 |
| Waarde 2 | 12 |
| Waarde 3 | 23 |
| Waarde 4 | 23 |
| Waarde 5 | 16 |
| Waarde 6 | 23 |
| Waarde 7 | 21 |
| Waarde 8 | 16 |
| Variantie van de steekproef s² | =VAR(B1:B8) |
| Standaardafwijking van de steekproef s | =STDEV(B1:B8) |
Ook in Google Spreadsheets gebruik je STDEVP en VARP voor een populatie en STDEV en VAR voor een steekproef.
Berekenen met Python
import statistics

numbers = [10, 12, 23, 23, 16, 23, 21, 16]  # de getallen waarvan je de spreiding wilt meten

mean = statistics.mean(numbers)               # gemiddelde μ
pstdev = statistics.pstdev(numbers)           # standaardafwijking van de populatie σ (delen door N)
pvariance = statistics.pvariance(numbers)     # variantie van de populatie σ²
sstdev = statistics.stdev(numbers)            # standaardafwijking van de steekproef s (delen door N-1)
svariance = statistics.variance(numbers)      # variantie van de steekproef s²

print(f"Aantal: {len(numbers)} / Som: {sum(numbers)} / Gemiddelde: {mean}")
print(f"Variantie populatie σ²: {pvariance} / Standaardafwijking populatie σ: {pstdev}")
print(f"Variantie steekproef s²: {svariance} / Standaardafwijking steekproef s: {sstdev}")
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
μ = Σxᵢ ÷ N
\mu = \frac{x_1 + x_2 + \cdots + x_N}{N}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>μ</mi>
<mo>=</mo>
<mfrac>
<mrow>
<msub><mi>x</mi><mn>1</mn></msub>
<mo>+</mo>
<msub><mi>x</mi><mn>2</mn></msub>
<mo>+</mo>
<mo>⋯</mo>
<mo>+</mo>
<msub><mi>x</mi><mi>N</mi></msub>
</mrow>
<mi>N</mi>
</mfrac>
</mrow>
</math>
mu = (x_1 + x_2 + cdots + x_N) / N
Mean[data]
mu := add(x[i], i = 1 .. N)/N;
mu = mean(x);
μ = (x_1 + x_2 + ⋯ + x_N)/N
S = Σ(xᵢ − μ)²
S = \sum_{i=1}^{N} (x_i - \mu)^2
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>S</mi>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>1</mn></mrow>
<mi>N</mi>
</munderover>
<msup>
<mrow><mo>(</mo><msub><mi>x</mi><mi>i</mi></msub><mo>−</mo><mi>μ</mi><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mrow>
</math>
S = sum_(i=1)^N (x_i - mu)^2
Total[(data - Mean[data])^2]
S := add((x[i] - mu)^2, i = 1 .. N);
S = sum((x - mean(x)).^2);
S = ∑_(i=1)^N (x_i − μ)^2
σ² = S ÷ N, s² = S ÷ (N − 1)
\sigma^2 = \frac{S}{N}, \qquad s^2 = \frac{S}{N-1}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msup><mi>σ</mi><mn>2</mn></msup>
<mo>=</mo>
<mfrac><mi>S</mi><mi>N</mi></mfrac>
<mo>,</mo>
<mspace width="1em"/>
<msup><mi>s</mi><mn>2</mn></msup>
<mo>=</mo>
<mfrac><mi>S</mi><mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow></mfrac>
</mrow>
</math>
sigma^2 = S/N, s^2 = S/(N-1)
popVar = S/n; sampleVar = Variance[data] (* N is een ingebouwde functie in Mathematica, dus het aantal heet n *)
sigma2 := S/N; s2 := S/(N - 1);
popVar = S/N; sampleVar = var(x);
σ^2 = S/N, s^2 = S/(N−1)
σ = √(σ²), s = √(s²)
\sigma = \sqrt{\sigma^2} = \sqrt{\dfrac{S}{N}}, \qquad s = \sqrt{s^2} = \sqrt{\dfrac{S}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>σ</mi>
<mo>=</mo>
<msqrt><mfrac><mi>S</mi><mi>N</mi></mfrac></msqrt>
<mo>,</mo>
<mspace width="1em"/>
<mi>s</mi>
<mo>=</mo>
<msqrt><mfrac><mi>S</mi><mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow></mfrac></msqrt>
</mrow>
</math>
sigma = sqrt(S/N), s = sqrt(S/(N-1))
popSD = Sqrt[S/n]; sampleSD = StandardDeviation[data] (* N is een ingebouwde functie in Mathematica, dus het aantal heet n *)
sigma := sqrt(S/N); s := sqrt(S/(N - 1));
popSD = sqrt(S/numel(x)); sampleSD = std(x);
σ = √(S/N), s = √(S/(N−1))
Zo laat je ChatGPT de berekening doen
Je bent een assistent voor statistische berekeningen. Voer de volgende berekening uit door daadwerkelijk Python-code uit te voeren en baseer je antwoord alleen op de getallen uit het resultaat van de uitvoering (geef geen antwoord uit het hoofd of op basis van een gok).

Zoek voor de volgende gegevens elk van de onderstaande waarden.
Gegevens: 10; 12; 23; 23; 16; 23; 21; 16
1. Het aantal, de som en het gemiddelde
2. De kwadratensom (het verschil van elke waarde met het gemiddelde, gekwadrateerd en alles bij elkaar opgeteld)
3. De variantie van de populatie σ² (delen door N) en de standaardafwijking van de populatie σ
4. De variantie van de steekproef s² (delen door N − 1) en de standaardafwijking van de steekproef s

Laat de formules zien die je hebt gebruikt en de getallen uit het resultaat van de uitvoering.
Zo werkt het
-
1Vul je getallen inTyp de getallen waarmee je wilt rekenen in de invoervelden
-
2BerekenKlik op de knop “Berekenen”
-
3Bekijk het resultaatHet resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
Kenmerken van DataChef

Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Zonder persoonlijke gegevens op te geven

Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt


Geen bronvermelding vereist

Geen toestemming vooraf nodig
Gerelateerde functies
Gemiddelde berekenen (rekenkundig gemiddelde)
Berekent het gemiddelde, de mediaan, het meetkundig gemiddelde en meer uit een rij getallen
Normale verdeling berekenen (kans tussen twee waarden en z-tabel)
Bereken de kans op een waarde binnen een bepaald interval, met het gemiddelde en de standaardafwijking

Procentueel verschil berekenen (percentageverschil)
Drukt het verschil tussen twee waarden uit als percentage van hun gemiddelde