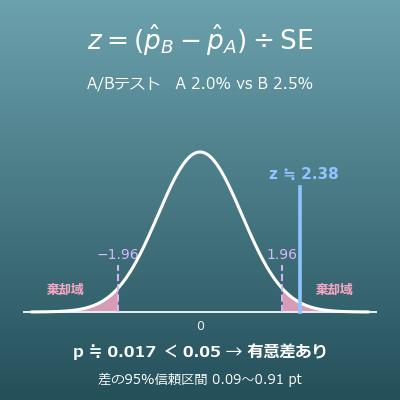
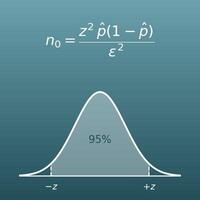
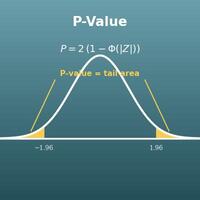
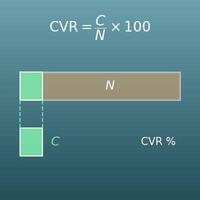
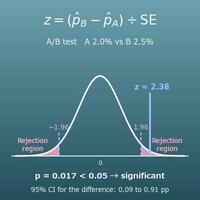
Om de steekproefgrootte te vinden, vul je de basis-CVR, de MDE, het significantieniveau en de power in en klik je op “Berekenen”. Je krijgt de steekproefgrootte per groep voor A en B (naar boven afgerond) en het totaal, plus de benodigde dagen als je je bezoekers per dag invult. Zet “Bereken” op power om de steekproefgrootte per groep vast te leggen en in plaats daarvan de power 1 − β te vinden.
Inhoudsopgave
-
Wat je op deze pagina kunt doen
-
Waarvoor is deze berekening handig?
-
Zo werkt het
-
Formules en figuren
-
Symbolen en begrippen
-
Handig om vooraf te weten
-
Berekenen met Excel
-
Berekenen met Google Spreadsheets
-
Berekenen met Python
-
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
-
Zo laat je ChatGPT de berekening doen
-
Kenmerken van DataChef
-
Gerelateerde functies
-
Alle rekenmachines van NumberChef
Wat je op deze pagina kunt doen
- Vul de basis-CVR in (het conversiepercentage van je huidige versie A), het minimaal detecteerbaar effect (MDE, als relatief % of in procentpunten), het significantieniveau \(\alpha\) (tweezijdig of eenzijdig) en de power \(1-\beta\). Je krijgt de steekproefgrootte die elke groep van je A/B-test nodig heeft (naar boven afgerond) en het totaal
- “Mijn pagina converteert met 3%. Hoeveel bezoekers hebben A en B elk nodig om een stijging van 10% (3% naar 3,3%) te detecteren?” Deze pagina beantwoordt de belangrijkste vraag die je stelt voordat een test begint
- Vul je bezoekers per dag in (optioneel) en je ziet ook hoeveel dagen het duurt om die steekproefgrootte te halen (naar boven afgerond)
- Kun je maar een vast aantal bezoekers per groep krijgen, leg dan de steekproefgrootte vast en los de power \(1-\beta\) op (de kans een verschil te vinden als er werkelijk een is)
- Een grafiek van hoe de steekproefgrootte met de MDE verandert, een heldere uitleg van de formules en formules om te kopiëren voor Excel, Google Spreadsheets en Python staan ook op deze pagina
Waarvoor is deze berekening handig?
Stel dat de productpagina van een webshop met 2% converteert en je een relatieve stijging van 10% (2% naar 2,2%) door nieuwe knoptekst wilt kunnen detecteren. Bij een significantieniveau van 5% (tweezijdig) en 80% power heb je ongeveer 80.682 bezoekers per groep nodig, ongeveer 161.364 in totaal.
Een paar tientallen of honderden bezoekers vergelijken (“B deed het vorige week beter”) kan een toevallig verschil niet van een echt verschil onderscheiden. Het vooraf uitrekenen van de steekproefgrootte voorkomt dat je weken besteedt aan een test die geen antwoord kan geven.
Een landingspagina krijgt demo-aanvragen met een CVR van 5%. Om een stijging van 1 punt (5% naar 6%) te kunnen detecteren heb je 8.158 bezoekers per groep nodig, 16.316 in totaal. Bij 300 bezoeken per dag is dat \(16.316 \div 300 \approx 54{,}4\), dus 55 dagen, of 8 weken als je de dagen van de week wilt uitmiddelen.
Vraagt iemand om resultaten binnen 2 weken, dan kun je met dit getal uitleggen: “In 2 weken (4.200 bezoekers, 2.100 per groep) hebben we een veel grotere MDE nodig, rond de 3 punten (5% naar 8%, wat 1.059 per groep vraagt).”
Heeft je nieuwsbrief een openpercentage van 20% en wil je een stijging van 2 punten (20% naar 22%) door een nieuwe onderwerpregel kunnen detecteren, dan moet je naar 6.510 mensen per groep versturen, 13.020 in totaal (significantieniveau 5%, power 80%).
Een maatstaf met een hoog percentage, zoals een openpercentage, heeft minder mensen nodig om een verschil te laten zien dan een CVR van een paar procent. Dat komt doordat het \(p(1-p)\)-deel van de formule anders is: dezelfde “2 punten” vraagt voor elke maatstaf een andere steekproefgrootte.
Stel dat een test gericht op een relatieve stijging van 10% op een pagina met een CVR van 3% draaide met 5.000 bezoekers per groep en “geen significant verschil” liet zien. Terugrekenen van de power geeft maar ongeveer 13,5%. De test was zo opgezet dat een echte verbetering in meer dan 8 van de 10 gevallen werd gemist.
De juiste conclusie is hier niet “het had geen effect” maar “met deze steekproefgrootte konden we het niet zien”. Terugrekenen van de power voorkomt dat je een test verkeerd leest en een goed idee weggooit.
Een app heeft een retentie van 40% op de volgende dag. Om een relatieve stijging van 10% (40% naar 44%) door een nieuwe tutorial te kunnen detecteren zijn ongeveer 2.389 nieuwe gebruikers per groep, ongeveer 4.778 in totaal, genoeg (significantieniveau 5%, power 80%).
Een maatstaf dichtbij 50%, zoals retentie, heeft een grote spreiding, maar het verschil in percentages (4 punten) is ook groot, dus resultaten komen sneller dan bij een test op een CVR van een paar procent. Het schatten van de steekproefgrootte per maatstaf helpt je ook te beslissen aan welke verbetering je eerst werkt.
Voor een test waarbij het missen van een goed idee duur zou zijn, zoals een verandering in hoe prijzen worden getoond, kun je de power van 80% naar 90% verhogen. Bij een CVR van 3% en een relatieve stijging van 10% stijgt de steekproefgrootte per groep van 53.211 naar 71.233 (ongeveer 1,34 keer).
Deze berekening laat precies zien hoeveel extra bezoekers het kost om de gemiste effecten te halveren (van 20% naar 10%), zodat je de steekproefgrootte en de testduur kunt afstemmen op hoe belangrijk de test is.
Formules en figuren
Symbolen en begrippen
Symbolen
| \(p_1\) | p index 1 | De basis-CVR (het conversiepercentage van de huidige versie A). \(p\) staat voor proportie of kans. In de formules wordt 3% geschreven als het decimale getal 0,03. |
| \(p_2\) | p index 2 | De doel-CVR (het conversiepercentage dat je hoopt dat versie B bereikt). Het is \(p_1 (1 + r/100)\) bij een relatief % en \(p_1 + d\) bij procentpunten. |
| \(\bar{p}\) | p-streep | Het gemiddelde van de twee CVR’s, \((p_1 + p_2) \div 2\). Het is de gedeelde CVR die je veronderstelt als er geen verschil is. In de statistiek geeft de streep erboven een gemiddelde aan. |
| \(r\) | er | De MDE opgegeven als relatief %. Het staat voor ratio (verhouding) en zegt met hoeveel procent de basis-CVR verbetert (3% naar 3,3% geeft \(r = 10\)). |
| \(d\) | dee | De MDE opgegeven in procentpunten. Het staat voor difference (verschil) en is het gewone verschil in CVR (3% naar 3,3% geeft \(d = 0{,}3\) punten). |
| \(p_2 - p_1\) | p twee min p een | Het te detecteren verschil, in procentpunten als decimaal getal geschreven (0,3 punten is 0,003). De steekproefgrootte wordt gedeeld door het kwadraat ervan, dus hoe kleiner het verschil, hoe sneller de steekproefgrootte groeit. |
| \(\alpha\) | alfa | Het significantieniveau: de kans een verschil echt te noemen terwijl er geen is (de kans op een type I-fout). 5% (0,05) is gebruikelijk. Alfa is de eerste Griekse letter en wordt in de statistiek gebruikt voor de kans op de “eerste” soort fout. |
| \(\beta\) | bèta | De kans een verschil te missen dat er werkelijk is (de kans op een type II-fout). Bèta is de tweede Griekse letter, gebruikt voor de kans op de “tweede” soort fout. |
| \(1-\beta\) | een min bèta | De power: de kans een verschil te vinden als er werkelijk een is. 80% of 90% is gebruikelijk. |
| \(z_{\alpha/2}\) | z index alfa gedeeld door twee | De z-waarde voor het significantieniveau \(\alpha\) bij een tweezijdige toets (het punt waarboven \(\alpha/2\) van de standaardnormale verdeling ligt). Het is 1,9600 bij 5%, 2,5758 bij 1% en 1,6449 bij 10%. Een eenzijdige toets gebruikt in plaats daarvan \(z_{\alpha}\) (1,6449 bij 5%). |
| \(z_{\beta}\) | z index bèta | De z-waarde voor de power \(1-\beta\) (het punt waaronder een kans \(1-\beta\) van de standaardnormale verdeling ligt). Het is 0,8416 bij 80% en 1,2816 bij 90%. |
| \(z_{1-\beta}\) | z index een min bèta | In de powerformule de z-waarde die uit de steekproefgrootte is teruggerekend. Vul die in \(\Phi\) in en je krijgt de power. (Het is hetzelfde als \(z_{\beta}\), geschreven vanuit de kant van de waarde die je oplost.) |
| \(\Phi\) | hoofdletter fi | De cumulatieve verdelingsfunctie van de standaardnormale verdeling. Ze geeft de kans dat een z-waarde kleiner dan of gelijk aan een gegeven waarde is: \(\Phi(1{,}96) \approx 0{,}975\) en \(\Phi(0{,}8416) \approx 0{,}80\). De Griekse hoofdletter fi is het gebruikelijke symbool voor deze functie. |
| \(n\) | en | De steekproefgrootte per groep (voor versie A en versie B elk). Het staat voor number (aantal). Het totaal voor A en B is \(2n\). |
| \(\sqrt{\ \ }\) | wortel | De wortel: het positieve getal dat het getal eronder geeft als je het kwadrateert, bijvoorbeeld \(\sqrt{30.000} \approx 173{,}205\). Hij komt voor bij het bepalen van de spreiding (standaardafwijking) van een CVR. |
| \(V\) | vee | Bezoekers per dag (alle bezoeken aan de geteste pagina, A en B samen). Het staat voor visits (bezoeken). |
| \(D\) | dee | De benodigde dagen. Het staat voor days (dagen). |
| \(\lceil\ \rceil\) | plafond | Het symbool voor naar boven afronden (de plafondfunctie). Het geeft het kleinste gehele getal dat groter dan of gelijk aan het getal erin is (\(\lceil 53{,}211 \rceil = 54\)). |
Begrippen
| A/B-test | Een experiment waarbij je bezoekers willekeurig verdeelt over de huidige versie (A) en een nieuwe versie (B) in dezelfde periode, om te zien welke beter presteert (bijvoorbeeld een hogere CVR). Je gebruikt het om met gegevens in plaats van onderbuikgevoel te controleren of een verandering zoals een knopkleur, een kop, de manier waarop een prijs wordt getoond of de indeling van een landingspagina echt helpt. |
| CVR (conversiepercentage) | Het deel van de bezoekers of klikken dat eindigt in een doelhandeling (een conversie), zoals een aankoop of aanmelding. In de formules op deze pagina is de CVR van versie A \(p_1\) en die van versie B \(p_2\). |
| MDE (minimaal detecteerbaar effect) | De kleinste stijging die je wilt kunnen detecteren. Het is de eerste waarde die je bepaalt als je een A/B-test plant. Hoe kleiner, hoe sneller de steekproefgrootte groeit (hij is omgekeerd evenredig met het kwadraat van het verschil), dus kies de kleinste stijging die voor je bedrijf zou tellen. |
| significantieniveau | De kans \(\alpha\) op de fout die je bereid bent te accepteren: een toevallig verschil zien en het echt noemen terwijl er geen verschil is. 5% is standaard, wat ongeveer 1 keer op de 20 een vals alarm toelaat. Een strenger niveau (1%) vraagt een grotere steekproefgrootte. |
| power (onderscheidend vermogen) | De kans \(1-\beta\) om een verschil te vinden als er werkelijk een is. 80% is standaard, wat accepteert dat je ongeveer 1 keer op de 5 een echte stijging mist. Zegt een test met lage power “geen verschil”, dan is dat geen bewijs dat er geen verschil is. |
| type I-fout | De fout om een verschil echt te noemen terwijl er geen is (een vals positief). De kans die je daarvoor toestaat is het significantieniveau \(\alpha\). Het is de keerzijde van een type II-fout (een gemiste): de ene omlaag duwen duwt de andere meestal omhoog. De meest basale manier om beide klein te maken is een grotere steekproefgrootte. |
| type II-fout | De fout om een verschil te missen dat er werkelijk is (een vals negatief). De kans is \(\beta\), en \(1-\beta\) is de power. Het is de keerzijde van een type I-fout (een vals alarm): de ene omlaag duwen duwt de andere meestal omhoog. De meest basale manier om beide klein te maken is een grotere steekproefgrootte. |
| nulhypothese | De hypothese “versie A en B hebben dezelfde CVR” die de toets probeert te verwerpen. De toets vraagt hoe ongewoon de gegevens zouden zijn als de nulhypothese waar was. Is dat ongewoon genoeg, dan wordt de nulhypothese verworpen en is het resultaat “een verschil”. |
| alternatieve hypothese | De hypothese “versie A en B hebben verschillende CVR’s” die de toets probeert aan te tonen. Ze wordt aanvaard als de nulhypothese (geen verschil) wordt verworpen. |
| tweezijdige toets | Een toets die zowel “B is hoger” als “B is lager” als een verschil telt. Hij wordt gebruikt in een gewone A/B-test, waarbij je niet weet welke kant het opgaat. Hij vraagt een grotere steekproefgrootte dan een eenzijdige toets, maar vangt ook op dat B slechter presteert. |
| eenzijdige toets | Een toets die alleen zoekt naar “B is hoger”. Hij vraagt een kleinere steekproefgrootte dan een tweezijdige toets, maar kan niet opvangen dat B slechter presteert, dus je moet hem vóór de start van de test kiezen. (Na het zien van de resultaten overstappen op eenzijdig is niet geldig.) |
| z-toets voor twee proporties | Een toets die controleert of twee groepen verschillen in een proportie (zoals de CVR), met een z-waarde (het gestandaardiseerde verschil) en de standaardnormale verdeling. De formules op deze pagina vinden de steekproefgrootte voor deze toets. De normale benadering werkt als elke groep genoeg conversies heeft (als vuistregel minstens 5 tot 10). |
| standaardnormale verdeling | De normale verdeling met gemiddelde 0 en standaardafwijking 1 (een symmetrische klokvorm). Een z-waarde is een punt op de horizontale as, en elke z-waarde hoort bij één kans, zoals in “de oppervlakte rechts van 1,96 is 2,5%”. |
| cumulatieve verdelingsfunctie | Een functie die de kans geeft op een gegeven waarde of lager. Die van de standaardnormale verdeling wordt \(\Phi\) geschreven en staat aan het eind van de powerformule. In Excel is het NORM.S.VERD (met WAAR als tweede argument) en in Python NormalDist().cdf. |
| standaardafwijking (spreiding) | Hoe ver gegevens uit elkaar liggen. De spreiding van een proportie \(p\) is evenredig met \(\sqrt{p(1-p)}\). De \(\sqrt{2\bar{p}(1-\bar{p})}\) en \(\sqrt{p_1(1-p_1)+p_2(1-p_2)}\) in de formules zijn de spreiding van het verschil tussen de CVR’s van de twee groepen. |
| meervoudig toetsen | Meerdere B-versies of meetwaarden tegelijk vergelijken. Hoe meer vergelijkingen, hoe waarschijnlijker dat er minstens één toevallig significant lijkt, dus je hebt een correctie nodig, zoals het significantieniveau delen door het aantal vergelijkingen (de Bonferroni-correctie). |
| tussentijds kijken (peeking) | Steeds opnieuw naar de resultaten kijken voordat de benodigde steekproefgrootte is bereikt en stoppen zodra het resultaat significant lijkt. Het maakt toevallige verschillen makkelijk te vangen, dus een test die een significantieniveau van 5% moest hebben, doet veel vaker een verkeerd oordeel. De formules op deze pagina gaan ervan uit dat je eerst de steekproefgrootte vastlegt en wacht tot je hem bereikt. |
Handig om vooraf te weten
Dit helpt je om de berekening op deze pagina echt te begrijpen, in plaats van alleen op de knop te drukken.
Loop je vast, dan is het herhalen van deze onderwerpen de snelste weg vooruit.
| Procenten (groep 7–8, 10-12 jaar) |
|
| Wortels (klas 2–3, 13-15 jaar) |
|
| Basiskansrekening (klas 1–3, 12-15 jaar) |
|
| De normale verdeling en z-scores (havo/vwo wiskunde A/C, 15-18 jaar) |
|
| Het idee van hypothesetoetsen (vwo wiskunde A/C, 16-18 jaar) |
|
| Naar boven afronden (groep 5–6, 8-10 jaar) |
|
Berekenen met Excel
| Basis-CVR p1 (%) | 3 |
| Relatieve stijging r (%) | 10 |
| Doel-CVR p2 (%) | =B1*(1+B2/100) |
| Basis-CVR p1 (%) | 3 |
| Doel-CVR p2 (%) | 3,3 |
| Significantieniveau α (%, tweezijdig) | 5 |
| Power 1−β (%) | 80 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| z_β | =NORM.S.INV(B4/100) |
| Gemiddelde CVR p̄ | =(B1+B2)/2/100 |
| Steekproefgrootte per groep n (naar boven afgerond) | =AFRONDEN.NAAR.BOVEN((B5*WORTEL(2*B7*(1-B7))+B6*WORTEL(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2;0) |
| Steekproefgrootte per groep n | 53211 |
| Bezoekers per dag V (A + B samen) | 2000 |
| Benodigde dagen D (naar boven afgerond) | =AFRONDEN.NAAR.BOVEN(2*B1/B2;0) |
| Basis-CVR p1 (%) | 3 |
| Doel-CVR p2 (%) | 3,3 |
| Significantieniveau α (%, tweezijdig) | 5 |
| Steekproefgrootte per groep n | 30000 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| Gemiddelde CVR p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ABS(B2-B1)/100*WORTEL(B4)-B5*WORTEL(2*B6*(1-B6)))/WORTEL(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| Power 1−β (%) | =NORM.S.VERD(B7;WAAR)*100 |
De eerste tabel toont 3,3 in B3 (een doel-CVR van 3,3%), de tweede toont 53211 in B8 (de steekproefgrootte per groep), de derde toont 54 in B3 (de benodigde dagen) en de vierde toont ongeveer 55,71 in B8 (een power van 55,71%).
NORM.S.INV zet een kans om in een z-waarde en NORM.S.VERD (met WAAR als tweede argument) zet een z-waarde om in een kans. Voor een eenzijdige toets verwijder je de “/2” uit de formule voor z_α/2, zodat die =NORM.S.INV(1-B3/100) wordt. AFRONDEN.NAAR.BOVEN(…;0) rondt naar boven af.
Berekenen met Google Spreadsheets
| Basis-CVR p1 (%) | 3 |
| Relatieve stijging r (%) | 10 |
| Doel-CVR p2 (%) | =B1*(1+B2/100) |
| Basis-CVR p1 (%) | 3 |
| Doel-CVR p2 (%) | 3,3 |
| Significantieniveau α (%, tweezijdig) | 5 |
| Power 1−β (%) | 80 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| z_β | =NORM.S.INV(B4/100) |
| Gemiddelde CVR p̄ | =(B1+B2)/2/100 |
| Steekproefgrootte per groep n (naar boven afgerond) | =AFRONDEN.NAAR.BOVEN((B5*WORTEL(2*B7*(1-B7))+B6*WORTEL(B1/100*(1-B1/100)+B2/100*(1-B2/100)))^2/((B2-B1)/100)^2;0) |
| Steekproefgrootte per groep n | 53211 |
| Bezoekers per dag V (A + B samen) | 2000 |
| Benodigde dagen D (naar boven afgerond) | =AFRONDEN.NAAR.BOVEN(2*B1/B2;0) |
| Basis-CVR p1 (%) | 3 |
| Doel-CVR p2 (%) | 3,3 |
| Significantieniveau α (%, tweezijdig) | 5 |
| Steekproefgrootte per groep n | 30000 |
| z_α/2 | =NORM.S.INV(1-B3/100/2) |
| Gemiddelde CVR p̄ | =(B1+B2)/2/100 |
| z_1−β | =(ABS(B2-B1)/100*WORTEL(B4)-B5*WORTEL(2*B6*(1-B6)))/WORTEL(B1/100*(1-B1/100)+B2/100*(1-B2/100)) |
| Power 1−β (%) | =NORM.S.VERD(B7;WAAR)*100 |
Berekenen met Python
from math import sqrt, ceil
from statistics import NormalDist

base_cvr = 3.0          # basis-CVR (%)
relative_mde = 10.0     # te detecteren MDE (relatief %)
alpha = 0.05            # significantieniveau (tweezijdig)
power = 0.80            # power
daily_visits = 2000     # bezoekers per dag (A + B samen)

p1 = base_cvr / 100
p2 = p1 * (1 + relative_mde / 100)          # doel-CVR
z_alpha = NormalDist().inv_cdf(1 - alpha / 2)  # voor een eenzijdige toets gebruik je 1 - alpha
z_beta = NormalDist().inv_cdf(power)
p_bar = (p1 + p2) / 2

n_exact = (z_alpha * sqrt(2 * p_bar * (1 - p_bar))
           + z_beta * sqrt(p1 * (1 - p1) + p2 * (1 - p2))) ** 2 / (p2 - p1) ** 2
n_per_group = ceil(n_exact)                  # steekproefgrootte per groep (naar boven afgerond)
days = ceil(2 * n_per_group / daily_visits)  # benodigde dagen

print(f"Doel-CVR: {p2 * 100:.4g}%")
print(f"Steekproefgrootte per groep: {n_per_group} (totaal {2 * n_per_group})")
print(f"Benodigde dagen: {days}")

# Andersom: de power met 30.000 bezoekers per groep
n_fixed = 30000
z_power = (abs(p2 - p1) * sqrt(n_fixed) - z_alpha * sqrt(2 * p_bar * (1 - p_bar))) \
          / sqrt(p1 * (1 - p1) + p2 * (1 - p2))
print(f"Power met {n_fixed} per groep: {NormalDist().cdf(z_power) * 100:.2f}%")
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
p₂ = p₁ × (1 + r/100)
p_2 = p_1 \left(1 + \dfrac{r}{100}\right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mi>p</mi><mn>2</mn></msub>
    <mo>=</mo>
    <msub><mi>p</mi><mn>1</mn></msub>
    <mo>(</mo><mn>1</mn><mo>+</mo><mfrac><mi>r</mi><mn>100</mn></mfrac><mo>)</mo>
  </mrow>
</math>
p_2 = p_1 (1 + r/100)
p1*(1 + r/100)
p2 := p1*(1 + r/100);
p2 = p1*(1 + r/100);
p_2 = p_1 (1 + r/100)
n = (z_α/2 √(2p̄(1 − p̄)) + z_β √(p₁(1 − p₁) + p₂(1 − p₂)))² ÷ (p₂ − p₁)²
n = \dfrac{\left( z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})} + z_{\beta}\sqrt{p_1(1-p_1)+p_2(1-p_2)} \right)^2}{(p_2 - p_1)^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msup>
<mrow>
<mo>(</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
<mo>+</mo>
<msub><mi>z</mi><mi>β</mi></msub>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
<mo>)</mo>
</mrow>
<mn>2</mn>
</msup>
<msup>
<mrow><mo>(</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo></mrow>
<mn>2</mn>
</msup>
</mfrac>
</mrow>
</math>
n = (z_(alpha/2) sqrt(2 bar p (1 - bar p)) + z_beta sqrt(p_1(1 - p_1) + p_2(1 - p_2)))^2 / (p_2 - p_1)^2
Ceiling[(za*Sqrt[2*pbar*(1 - pbar)] + zb*Sqrt[p1*(1 - p1) + p2*(1 - p2)])^2/(p2 - p1)^2]
n := ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = ceil((za*sqrt(2*pbar*(1 - pbar)) + zb*sqrt(p1*(1 - p1) + p2*(1 - p2)))^2/(p2 - p1)^2);
n = (z_(α/2) √(2p̄(1 − p̄)) + z_β √(p_1(1 − p_1) + p_2(1 − p_2)))^2/(p_2 − p_1)^2
D = ⌈2n ÷ V⌉
D = \left\lceil \dfrac{2n}{V} \right\rceil
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>D</mi>
<mo>=</mo>
<mo>⌈</mo>
<mfrac><mrow><mn>2</mn><mi>n</mi></mrow><mi>V</mi></mfrac>
<mo>⌉</mo>
</mrow>
</math>
D = |~ (2n)/V ~|
Ceiling[2*n/v]
days := ceil(2*n/V);
D = ceil(2*n/V);
D = ⌈2n/V⌉
1 − β = Φ((|p₂ − p₁|√n − z_α/2 √(2p̄(1 − p̄))) ÷ √(p₁(1 − p₁) + p₂(1 − p₂)))
1 - \beta = \Phi\left( \dfrac{|p_2 - p_1|\sqrt{n} - z_{\alpha/2}\sqrt{2\bar{p}(1-\bar{p})}}{\sqrt{p_1(1-p_1)+p_2(1-p_2)}} \right)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mn>1</mn><mo>−</mo><mi>β</mi>
<mo>=</mo>
<mi>Φ</mi>
<mo>(</mo>
<mfrac>
<mrow>
<mo>|</mo><msub><mi>p</mi><mn>2</mn></msub><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>|</mo>
<msqrt><mi>n</mi></msqrt>
<mo>−</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt><mn>2</mn><mover><mi>p</mi><mo>¯</mo></mover><mo>(</mo><mn>1</mn><mo>−</mo><mover><mi>p</mi><mo>¯</mo></mover><mo>)</mo></msqrt>
</mrow>
<msqrt>
<msub><mi>p</mi><mn>1</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>1</mn></msub><mo>)</mo>
<mo>+</mo>
<msub><mi>p</mi><mn>2</mn></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mi>p</mi><mn>2</mn></msub><mo>)</mo>
</msqrt>
</mfrac>
<mo>)</mo>
</mrow>
</math>
1 - beta = Phi((|p_2 - p_1| sqrt(n) - z_(alpha/2) sqrt(2 bar p (1 - bar p))) / sqrt(p_1(1 - p_1) + p_2(1 - p_2)))
CDF[NormalDistribution[0, 1], (Abs[p2 - p1]*Sqrt[n] - za*Sqrt[2*pbar*(1 - pbar)])/Sqrt[p1*(1 - p1) + p2*(1 - p2)]]
power := Statistics[CDF](Normal(0, 1), (abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
power = normcdf((abs(p2 - p1)*sqrt(n) - za*sqrt(2*pbar*(1 - pbar)))/sqrt(p1*(1 - p1) + p2*(1 - p2)));
1 − β = Φ((|p_2 − p_1| √n − z_(α/2) √(2p̄(1 − p̄)))/√(p_1(1 − p_1) + p_2(1 − p_2)))
Zo laat je ChatGPT de berekening doen
Je bent een assistent voor het plannen van A/B-tests. Voer de volgende berekening uit door daadwerkelijk Python-code uit te voeren en baseer je antwoord alleen op de getallen uit het resultaat van de uitvoering (geef geen antwoord uit je hoofd of op basis van een gok).

De CVR van de huidige pagina (de basis-CVR) is 3%. Ik wil met versie B een relatieve stijging van 10% (een CVR van 3,3%) kunnen detecteren.
Bereken bij een significantieniveau van 5% (tweezijdige toets) en 80% power elk van de volgende punten:
1. De doel-CVR p2 (p2 = p1 × (1 + 10/100))
2. De steekproefgrootte per groep n (de formule voor de z-toets voor twee proporties: n = (z_{α/2}·√(2p̄(1−p̄)) + z_β·√(p1(1−p1)+p2(1−p2)))² ÷ (p2−p1)², met p̄ = (p1+p2)/2, naar boven afgerond) en de totale steekproefgrootte voor A en B
3. De benodigde dagen (naar boven afgerond) bij 2.000 bezoekers per dag (A en B samen)
4. De power als er maar 30.000 bezoekers per groep beschikbaar zijn (1−β = Φ((|p2−p1|·√n − z_{α/2}·√(2p̄(1−p̄))) ÷ √(p1(1−p1)+p2(1−p2))))

Gebruik statistics.NormalDist voor de z-waarden en de cumulatieve verdelingsfunctie en laat de gebruikte formules en de getallen uit het resultaat van de uitvoering zien.
Zo werkt het
-
1Vul je getallen inTyp de getallen waarmee je wilt rekenen in de invoervelden
-
2BerekenKlik op de knop “Berekenen”
-
3Bekijk het resultaatHet resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
Kenmerken van DataChef

Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Zonder persoonlijke gegevens op te geven

Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt


Geen bronvermelding vereist

Geen toestemming vooraf nodig
Gerelateerde functies
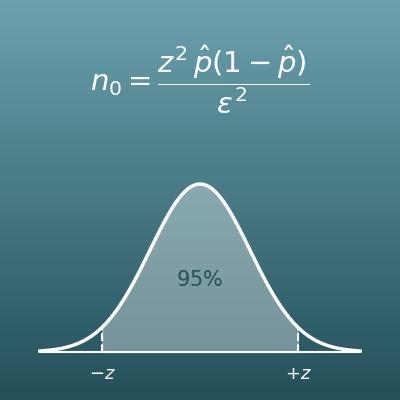
Steekproefgrootte berekenen (enquête, foutmarge en betrouwbaarheid)
Bereken hoeveel mensen een enquête nodig heeft uit het betrouwbaarheidsniveau, de foutmarge en de proportie. Gebruik het als je één percentage nauwkeurig wilt meten
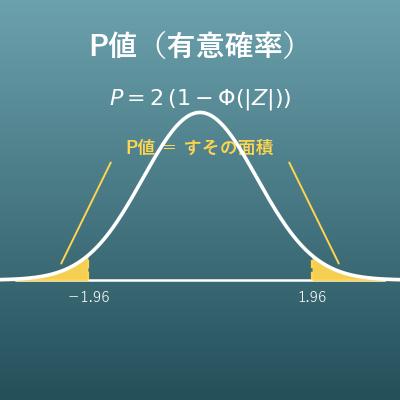
P-waarde berekenen: z-score naar p-waarde en terug
Bepaal de p-waarde uit een z-score en leer wanneer je een tweezijdige of eenzijdige toets gebruikt. Het is de andere kant van het significantieniveau α op deze pagina
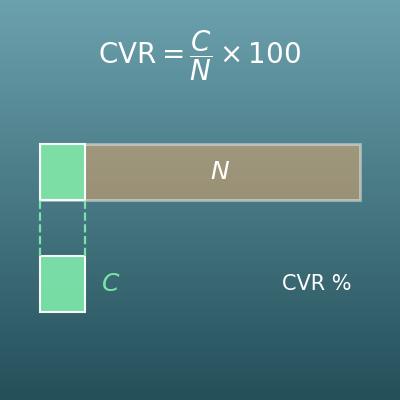
Conversiepercentage berekenen (CVR, benodigde bezoeken en verwachte conversies)
Bepaal bezoeken, conversies of conversiepercentage uit de andere twee. Gebruik het om de basis-CVR voor deze pagina te bepalen