Vul de bezoekers en conversies in voor groep A (de originele versie) en groep B (de aangepaste versie). Naast elk conversiepercentage, het verschil en de relatieve uplift voert de calculator een z-toets voor twee proporties uit voor de z-score en de p-waarde, en geeft hij een oordeel “significant / niet significant” bij het significantieniveau dat je kiest.
Inhoudsopgave
-
Wat je op deze pagina kunt doen
-
Waarvoor is deze berekening handig?
-
Zo werkt het
-
Formule
-
Conversiepercentage van elke groep
-
Verschil in conversiepercentages en relatieve uplift
-
Gepoold conversiepercentage (één percentage voor beide groepen samen)
-
Standaardfout en z-score (z-toets voor twee proporties)
-
P-waarden (tweezijdig en eenzijdig)
-
Betrouwbaarheidsinterval voor het verschil in conversiepercentages
-
-
Symbolen en begrippen
-
Handig om vooraf te weten
-
Berekenen met Excel
-
Berekenen met Google Spreadsheets
-
Berekenen met Python
-
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
-
Zo laat je ChatGPT de berekening doen
-
Kenmerken van DataChef
-
Gerelateerde functies
-
Alle rekenmachines van NumberChef
Wat je op deze pagina kunt doen
- Vul de bezoekers (klikken of sessies kan ook) en conversies van groep A en B in en krijg in één keer elk conversiepercentage, het verschil in conversiepercentages en de relatieve uplift
- “B lijkt beter, maar kan het gewoon toeval zijn?” Een z-toets voor twee proporties beantwoordt dit (z-score, tweezijdige en eenzijdige p-waarden en een oordeel bij een significantieniveau van 5%, 1% of 10%)
- Je krijgt ook het betrouwbaarheidsinterval voor het verschil (zoals 95%) en de marge waarmee de z-score de significantiegrens haalt (of mist)
- Een grafiek van de standaardnormale verdeling laat zien waar je z-score valt en kleurt het kritieke gebied in (significant als de z-score daar terechtkomt)
- Op deze pagina vind je ook een heldere uitleg van de formules en formules om te kopiëren voor Excel, Google Spreadsheets en Python
Waarvoor is deze berekening handig?
“Versie B met een andere kleur voor de knop verhoogde het conversiepercentage van 2,0% naar 2,5%.” Controleren of dit verschil niet zomaar toeval is, is de significantie van een A/B-test, die elke dag in online marketing wordt gedaan. Met 10.000 bezoekers per groep is de tweezijdige p-waarde ongeveer 0,017, “significant bij 5%”. Maar bij vergelijkbare conversiepercentages met 500 bezoekers per groep (10 conversies tegenover 12 of 13) is de p-waarde ongeveer 0,5 tot 0,7 en kun je alleen zeggen “het kan toeval zijn”.
Als je overstapt omdat “B er beter uitziet”, gebeurt het vaak dat de resultaten de volgende maand terugzakken. Eerst het aantal bezoekers bepalen en beoordelen op een significantieniveau voorkomt dit (ervan uitgaand dat bezoekers willekeurig worden verdeeld).
Stuur dezelfde e-mail met twee verschillende onderwerpregels naar elk de helft van de lijst en vergelijk openpercentages van 48% en 52%. Ook dit is een toets op het verschil tussen twee proporties. Bij 5.000 e-mails per groep heeft het verschil van 4 punten een z-score van ongeveer 4, een verschil dat moeilijk met toeval te verklaren is.
Grotere proporties zoals openpercentages zijn bij hetzelfde aantal e-mails makkelijker te beoordelen dan kleine zoals conversiepercentages (het verschil is vaak groot ten opzichte van de standaardfout). Deze formule geeft je een gevoel voor hoe de maatstaf die je vergelijkt het aantal benodigde verzendingen verandert.
Verbeterpercentages van twee groepen vergelijken, zoals “60% knapte op met de standaardbehandeling en 70% met de nieuwe”, is een basistoets in klinisch onderzoek (echte studies gebruiken strenge opzetten zoals randomisatie en blindering).
Artikelen achter geneesmiddelregistraties en behandelrichtlijnen vermelden altijd p-waarden en betrouwbaarheidsintervallen. Als je deze formule begrijpt, laat je je niet leiden door het ene woord “significant”; je kunt ook lezen “hoe groot is het verschil?” en “waren er genoeg patiënten?”.
Lijkt een nieuw proces B het uitvalpercentage te verlagen van 1,5% naar 1,0%, dan verandert het oordeel met het volume: bij 2.000 stuks per groep is het “binnen toeval” en bij 20.000 stuks per groep “een significante verbetering”. Deze berekening voorkomt dat beslissingen over apparatuur en procesveranderingen door toeval in kleine steekproeven worden gestuurd.
Bij kleine proporties zoals uitvalpercentages wordt de normale benadering ruw als het verwachte aantal defecten (stuks × uitvalpercentage) onder 5 komt, dus kies je in plaats daarvan een exacte toets die de binomiale verdeling rechtstreeks gebruikt (zoals de exacte toets van Fisher).
Dezelfde toets werkt voor vergelijkingen als “klassen met het nieuwe leerboek hadden een slagingspercentage van 75%, tegenover 65% met het oude”. Maar als je leerboeken per klas toewijst, zijn leerlingen niet willekeurig verdeeld en raken verschillen tussen docenten en leerlingen vermengd met het resultaat.
In onderwijs- en sociaal onderzoek telt, naast het controleren van de significantie met deze formule, ook de opzet: zijn groepen willekeurig verdeeld, en heeft iemand de manier van vergelijken veranderd nadat de resultaten bekend waren? Als je de aannames achter de formule kent, laat je je niet voor de gek houden door cijfers.
Formule
Symbolen en begrippen
Symbolen
| \(n_A,\ n_B\) | n index A, n index B | Bezoekers (klikken of sessies) in groep A en B. \(n\) staat voor het Engelse “number” (aantal), de gebruikelijke letter in de statistiek voor de steekproefgrootte. |
| \(x_A,\ x_B\) | x index A, x index B | Conversies in groep A en B. \(x\) gebruiken voor het aantal successen is gebruikelijk bij de binomiale verdeling. |
| \(\hat{p}_A,\ \hat{p}_B\) | p-dak index A, p-dak index B | Conversiepercentages van groep A en B (proporties uit de steekproef). \(p\) staat voor “proportie” of “kans” en het “\(\hat{}\)” (dakje) erboven geeft aan dat het een uit de steekproef geschatte waarde is voor de werkelijke waarde \(p\). |
| \(\hat{p}\) | p-dak | Gepoold conversiepercentage. Eén geschat conversiepercentage uit beide groepen samen, ervan uitgaand dat er geen verschil is: \(\hat{p} = (x_A + x_B) \div (n_A + n_B)\). |
| \(d\) | dee | Verschil in conversiepercentages (\(\hat{p}_B - \hat{p}_A\)), van het Engelse “difference”. Deze pagina toont het maal 100, in procentpunten. |
| \(L\) | el | Relatieve uplift (%), van de eerste letter van “lift”. Met hoeveel % het conversiepercentage van B is gestegen ten opzichte van dat van A. |
| \(\mathrm{SE}\) | es-ee | Standaardfout. Een maat voor hoeveel een waarde uit de steekproef (hier het verschil in conversiepercentages) door toeval schommelt; het is de standaardafwijking van die steekproefwaarde. De toets gebruikt het gepoolde conversiepercentage en het betrouwbaarheidsinterval gebruikt \(\mathrm{SE}_d\) uit het conversiepercentage van elke groep. |
| \(z\) | zet | z-score (toetsingsgrootheid). Het verschil gedeeld door de standaardfout: hoeveel keer de toevallige schommeling het verschil is. Zonder verschil volgt hij de standaardnormale verdeling (gemiddelde 0, standaardafwijking 1), dus de p-waarde volgt uit hoe groot hij is. |
| \(|z|\) | absolute waarde van z | De grootte van de z-score zonder teken. Een tweezijdige toets let niet op de richting van het verschil, dus gebruikt de absolute waarde. |
| \(\Phi\) | hoofdletter fi | De cumulatieve verdelingsfunctie van de standaardnormale verdeling. \(\Phi(z)\) is de kans dat een standaardnormale waarde \(z\) of lager is, de oppervlakte onder de klokkromme links van \(z\). De Griekse hoofdletter fi is het gebruikelijke symbool daarvoor. |
| \(p_2,\ p_1\) | p index 2, p index 1 | De tweezijdige en eenzijdige p-waarden. De indices 2 en 1 staan voor “twee staarten” en “één staart”, een aanduiding die alleen op deze pagina wordt gebruikt; statistiekboeken schrijven gewoon \(p\). |
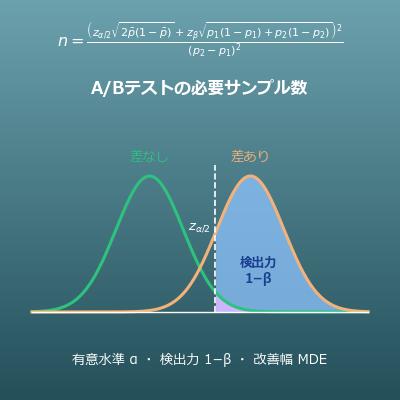
| \(\alpha\) | alfa | Het significantieniveau: de vooraf gekozen grens waarbij “is de p-waarde kleiner, dan verwerp je de nulhypothese”. 5% (0,05) is gebruikelijk. Griekse letter alfa; het is de kans op een type I-fout (een verschil echt noemen terwijl er geen is). |
| \(z_{\alpha/2}\) | z index alfa gedeeld door 2 | De grens-z-score (kritieke waarde) die in beide staarten samen een kans van \(\alpha\) overlaat. 1,96 bij een 95%-betrouwbaarheidsinterval (\(\alpha = 0{,}05\)) en 2,576 bij 99%. Voor één staart is het \(z_\alpha\) (1,645 bij 5%). |
| \(d_L,\ d_U\) | d index L, d index U | De onder- en bovengrens van het betrouwbaarheidsinterval voor het verschil: de twee uiteinden van het bereik waarin het werkelijke verschil waarschijnlijk ligt. |
Begrippen
| A/B-test | Een experiment waarbij je bezoekers willekeurig de originele versie (A) of een aangepaste versie (B) laat zien in dezelfde periode en de resultaten vergelijkt. Veel gebruikt voor websites, advertenties en e-mail. Door willekeurig te verdelen zijn andere factoren dan de versie (dag van de week, verkeersbron enzovoort) in beide groepen gelijk. |
| conversiepercentage (CVR) | Het deel van de bezoeken (klikken) dat tot een resultaat (conversie) zoals een aankoop of aanmelding leidde. Om één conversiepercentage te berekenen of terug te rekenen, zie de calculator voor het conversiepercentage. |
| nulhypothese | De hypothese die de toets probeert te verwerpen: “A en B hebben werkelijk hetzelfde conversiepercentage” (\(p_A = p_B\)). De toets kijkt hoe onwaarschijnlijk het waargenomen verschil zou zijn als dit waar was. |
| alternatieve hypothese | De hypothese die je wilt aantonen, het tegenovergestelde van de nulhypothese. Bij een tweezijdige toets is het “A en B verschillen” (\(p_A \neq p_B\)); bij een eenzijdige toets “B is hoger dan A” (\(p_B > p_A\)). |
| significantieniveau | De grens die je vóór de toets kiest: is de p-waarde kleiner, dan verwerp je de nulhypothese. 5% is gebruikelijk; gebruik 1% voor een strengere toets. “Significant bij 5%” zegt: “de kans op een verschil zo groot zonder werkelijk verschil is minder dan 5%”. |
| p-waarde | De kans op een verschil dat minstens zo groot is door toeval, als de nulhypothese (geen verschil) waar is. Hoe kleiner, hoe moeilijker het resultaat met toeval te verklaren is. Let op dat het niet “de kans dat B beter is” is (een veelvoorkomend misverstand). |
| statistisch significant | De p-waarde is lager dan het significantieniveau, dus het verschil is moeilijk met toevallige schommeling te verklaren. Het belooft niet dat het verschil groot of het effect zeker is; bij een enorm aantal bezoekers wordt zelfs een piepklein verschil significant. |
| toetsingsgrootheid | Eén getal dat uit de gegevens voor de toets wordt berekend. Op deze pagina is het de z-score, “verschil ÷ standaardfout”. Hoe extreem hij is, bepaalt de p-waarde. |
| z-toets voor twee proporties | Een toets die de normale verdeling gebruikt om te controleren of de proporties (zoals conversiepercentages) van twee groepen verschillen. Het is de meest basale manier om de significantie van een A/B-test te beoordelen. Je kunt vrijwel hetzelfde doen met een 2×2-chikwadraattoets; de tweezijdige p-waarden komen overeen. |
| standaardfout | De standaardafwijking van een statistiek uit een steekproef (hier het verschil in conversiepercentages): hoeveel hij door toeval schommelt afhankelijk van de steekproef. Hij wordt kleiner met de wortel uit het aantal bezoekers, dus om de standaardfout te halveren heb je 4 keer zoveel bezoekers nodig. |
| gepoold (poolen) | De gegevens van beide groepen combineren tot één schatting van het conversiepercentage, ervan uitgaand dat er geen verschil is. De standaardfout voor de toets gebruikt deze gepoolde waarde. |
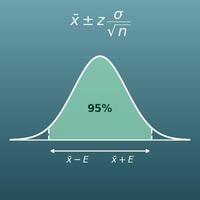
| betrouwbaarheidsinterval | Het bereik waarin het werkelijke verschil waarschijnlijk ligt. Een 95%-betrouwbaarheidsinterval is een manier om intervallen zo te bouwen dat bij vele herhalingen van het experiment 95% ervan het werkelijke verschil bevat. Bevat het interval 0 niet, dan komt dat vrijwel altijd overeen met significantie in een tweezijdige toets bij 5%. |
| tweezijdige toets | Een toets van “is er een verschil (welke ook hoger is)?”. Gebruik hem voor een gewone A/B-test waarbij je niet weet welke kant het opgaat. |
| eenzijdige toets | Een toets met een vaste richting, zoals “is B hoger dan A?”. De p-waarde is de helft van die van de tweezijdige, dus hij wordt sneller significant; gebruik hem alleen als je de richting vóór de test hebt besloten. |
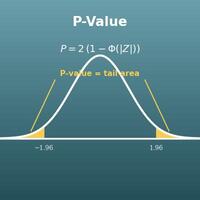
| kritiek gebied | Het staartgebied van de standaardnormale verdeling waarin je de nulhypothese verwerpt als de z-score daar terechtkomt. Bij tweezijdig 5% zijn het de twee staarten \(z < -1{,}96\) en \(z > 1{,}96\), met een totale oppervlakte van 0,05. Het is het gekleurde deel van de grafiek op deze pagina. |
| kritieke waarde | De z-score aan de rand van het kritieke gebied. 1,96 bij tweezijdig 5%, 2,576 bij tweezijdig 1% en 1,645 bij eenzijdig 5%. De “marge van de z-score” in het resultaat laat zien hoeveel deze z-score boven (of onder) de kritieke waarde ligt. |
| normale benadering | Het aantal conversies volgt eigenlijk een binomiale verdeling, maar bij veel bezoekers benadert een normale verdeling (klokkromme) die goed. De z-toets gebruikt deze benadering, dus als richtlijn moeten de verwachte conversies \(n\hat{p}\) en de verwachte niet-conversies \(n(1-\hat{p})\) in elke groep 5 of meer zijn (liefst 10 of meer). |
| onderscheidend vermogen (power) | De kans dat de toets een werkelijk verschil als significant herkent. Bij weinig bezoekers is het onderscheidend vermogen laag, en komt zelfs een echt effect vaak “niet significant” uit. “Niet significant” bewijst niet “geen verschil”. |
| type I-fout | Een resultaat significant noemen terwijl er werkelijk geen verschil is (een vals positief). Het significantieniveau \(\alpha\) is de kans op deze fout die je accepteert; bij 5%: “doe 100 toetsen zonder werkelijk verschil en ongeveer 5 zijn toevallig significant”. |
| meervoudig toetsen | Veel versies of meetwaarden tegelijk testen. Zelfs bij een significantieniveau van 5% komt bij 20 meetwaarden waarschijnlijk één “significant” uit door toeval. Je moet de meetwaarden vooraf beperken of een strenger significantieniveau gebruiken (Bonferroni-correctie en andere). |
| tussentijds kijken (peeking) | Tijdens de test steeds opnieuw naar de resultaten kijken en stoppen zodra het significant lijkt. De p-waarde gaat tijdens een test op en neer, dus als je blijft “stoppen zodra hij onder 5% komt”, komt de kans op significantie zonder werkelijk verschil ver boven 5%. De basisregel is eerst het benodigde aantal bezoekers te bepalen en te wachten tot je het hebt. |
| relatieve uplift | Met hoeveel % het conversiepercentage van B is gestegen ten opzichte van dat van A: het verschil \(d\) gedeeld door het conversiepercentage van A, maal 100. “25% hoger” is makkelijker om te zetten in schattingen van extra conversies en omzet dan “0,5 punt hoger”. |
| procentpunt | De eenheid voor het resultaat van het aftrekken van het ene percentage van het andere (afgekort pp). Gebruikt zoals in “2,5% − 2% = 0,5 procentpunt”; “0,5%” schrijven zou kunnen worden opgevat als “0,5% van 2%”. |
Handig om vooraf te weten
Dit helpt je om de berekening op deze pagina echt te begrijpen, in plaats van alleen op de knop te drukken.
Loop je vast, dan is het herhalen van deze onderwerpen de snelste weg vooruit.
| Procenten (groep 7–8, 10-12 jaar) |
|
| Omgekeerden en wortels (groep 8–klas 2, 11-14 jaar) |
|
| De normale verdeling en standaardafwijking (havo/vwo wiskunde A/C, 15-18 jaar) |
|
| De logica van hypothesetoetsen (havo/vwo wiskunde A/C, 15-18 jaar) |
|
| De binomiale verdeling en de normale benadering (vwo wiskunde A/C, 16-18 jaar) |
|
Berekenen met Excel
| Bezoekers in A n_A | 10000 |
| Conversies in A x_A | 200 |
| Bezoekers in B n_B | 10000 |
| Conversies in B x_B | 250 |
| Conversiepercentage van A p̂_A | =B2/B1 |
| Conversiepercentage van B p̂_B | =B4/B3 |
| Conversiepercentage van A p̂_A | 0,02 |
| Conversiepercentage van B p̂_B | 0,025 |
| Verschil d | =B2-B1 |
| Relatieve uplift L (%) | =B3/B1*100 |
| Conversies in A x_A | 200 |
| Conversies in B x_B | 250 |
| Bezoekers in A n_A | 10000 |
| Bezoekers in B n_B | 10000 |
| Gepoold conversiepercentage p̂ | =(B1+B2)/(B3+B4) |
| Gepoold conversiepercentage p̂ | 0,0225 |
| Bezoekers in A n_A | 10000 |
| Bezoekers in B n_B | 10000 |
| Verschil d | 0,005 |
| Standaardfout SE | =WORTEL(B1*(1-B1)*(1/B2+1/B3)) |
| z-score z | =B4/B5 |
| z-score z | 2,384 |
| Tweezijdige p-waarde p₂ | =2*(1-NORM.S.VERD(ABS(B1);WAAR)) |
| Eenzijdige p-waarde p₁ | =1-NORM.S.VERD(B1;WAAR) |
| Conversiepercentage van A p̂_A | 0,02 |
| Bezoekers in A n_A | 10000 |
| Conversiepercentage van B p̂_B | 0,025 |
| Bezoekers in B n_B | 10000 |
| Verschil d | 0,005 |
| Betrouwbaarheidsniveau (0,95 = 95%) | 0,95 |
| z_(α/2) | =NORM.S.INV(1-(1-B6)/2) |
| Standaardfout SE_d | =WORTEL(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| Ondergrens d_L | =B5-B7*B8 |
| Bovengrens d_U | =B5+B7*B8 |
In de eerste tabel toont B5 het conversiepercentage van A, 0,02, en B6 dat van B, 0,025. De tweede tabel geeft een verschil van 0,005 (0,5 procentpunten) en een uplift van 25, de derde een gepoold conversiepercentage van 0,0225 en de vierde een standaardfout van ongeveer 0,002097 en een z-score van ongeveer 2,384.
In de vijfde tabel geeft NORM.S.VERD(z; WAAR) de standaardnormale cumulatieve kans Φ(z); de tweezijdige p-waarde is ongeveer 0,0171 en de eenzijdige p-waarde ongeveer 0,0086. In de zesde tabel vindt NORM.S.INV de z-score uit een cumulatieve kans (1,96 bij een betrouwbaarheidsniveau van 95%), wat een ondergrens van ongeveer 0,0009 en een bovengrens van ongeveer 0,0091 geeft (0,09 tot 0,91 procentpunten).
Berekenen met Google Spreadsheets
| Bezoekers in A n_A | 10000 |
| Conversies in A x_A | 200 |
| Bezoekers in B n_B | 10000 |
| Conversies in B x_B | 250 |
| Conversiepercentage van A p̂_A | =B2/B1 |
| Conversiepercentage van B p̂_B | =B4/B3 |
| Conversiepercentage van A p̂_A | 0,02 |
| Conversiepercentage van B p̂_B | 0,025 |
| Verschil d | =B2-B1 |
| Relatieve uplift L (%) | =B3/B1*100 |
| Conversies in A x_A | 200 |
| Conversies in B x_B | 250 |
| Bezoekers in A n_A | 10000 |
| Bezoekers in B n_B | 10000 |
| Gepoold conversiepercentage p̂ | =(B1+B2)/(B3+B4) |
| Gepoold conversiepercentage p̂ | 0,0225 |
| Bezoekers in A n_A | 10000 |
| Bezoekers in B n_B | 10000 |
| Verschil d | 0,005 |
| Standaardfout SE | =WORTEL(B1*(1-B1)*(1/B2+1/B3)) |
| z-score z | =B4/B5 |
| z-score z | 2,384 |
| Tweezijdige p-waarde p₂ | =2*(1-STAND.NORM.VERD(ABS(B1))) |
| Eenzijdige p-waarde p₁ | =1-STAND.NORM.VERD(B1) |
| Conversiepercentage van A p̂_A | 0,02 |
| Bezoekers in A n_A | 10000 |
| Conversiepercentage van B p̂_B | 0,025 |
| Bezoekers in B n_B | 10000 |
| Verschil d | 0,005 |
| Betrouwbaarheidsniveau (0,95 = 95%) | 0,95 |
| z_(α/2) | =STAND.NORM.INV(1-(1-B6)/2) |
| Standaardfout SE_d | =WORTEL(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| Ondergrens d_L | =B5-B7*B8 |
| Bovengrens d_U | =B5+B7*B8 |
Berekenen met Python
import math

visits_a, conversions_a = 10000, 200   # bezoekers en conversies in A
visits_b, conversions_b = 10000, 250   # bezoekers en conversies in B
alpha = 0.05                           # significantieniveau (5%)

def normal_cdf(z):
    # standaardnormale cumulatieve verdelingsfunctie Φ(z)
    return 0.5 * math.erfc(-z / math.sqrt(2))

def normal_ppf(p):
    # inverse van Φ (bisectie; gebruikt om z_(α/2) te vinden)
    low, high = -10.0, 10.0
    for _ in range(100):
        mid = (low + high) / 2
        if normal_cdf(mid) < p:
            low = mid
        else:
            high = mid
    return (low + high) / 2

cvr_a = conversions_a / visits_a
cvr_b = conversions_b / visits_b
diff = cvr_b - cvr_a
lift = diff / cvr_a * 100
pooled = (conversions_a + conversions_b) / (visits_a + visits_b)
se_pooled = math.sqrt(pooled * (1 - pooled) * (1 / visits_a + 1 / visits_b))
z = diff / se_pooled
p_two_sided = 2 * (1 - normal_cdf(abs(z)))
p_one_sided = 1 - normal_cdf(z)

se_diff = math.sqrt(cvr_a * (1 - cvr_a) / visits_a + cvr_b * (1 - cvr_b) / visits_b)
z_half = normal_ppf(1 - alpha / 2)
ci_low, ci_high = diff - z_half * se_diff, diff + z_half * se_diff

print(f"Conversiepercentage A: {cvr_a * 100:.2f}%  Conversiepercentage B: {cvr_b * 100:.2f}%")
print(f"Verschil: {diff * 100:.2f} procentpunten  Relatieve uplift: {lift:.1f}%")
print(f"z-score: {z:.3f}  tweezijdige p-waarde: {p_two_sided:.4f}  eenzijdige p-waarde: {p_one_sided:.4f}")
print("Oordeel (tweezijdig):", "statistisch significant" if p_two_sided < alpha else "niet statistisch significant")
print(f"{(1 - alpha) * 100:.0f}%-betrouwbaarheidsinterval voor het verschil: {ci_low * 100:.2f} tot {ci_high * 100:.2f} procentpunten")
De formule in LaTeX en andere wiskundenotaties (om te kopiëren)
p̂_A = x_A ÷ n_A
\hat{p}_A = \dfrac{x_A}{n_A}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
    <mo>=</mo>
    <mfrac>
      <msub><mi>x</mi><mi>A</mi></msub>
      <msub><mi>n</mi><mi>A</mi></msub>
    </mfrac>
  </mrow>
</math>
hat(p)_A = x_A / n_A
xA/nA
pA := xA/nA;
pA = xA/nA;
p̂_A = x_A/n_A
d = p̂_B − p̂_A, L = d ÷ p̂_A × 100
d = \hat{p}_B - \hat{p}_A, \quad L = \dfrac{d}{\hat{p}_A} \times 100
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>=</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub>
<mo>−</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
<mo>,</mo><mspace width="1em"/>
<mi>L</mi><mo>=</mo>
<mfrac><mi>d</mi><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mfrac>
<mo>×</mo><mn>100</mn>
</mrow>
</math>
d = hat(p)_B - hat(p)_A, L = d / hat(p)_A xx 100
d = pB - pA; d/pA*100
d := pB - pA; L := d/pA*100;
d = pB - pA; L = d/pA*100;
d = p̂_B − p̂_A, L = d/p̂_A × 100
p̂ = (x_A + x_B) ÷ (n_A + n_B)
\hat{p} = \dfrac{x_A + x_B}{n_A + n_B}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mover accent="true"><mi>p</mi><mo>^</mo></mover>
    <mo>=</mo>
    <mfrac>
      <mrow><msub><mi>x</mi><mi>A</mi></msub><mo>+</mo><msub><mi>x</mi><mi>B</mi></msub></mrow>
      <mrow><msub><mi>n</mi><mi>A</mi></msub><mo>+</mo><msub><mi>n</mi><mi>B</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
hat(p) = (x_A + x_B) / (n_A + n_B)
(xA + xB)/(nA + nB)
pPool := (xA + xB)/(nA + nB);
pPool = (xA + xB)/(nA + nB);
p̂ = (x_A + x_B)/(n_A + n_B)
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d ÷ SE
\mathrm{SE} = \sqrt{\hat{p}(1-\hat{p})\left(\dfrac{1}{n_A}+\dfrac{1}{n_B}\right)}, \quad z = \dfrac{d}{\mathrm{SE}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi><mo>=</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mrow>
<msqrt>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
<mo>(</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>A</mi></msub></mfrac>
<mo>+</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>B</mi></msub></mfrac>
<mo>)</mo>
</msqrt>
</mfrac>
</mrow>
</math>
SE = sqrt(hat(p)(1 - hat(p))(1/n_A + 1/n_B)), z = d / SE
se = Sqrt[pPool*(1 - pPool)*(1/nA + 1/nB)]; z = d/se
SE := sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z := d/SE;
SE = sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z = d/SE;
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d/SE
p₂ = 2(1 − Φ(|z|)), p₁ = 1 − Φ(z)
p_2 = 2\left(1 - \Phi(|z|)\right), \quad p_1 = 1 - \Phi(z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>p</mi><mn>2</mn></msub><mo>=</mo>
<mn>2</mn><mo>(</mo><mn>1</mn><mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>z</mi><mo>|</mo><mo>)</mo><mo>)</mo>
<mo>,</mo><mspace width="1em"/>
<msub><mi>p</mi><mn>1</mn></msub><mo>=</mo>
<mn>1</mn><mo>−</mo><mi>Φ</mi><mo>(</mo><mi>z</mi><mo>)</mo>
</mrow>
</math>
p_2 = 2(1 - Phi(|z|)), p_1 = 1 - Phi(z)
p2 = 2*(1 - CDF[NormalDistribution[0, 1], Abs[z]]); p1 = 1 - CDF[NormalDistribution[0, 1], z]
p2 := 2*(1 - Statistics:-CDF(Normal(0, 1), abs(z))); p1 := 1 - Statistics:-CDF(Normal(0, 1), z);
p2 = 2*(1 - normcdf(abs(z))); p1 = 1 - normcdf(z);
p_2 = 2(1 − Φ(|z|)), p_1 = 1 − Φ(z)
d ± z_(α/2) × √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
d \pm z_{\alpha/2}\sqrt{\dfrac{\hat{p}_A(1-\hat{p}_A)}{n_A}+\dfrac{\hat{p}_B(1-\hat{p}_B)}{n_B}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>±</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>A</mi></msub>
</mfrac>
<mo>+</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>B</mi></msub>
</mfrac>
</msqrt>
</mrow>
</math>
d +- z_(alpha/2) sqrt((hat(p)_A(1 - hat(p)_A))/n_A + (hat(p)_B(1 - hat(p)_B))/n_B)
seD = Sqrt[pA*(1 - pA)/nA + pB*(1 - pB)/nB]; {d - zHalf*seD, d + zHalf*seD}
seD := sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); [d - zHalf*seD, d + zHalf*seD];
seD = sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); ci = [d - zHalf*seD, d + zHalf*seD];
d ± z_(α/2) √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
Zo laat je ChatGPT de berekening doen
Je bent een rekenassistent voor statistiek (hypothesetoetsen). Voer de volgende berekening uit door daadwerkelijk Python-code uit te voeren en baseer je antwoord alleen op de getallen uit het resultaat van de uitvoering (geef geen antwoord uit je hoofd of op basis van een gok).

De resultaten van de A/B-test zijn:
- Groep A: 10000 bezoekers, 200 conversies
- Groep B: 10000 bezoekers, 250 conversies
Bereken elk van de volgende punten:
1. Het conversiepercentage van elke groep (%), het verschil in conversiepercentage (procentpunten) en de relatieve uplift (%)
2. Het gepoolde conversiepercentage en de gepoolde standaardfout SE = √(p̂(1−p̂)(1/n_A + 1/n_B))
3. De z-score = verschil ÷ SE, en de tweezijdige en eenzijdige p-waarden (standaardnormale verdeling)
4. Of het verschil statistisch significant is bij een significantieniveau van 5% (tweezijdig)
5. Het 95%-betrouwbaarheidsinterval voor het verschil (met de standaardfout uit het conversiepercentage van elke groep, √(p̂_A(1−p̂_A)/n_A + p̂_B(1−p̂_B)/n_B))

Gebruik in Python math.erfc (of scipy.stats.norm) en laat de gebruikte formules en de getallen uit het resultaat van de uitvoering zien.
Zo werkt het
-
1Vul je getallen inTyp de getallen waarmee je wilt rekenen in de invoervelden
-
2BerekenKlik op de knop “Berekenen”
-
3Bekijk het resultaatHet resultaat verschijnt meteen. Op dezelfde pagina vind je ook de uitwerking van de berekening en de uitleg van de formule
Kenmerken van DataChef

Geen voorkennis nodig – intuïtieve en eenvoudige bediening

Zonder persoonlijke gegevens op te geven

Bestand wordt automatisch verwijderd zodra je op "Downloaden" klikt


Geen bronvermelding vereist

Geen toestemming vooraf nodig
Gerelateerde functies
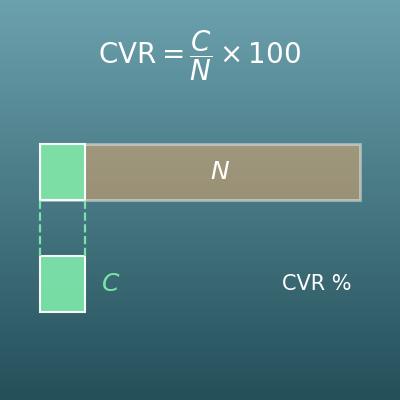
Conversiepercentage berekenen (CVR, benodigde bezoeken en verwachte conversies)
Vul twee van bezoeken, conversies en conversiepercentage in en bereken de derde. Gebruik het als je alleen het conversiepercentage van één groep nodig hebt
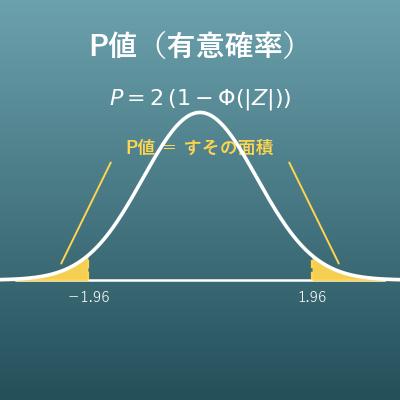
P-waarde berekenen: z-score naar p-waarde en terug
Een algemene calculator die een z-score die je al hebt omrekent naar een linkszijdige, rechtszijdige of tweezijdige p-waarde. Deze pagina begint een stap eerder, bij bezoekers en conversies
Betrouwbaarheidsinterval berekenen (voor een populatiegemiddelde)
Berekent het betrouwbaarheidsinterval voor een gemiddelde (toetscijfers, omzet enzovoort). De variant voor gemiddelden van het betrouwbaarheidsinterval voor het verschil op deze pagina
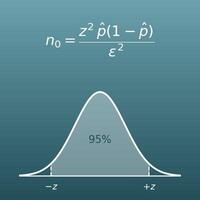
Steekproefgrootte berekenen (enquête, foutmarge en betrouwbaarheid)
Berekent hoeveel mensen je nodig hebt om in een enquête één proportie binnen een foutmarge te schatten. Gebruik het om enquêtes op te zetten