Geben Sie die Besuche und Conversions für Variante A (das Original) und Variante B (die Änderung) ein. Neben der Conversion-Rate jeder Variante, der Differenz und dem relativen Uplift führt der Rechner einen z-Test für zwei Anteile durch, liefert z-Wert und p-Wert und entscheidet beim gewählten Signifikanzniveau, ob das Ergebnis signifikant ist.
Inhaltsverzeichnis
-
Das können Sie auf dieser Seite
-
Wofür braucht man diese Berechnung?
-
Anleitung
-
Formel
-
Symbole und Begriffe
-
Das sollten Sie vorher wissen
-
So berechnen Sie es in Excel
-
So berechnen Sie es in Google Tabellen
-
So berechnen Sie es in Python
-
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
-
So lassen Sie ChatGPT rechnen
-
Die Vorteile von DataChef
-
Verwandte Funktionen
-
Alle Rechner von NumberChef
Das können Sie auf dieser Seite
- Geben Sie für Variante A und B die Besuche (auch Klicks oder Sitzungen) und die Conversions ein – der Rechner ermittelt die Conversion-Rate jeder Variante, die Differenz und den relativen Uplift in einem Schritt
- „B sieht besser aus – aber ist das vielleicht nur Zufall?“ Ein z-Test für zwei Anteile beantwortet das (z-Wert, zwei- und einseitiger p-Wert, Ergebnis bei einem Signifikanzniveau von 5 %, 1 % oder 10 %)
- Dazu das Konfidenzintervall für die Differenz (z. B. 95 %) und der Abstand, um den der z-Wert die Signifikanzgrenze überschreitet (oder verfehlt)
- Ein Graph der Standard-Normalverteilung zeigt, wo Ihr z-Wert liegt, und färbt den Ablehnungsbereich (landet der z-Wert dort, ist das Ergebnis signifikant)
- Dazu eine leicht verständliche Erklärung der Formeln und Formeln zum Kopieren für Excel, Google Tabellen und Python
Wofür braucht man diese Berechnung?
„Variante B mit anderer Buttonfarbe hat die Conversion-Rate von 2,0 % auf 2,5 % erhöht.“ Zu prüfen, ob diese Differenz nicht nur Zufall ist, ist die Signifikanzprüfung beim A/B-Test – im Online-Marketing tägliches Brot. Mit je 10.000 Besuchen beträgt der zweiseitige p-Wert etwa 0,017, also „signifikant bei 5 %“. Mit ähnlichen Conversion-Rates bei je 500 Besuchen (10 gegen 12 oder 13 Conversions) liegt der p-Wert dagegen bei etwa 0,5 bis 0,7, und man kann nur sagen: „Das kann Zufall sein.“
Wer umstellt, weil „B besser aussieht“, erlebt oft, dass sich die Ergebnisse im nächsten Monat wieder angleichen. Legt man die Zahl der Besuche vorab fest und entscheidet über ein Signifikanzniveau, lässt sich das vermeiden (vorausgesetzt, die Besuche werden zufällig aufgeteilt).
Schicken Sie dieselbe E-Mail mit zwei verschiedenen Betreffzeilen an je die Hälfte der Liste und vergleichen Sie Öffnungsraten von 48 % und 52 %. Auch das ist ein Test auf den Unterschied zweier Anteile. Bei je 5.000 E-Mails hat die Differenz von 4 Prozentpunkten einen z-Wert von etwa 4 – kaum mit Zufall zu erklären.
Größere Anteile wie Öffnungsraten lassen sich mit derselben Zahl an E-Mails leichter beurteilen als kleine wie Conversion-Rates (die Differenz ist im Verhältnis zum Standardfehler meist groß). Mit dieser Formel bekommen Sie ein Gefühl dafür, wie die verglichene Kennzahl die nötige Zahl an Sendungen verändert.
Der Vergleich von Besserungsraten zweier Gruppen, etwa „60 % besser mit der Standardtherapie, 70 % mit der neuen“, ist ein grundlegender Test in klinischen Studien (echte Studien nutzen strenge Designs wie Randomisierung und Verblindung).
Studien hinter Arzneimittelzulassungen und Behandlungsleitlinien geben immer p-Werte und Konfidenzintervalle an. Wer diese Formel versteht, lässt sich vom Wort „signifikant“ allein nicht beeindrucken und fragt auch: „Wie groß ist der Unterschied?“ und „Waren es genug Patientinnen und Patienten?“
Scheint ein neuer Prozess B die Fehlerquote von 1,5 % auf 1,0 % zu senken, hängt das Ergebnis von der Menge ab: Bei je 2.000 Stück liegt es „im Rahmen des Zufalls“, bei je 20.000 Stück ist es „eine signifikante Verbesserung“. Diese Rechnung verhindert, dass Entscheidungen über Anlagen und Prozessänderungen vom Zufall kleiner Stichproben abhängen.
Bei kleinen Anteilen wie Fehlerquoten wird die Normalapproximation ungenau, wenn die erwartete Zahl an Fehlern (Stückzahl × Fehlerquote) unter 5 fällt; dann wählt man einen exakten Test, der die Binomialverteilung direkt nutzt (etwa den exakten Test nach Fisher).
Derselbe Test passt für Vergleiche wie „Klassen mit dem neuen Lehrbuch hatten eine Bestehensquote von 75 %, mit dem alten 65 %“. Verteilen Sie die Lehrbücher aber klassenweise, wurden die Schülerinnen und Schüler nicht zufällig aufgeteilt, und Unterschiede bei Lehrkräften und Lernenden fließen ins Ergebnis ein.
In der Bildungs- und Sozialforschung zählt neben der Signifikanzprüfung mit dieser Formel auch das Design: Wurden die Gruppen zufällig gebildet, und hat jemand nach dem Blick auf die Ergebnisse den Vergleich anders zugeschnitten? Wer die Annahmen hinter der Formel kennt, lässt sich von Zahlen nicht täuschen.
Formel
Symbole und Begriffe
Symbole
| \(n_A,\ n_B\) | n Index A, n Index B | Die Besuche (Klicks oder Sitzungen) in Variante A und B. \(n\) steht für „Number“ (Anzahl); in der Statistik ist es der übliche Buchstabe für den Stichprobenumfang. |
| \(x_A,\ x_B\) | x Index A, x Index B | Die Conversions in Variante A und B. Die Zahl der Erfolge mit \(x\) zu bezeichnen, ist bei der Binomialverteilung üblich. |
| \(\hat{p}_A,\ \hat{p}_B\) | p Dach A, p Dach B | Die Conversion-Rates von Variante A und B (Anteile aus der Stichprobe). \(p\) steht für „Proportion“ (Anteil) oder „Probability“ (Wahrscheinlichkeit); das „\(\hat{}\)“ (Dach) kennzeichnet einen aus der Stichprobe geschätzten Wert für den wahren Wert \(p\). |
| \(\hat{p}\) | p Dach | Die gepoolte Conversion-Rate: ein Schätzwert aus beiden Varianten zusammen, unter der Annahme, dass es keinen Unterschied gibt, \(\hat{p} = (x_A + x_B) \div (n_A + n_B)\). |
| \(d\) | De | Die Differenz der Conversion-Rates (\(\hat{p}_B - \hat{p}_A\)), \(d\) wie „Differenz“. Diese Seite zeigt sie mal 100 in Prozentpunkten. |
| \(L\) | El | Der relative Uplift (%), \(L\) nach dem englischen „Lift“: um wie viel Prozent die Conversion-Rate von B gegenüber der von A gestiegen ist. |
| \(\mathrm{SE}\) | S-E | Der Standardfehler (englisch „Standard Error“): ein Maß dafür, wie stark ein Wert aus der Stichprobe (hier die Differenz der Conversion-Rates) zufällig schwankt – die Standardabweichung dieses Stichprobenwerts. Der Test verwendet die gepoolte Conversion-Rate, das Konfidenzintervall \(\mathrm{SE}_d\) aus den Conversion-Rates der einzelnen Varianten. |
| \(z\) | Zet | Der z-Wert (Teststatistik): die Differenz geteilt durch den Standardfehler, also das Wievielfache der zufälligen Schwankung. Ohne Unterschied folgt er der Standard-Normalverteilung (Mittelwert 0, Standardabweichung 1); aus seiner Größe ergibt sich der p-Wert. |
| \(|z|\) | Betrag von z | Die Größe des z-Werts ohne Vorzeichen. Beim zweiseitigen Test spielt die Richtung der Differenz keine Rolle, daher wird der Betrag verwendet. |
| \(\Phi\) | Phi (groß) | Die Verteilungsfunktion der Standard-Normalverteilung. \(\Phi(z)\) ist die Wahrscheinlichkeit, dass ein standardnormalverteilter Wert höchstens \(z\) ist – die Fläche unter der Glockenkurve links von \(z\). Das große griechische Phi ist das übliche Zeichen dafür. |
| \(p_2,\ p_1\) | p Index 2, p Index 1 | Der zwei- und der einseitige p-Wert. Die Indizes 2 und 1 stehen für „zwei Ränder“ und „ein Rand“ – eine Bezeichnung nur auf dieser Seite; Statistikbücher schreiben einfach \(p\). |
| \(\alpha\) | Alpha | Das Signifikanzniveau: die vorab festgelegte Grenze – liegt der p-Wert darunter, wird die Nullhypothese abgelehnt. Üblich sind 5 % (0,05). Das griechische Alpha ist die Wahrscheinlichkeit eines Fehlers 1. Art (einen Unterschied für echt halten, den es nicht gibt). |
| \(z_{\alpha/2}\) | z Index Alpha halbe | Der z-Wert an der Grenze (kritischer Wert), bei dem an beiden Rändern zusammen die Wahrscheinlichkeit \(\alpha\) übrig bleibt: 1,96 bei einem 95-%-Konfidenzintervall (\(\alpha = 0{,}05\)) und 2,576 bei 99 %. Einseitig ist es \(z_\alpha\) (1,645 bei 5 %). |
| \(d_L,\ d_U\) | d Index L, d Index U | Unter- und Obergrenze (englisch „lower“ und „upper“) des Konfidenzintervalls für die Differenz: die beiden Enden des Bereichs, in dem die wahre Differenz wahrscheinlich liegt. |
Begriffe
| A/B-Test | Ein Experiment, das Besuchern im selben Zeitraum zufällig das Original (A) oder eine geänderte Variante (B) zeigt und die Ergebnisse vergleicht. Weit verbreitet bei Websites, Anzeigen und E-Mails. Die zufällige Aufteilung sorgt dafür, dass alle anderen Einflüsse (Wochentag, Traffic-Quelle usw.) in beiden Gruppen gleich sind. |
| Conversion-Rate (CVR) | Der Anteil der Besuche (Klicks), die zu einem Erfolg (Conversion) wie Kauf oder Anmeldung geführt haben. Eine einzelne Conversion-Rate berechnen oder zurückrechnen Sie auf der Seite „Conversion-Rate berechnen“. |
| Nullhypothese | Die Hypothese, die der Test widerlegen will: „A und B haben in Wahrheit dieselbe Conversion-Rate“ (\(p_A = p_B\)). Der Test prüft, wie unwahrscheinlich die beobachtete Differenz wäre, wenn sie stimmt. |
| Alternativhypothese | Die Hypothese, die Sie zeigen wollen, das Gegenstück zur Nullhypothese (auch Gegenhypothese). Beim zweiseitigen Test „A und B unterscheiden sich“ (\(p_A \neq p_B\)), beim einseitigen Test „B ist höher als A“ (\(p_B > p_A\)). |
| Signifikanzniveau | Die vor dem Test festgelegte Grenze – liegt der p-Wert darunter, wird die Nullhypothese abgelehnt. Üblich sind 5 %, für einen strengeren Test 1 %. „Signifikant bei 5 %“ heißt: „Die Wahrscheinlichkeit einer so großen Differenz ohne echten Unterschied liegt unter 5 %.“ |
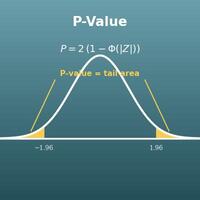
| p-Wert | Die Wahrscheinlichkeit, dass eine mindestens so große Differenz zufällig auftritt, wenn die Nullhypothese (kein Unterschied) stimmt. Je kleiner, desto schwerer ist das Ergebnis mit Zufall zu erklären. Achtung – es ist nicht „die Wahrscheinlichkeit, dass B besser ist“ (ein häufiges Missverständnis). |
| statistisch signifikant | Der p-Wert liegt unter dem Signifikanzniveau; die Differenz gilt als schwer mit zufälliger Streuung erklärbar. Das garantiert nicht, dass die Differenz groß oder der Effekt sicher ist – bei sehr vielen Besuchen wird auch eine winzige Differenz signifikant. |
| Teststatistik | Eine einzelne Zahl, die für den Test aus den Daten berechnet wird (auch Prüfgröße). Auf dieser Seite ist es der z-Wert, „Differenz ÷ Standardfehler“. Wie extrem er ist, bestimmt den p-Wert. |
| z-Test für zwei Anteile | Ein Test, der mit der Normalverteilung prüft, ob sich die Anteile (etwa Conversion-Rates) zweier Gruppen unterscheiden. Er ist der grundlegende Weg, die Signifikanz eines A/B-Tests zu beurteilen. Fast dasselbe leistet ein Chi-Quadrat-Test mit einer 2×2-Tabelle; die zweiseitigen p-Werte stimmen überein. |
| Standardfehler | Die Standardabweichung einer Größe aus einer Stichprobe (hier der Differenz der Conversion-Rates) – wie stark sie je nach Stichprobe zufällig schwankt. Sie sinkt mit der Wurzel der Besuche; für einen halb so großen Standardfehler braucht man also viermal so viele Besuche. |
| Poolen | Die Daten beider Varianten zu einer einzigen geschätzten Conversion-Rate zusammenfassen – unter der Annahme, dass es keinen Unterschied gibt (vom englischen „pool“, zusammenlegen). Der Standardfehler für den Test verwendet diesen gepoolten Wert. |
| Konfidenzintervall | Der Bereich, in dem die wahre Differenz wahrscheinlich liegt. Ein 95-%-Konfidenzintervall wird so gebildet, dass bei vielfacher Wiederholung des Experiments 95 % dieser Intervalle die wahre Differenz enthalten. Enthält das Intervall die 0 nicht, stimmt das fast immer mit Signifikanz im zweiseitigen Test bei 5 % überein. |
| zweiseitiger Test | Ein Test auf „gibt es einen Unterschied (egal, welche Variante höher liegt)?“. Er ist richtig für einen gewöhnlichen A/B-Test, bei dem offen ist, in welche Richtung es geht. |
| einseitiger Test | Ein Test mit festgelegter Richtung, etwa „ist B höher als A?“ (so lautet dann die Alternativhypothese). Sein p-Wert ist halb so groß wie der zweiseitige und wird daher leichter signifikant – nutzen Sie ihn nur, wenn Sie die Richtung vor dem Test festgelegt haben. |
| Ablehnungsbereich | Der Randbereich der Standard-Normalverteilung: Landet der z-Wert dort, wird die Nullhypothese abgelehnt (verworfen). Zweiseitig bei 5 % sind es die beiden Ränder \(z < -1{,}96\) und \(z > 1{,}96\) mit einer Gesamtfläche von 0,05 – der gefärbte Teil des Graphen auf dieser Seite. |
| kritischer Wert | Der z-Wert an der Grenze des Ablehnungsbereichs. 1,96 zweiseitig bei 5 %, 2,576 zweiseitig bei 1 % und 1,645 einseitig bei 5 %. Der „Abstand des z-Werts“ im Ergebnis zeigt, wie weit Ihr z-Wert über (oder unter) dem kritischen Wert liegt. |
| Normalapproximation | Die Zahl der Conversions folgt eigentlich einer Binomialverteilung, bei vielen Besuchen lässt sie sich aber gut durch eine Normalverteilung (Glockenkurve) annähern. Der z-Test nutzt diese Näherung; als Faustregel sollten die erwarteten Conversions \(n\hat{p}\) und die erwarteten Nicht-Conversions \(n(1-\hat{p})\) jeder Variante mindestens 5 betragen (besser 10). |
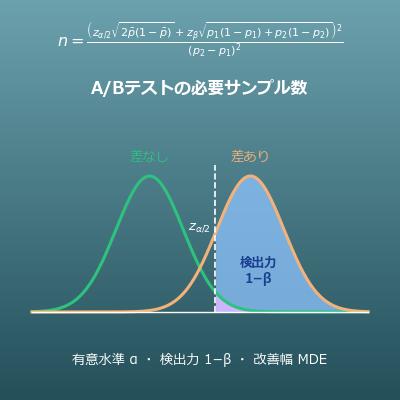
| Teststärke (Power) | Die Wahrscheinlichkeit, dass der Test einen echten Unterschied als signifikant erkennt. Bei wenigen Besuchen ist die Teststärke gering, und selbst ein echter Effekt kommt oft als „nicht signifikant“ heraus. „Nicht signifikant“ beweist nicht „kein Unterschied“. |
| Fehler 1. Art | Ein Ergebnis für signifikant halten, obwohl es keinen Unterschied gibt (falsch positiv, α-Fehler). Das Signifikanzniveau \(\alpha\) ist die Wahrscheinlichkeit, die Sie für diesen Fehler in Kauf nehmen; bei 5 % heißt das: „Von 100 Tests ohne echten Unterschied sind etwa 5 zufällig signifikant.“ |
| multiples Testen | Viele Varianten oder Kennzahlen gleichzeitig testen (Problem der Alpha-Fehler-Kumulierung). Selbst bei einem Signifikanzniveau von 5 % ist von 20 Kennzahlen wahrscheinlich eine zufällig „signifikant“. Sie müssen die Kennzahlen vorab eingrenzen oder ein strengeres Signifikanzniveau verwenden (Bonferroni-Korrektur u. a.). |
| Peeking (vorzeitiger Testabbruch) | Während des Tests immer wieder auf das Ergebnis schauen und abbrechen, sobald es signifikant aussieht. Der p-Wert schwankt während eines Tests auf und ab; wer „beim ersten Mal unter 5 % aufhört“, treibt die Wahrscheinlichkeit einer Signifikanz ohne echten Unterschied weit über 5 %. Grundregel – die nötigen Besuche vorab festlegen und warten, bis sie erreicht sind. |
| relativer Uplift | Um wie viel Prozent die Conversion-Rate von B gegenüber der von A gestiegen ist: die Differenz \(d\) geteilt durch die Conversion-Rate von A, mal 100 (auch Lift). „25 % mehr“ lässt sich leichter in zusätzliche Conversions und Umsatz umrechnen als „0,5 Prozentpunkte mehr“. |
| Prozentpunkte | Die Einheit für das Ergebnis einer Subtraktion zweier Prozentangaben. Man sagt „2,5 % − 2 % = 0,5 Prozentpunkte“; „0,5 %“ könnte als „0,5 % von 2 %“ missverstanden werden. |
Das sollten Sie vorher wissen
Damit Sie die Berechnung auf dieser Seite mit Verständnis nutzen und nicht nur auf den Knopf drücken, hilft Ihnen Folgendes.
Kommen Sie nicht weiter, ist es am schnellsten, diese Themen noch einmal zu wiederholen.
| Prozentrechnung (Klasse 6–7, 11–13 Jahre) |
|
| Kehrwerte und Quadratwurzeln (Klasse 6–9, 11–15 Jahre) |
|
| Normalverteilung und Standardabweichung (Oberstufe Stochastik, 16–18 Jahre) |
|
| Die Logik des Hypothesentests (Oberstufe Stochastik, 16–18 Jahre) |
|
| Binomialverteilung und ihre Normalapproximation (Oberstufe Stochastik, 16–18 Jahre) |
|
So berechnen Sie es in Excel
| Besuche A n_A | 10000 |
| Conversions A x_A | 200 |
| Besuche B n_B | 10000 |
| Conversions B x_B | 250 |
| Conversion-Rate A p̂_A | =B2/B1 |
| Conversion-Rate B p̂_B | =B4/B3 |
| Conversion-Rate A p̂_A | 0,02 |
| Conversion-Rate B p̂_B | 0,025 |
| Differenz d | =B2-B1 |
| Relativer Uplift L (%) | =B3/B1*100 |
| Conversions A x_A | 200 |
| Conversions B x_B | 250 |
| Besuche A n_A | 10000 |
| Besuche B n_B | 10000 |
| Gepoolte Conversion-Rate p̂ | =(B1+B2)/(B3+B4) |
| Gepoolte Conversion-Rate p̂ | 0,0225 |
| Besuche A n_A | 10000 |
| Besuche B n_B | 10000 |
| Differenz d | 0,005 |
| Standardfehler SE | =WURZEL(B1*(1-B1)*(1/B2+1/B3)) |
| z-Wert z | =B4/B5 |
| z-Wert z | 2,384 |
| Zweiseitiger p-Wert p₂ | =2*(1-NORM.S.VERT(ABS(B1);WAHR)) |
| Einseitiger p-Wert p₁ | =1-NORM.S.VERT(B1;WAHR) |
| Conversion-Rate A p̂_A | 0,02 |
| Besuche A n_A | 10000 |
| Conversion-Rate B p̂_B | 0,025 |
| Besuche B n_B | 10000 |
| Differenz d | 0,005 |
| Konfidenzniveau (0,95 = 95 %) | 0,95 |
| z_(α/2) | =NORM.S.INV(1-(1-B6)/2) |
| Standardfehler SE_d | =WURZEL(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| Untergrenze d_L | =B5-B7*B8 |
| Obergrenze d_U | =B5+B7*B8 |
In der ersten Tabelle zeigt B5 die Conversion-Rate von A (0,02) und B6 die von B (0,025). Die zweite Tabelle liefert eine Differenz von 0,005 (0,5 Prozentpunkte) und einen Uplift von 25, die dritte eine gepoolte Conversion-Rate von 0,0225 und die vierte einen Standardfehler von etwa 0,002097 und einen z-Wert von etwa 2,384.
In der fünften Tabelle liefert NORM.S.VERT(z;WAHR) die kumulierte Wahrscheinlichkeit Φ(z) der Standardnormalverteilung; der zweiseitige p-Wert beträgt etwa 0,0171, der einseitige etwa 0,0086. In der sechsten Tabelle ermittelt NORM.S.INV aus einer kumulierten Wahrscheinlichkeit den z-Wert (1,96 bei einem Konfidenzniveau von 95 %); daraus ergeben sich eine Untergrenze von etwa 0,0009 und eine Obergrenze von etwa 0,0091 (0,09 bis 0,91 Prozentpunkte).
So berechnen Sie es in Google Tabellen
| Besuche A n_A | 10000 |
| Conversions A x_A | 200 |
| Besuche B n_B | 10000 |
| Conversions B x_B | 250 |
| Conversion-Rate A p̂_A | =B2/B1 |
| Conversion-Rate B p̂_B | =B4/B3 |
| Conversion-Rate A p̂_A | 0,02 |
| Conversion-Rate B p̂_B | 0,025 |
| Differenz d | =B2-B1 |
| Relativer Uplift L (%) | =B3/B1*100 |
| Conversions A x_A | 200 |
| Conversions B x_B | 250 |
| Besuche A n_A | 10000 |
| Besuche B n_B | 10000 |
| Gepoolte Conversion-Rate p̂ | =(B1+B2)/(B3+B4) |
| Gepoolte Conversion-Rate p̂ | 0,0225 |
| Besuche A n_A | 10000 |
| Besuche B n_B | 10000 |
| Differenz d | 0,005 |
| Standardfehler SE | =WURZEL(B1*(1-B1)*(1/B2+1/B3)) |
| z-Wert z | =B4/B5 |
| z-Wert z | 2,384 |
| Zweiseitiger p-Wert p₂ | =2*(1-STANDNORMVERT(ABS(B1))) |
| Einseitiger p-Wert p₁ | =1-STANDNORMVERT(B1) |
| Conversion-Rate A p̂_A | 0,02 |
| Besuche A n_A | 10000 |
| Conversion-Rate B p̂_B | 0,025 |
| Besuche B n_B | 10000 |
| Differenz d | 0,005 |
| Konfidenzniveau (0,95 = 95 %) | 0,95 |
| z_(α/2) | =STANDNORMINV(1-(1-B6)/2) |
| Standardfehler SE_d | =WURZEL(B1*(1-B1)/B2+B3*(1-B3)/B4) |
| Untergrenze d_L | =B5-B7*B8 |
| Obergrenze d_U | =B5+B7*B8 |
So berechnen Sie es in Python
import math

visits_a, conversions_a = 10000, 200   # Besuche und Conversions A
visits_b, conversions_b = 10000, 250   # Besuche und Conversions B
alpha = 0.05                           # Signifikanzniveau (5 %)

def normal_cdf(z):
    # Verteilungsfunktion Φ(z) der Standardnormalverteilung
    return 0.5 * math.erfc(-z / math.sqrt(2))

def normal_ppf(p):
    # Umkehrfunktion von Φ (Bisektion; für z_(α/2))
    low, high = -10.0, 10.0
    for _ in range(100):
        mid = (low + high) / 2
        if normal_cdf(mid) < p:
            low = mid
        else:
            high = mid
    return (low + high) / 2

cvr_a = conversions_a / visits_a
cvr_b = conversions_b / visits_b
diff = cvr_b - cvr_a
lift = diff / cvr_a * 100
pooled = (conversions_a + conversions_b) / (visits_a + visits_b)
se_pooled = math.sqrt(pooled * (1 - pooled) * (1 / visits_a + 1 / visits_b))
z = diff / se_pooled
p_two_sided = 2 * (1 - normal_cdf(abs(z)))
p_one_sided = 1 - normal_cdf(z)

se_diff = math.sqrt(cvr_a * (1 - cvr_a) / visits_a + cvr_b * (1 - cvr_b) / visits_b)
z_half = normal_ppf(1 - alpha / 2)
ci_low, ci_high = diff - z_half * se_diff, diff + z_half * se_diff

print(f"Conversion-Rate A: {cvr_a * 100:.2f} %  Conversion-Rate B: {cvr_b * 100:.2f} %")
print(f"Differenz: {diff * 100:.2f} Prozentpunkte  Relativer Uplift: {lift:.1f} %")
print(f"z-Wert: {z:.3f}  zweiseitiger p-Wert: {p_two_sided:.4f}  einseitiger p-Wert: {p_one_sided:.4f}")
print("Ergebnis (zweiseitig):", "statistisch signifikant" if p_two_sided < alpha else "nicht statistisch signifikant")
print(f"{(1 - alpha) * 100:.0f}-%-Konfidenzintervall der Differenz: {ci_low * 100:.2f} bis {ci_high * 100:.2f} Prozentpunkte")
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
p̂_A = x_A ÷ n_A
\hat{p}_A = \dfrac{x_A}{n_A}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
    <mo>=</mo>
    <mfrac>
      <msub><mi>x</mi><mi>A</mi></msub>
      <msub><mi>n</mi><mi>A</mi></msub>
    </mfrac>
  </mrow>
</math>
hat(p)_A = x_A / n_A
xA/nA
pA := xA/nA;
pA = xA/nA;
p̂_A = x_A/n_A
d = p̂_B − p̂_A, L = d ÷ p̂_A × 100
d = \hat{p}_B - \hat{p}_A, \quad L = \dfrac{d}{\hat{p}_A} \times 100
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>=</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub>
<mo>−</mo>
<msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub>
<mo>,</mo><mspace width="1em"/>
<mi>L</mi><mo>=</mo>
<mfrac><mi>d</mi><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mfrac>
<mo>×</mo><mn>100</mn>
</mrow>
</math>
d = hat(p)_B - hat(p)_A, L = d / hat(p)_A xx 100
d = pB - pA; d/pA*100
d := pB - pA; L := d/pA*100;
d = pB - pA; L = d/pA*100;
d = p̂_B − p̂_A, L = d/p̂_A × 100
p̂ = (x_A + x_B) ÷ (n_A + n_B)
\hat{p} = \dfrac{x_A + x_B}{n_A + n_B}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mover accent="true"><mi>p</mi><mo>^</mo></mover>
    <mo>=</mo>
    <mfrac>
      <mrow><msub><mi>x</mi><mi>A</mi></msub><mo>+</mo><msub><mi>x</mi><mi>B</mi></msub></mrow>
      <mrow><msub><mi>n</mi><mi>A</mi></msub><mo>+</mo><msub><mi>n</mi><mi>B</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
hat(p) = (x_A + x_B) / (n_A + n_B)
(xA + xB)/(nA + nB)
pPool := (xA + xB)/(nA + nB);
pPool = (xA + xB)/(nA + nB);
p̂ = (x_A + x_B)/(n_A + n_B)
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d ÷ SE
\mathrm{SE} = \sqrt{\hat{p}(1-\hat{p})\left(\dfrac{1}{n_A}+\dfrac{1}{n_B}\right)}, \quad z = \dfrac{d}{\mathrm{SE}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi><mo>=</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub></mrow>
<msqrt>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
<mo>(</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>A</mi></msub></mfrac>
<mo>+</mo>
<mfrac><mn>1</mn><msub><mi>n</mi><mi>B</mi></msub></mfrac>
<mo>)</mo>
</msqrt>
</mfrac>
</mrow>
</math>
SE = sqrt(hat(p)(1 - hat(p))(1/n_A + 1/n_B)), z = d / SE
se = Sqrt[pPool*(1 - pPool)*(1/nA + 1/nB)]; z = d/se
SE := sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z := d/SE;
SE = sqrt(pPool*(1 - pPool)*(1/nA + 1/nB)); z = d/SE;
SE = √(p̂(1 − p̂)(1/n_A + 1/n_B)), z = d/SE
p₂ = 2(1 − Φ(|z|)), p₁ = 1 − Φ(z)
p_2 = 2\left(1 - \Phi(|z|)\right), \quad p_1 = 1 - \Phi(z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>p</mi><mn>2</mn></msub><mo>=</mo>
<mn>2</mn><mo>(</mo><mn>1</mn><mo>−</mo>
<mi>Φ</mi><mo>(</mo><mo>|</mo><mi>z</mi><mo>|</mo><mo>)</mo><mo>)</mo>
<mo>,</mo><mspace width="1em"/>
<msub><mi>p</mi><mn>1</mn></msub><mo>=</mo>
<mn>1</mn><mo>−</mo><mi>Φ</mi><mo>(</mo><mi>z</mi><mo>)</mo>
</mrow>
</math>
p_2 = 2(1 - Phi(|z|)), p_1 = 1 - Phi(z)
p2 = 2*(1 - CDF[NormalDistribution[0, 1], Abs[z]]); p1 = 1 - CDF[NormalDistribution[0, 1], z]
p2 := 2*(1 - Statistics:-CDF(Normal(0, 1), abs(z))); p1 := 1 - Statistics:-CDF(Normal(0, 1), z);
p2 = 2*(1 - normcdf(abs(z))); p1 = 1 - normcdf(z);
p_2 = 2(1 − Φ(|z|)), p_1 = 1 − Φ(z)
d ± z_(α/2) × √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
d \pm z_{\alpha/2}\sqrt{\dfrac{\hat{p}_A(1-\hat{p}_A)}{n_A}+\dfrac{\hat{p}_B(1-\hat{p}_B)}{n_B}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>d</mi><mo>±</mo>
<msub><mi>z</mi><mrow><mi>α</mi><mo>/</mo><mn>2</mn></mrow></msub>
<msqrt>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>A</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>A</mi></msub>
</mfrac>
<mo>+</mo>
<mfrac>
<mrow><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>(</mo><mn>1</mn><mo>−</mo><msub><mover accent="true"><mi>p</mi><mo>^</mo></mover><mi>B</mi></msub><mo>)</mo></mrow>
<msub><mi>n</mi><mi>B</mi></msub>
</mfrac>
</msqrt>
</mrow>
</math>
d +- z_(alpha/2) sqrt((hat(p)_A(1 - hat(p)_A))/n_A + (hat(p)_B(1 - hat(p)_B))/n_B)
seD = Sqrt[pA*(1 - pA)/nA + pB*(1 - pB)/nB]; {d - zHalf*seD, d + zHalf*seD}
seD := sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); [d - zHalf*seD, d + zHalf*seD];
seD = sqrt(pA*(1 - pA)/nA + pB*(1 - pB)/nB); ci = [d - zHalf*seD, d + zHalf*seD];
d ± z_(α/2) √(p̂_A(1 − p̂_A)/n_A + p̂_B(1 − p̂_B)/n_B)
So lassen Sie ChatGPT rechnen
Sie sind ein Rechenassistent für Statistik (Hypothesentests). Führen Sie die folgende Berechnung aus, indem Sie tatsächlich Python-Code ausführen, und stützen Sie Ihre Antwort ausschließlich auf die Zahlen aus dem Ausführungsergebnis (nicht im Kopf rechnen und nicht schätzen).

Die Ergebnisse des A/B-Tests lauten:
- Variante A: 10000 Besuche, 200 Conversions
- Variante B: 10000 Besuche, 250 Conversions
Ermitteln Sie Folgendes:
1. Die Conversion-Rate jeder Variante (%), die Differenz der Conversion-Rates (Prozentpunkte) und den relativen Uplift (%)
2. Die gepoolte Conversion-Rate und den gepoolten Standardfehler SE = √(p̂(1−p̂)(1/n_A + 1/n_B))
3. Den z-Wert = Differenz ÷ SE sowie den zwei- und den einseitigen p-Wert (Standardnormalverteilung)
4. Ob die Differenz bei einem Signifikanzniveau von 5 % (zweiseitig) statistisch signifikant ist
5. Das 95-%-Konfidenzintervall der Differenz (mit dem Standardfehler aus den Conversion-Rates der einzelnen Varianten, √(p̂_A(1−p̂_A)/n_A + p̂_B(1−p̂_B)/n_B))

Verwenden Sie in Python math.erfc (oder scipy.stats.norm) und zeigen Sie die verwendeten Formeln und die Zahlen aus dem Ausführungsergebnis.
Anleitung
-
1Werte eingebenTragen Sie die Zahlen, mit denen Sie rechnen möchten, in die Eingabefelder ein
-
2BerechnenKlicken Sie auf die Schaltfläche „Berechnen“
-
3Ergebnis ansehenDas Ergebnis erscheint sofort. Auf derselben Seite finden Sie auch den Rechenweg und die Erklärung der Formel
Die Vorteile von DataChef

Kein Fachwissen nötig – einfach und intuitiv

Keine persönlichen Daten erforderlich

Die Datei wird nach dem Download automatisch gelöscht


Keine Quellenangabe nötig

Keine vorherige Genehmigung erforderlich
Verwandte Funktionen
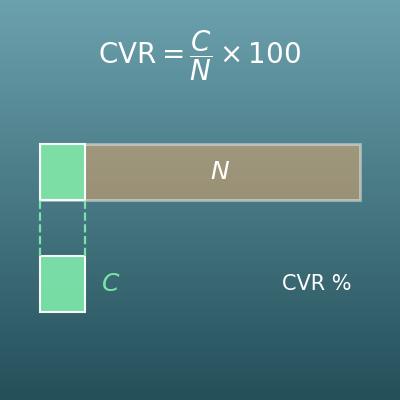
Conversion-Rate berechnen – CVR, nötige Besucher und erwartete Conversions
Berechnet aus zwei der Werte Besuche, Conversions und Conversion-Rate den dritten – wenn Sie nur die Conversion-Rate einer Variante brauchen
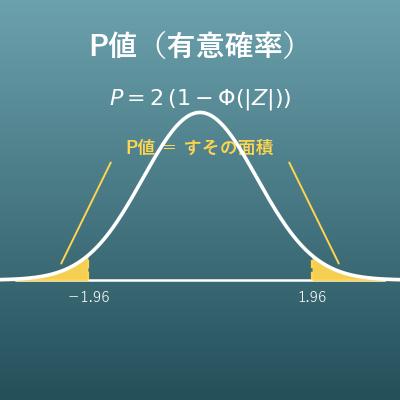
p-Wert berechnen: z-Wert in p-Wert umrechnen und zurück
Rechnet einen vorhandenen z-Wert in einen links-, rechts- oder zweiseitigen p-Wert um. Diese Seite beginnt einen Schritt früher, bei Besuchen und Conversions
Konfidenzintervall berechnen für den Mittelwert
Ermittelt das Konfidenzintervall für einen Mittelwert (Testpunkte, Umsätze usw.) – die Mittelwert-Variante des Konfidenzintervalls für die Differenz auf dieser Seite
Stichprobengröße berechnen – Stichprobenumfang und Fehlertoleranz
Berechnet, wie viele Personen eine Umfrage braucht, um einen Anteil mit einer gewünschten Fehlertoleranz zu schätzen – für die Planung von Umfragen