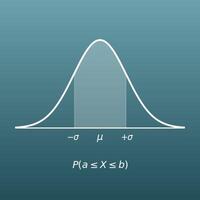
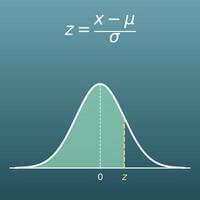
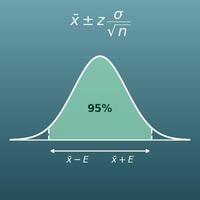
Es gibt zwei Verwendungsarten. ① Geben Sie Konfidenzniveau, Anteil und Fehlertoleranz ein, um die nötige Stichprobengröße zu erhalten. ② Geben Sie Konfidenzniveau, Anteil und Stichprobengröße ein, um die Fehlertoleranz zu erhalten. Die Größe der Grundgesamtheit tragen Sie nur ein, wenn Sie sie kennen.
Inhaltsverzeichnis
-
Das können Sie auf dieser Seite
-
Wofür braucht man diese Berechnung?
-
Anleitung
-
Formel
-
Symbole und Begriffe
-
Das sollten Sie vorher wissen
-
So berechnen Sie es in Excel
-
So berechnen Sie es in Google Tabellen
-
So berechnen Sie es in Python
-
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
-
So lassen Sie ChatGPT rechnen
-
Die Vorteile von DataChef
-
Verwandte Funktionen
-
Alle Rechner von NumberChef
Das können Sie auf dieser Seite
- „Wie viele Personen muss ich befragen, damit das Ergebnis mit 95 % Konfidenzniveau auf ±5 % genau ist?“ – Sie sehen sofort den Stichprobenumfang, den Ihre Umfrage braucht
- Umgekehrt: „Wie genau ist eine Umfrage mit 1.000 Befragten, plus/minus wie viel?“ – auch die Fehlertoleranz berechnen Sie auf derselben Seite
- Kennen Sie die Größe der Grundgesamtheit (500 Beschäftigte, 1.000 Mitglieder usw.), grenzt die Endlichkeitskorrektur die wirklich nötige Zahl weiter ein
- Dazu eine verständliche Erklärung der Formeln sowie fertige Formeln zum Kopieren für Excel, Google Tabellen und Python
Wofür braucht man diese Berechnung?
Für das ZDF-Politbarometer befragt die Forschungsgruppe Wahlen circa 1.300 zufällig ausgewählte Wahlberechtigte – von rund 60 Millionen in Deutschland. Bei 95 % Konfidenzniveau, einer Fehlertoleranz von ±3 % und einem Anteil von 50 % ergibt die Formel einen nötigen Stichprobenumfang von \(1{,}96^2 \times 0{,}25 \div 0{,}03^2 \approx 1067{,}1\) (etwa 1.068 Personen). Umgekehrt haben 1.300 Befragte bei einem Anteil von 50 % eine Fehlertoleranz von etwa ±2,7 Prozentpunkten. Das beantwortet die Frage: „Können gut 1.000 Befragte wirklich zeigen, was 60 Millionen denken?“
Ebenso sieht man: Liegt der Unterschied „45 % gegenüber 47 % Zustimmung“ innerhalb von ±3 Prozentpunkten, lässt sich statistisch nicht sicher sagen, dass es einen Unterschied gibt.
„Wie viele unserer 1.000 Mitglieder müssen wir befragen?“ ist ein typischer Fall für die Endlichkeitskorrektur. Bei 95 % Konfidenzniveau, ±5 % Fehlertoleranz und einem Anteil von 50 % sinkt der Wert vor der Korrektur, 384,16, auf \(384{,}16 \div (1 + 383{,}16 \div 1000) \approx 277{,}7\) (aufgerundet 278 Personen).
Wer vorher festlegt, wie viele Antworten für die gewünschte Genauigkeit reichen, statt alle immer wieder zu erinnern, kann Kosten und Genauigkeit der Umfrage mit Zahlen abwägen.
Auch um den Ausschussanteil massenhaft gefertigter Teile zu schätzen, ohne jedes Teil zu prüfen, nutzt man diese Formel. Lassen bisherige Daten einen Ausschuss von etwa 10 % erwarten, ergeben 90 % Konfidenzniveau und ±4 % Fehlertoleranz \(1{,}65^2 \times 0{,}1 \times 0{,}9 \div 0{,}04^2 \approx 153{,}1\) – eine Stichprobe von etwa 154 Teilen reicht.
Das Beispiel zeigt auch: Je weiter der Anteil von 50 % entfernt ist, desto kleiner ist die Streuung \(\hat{p}(1-\hat{p})\) und desto weniger Teile braucht man.
Bei einer epidemiologischen Studie zum „Anteil der Menschen in einer Region mit diesem Symptom“ muss der Studienplan angeben, wie viele Teilnehmende nötig sind. Lassen frühere Studien eine Häufigkeit von etwa 20 % erwarten, ergeben 95 % Konfidenzniveau und ±3 % Fehlertoleranz \(1{,}96^2 \times 0{,}2 \times 0{,}8 \div 0{,}03^2 \approx 683{,}0\), also etwa 683 Personen.
In der echten klinischen Forschung kommen zusätzlich genauere, zum Studiendesign passende Verfahren hinzu (etwa die Poweranalyse). Diese Formel ist die Grundform, von der sie ausgehen.
Einschaltquoten werden nicht in allen Haushalten gemessen, sondern in einem Panel aus einigen Tausend Haushalten und dann hochgerechnet. Als vereinfachtes Beispiel (die echten Verfahren sind komplizierter) nehmen wir 2.700 Haushalte und eine Sendung, die in 10 % davon läuft. Bei 95 % Konfidenzniveau ist die Fehlertoleranz \(1{,}96 \times \sqrt{0{,}1 \times 0{,}9 \div 2700} \approx 0{,}0113\) (etwa ±1,1 Prozentpunkte).
So erkennt man, dass „der Unterschied zwischen 9,5 % und 10,5 % Quote im Bereich des Fehlers liegen kann“, und liest Zahlen in den Nachrichten einen Schritt genauer.
Formel
Symbole und Begriffe
Symbole
| \(n\) | n | Der Stichprobenumfang (die Stichprobengröße). Bei einer Umfrage ist das die Zahl der Personen, deren Antworten Sie sammeln, bei einer Prüfung die Zahl der geprüften Teile. |
| \(n_0\) | n null | Der berechnete nötige Stichprobenumfang, wenn die Grundgesamtheit als sehr groß gilt – der Wert vor der Endlichkeitskorrektur. |
| \(z\) | z | Der zum Konfidenzniveau passende z-Wert (ein Wert der Standardnormalverteilung). Üblich sind 1,96 für 95 % und 2,58 für 99 %. |
| \(\hat{p}\) | p Dach | Der Anteil (etwa der gesuchte Anteil der „Ja“-Antworten). Für den Stichprobenumfang setzt man den erwarteten Wert ein, für die Fehlertoleranz den Anteil, den die Umfrage tatsächlich ergeben hat (den Anteil in der Stichprobe). Man schreibt ihn als Dezimalzahl von 0 bis 1 (50 % = 0,5). |
| \(\varepsilon\) | Epsilon | Die Fehlertoleranz – wie weit das Umfrageergebnis vom wahren Wert abweichen darf. Man gibt sie mit ± an, etwa „±5 %“. |
| \(N\) | großes N | Die Größe der Grundgesamtheit, also die Zahl der Personen oder Teile der ganzen Gruppe, die Sie untersuchen möchten (z. B. alle 500 Beschäftigten). |
Begriffe
| Grundgesamtheit | Die gesamte Gruppe, über die man eigentlich etwas wissen will, etwa „alle Wahlberechtigten in Deutschland“ oder „alle 500 Beschäftigten“. |
| Stichprobe | Der Teil der Grundgesamtheit, den man auswählt, um ihn tatsächlich zu untersuchen. Die Zahl der Personen oder Teile in der Stichprobe heißt Stichprobenumfang. |
| Stichprobenumfang (Stichprobengröße) | Wie viele Personen oder Teile die Stichprobe umfasst, Symbol \(n\). |
| Zufallsstichprobe | Eine Stichprobe, die so ausgewählt wird, dass jede Person der Grundgesamtheit dieselbe Chance hat – wie bei einer Auslosung. Die Formeln dieser Seite setzen eine Zufallsstichprobe voraus und gelten nicht für Umfragen, bei denen nur antwortet, wer möchte. |
| Anteilswert | Der Anteil, den man eigentlich wissen will, etwa der Anteil der „Ja“-Antworten in der ganzen Grundgesamtheit. Den Anteil aus einer Stichprobe nennt man zur Unterscheidung Stichprobenanteil. |
| Konfidenzniveau | Wie sicher man sein kann: Würde man dieselbe Umfrage sehr oft wiederholen, gibt es an, in wie viel Prozent der Fälle das Ergebnis innerhalb der Fehlertoleranz läge. Am häufigsten wird 95 % verwendet. |
| Konfidenzintervall | Der Bereich, den man erhält, wenn man ein Umfrageergebnis mit einer Spanne angibt, etwa „52 % ± 3 % (49 % bis 55 %)“. Die Fehlertoleranz ±ε auf dieser Seite ist diese Spanne. |
| Fehlertoleranz (Fehlermarge) | Wie weit das Umfrageergebnis vom wahren Wert abweichen darf. Das ist gemeint, wenn es bei Umfragen in den Nachrichten heißt „Fehlertoleranz ±3 Prozentpunkte“. |
| Endlichkeitskorrektur | Eine Korrektur, die den nötigen Stichprobenumfang bzw. die Fehlertoleranz verkleinert, wenn bekannt ist, dass die Grundgesamtheit eine begrenzte Größe hat. Sie bildet ab, dass ein Ergebnis umso sicherer ist, je größer der untersuchte Teil der Grundgesamtheit ist. |
Das sollten Sie vorher wissen
Damit Sie die Rechnung auf dieser Seite nicht nur per Knopfdruck, sondern mit Verständnis nutzen, ist hier zusammengefasst, was Sie vorher wissen sollten.
| Prozent und Anteile (Klasse 6–7, 11–13 Jahre) |
|
| Quadratwurzeln (Klasse 8–9, 13–15 Jahre) |
|
| Zufallsstichproben (Klasse 9–10, 14–16 Jahre) |
|
| Normalverteilung und beurteilende Statistik (Oberstufe, 16–19 Jahre) |
|
So berechnen Sie es in Excel
| z-Wert (1,96 für 95 %) | 1,96 |
| Erwarteter Anteil (%) | 50 |
| Fehlertoleranz (%) | 5 |
| Berechneter Wert n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Nötige Stichprobengröße (aufgerundet) | =AUFRUNDEN(B4;0) |
| z-Wert (1,96 für 95 %) | 1,96 |
| Erwarteter Anteil (%) | 50 |
| Fehlertoleranz (%) | 5 |
| Größe der Grundgesamtheit N | 500 |
| Wert vor der Korrektur n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Nötige Stichprobengröße (korrigiert, aufgerundet) | =AUFRUNDEN(B5/(1+(B5-1)/B4);0) |
| z-Wert (1,96 für 95 %) | 1,96 |
| Anteil aus der Umfrage (%) | 60 |
| Stichprobengröße n | 100 |
| Fehlertoleranz (%) | =B1*WURZEL(B2/100*(1-B2/100)/B3)*100 |
| z-Wert (1,96 für 95 %) | 1,96 |
| Anteil aus der Umfrage (%) | 30 |
| Stichprobengröße n | 200 |
| Größe der Grundgesamtheit N | 1000 |
| Fehlertoleranz vor der Korrektur (%) | =B1*WURZEL(B2/100*(1-B2/100)/B3)*100 |
| Korrigierte Fehlertoleranz (%) | =B5*WURZEL((B4-B3)/(B4-1)) |
In der ersten Tabelle erscheint in B4 384,16 und in B5 385. Das Ergebnis der zweiten Tabelle ist 218, der dritten etwa 9,60 (%) und der vierten etwa 5,68 (%).
„^“ steht für eine Potenz (zum Quadrat), „WURZEL“ für die Quadratwurzel und „AUFRUNDEN“ ist die Funktion zum Aufrunden.
Hinweis: Der Rechner auf dieser Seite rundet zur Sicherheit auch dann um 1 auf, wenn der berechnete Wert genau eine ganze Zahl ist. Bei solchen glatten Werten kann er deshalb um 1 von AUFRUNDEN in Excel abweichen.
So berechnen Sie es in Google Tabellen
| z-Wert (1,96 für 95 %) | 1,96 |
| Erwarteter Anteil (%) | 50 |
| Fehlertoleranz (%) | 5 |
| Berechneter Wert n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Nötige Stichprobengröße (aufgerundet) | =AUFRUNDEN(B4;0) |
| z-Wert (1,96 für 95 %) | 1,96 |
| Erwarteter Anteil (%) | 50 |
| Fehlertoleranz (%) | 5 |
| Größe der Grundgesamtheit N | 500 |
| Wert vor der Korrektur n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| Nötige Stichprobengröße (korrigiert, aufgerundet) | =AUFRUNDEN(B5/(1+(B5-1)/B4);0) |
| z-Wert (1,96 für 95 %) | 1,96 |
| Anteil aus der Umfrage (%) | 60 |
| Stichprobengröße n | 100 |
| Fehlertoleranz (%) | =B1*WURZEL(B2/100*(1-B2/100)/B3)*100 |
| z-Wert (1,96 für 95 %) | 1,96 |
| Anteil aus der Umfrage (%) | 30 |
| Stichprobengröße n | 200 |
| Größe der Grundgesamtheit N | 1000 |
| Fehlertoleranz vor der Korrektur (%) | =B1*WURZEL(B2/100*(1-B2/100)/B3)*100 |
| Korrigierte Fehlertoleranz (%) | =B5*WURZEL((B4-B3)/(B4-1)) |
So berechnen Sie es in Python
import math

# Kurztabelle Konfidenzniveau (%) → z-Wert (gebräuchliche gerundete Werte)
z_table = {80: 1.28, 85: 1.44, 90: 1.65, 95: 1.96, 98: 2.33, 99: 2.58}

# ---- Verwendung 1: nötige Stichprobengröße berechnen ----
confidence_level = 95    # Konfidenzniveau (%)
population_ratio = 50    # erwarteter Anteil (%)
margin_of_error = 5      # Fehlertoleranz (%)
population_size = None   # Größe der Grundgesamtheit (None, wenn unbekannt oder sehr groß)

z = z_table[confidence_level]
p = population_ratio / 100
e = margin_of_error / 100

raw_size = z ** 2 * p * (1 - p) / e ** 2   # Wert vor der Korrektur
if population_size is not None:
    raw_size = raw_size / (1 + (raw_size - 1) / population_size)   # Endlichkeitskorrektur
required_size = math.floor(raw_size) + 1   # kleinste ganze Zahl über dem berechneten Wert (zur Sicherheit aufgerundet)
print(f"Nötige Stichprobengröße: {required_size}")

# ---- Verwendung 2: Fehlertoleranz berechnen ----
sample_size = 1000       # tatsächlich befragte Personen
sample_ratio = 50 / 100  # Anteil aus der Umfrage (0.5 für 50 %)

error_ratio = z * math.sqrt(sample_ratio * (1 - sample_ratio) / sample_size)
print(f"Fehlertoleranz: ±{error_ratio * 100:.2f} %")
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
n₀ = z² × p̂(1 − p̂) ÷ ε²
n_0 = \dfrac{z^2 \, \hat{p}(1-\hat{p})}{\varepsilon^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>n</mi><mn>0</mn></msub>
<mo>=</mo>
<mfrac>
<mrow>
<msup><mi>z</mi><mn>2</mn></msup>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<msup><mi>ε</mi><mn>2</mn></msup>
</mfrac>
</mrow>
</math>
n_0 = (z^2 hat(p)(1 - hat(p)))/(epsilon^2)
z^2*p*(1 - p)/err^2
n0 := z^2*p*(1 - p)/err^2;
n0 = z^2*p*(1 - p)/err^2;
n_0 = (z^2 p̂(1 − p̂))/ε^2
n = n₀ ÷ (1 + (n₀ − 1) ÷ N)
n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msub><mi>n</mi><mn>0</mn></msub>
<mrow>
<mn>1</mn><mo>+</mo>
<mfrac>
<mrow><msub><mi>n</mi><mn>0</mn></msub><mo>−</mo><mn>1</mn></mrow>
<mi>N</mi>
</mfrac>
</mrow>
</mfrac>
</mrow>
</math>
n = n_0/(1 + (n_0 - 1)/N)
n0/(1 + (n0 - 1)/nPop)
n := n0/(1 + (n0 - 1)/N);
n = n0/(1 + (n0 - 1)/N);
n = n_0/(1 + (n_0 − 1)/N)
ε = z × √(p̂(1 − p̂) ÷ n)
\varepsilon = z \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<mi>z</mi>
<msqrt>
<mfrac>
<mrow>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<mi>n</mi>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = z sqrt((hat(p)(1 - hat(p)))/n)
z*Sqrt[p*(1 - p)/n]
err := z*sqrt(p*(1 - p)/n);
err = z*sqrt(p*(1 - p)/n);
ε = z√((p̂(1 − p̂))/n)
ε = ε₀ × √((N − n) ÷ (N − 1))
\varepsilon = \varepsilon_0 \sqrt{\dfrac{N-n}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<msub><mi>ε</mi><mn>0</mn></msub>
<msqrt>
<mfrac>
<mrow><mi>N</mi><mo>−</mo><mi>n</mi></mrow>
<mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = epsilon_0 sqrt((N - n)/(N - 1))
err0*Sqrt[(nPop - n)/(nPop - 1)]
err := err0*sqrt((N - n)/(N - 1));
err = err0*sqrt((N - n)/(N - 1));
ε = ε_0 √((N − n)/(N − 1))
So lassen Sie ChatGPT rechnen
Sie sind ein Rechenassistent für statistische Erhebungen. Führen Sie die folgende Berechnung aus, indem Sie tatsächlich Python-Code ausführen, und stützen Sie Ihre Antwort nur auf die Zahlen aus dem Ausführungsergebnis (nicht im Kopf rechnen oder schätzen).

Ein Dienst mit 1.000 Mitgliedern führt eine Zufriedenheitsumfrage durch. Verwenden Sie ein Konfidenzniveau von 95 % (z-Wert 1,96), einen erwarteten Anteil von 50 % und eine Fehlertoleranz von ±5 %.
Bestimmen Sie:
1. Die nötige Stichprobengröße, wenn die Grundgesamtheit als sehr groß gilt (berechneter Wert und aufgerundete Personenzahl)
2. Die nötige Stichprobengröße mit Endlichkeitskorrektur für eine Grundgesamtheit von 1.000
3. Die Fehlertoleranz (mit Endlichkeitskorrektur, in %), wenn nur 200 Personen antworten

Zeigen Sie die verwendeten Formeln und die Zahlen aus dem Ausführungsergebnis.
Anleitung
-
1Werte eingebenTragen Sie die Zahlen, mit denen Sie rechnen möchten, in die Eingabefelder ein
-
2BerechnenKlicken Sie auf die Schaltfläche „Berechnen“
-
3Ergebnis ansehenDas Ergebnis erscheint sofort. Auf derselben Seite finden Sie auch den Rechenweg und die Erklärung der Formel
Die Vorteile von DataChef

Kein Fachwissen nötig – einfach und intuitiv

Keine persönlichen Daten erforderlich

Die Datei wird nach dem Download automatisch gelöscht


Keine Quellenangabe nötig

Keine vorherige Genehmigung erforderlich
Verwandte Funktionen
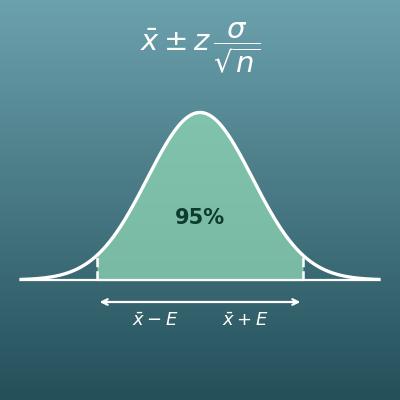
Konfidenzintervall berechnen für den Mittelwert
Berechnet ein Konfidenzintervall (z. B. das 95-%-Konfidenzintervall) für den Mittelwert
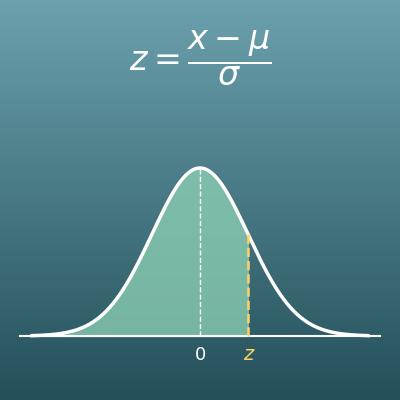
z-Wert berechnen: z-Transformation und Wahrscheinlichkeit in beide Richtungen
Berechnet den z-Wert aus Wert, Mittelwert und Standardabweichung und rechnet ihn in eine Wahrscheinlichkeit um und zurück
Normalverteilung berechnen – Wahrscheinlichkeit für einen Bereich
Berechnet aus Mittelwert und Standardabweichung die Wahrscheinlichkeit für einen Bereich
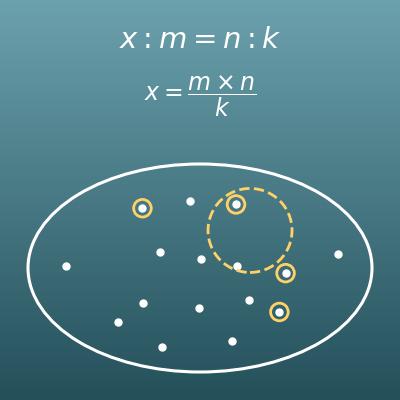
Fang-Wiederfang-Methode und Hochrechnung aus einer Stichprobe
Vom Ergebnis einer Stichprobe auf die Grundgesamtheit schließen, wie in der Schule (diese Seite plant dagegen die Umfrage – wie groß die Stichprobe sein muss). Mit Rückfangmethode für Fische im Teich