Der Rechner kann dreierlei: ① den z-Wert aus Messwert, Mittelwert und Standardabweichung berechnen, ② zwischen z-Wert und Wahrscheinlichkeit umrechnen (nur ein Feld ausfüllen), ③ die Wahrscheinlichkeit zwischen zwei z-Werten berechnen. Füllen Sie nur die Felder der gewünschten Gruppe aus.
Inhaltsverzeichnis
-
Das können Sie auf dieser Seite
-
Wofür braucht man diese Berechnung?
-
Anleitung
-
Formeln und Graphen
-
Symbole und Begriffe
-
Das sollten Sie vorher wissen
-
So berechnen Sie es in Excel
-
So berechnen Sie es in Google Tabellen
-
So berechnen Sie es in Python
-
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
-
So lassen Sie ChatGPT rechnen
-
Die Vorteile von DataChef
-
Verwandte Funktionen
-
Alle Rechner von NumberChef
Das können Sie auf dieser Seite
- Messwert \(x\), Mittelwert \(\mu\) und Standardabweichung \(\sigma\) eingeben – und Sie erhalten den z-Wert (Standardwert) und die Wahrscheinlichkeit für einen kleineren Wert auf einmal
- Statt in der z-Tabelle (Tabelle der Standardnormalverteilung) nachzuschlagen, rechnen Sie z-Werte und Wahrscheinlichkeiten in beide Richtungen um (vom z-Wert zur Wahrscheinlichkeit und zurück)
- Auch die Wahrscheinlichkeit zwischen zwei z-Werten (z. B. zwischen −1,96 und 1,96) berechnen Sie sofort
- Dazu eine verständliche Erklärung der Formeln sowie fertige Formeln zum Kopieren für Excel, Google Tabellen und Python
Wofür braucht man diese Berechnung?
In einem Test mit dem Mittelwert 65 und der Standardabweichung 5 entsprechen 75 Punkte \(z = 2\). Sind die Ergebnisse normalverteilt, gehören Sie damit etwa zu den besten 2,3 % (\(1 - \Phi(2) \approx 0{,}0228\)) – das ist ein Prozentrang von rund 97,7. Intelligenztests und viele psychologische Tests rechnen genau so: IQ \(= 100 + 15 \times z\) und T-Wert \(= 50 + 10 \times z\). Dieselbe Position entspricht also einem IQ von 130 bzw. einem T-Wert von 70.
Das ist die bekannteste Anwendung von z-Werten: aus einer Rohpunktzahl einen Prozentrang machen und erkennen, wie groß ein Unterschied von ein paar Punkten wirklich ist – auch zwischen Tests mit verschiedenen Höchstpunktzahlen und Durchschnitten.
„80 Punkte in Englisch (Mittelwert 70, Standardabweichung 10)“ und „65 Punkte in Mathe (Mittelwert 50, Standardabweichung 15)“ – nach Rohpunkten wirkt Englisch besser, als z-Werte liegen aber beide bei \(z = 1\), also an derselben Stelle.
Auch wenn Einheiten, Höchstpunktzahlen oder die Strenge der Bewertung verschieden sind, lassen sich Ergebnisse mit z-Werten fair danach vergleichen, wie weit sie über der Gruppe liegen. Dieselbe Idee steckt hinter der Normierung von Testergebnissen und der Vereinheitlichung von Bewertungen in Personalbeurteilungen.
In der Kinderheilkunde werden Größe und Gewicht oft als SDS (Standard Deviation Score) angegeben. Das ist nichts anderes als ein z-Wert: Er sagt, wie viele Standardabweichungen (SD) ein Kind vom Durchschnitt gleichaltriger Kinder entfernt ist. Die Perzentilkurven im Kinderuntersuchungsheft zeigen dasselbe in anderer Form; die 3. und die 97. Perzentile liegen bei etwa \(z = \pm 1{,}88\).
Außerhalb von ±2 SDS (\(z = \pm 2\)) liegen jeweils nur etwa 2,3 % der Kinder. Werte dort sind ein Anlass, genauer hinzusehen – ob Handlungsbedarf besteht, entscheidet die Ärztin oder der Arzt aber erst nach dem Verlauf über mehrere Untersuchungen, denn Kinder wachsen unterschiedlich schnell. Wer weiß, was eine SDS-Angabe oder eine Perzentile bedeutet, versteht die Erklärungen bei der U-Untersuchung leichter.
Maße und Gewichte von Produkten streuen oft ähnlich einer Normalverteilung. Rechnet man die obere und die untere Toleranzgrenze in z-Werte um, lässt sich der Ausschussanteil abschätzen. Liegen die Grenzen bei Mittelwert \(\pm 3\sigma\), fallen etwa 0,3 % heraus (\(2 \times (1 - \Phi(3)) \approx 0{,}0027\)).
Auch der Name der Qualitätsmethode „Six Sigma“ stammt von dieser Idee (wie viele σ entfernt).
Banken und Vermögensverwalter messen das Verlustrisiko ihrer Bestände mit der Kennzahl Value at Risk (VaR). Nimmt man an, dass die Renditen einer Normalverteilung folgen, liegt die Grenze „mit 99 % Wahrscheinlichkeit bleibt der Verlust darunter“ beim z-Wert \(\Phi^{-1}(0{,}99) \approx 2{,}33\), also 2,33 Standardabweichungen vom Mittelwert entfernt.
Diese Umrechnung von der Wahrscheinlichkeit zum z-Wert steckt in den Risikoberechnungen von Finanzinstituten auf der ganzen Welt.
Formeln und Graphen
Symbole und Begriffe
Symbole
| \(z\) | z (z-Wert) | Zahl, die angibt, wie viele Standardabweichungen ein Wert vom Mittelwert entfernt ist; berechnet mit \(z = (x - \mu) \div \sigma\). Positive Werte liegen über dem Mittelwert, negative darunter. Einen z-Wert, den Sie selbst vorgeben (wie bei ② und ③), schreibt diese Seite mit großem \(Z\). |
| \(x\) | x | Der gemessene Wert, etwa eine Punktzahl oder eine Körpergröße – der Ausgangswert, den Sie in einen z-Wert umrechnen möchten. |
| \(\mu\) | My | Der Mittelwert, also die Lage der Mitte des Gipfels der Verteilung. Ein griechischer Buchstabe, der unserem m entspricht. |
| \(\sigma\) | Sigma | Die Standardabweichung, also wie stark die Daten streuen. Je größer sie ist, desto flacher und breiter der Gipfel. Ein griechischer Buchstabe, der unserem s entspricht. |
| \(\Phi(Z)\) | Phi von Z | Die Verteilungsfunktion der Standardnormalverteilung (Mittelwert 0, Standardabweichung 1). Sie liefert die Wahrscheinlichkeit für einen Wert unter \(Z\), also die Fläche unter der Kurve links von \(Z\). |
| \(\Phi^{-1}\) | Phi hoch minus eins (Umkehrfunktion von Φ) | Die Umkehrfunktion von \(\Phi\). Sie nimmt eine Wahrscheinlichkeit (Fläche) und liefert den passenden z-Wert (Beispiel: \(\Phi^{-1}(0{,}975) \approx 1{,}96\)). |
| \(Z_1,\ Z_2\) | Z eins, Z zwei | Die beiden z-Werte, die Sie bei ③ eingeben. \(Z_1\) ist die linke (kleinere), \(Z_2\) die rechte (größere) Grenze. |
Begriffe
| z-Wert (Standardwert) | Zahl ohne Einheit, die angibt, wie viele Standardabweichungen ein Wert vom Mittelwert entfernt ist. Auch Standardwert oder (englisch) z-Score genannt. Ihr größter Vorteil – Daten mit unterschiedlichen Einheiten oder Höchstpunktzahlen lassen sich auf derselben Skala vergleichen. |
| z-Transformation (Standardisierung) | Das Umrechnen eines Ausgangswerts in einen z-Wert. Nach der Standardisierung lassen sich Daten aus jeder Normalverteilung mit einer einzigen Standardnormalverteilung (Mittelwert 0, Standardabweichung 1) behandeln. |
| Standardnormalverteilung | Die Normalverteilung mit Mittelwert 0 und Standardabweichung 1. Sie ist die Verteilung der z-Werte und dient als gemeinsamer Maßstab für Wahrscheinlichkeiten bei jeder Normalverteilung. |
| Normalverteilung | Verteilung, die symmetrisch um den Mittelwert in Form einer Glocke streut (Gaußsche Glockenkurve). Viele reale Daten wie Testergebnisse, Körpergrößen oder das Gewicht von Produkten kommen dieser Form nahe. |
| Verteilungsfunktion | Funktion, die die Wahrscheinlichkeit für diesen Wert oder einen kleineren angibt (auch kumulative Verteilungsfunktion). Bei der Standardnormalverteilung schreibt man sie \(\Phi\) (Phi). Sie summiert die Fläche links unter der Kurve auf (kumuliert sie). |
| Tabelle der Standardnormalverteilung (z-Tabelle) | Tabelle, die zu jedem z-Wert den Wert (die Fläche) von \(\Phi\) angibt. Sie steht in Formelsammlungen und im Anhang von Statistikbüchern. Teil ② dieses Rechners ersetzt die z-Tabelle. |
| T-Wert | Ein z-Wert, umgerechnet auf Mittelwert 50 und 10 Punkte je Standardabweichung (T-Wert \(= 50 + 10 \times z\)). Er wird in psychologischen und pädagogischen Tests verwendet. Der IQ funktioniert genauso, mit Mittelwert 100 und 15 Punkten je Standardabweichung. |
Das sollten Sie vorher wissen
Hier steht, was Ihnen hilft, die Berechnung auf dieser Seite wirklich zu verstehen – nicht nur auf den Knopf zu drücken.
| Der Mittelwert (Klasse 5–6, 10–12 Jahre) |
|
| Rechnen mit negativen Zahlen (Klasse 6–7, 11–13 Jahre) |
|
| Streuung und Standardabweichung (Klasse 9 bis Oberstufe, 14–18 Jahre) |
|
| Die Normalverteilung und Flächen unter der Kurve (Oberstufe, Stochastik, 16–18 Jahre) |
|
So berechnen Sie es in Excel
| Messwert x | 75 |
| Mittelwert μ | 65 |
| Standardabw. σ | 5 |
| z-Wert | =(B1-B2)/B3 |
| z-Wert Z | 2 |
| P(x<Z) | =NORM.S.VERT(B1;WAHR) |
| z-Wert Z | 1,96 |
| Φ(Z) | =NORM.S.VERT(B1;WAHR) |
| Wahrscheinlichkeit zwischen −Z und Z | =2*B2-1 |
| Linke Grenze Z1 | -1 |
| Rechte Grenze Z2 | 0 |
| Φ(Z1) | =NORM.S.VERT(B1;WAHR) |
| Φ(Z2) | =NORM.S.VERT(B2;WAHR) |
| Wahrscheinlichkeit zwischen Z1 und Z2 | =B4-B3 |
In der ersten Tabelle ändern Sie Messwert, Mittelwert und Standardabweichung (B1 bis B3), und B4 zeigt den z-Wert (mit den Beispielwerten 2). Die zweite Tabelle berechnet aus dem z-Wert (B1) die Wahrscheinlichkeit (B2); mit dem Beispielwert ist B2 etwa 0,97725 (97,7 %).
Geben Sie in der dritten Tabelle den z-Wert 1,96 ein, erhalten Sie die Wahrscheinlichkeit zwischen −1,96 und 1,96 (B3) von etwa 0,95 (95 %). Die vierte Tabelle liefert die Wahrscheinlichkeit zwischen zwei z-Werten; mit den Beispielwerten (−1 und 0) ist B5 etwa 0,34134 (34,1 %).
Für den umgekehrten Weg, von einer Wahrscheinlichkeit zum z-Wert, nehmen Sie „=NORM.S.INV(Wahrscheinlichkeit)“ (Beispiel: `=NORM.S.INV(0,975)` ergibt etwa 1,95996).
So berechnen Sie es in Google Tabellen
| Messwert x | 75 |
| Mittelwert μ | 65 |
| Standardabw. σ | 5 |
| z-Wert | =(B1-B2)/B3 |
| z-Wert Z | 2 |
| P(x<Z) | =STANDNORMVERT(B1) |
| z-Wert Z | 1,96 |
| Φ(Z) | =STANDNORMVERT(B1) |
| Wahrscheinlichkeit zwischen −Z und Z | =2*B2-1 |
| Linke Grenze Z1 | -1 |
| Rechte Grenze Z2 | 0 |
| Φ(Z1) | =STANDNORMVERT(B1) |
| Φ(Z2) | =STANDNORMVERT(B2) |
| Wahrscheinlichkeit zwischen Z1 und Z2 | =B4-B3 |
Die Ergebnisse sind dieselben wie in Excel: Die erste Tabelle ergibt aus 75, 65 und 5 den z-Wert 2, die zweite aus dem z-Wert 2 die Wahrscheinlichkeit von etwa 0,97725.
Um aus einer Wahrscheinlichkeit den z-Wert zu bestimmen, nehmen Sie „=STANDNORMINV(Wahrscheinlichkeit)“ (Beispiel: `=STANDNORMINV(0,975)` ergibt etwa 1,95996).
So berechnen Sie es in Python
import math

def phi(z):
    # Verteilungsfunktion der Standardnormalverteilung Φ(z) (berechnet mit der Fehlerfunktion erf)
    return 0.5 * (1 + math.erf(z / math.sqrt(2)))

x = 75       # Messwert
mean = 65    # Mittelwert
sd = 5       # Standardabweichung

z_score = (x - mean) / sd             # z-Wert
p_less_than_z = phi(z_score)          # Wahrscheinlichkeit für einen Wert unter dem z-Wert, P(x<Z)

z = 1.96
p_between_minus_z_and_z = 2 * phi(z) - 1   # Wahrscheinlichkeit zwischen -z und z

z1, z2 = -1, 0
p_between_z1_z2 = phi(z2) - phi(z1)        # Wahrscheinlichkeit zwischen z1 und z2

print(f"z-Wert: {z_score}")
print(f"P(x<Z): {p_less_than_z}")
print(f"Wahrscheinlichkeit zwischen -z und z: {p_between_minus_z_and_z}")
print(f"Wahrscheinlichkeit zwischen z1 und z2: {p_between_z1_z2}")
So schreiben Sie die Formel in LaTeX und anderen Formelsprachen (zum Kopieren)
z = (x − μ) ÷ σ
z = \dfrac{x - \mu}{\sigma}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>z</mi>
<mo>=</mo>
<mfrac>
<mrow><mi>x</mi><mo>−</mo><mi>μ</mi></mrow>
<mi>σ</mi>
</mfrac>
</mrow>
</math>
z = (x - mu)/sigma
(x - mu)/sigma
z := (x - mu)/sigma;
z = (x - mu)/sigma;
z = (x-μ)/σ
P(x<Z) = Φ(Z)
P(x<Z) = \Phi(Z)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>x</mi><mo><</mo><mi>Z</mi><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo>
</mrow>
</math>
P(x<Z) = Phi(Z)
CDF[NormalDistribution[0, 1], Z]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), Z);
p = normcdf(Z);
P(x<Z) = Φ(Z)
P(−Z<x<Z) = 2Φ(Z) − 1
P(-Z<x<Z) = 2\Phi(Z) - 1
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mo>−</mo><mi>Z</mi><mo><</mo><mi>x</mi><mo><</mo><mi>Z</mi><mo>)</mo>
<mo>=</mo>
<mn>2</mn><mi>Φ</mi><mo>(</mo><mi>Z</mi><mo>)</mo><mo>−</mo><mn>1</mn>
</mrow>
</math>
P(-Z<x<Z) = 2 Phi(Z) - 1
2 CDF[NormalDistribution[0, 1], Z] - 1
with(Statistics): 2*CDF(RandomVariable(Normal(0, 1)), Z) - 1;
p = 2*normcdf(Z) - 1;
P(-Z<x<Z) = 2Φ(Z) - 1
P(Z₁<x<Z₂) = Φ(Z₂) − Φ(Z₁)
P(Z_1<x<Z_2) = \Phi(Z_2) - \Phi(Z_1)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><msub><mi>Z</mi><mn>1</mn></msub><mo><</mo><mi>x</mi><mo><</mo><msub><mi>Z</mi><mn>2</mn></msub><mo>)</mo>
<mo>=</mo>
<mi>Φ</mi><mo>(</mo><msub><mi>Z</mi><mn>2</mn></msub><mo>)</mo>
<mo>−</mo>
<mi>Φ</mi><mo>(</mo><msub><mi>Z</mi><mn>1</mn></msub><mo>)</mo>
</mrow>
</math>
P(Z_1<x<Z_2) = Phi(Z_2) - Phi(Z_1)
CDF[NormalDistribution[0, 1], Z2] - CDF[NormalDistribution[0, 1], Z1]
with(Statistics): CDF(RandomVariable(Normal(0, 1)), Z2) - CDF(RandomVariable(Normal(0, 1)), Z1);
p = normcdf(Z2) - normcdf(Z1);
P(Z1<x<Z2) = Φ(Z2) - Φ(Z1)
So lassen Sie ChatGPT rechnen
Sie sind ein Assistent für statistische Berechnungen. Führen Sie die folgende Berechnung aus, indem Sie tatsächlich Python-Code ausführen, und stützen Sie Ihre Antwort ausschließlich auf die Zahlen aus dem Ausführungsergebnis (nicht im Kopf rechnen und nicht schätzen).

Jemand hat in einem Test mit dem Mittelwert 65 Punkte und der Standardabweichung 5 Punkte 75 Punkte erreicht.
1. Berechnen Sie den z-Wert dieser Person.
2. Berechnen Sie die Wahrscheinlichkeit für ein Ergebnis unter diesem Wert, P(x<Z) (mit der Verteilungsfunktion Φ der Standardnormalverteilung; die Python-Standardbibliothek, etwa math.erf oder statistics.NormalDist, darf verwendet werden).
3. Berechnen Sie außerdem die Wahrscheinlichkeit, dass ein z-Wert zwischen −1,96 und 1,96 liegt.

Zeigen Sie die verwendeten Formeln und die Zahlen aus dem Ausführungsergebnis.
Anleitung
-
1Werte eingebenTragen Sie die Zahlen, mit denen Sie rechnen möchten, in die Eingabefelder ein
-
2BerechnenKlicken Sie auf die Schaltfläche „Berechnen“
-
3Ergebnis ansehenDas Ergebnis erscheint sofort. Auf derselben Seite finden Sie auch den Rechenweg und die Erklärung der Formel
Die Vorteile von DataChef

Kein Fachwissen nötig – einfach und intuitiv

Keine persönlichen Daten erforderlich

Die Datei wird nach dem Download automatisch gelöscht


Keine Quellenangabe nötig

Keine vorherige Genehmigung erforderlich
Verwandte Funktionen
Normalverteilung berechnen – Wahrscheinlichkeit für einen Bereich
Berechnet aus Mittelwert und Standardabweichung die Wahrscheinlichkeit für einen Bereich oder den Anteil der obersten Prozent
Standardabweichung berechnen für Grundgesamtheit und Stichprobe
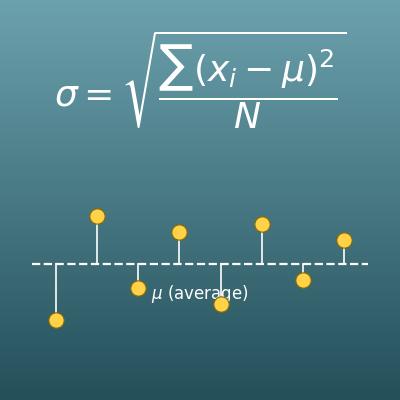
Berechnet aus einer Liste von Zahlen die Standardabweichung von Grundgesamtheit und Stichprobe, die Varianz und den Mittelwert
Wahrscheinlichkeit zweier unabhängiger Ereignisse berechnen
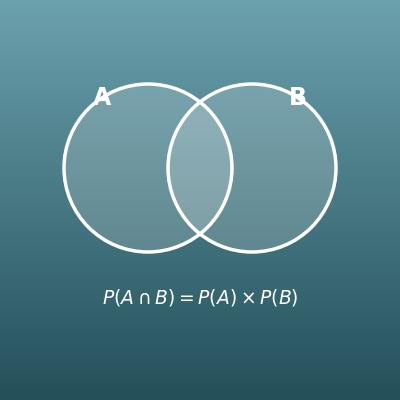
Berechnet aus zwei Wahrscheinlichkeiten, wie wahrscheinlich beide eintreten, mindestens eines eintritt und mehr