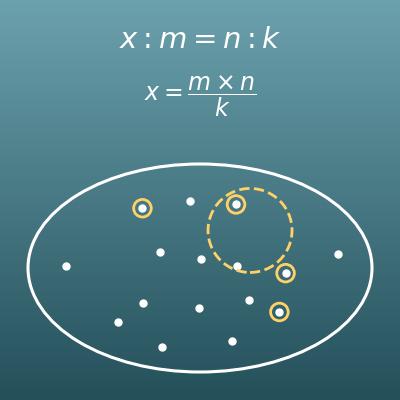
使い方は2つあります。①信頼水準・母比率・許容誤差を入れて「必要なサンプルサイズ」を求める ②信頼水準・母比率・サンプルサイズを入れて「許容誤差」を求める。母集団の大きさは、わかっている場合だけ入力してください。
このページでできること
- 「信頼水準95%・誤差±5%で調べるには何人にアンケートすればよいか」——調査に必要なサンプルサイズ(標本の大きさ)がその場でわかります
- 逆に「1000人に調査した結果は±何%まで信頼できるか」——許容誤差(マージン・オブ・エラー)も同じページで計算できます
- 母集団の大きさがわかっている場合(社員500人・会員1000人など)は、有限母集団補正で「本当に必要な人数」まで絞り込めます
- 式のやさしい解説・Excel/Googleスプレッドシート/Python用のコピペ数式・計算ドリル(演習問題)もこのページにまとまっています
この計算は何の役に立つ?
新聞やテレビの世論調査は、全国の有権者(約1億人)から1000〜2000人程度を無作為に選んで行われます。信頼水準95%・許容誤差±3%・母比率50%で計算すると、必要サンプルサイズは \(1.96^2 \times 0.25 \div 0.03^2 \fallingdotseq 1067.1\)(約1068人)——「たった1000人で1億人の意見がわかるの?」という疑問に、この式が根拠を与えています。
逆に「支持率45%と47%の差」が誤差±3ポイントの範囲内なら、統計的には差があるとは言い切れない、という読み方もできるようになります。
「会員1000人のうち何人に聞けば十分か」は、有限母集団補正まで使う典型例です。信頼水準95%・許容誤差±5%・母比率50%なら、補正前の計算値384.16が \(384.16 \div (1 + 383.16 \div 1000) \fallingdotseq 277.7\)(切り上げて278人)まで減ります。
全員に督促を重ねる前に「何人集まれば目的の精度に足りるか」を先に決めておくと、調査のコストと精度のバランスを数字で判断できます。
大量生産された部品の不良率を全数検査せずに見積もるときにも、この式が使われます。過去の実績から不良率10%前後と想定し、信頼水準90%・許容誤差±4%で計算すると \(1.65^2 \times 0.1 \times 0.9 \div 0.04^2 \fallingdotseq 153.1\)(約154個)の抜き取りで足ります。
母比率が50%から離れるほどばらつき \(\hat{p}(1-\hat{p})\) が小さくなり、必要な個数が減ることも、この例からわかります。
「ある地域でこの症状を持つ人の割合」を調べる疫学調査では、研究計画の段階で必要な対象者数を明示することが求められます。先行研究から有病率20%前後と想定し、信頼水準95%・許容誤差±3%とすると \(1.96^2 \times 0.2 \times 0.8 \div 0.03^2 \fallingdotseq 683.0\)(約683人)が目安になります。
なお、実際の臨床研究では研究デザインに応じたより精密な方法(検出力分析など)が併用されます。この式はその出発点になる基本形です。
関東地区のテレビ視聴率は約2700世帯の調査から推定されています(世帯数は調査会社の公表値で、実際の調査手法はより複雑です)。単純化した目安として、視聴率10%の番組を信頼水準95%で考えると、許容誤差は \(1.96 \times \sqrt{0.1 \times 0.9 \div 2700} \fallingdotseq 0.0113\)(±約1.1%)。
「視聴率9.5%と10.5%の差は誤差の範囲かもしれない」といった見方ができるようになり、数字のニュースを一歩深く読めます。
式
用語・記号の解説
記号
| \(n\) | エヌ | サンプルサイズ(標本の大きさ)。アンケートなら実際に回答を集める人数、検査なら調べる個数です。 |
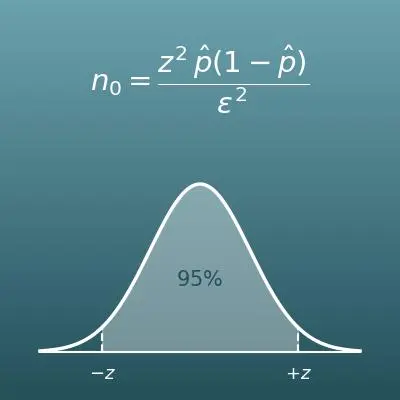
| \(n_0\) | エヌゼロ | 母集団を十分大きいとみなした場合の、必要サンプルサイズの計算値。有限母集団補正をする前の値です。 |
| \(z\) | ゼット | 信頼水準に対応するzスコア(標準正規分布の値)。信頼水準95%なら1.96、99%なら2.58が慣用の値です。 |
| \(\hat{p}\) | ピーハット ピーのハット | 母比率(調べたい「はい」の割合など)。サンプルサイズを求めるときは「想定する値」を、許容誤差を求めるときは「調査で実際に得られた比率(標本比率)」を入れます。0〜1の小数で表します(50%なら0.5)。 |
| \(\varepsilon\) | イプシロン | 許容誤差(マージン・オブ・エラー)。調査結果と本当の値のずれとして許す幅で、「±5%」のように±付きで示されます。 |
| \(N\) | エヌ(大文字) | 母集団の大きさ。調べたい集団全体の人数・個数です(例:全社員500人)。 |
用語
| 母集団 | ぼしゅうだん | 本当に知りたい対象の全体のこと。「全国の有権者全員」「全社員500人」などです。 |
| 標本 (サンプル) |
ひょうほん | 母集団の中から実際に調べるために選び出した一部のこと。標本の人数・個数をサンプルサイズ(標本の大きさ)と呼びます。 |
| 無作為抽出 | むさくいちゅうしゅつ | くじ引きのように、母集団の全員が同じ確率で選ばれるように標本を選ぶこと。このページの式は無作為抽出が前提で、「答えたい人だけが答える」アンケートには使えません。 |
| 母比率 | ぼひりつ | 母集団全体での「はい」の割合など、本当に知りたい比率のこと。標本から得た比率は「標本比率」と呼んで区別します。 |
| 信頼水準 | しんらいすいじゅん | 「同じ調査を何回もくり返したとき、そのうち何%で結果が誤差の範囲に収まるか」という確かさの度合い。95%が最もよく使われます。 |
| 信頼区間 | しんらいくかん | 調査結果を「52% ± 3%(49%〜55%)」のように幅を持たせて示したときの、その範囲のこと。このページの許容誤差±εがその幅にあたります。 |
| 許容誤差 (マージン・オブ・エラー) |
きょようごさ | 調査結果と本当の値のずれとして許す幅。ニュースの世論調査で「誤差±3ポイント」と書かれているのがこれです。 |
| 有限母集団補正 | ゆうげんぼしゅうだんほせい | 母集団の大きさが有限だとわかっているときに、必要サンプルサイズや許容誤差を小さめに直す補正。母集団の大部分を調べるほど結果が確かになることを反映しています。 |
前提として理解しておくといいこと
このページの計算を「意味がわかって」使えるようになるために、前提として理解しておくといいことをまとめました。
| 百分率・割合(小学5年) |
|
| 平方根(中学3年) |
|
| 標本調査(中学3年) |
|
| 正規分布と統計的な推測(高校 数学B) |
|
Excelで計算する方法
| zスコア(信頼水準95%なら1.96) | 1.96 |
| 想定する母比率(%) | 50 |
| 許容誤差(%) | 5 |
| 計算値 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 必要なサンプルサイズ(切り上げ) | =ROUNDUP(B4,0) |
| zスコア(信頼水準95%なら1.96) | 1.96 |
| 想定する母比率(%) | 50 |
| 許容誤差(%) | 5 |
| 母集団の大きさ N | 500 |
| 補正前の計算値 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 必要なサンプルサイズ(補正+切り上げ) | =ROUNDUP(B5/(1+(B5-1)/B4),0) |
| zスコア(信頼水準95%なら1.96) | 1.96 |
| 調査で得られた比率(%) | 60 |
| サンプルサイズ n | 100 |
| 許容誤差(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| zスコア(信頼水準95%なら1.96) | 1.96 |
| 調査で得られた比率(%) | 30 |
| サンプルサイズ n | 200 |
| 母集団の大きさ N | 1000 |
| 補正前の許容誤差(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| 補正後の許容誤差(%) | =B5*SQRT((B4-B3)/(B4-1)) |
1つ目の表ならB4に384.16、B5に385と表示されます。2つ目の表の答えは218、3つ目は約9.60(%)、4つ目は約5.68(%)です。
「^」はべき乗(2乗)、「SQRT」は平方根、「ROUNDUP」は切り上げの関数です。
なお、このページの計算機は計算値がちょうど整数のときも安全側に1つ多く丸めるため、切りのよい計算値ではExcelのROUNDUPと1だけ差が出ることがあります。
Googleスプレッドシートで計算する方法
| zスコア(信頼水準95%なら1.96) | 1.96 |
| 想定する母比率(%) | 50 |
| 許容誤差(%) | 5 |
| 計算値 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 必要なサンプルサイズ(切り上げ) | =ROUNDUP(B4,0) |
| zスコア(信頼水準95%なら1.96) | 1.96 |
| 想定する母比率(%) | 50 |
| 許容誤差(%) | 5 |
| 母集団の大きさ N | 500 |
| 補正前の計算値 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 必要なサンプルサイズ(補正+切り上げ) | =ROUNDUP(B5/(1+(B5-1)/B4),0) |
| zスコア(信頼水準95%なら1.96) | 1.96 |
| 調査で得られた比率(%) | 60 |
| サンプルサイズ n | 100 |
| 許容誤差(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| zスコア(信頼水準95%なら1.96) | 1.96 |
| 調査で得られた比率(%) | 30 |
| サンプルサイズ n | 200 |
| 母集団の大きさ N | 1000 |
| 補正前の許容誤差(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| 補正後の許容誤差(%) | =B5*SQRT((B4-B3)/(B4-1)) |
Pythonで計算する方法
import math

# 信頼水準(%)→zスコアの早見表(慣用の丸め値)
z_table = {80: 1.28, 85: 1.44, 90: 1.65, 95: 1.96, 98: 2.33, 99: 2.58}

# ---- 使い方①:必要なサンプルサイズを求める ----
confidence_level = 95    # 信頼水準(%)
population_ratio = 50    # 想定する母比率(%)
margin_of_error = 5      # 許容誤差(%)
population_size = None   # 母集団の大きさ(わからない・十分大きい場合は None)

z = z_table[confidence_level]
p = population_ratio / 100
e = margin_of_error / 100

raw_size = z ** 2 * p * (1 - p) / e ** 2   # 補正前の計算値
if population_size is not None:
    raw_size = raw_size / (1 + (raw_size - 1) / population_size)   # 有限母集団補正
required_size = math.floor(raw_size) + 1   # 計算値を超える最小の整数(安全側に切り上げ)
print(f"必要なサンプルサイズ: {required_size}")

# ---- 使い方②:許容誤差を求める ----
sample_size = 1000       # 実際に調査したサンプルサイズ
sample_ratio = 50 / 100  # 調査で得られた比率(50%なら0.5)

error_ratio = z * math.sqrt(sample_ratio * (1 - sample_ratio) / sample_size)
print(f"許容誤差: ±{error_ratio * 100:.2f}%")
数式記述言語(LaTeX等)での書き方(コピペ可)
n₀ = z² × p̂(1 − p̂) ÷ ε²
n_0 = \dfrac{z^2 \, \hat{p}(1-\hat{p})}{\varepsilon^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>n</mi><mn>0</mn></msub>
<mo>=</mo>
<mfrac>
<mrow>
<msup><mi>z</mi><mn>2</mn></msup>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<msup><mi>ε</mi><mn>2</mn></msup>
</mfrac>
</mrow>
</math>
n_0 = (z^2 hat(p)(1 - hat(p)))/(epsilon^2)
z^2*p*(1 - p)/err^2
n0 := z^2*p*(1 - p)/err^2;
n0 = z^2*p*(1 - p)/err^2;
n_0 = (z^2 p̂(1 − p̂))/ε^2
n = n₀ ÷ (1 + (n₀ − 1) ÷ N)
n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msub><mi>n</mi><mn>0</mn></msub>
<mrow>
<mn>1</mn><mo>+</mo>
<mfrac>
<mrow><msub><mi>n</mi><mn>0</mn></msub><mo>−</mo><mn>1</mn></mrow>
<mi>N</mi>
</mfrac>
</mrow>
</mfrac>
</mrow>
</math>
n = n_0/(1 + (n_0 - 1)/N)
n0/(1 + (n0 - 1)/nPop)
n := n0/(1 + (n0 - 1)/N);
n = n0/(1 + (n0 - 1)/N);
n = n_0/(1 + (n_0 − 1)/N)
ε = z × √(p̂(1 − p̂) ÷ n)
\varepsilon = z \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<mi>z</mi>
<msqrt>
<mfrac>
<mrow>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<mi>n</mi>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = z sqrt((hat(p)(1 - hat(p)))/n)
z*Sqrt[p*(1 - p)/n]
err := z*sqrt(p*(1 - p)/n);
err = z*sqrt(p*(1 - p)/n);
ε = z√((p̂(1 − p̂))/n)
ε = ε₀ × √((N − n) ÷ (N − 1))
\varepsilon = \varepsilon_0 \sqrt{\dfrac{N-n}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<msub><mi>ε</mi><mn>0</mn></msub>
<msqrt>
<mfrac>
<mrow><mi>N</mi><mo>−</mo><mi>n</mi></mrow>
<mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = epsilon_0 sqrt((N - n)/(N - 1))
err0*Sqrt[(nPop - n)/(nPop - 1)]
err := err0*sqrt((N - n)/(N - 1));
err = err0*sqrt((N - n)/(N - 1));
ε = ε_0 √((N − n)/(N − 1))
ChatGPT に聞いて計算してもらう方法
あなたは統計調査の計算アシスタントです。次の計算を、必ずPythonコードを実際に実行して行い、実行結果の数値だけを根拠に回答してください(暗算や推測で答えないでください)。

会員1000人のサービスで満足度アンケートを行います。信頼水準95%(zスコア1.96)、想定する母比率50%、許容誤差±5%とします。
次の値をそれぞれ求めてください。
1. 母集団を十分大きいとみなした場合の必要サンプルサイズ(計算値と切り上げ後の人数)
2. 母集団1000人として有限母集団補正をした場合の必要サンプルサイズ
3. 仮に200人しか回答が集まらなかった場合の許容誤差(有限母集団補正込み、%)

計算に使った式と、実行結果の数値を示してください。
計算ドリル(演習問題)
このページの式を、自分の手で計算できるようになるための演習問題です。計算しやすいように、zスコアは2(信頼水準約95%)としています。
答えと解説は解答ページにあります。
使い方
-
1数値を入力計算したい数値を入力欄に入力します
-
2計算「計算する」ボタンを押します
-
3結果を確認計算結果がその場に表示されます。計算の考え方や式の解説も同じページで確認できます
DataChefの特徴

専門知識不要、直感的で簡単な操作
個人情報を登録することなく使用できます
「ダウンロード」押下でファイルを自動削除
クレジット表記不要
商用利用許諾の連絡も不要です
関連機能
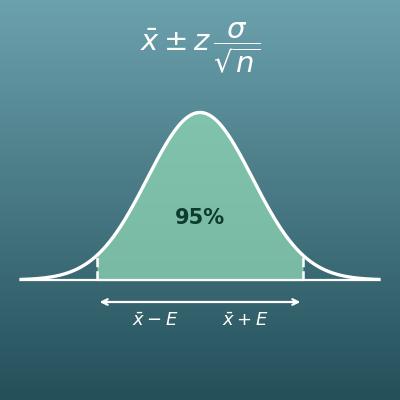
信頼区間計算機
平均や比率の信頼区間(95%信頼区間など)を計算します
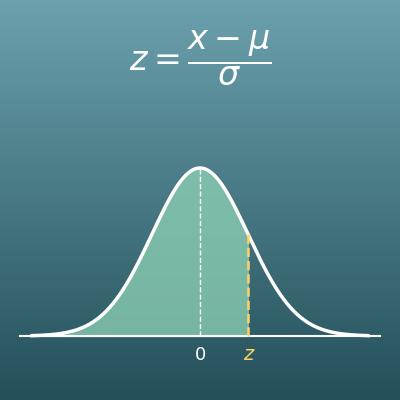
Zスコア計算機(標準得点)
値・平均・標準偏差からzスコアを計算し、確率とも相互変換できます
正規分布の確率
平均と標準偏差から、指定した範囲に入る確率を計算します