































































































































関係を調べたい2種類のデータを、それぞれカンマ(,)区切りで入力してください。相関係数rと共分散、回帰直線の式を計算し、散布図に回帰直線を重ねて描きます。
このページでできること
- \(x\) と \(y\) のペアのデータ(2つの変量)を入れるだけで、相関係数 \(r\) と共分散 \(s_{xy}\) がその場でわかります
- \(x\)・\(y\) それぞれの平均・分散・標準偏差と、回帰直線(最小二乗法)\(y = ax + b\) の式も同時に計算します
- 散布図に回帰直線と平均点を重ねて描くので、2つのデータの関係(右上がりか・右下がりか・ばらばらか)が一目でわかります
- 相関係数の値から「強い正の相関」「ほとんど相関がない」などの目安の解釈も表示します
- 式のやさしい解説・Excel/Googleスプレッドシート/Python用のコピペ数式・計算ドリル(演習問題)もこのページにまとまっています
この計算は何の役に立つ?
「勉強時間を増やすと成績は上がるのか」を、感覚ではなくデータで確かめるのが相関係数の代表的な使い方です。生徒ごとの勉強時間と得点のペアから \(r\) を計算すれば、関係の強さが1つの数字でわかります。
学校や塾では、模試の教科間の相関(数学が得意な生徒は理科も得意か、など)を調べて指導に生かすこともあります。ただし相関があっても「時間さえ増やせば必ず上がる」という因果の証明にはならない点は要注意です。
アイスクリームや冷たい飲み物の売上は気温と正の相関、おでんや肉まんは気温と負の相関を持つことが知られています。小売や飲食の現場では、過去の「気温と販売数」のデータから相関を確かめ、天気予報に合わせて仕入れ量や陳列を変えています。
回帰直線まで求めれば「明日の予想気温30度なら販売数はおよそ何個」という具体的な予測の目安も立てられます。
投資の世界では、株式・債券・金など資産どうしの値動きの相関係数が、分散投資の基本の道具です。相関が低い(または負の)資産を組み合わせると、片方が下がってももう片方が下がりにくいため、資産全体の値動きの振れ幅を抑えられます。
年金基金や投資信託の運用でも、資産配分を決める前に必ず資産間の相関が分析されています。
工場で不良品が増えたとき、「加工温度」「湿度」「機械の稼働時間」などの条件と不良率との相関係数を調べると、どの条件が不良と一緒に動いているかを絞り込めます。品質管理では、この分析に使う散布図が「QC七つ道具」の1つに数えられているほど基本の手法です。
相関が強い条件が見つかったら、実験で条件を変えて因果関係を確かめる、という流れで改善を進めます。
「運動量と血圧」「喫煙量とある病気のかかりやすさ」のように、生活習慣と健康の関係を調べる研究でも、まずデータの相関を確かめるところから始まります。
一方で、相関=原因と早合点しない訓練の場でもあります。有名な例が「アイスクリームの売上と水難事故の件数には正の相関がある」という話で、これはどちらも気温という共通の要因で増えるだけです。医学の研究では、こうした第3の要因の影響を取り除く工夫を重ねて、因果関係に迫っていきます。
式と図
用語・記号の解説
記号
| \(x_i,\ y_i\) | エックスアイ、ワイアイ | \(i\) 組目のデータの \(x\) の値と \(y\) の値。(例:3人目の勉強時間 \(x_3\) と得点 \(y_3\))。\(i\) は index(番号)を表すのによく使われる文字です。 |
| \(n\) | エヌ | データの組数。number(数)の頭文字です。(例:5人分のペアなら \(n = 5\)) |
| \(\bar{x},\ \bar{y}\) | エックスバー、ワイバー | \(x\)・\(y\) それぞれの平均。文字の上の横棒(バー)は「平均」を表す慣例の記号です。 |
| \(x_i - \bar{x}\) | エックスアイ引くエックスバー | \(x\) の偏差。各データが \(x\) の平均からどれだけ離れているか(ずれ)を表します。\(y_i - \bar{y}\) は \(y\) の偏差です。 |
| \(s_{xy}\) | エスエックスワイ | \(x\) と \(y\) の共分散。偏差の積の平均で、2つのデータが一緒に動く傾向を表します。\(s\) は standard deviation(標準偏差)と同じ仲間の統計量であることを表す慣例の文字です。 |
| \(s_x,\ s_y\) | エスエックス、エスワイ | \(x\)・\(y\) それぞれの標準偏差(散らばりの大きさ)。分散の平方根です。 |
| \(s_x^2,\ s_y^2\) | エスエックス2乗、エスワイ2乗 | \(x\)・\(y\) それぞれの分散。偏差の2乗の平均(\(n\) で割る)です。 |
| \(r\) | アール | 相関係数。correlation(相関)や relation(関係)の \(r\) に由来するといわれます。必ず \(-1\) 以上 \(1\) 以下の値になります。 |
| \(\sum\) | シグマ(和の記号) | 「全部足す」という意味の記号。\(\sum_{i=1}^{n}\) は「\(i = 1\) から \(n\) まで全部足す」と読みます。 |
| \(a,\ b\) | エー、ビー | 回帰直線 \(y = ax + b\) の傾きと切片。一次関数と同じ記号です。 |
用語
| 相関 | そうかん | 一方が増えるともう一方も増える(または減る)という、2つのデータの間の直線的な関係の傾向のこと。関係が強いほど散布図の点は直線に近く並びます。 |
| 正の相関 | せいのそうかん | \(x\) が増えると \(y\) も増える傾向のこと。散布図は右上がりになり、相関係数はプラスになります。 |
| 負の相関 | ふのそうかん | \(x\) が増えると \(y\) が減る傾向のこと。散布図は右下がりになり、相関係数はマイナスになります。 |
| 相関係数 | そうかんけいすう | 相関の強さと向きを \(-1\) から \(1\) までの1つの数値で表した指標。共分散を \(x\)・\(y\) の標準偏差の積で割って求めます。単位に影響されないので、違うデータどうしでも強さを比べられます。 |
| 共分散 | きょうぶんさん | \(x\) の偏差と \(y\) の偏差の積の平均。プラスなら右上がり、マイナスなら右下がりの傾向を表します。このページでは日本の教科書と同じく組数 \(n\) で割ります。 |
| 散布図 | さんぷず | ペアのデータ \((x,\ y)\) を座標の点として打った図。点の並び方から、相関の向きと強さがひと目で読み取れます。 |
| 変量 | へんりょう | 身長・点数・気温のように、データとして測る量のこと。このページは \(x\) と \(y\) の「2つの変量」の関係を調べます。 |
| 偏差 | へんさ | 各データと平均との差。プラスなら平均より大きい、マイナスなら小さいことを表します。共分散・分散・標準偏差はすべて偏差から作られます。 |
| 分散 | ぶんさん | 偏差の2乗の平均。データの散らばりの大きさを表します。回帰直線の傾きの分母に登場します。 |
| 標準偏差 | ひょうじゅんへんさ | 分散の平方根。単位がデータと同じに戻るので、散らばりの目安として使いやすい値です。相関係数の分母に登場します。 |
| 回帰直線 | かいきちょくせん | 散布図の点の集まりに最もよく当てはまる直線 \(y = ax + b\) のこと。\(x\) の値から \(y\) の値を予測するのに使います。 |
| 最小二乗法 | さいしょうにじょうほう | 各点と直線との縦方向のずれ(誤差)を2乗して全部足した値が最小になるように、直線の傾きと切片を決める方法。回帰直線はこの方法で決めた直線です。 |
| 外れ値 | はずれち | 他の点から大きく離れた値。相関係数は外れ値の影響を強く受けるため、散布図とセットで確認するのが基本です。 |
| 相関関係 | そうかんかんけい | 2つの量が一緒に動く(一方が増えるともう一方も増える/減る)関係。相関があっても、一方が原因でもう一方が結果だ(因果関係)とは限りません。裏に共通の原因(第3の要因)があるだけのこともあります。 |
| 因果関係 | いんがかんけい | 一方が原因で、もう一方がその結果として決まる関係。相関関係(一緒に動くこと)があるだけでは因果関係は言えず、裏に共通の原因(第3の要因)があるだけのこともあります。 |
前提として理解しておくといいこと
このページの計算を「意味がわかって」使えるようになるために、前提として理解しておくといいことをまとめました。
つまずいたら、この表の内容に戻って復習するのが近道です。
| 平均(小学5年) |
|
| 正負の数(中学1年) |
|
| 座標と一次関数(中学1〜2年) |
|
| 平方根(中学3年) |
|
| データの分析(高校 数学I) |
|
Excelで計算する方法
| xの1組目 | 1 |
| xの2組目 | 2 |
| xの3組目 | 3 |
| xの4組目 | 4 |
| xの5組目 | 5 |
| yの1組目 | 2 |
| yの2組目 | 4 |
| yの3組目 | 4 |
| yの4組目 | 4 |
| yの5組目 | 6 |
| 共分散 s_xy(n で割る) | =COVARIANCE.P(B1:B5,B6:B10) |
| (参考)n−1 で割る標本共分散 | =COVARIANCE.S(B1:B5,B6:B10) |
| xの1組目 | 1 |
| xの2組目 | 2 |
| xの3組目 | 3 |
| xの4組目 | 4 |
| xの5組目 | 5 |
| yの1組目 | 2 |
| yの2組目 | 4 |
| yの3組目 | 4 |
| yの4組目 | 4 |
| yの5組目 | 6 |
| 相関係数 r | =CORREL(B1:B5,B6:B10) |
| (参考)PEARSON関数でも同じ値 | =PEARSON(B1:B5,B6:B10) |
| xの1組目 | 1 |
| xの2組目 | 2 |
| xの3組目 | 3 |
| xの4組目 | 4 |
| xの5組目 | 5 |
| yの1組目 | 2 |
| yの2組目 | 4 |
| yの3組目 | 4 |
| yの4組目 | 4 |
| yの5組目 | 6 |
| 傾き a | =SLOPE(B6:B10,B1:B5) |
| 切片 b | =INTERCEPT(B6:B10,B1:B5) |
| xの1組目 | 1 |
| xの2組目 | 2 |
| xの3組目 | 3 |
| xの4組目 | 4 |
| xの5組目 | 5 |
| yの1組目 | 2 |
| yの2組目 | 4 |
| yの3組目 | 4 |
| yの4組目 | 4 |
| yの5組目 | 6 |
| xの平均 x̄ | =AVERAGE(B1:B5) |
| yの平均 ȳ | =AVERAGE(B6:B10) |
| xの分散 s_x² | =VARP(B1:B5) |
| xの標準偏差 s_x | =STDEVP(B1:B5) |
| yの分散 s_y² | =VARP(B6:B10) |
| yの標準偏差 s_y | =STDEVP(B6:B10) |
1つ目の表の共分散は1.6(標本共分散は2)、2つ目の表の相関係数は約0.8944、3つ目の表は傾き0.8・切片1.6になります。
共分散の関数は2種類あるので注意してください。COVARIANCE.Pが「n で割る」共分散(この計算機・日本の教科書と同じ)、COVARIANCE.Sが「n−1 で割る」標本共分散です。古いExcel(2007以前)ではCOVARIANCE.Pの代わりにCOVARを使います。
相関係数はCORRELでもPEARSONでも同じ値になります(相関係数は n で割っても n−1 で割っても同じ値になるため、関数の使い分けはありません)。
SLOPE・INTERCEPTは「yの範囲, xの範囲」の順で指定します(xが先ではないことに注意)。
データの組数を変えたいときは、数値の行を増やし(減らし)てから、式の「B1:B5」「B6:B10」の部分を実際のデータ範囲に書き換えてください。
Googleスプレッドシートで計算する方法
| xの1組目 | 1 |
| xの2組目 | 2 |
| xの3組目 | 3 |
| xの4組目 | 4 |
| xの5組目 | 5 |
| yの1組目 | 2 |
| yの2組目 | 4 |
| yの3組目 | 4 |
| yの4組目 | 4 |
| yの5組目 | 6 |
| 共分散 s_xy(n で割る) | =COVAR(B1:B5,B6:B10) |
| xの1組目 | 1 |
| xの2組目 | 2 |
| xの3組目 | 3 |
| xの4組目 | 4 |
| xの5組目 | 5 |
| yの1組目 | 2 |
| yの2組目 | 4 |
| yの3組目 | 4 |
| yの4組目 | 4 |
| yの5組目 | 6 |
| 相関係数 r | =CORREL(B1:B5,B6:B10) |
| xの1組目 | 1 |
| xの2組目 | 2 |
| xの3組目 | 3 |
| xの4組目 | 4 |
| xの5組目 | 5 |
| yの1組目 | 2 |
| yの2組目 | 4 |
| yの3組目 | 4 |
| yの4組目 | 4 |
| yの5組目 | 6 |
| 傾き a | =SLOPE(B6:B10,B1:B5) |
| 切片 b | =INTERCEPT(B6:B10,B1:B5) |
Googleスプレッドシートでは、「n で割る」共分散はCOVAR関数で求めます(この計算機・日本の教科書と同じ定義。COVARIANCE.Pという名前でも同じ関数を呼べます)。相関係数はExcelと同じCORRELです。
Pythonで計算する方法
import statistics

xs = [1, 2, 3, 4, 5]      # xのデータ(例:勉強時間)
ys = [2, 4, 4, 4, 6]      # yのデータ(例:小テストの得点)

n = len(xs)
mean_x = statistics.mean(xs)      # xの平均
mean_y = statistics.mean(ys)      # yの平均

# 共分散 s_xy(日本の教科書と同じ「n で割る」定義)
covariance = sum((x - mean_x) * (y - mean_y) for x, y in zip(xs, ys)) / n

sd_x = statistics.pstdev(xs)      # xの標準偏差(n で割る)
sd_y = statistics.pstdev(ys)      # yの標準偏差(n で割る)

r = covariance / (sd_x * sd_y)    # 相関係数

slope = covariance / statistics.pvariance(xs)   # 回帰直線の傾き a
intercept = mean_y - slope * mean_x             # 回帰直線の切片 b

print(f"共分散 s_xy: {covariance}")
print(f"相関係数 r: {r}")
# 切片は浮動小数の誤差(1.5999…)が出ることがあるため、有効10桁に丸めて表示する
print(f"回帰直線: y = {slope:.10g}x + {intercept:.10g}")
数式記述言語(LaTeX等)での書き方(コピペ可)
s_xy = {(x₁ − x̄)(y₁ − ȳ) + … + (xₙ − x̄)(yₙ − ȳ)} ÷ n
s_{xy} = \dfrac{1}{n}\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y})
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
<mo>=</mo>
<mfrac><mn>1</mn><mi>n</mi></mfrac>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>1</mn></mrow>
<mi>n</mi>
</munderover>
<mrow>
<mo>(</mo><msub><mi>x</mi><mi>i</mi></msub><mo>−</mo><mover><mi>x</mi><mo>¯</mo></mover><mo>)</mo>
<mo>(</mo><msub><mi>y</mi><mi>i</mi></msub><mo>−</mo><mover><mi>y</mi><mo>¯</mo></mover><mo>)</mo>
</mrow>
</mrow>
</math>
s_(xy) = (1/n) sum_(i=1)^n (x_i - bar x)(y_i - bar y)
Covariance[xdata, ydata]*(Length[xdata] - 1)/Length[xdata] (* Covarianceは n−1 で割るため、n で割る値に直している *)
s_xy := add((x[i] - x_bar)*(y[i] - y_bar), i = 1 .. n)/n;
s_xy = mean((x - mean(x)).*(y - mean(y)));
s_xy = (1/n) ∑_(i=1)^n (x_i − x̄)(y_i − ȳ)
r = s_xy ÷ (s_x × s_y)
r = \dfrac{s_{xy}}{s_x\, s_y}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>r</mi>
    <mo>=</mo>
    <mfrac>
      <msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
      <mrow><msub><mi>s</mi><mi>x</mi></msub><msub><mi>s</mi><mi>y</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
r = s_(xy) / (s_x s_y)
Correlation[xdata, ydata]
r := s_xy/(s_x*s_y);
R = corrcoef(x, y); r = R(1, 2);
r = s_xy/(s_x s_y)
y = ax + b, a = s_xy ÷ s_x², b = ȳ − a·x̄
y = ax + b, \quad a = \dfrac{s_{xy}}{s_x^{2}}, \quad b = \bar{y} - a\bar{x}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>y</mi><mo>=</mo><mi>a</mi><mi>x</mi><mo>+</mo><mi>b</mi>
<mo>,</mo><mspace width="1em"/>
<mi>a</mi><mo>=</mo>
<mfrac>
<msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
<msubsup><mi>s</mi><mi>x</mi><mn>2</mn></msubsup>
</mfrac>
<mo>,</mo><mspace width="1em"/>
<mi>b</mi><mo>=</mo>
<mover><mi>y</mi><mo>¯</mo></mover>
<mo>−</mo>
<mi>a</mi><mover><mi>x</mi><mo>¯</mo></mover>
</mrow>
</math>
y = a x + b, a = s_(xy)/s_x^2, b = bar y - a bar x
lm = LinearModelFit[Transpose[{xdata, ydata}], t, t]; lm["BestFitParameters"]
a := s_xy/s_x^2; b := y_bar - a*x_bar;
p = polyfit(x, y, 1); % p(1)=傾きa、p(2)=切片b
y = ax + b, a = s_xy/s_x^2, b = ȳ − ax̄
ChatGPT に聞いて計算してもらう方法
あなたは統計計算のアシスタントです。次の計算を、必ずPythonコードを実際に実行して行い、実行結果の数値だけを根拠に回答してください(暗算や推測で答えないでください)。

次のペアのデータについて、以下の値をそれぞれ求めてください。
x: 1, 2, 3, 4, 5
y: 2, 4, 4, 4, 6
1. x・yそれぞれの平均と、n で割る定義の分散・標準偏差
2. 共分散 s_xy(偏差の積の合計をデータの組数 n で割る定義。n−1 では割らないでください)
3. 相関係数 r
4. 回帰直線 y = ax + b の傾き a と切片 b(最小二乗法)

計算に使った式と、実行結果の数値を示してください。
計算ドリル(演習問題)
このページの式を、自分の手で計算できるようになるための演習問題です。
共分散・分散はデータの組数 \(n\) で割る定義で計算します。
答えと解説は解答ページにあります。
使い方
-
1数値を入力計算したい数値を入力欄に入力します
-
2計算「計算する」ボタンを押します
-
3結果を確認計算結果がその場に表示されます。計算の考え方や式の解説も同じページで確認できます
DataChefの特徴

専門知識不要、直感的で簡単な操作

個人情報を登録することなく使用できます

「ダウンロード」押下でファイルを自動削除


クレジット表記不要

商用利用許諾の連絡も不要です
関連機能
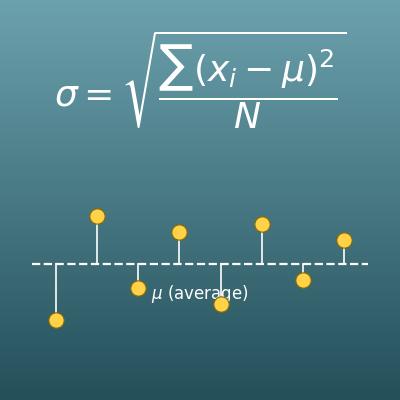
標準偏差計算機(母標準偏差・標本標準偏差)
カンマ区切りの数値から標準偏差・分散・偏差平方和をまとめて計算します
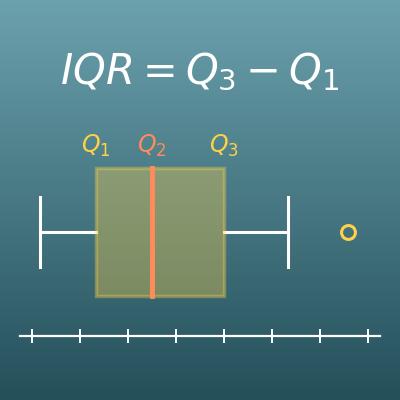
四分位数・箱ひげ図 計算機
データから四分位数Q1・Q2・Q3と四分位範囲を計算し、箱ひげ図を描きます