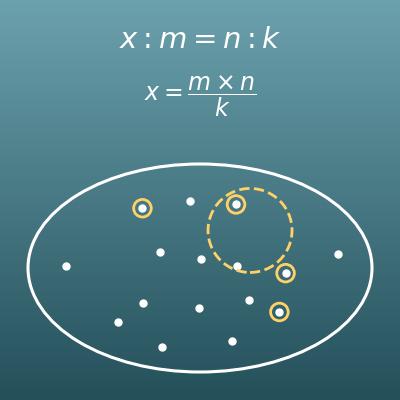































































































































有兩種用法。用法 1:輸入信心水準、母體比例與抽樣誤差,求「需要的樣本數」。用法 2:輸入信心水準、母體比例與樣本數,求「抽樣誤差」。母體大小只有在已知時才需要輸入。
這個頁面可以做什麼
- 「想在 95% 信心水準、抽樣誤差 ±5% 下做調查,要問幾個人?」馬上就能知道調查需要的樣本數
- 反過來,「調查了 1,000 人,結果的誤差是正負多少 %?」抽樣誤差也能在同一個頁面計算
- 已知母體大小時(員工 500 人、會員 1,000 人等),可以用有限母體校正算出「真正需要的人數」
- 這個頁面還整理了公式的淺顯解說,以及可直接複製到 Excel、Google 試算表、Python 使用的公式
這個計算有什麼用?
在台灣,新聞報導的民調通常是從約 1,950 萬名選舉人(2024 年總統大選)中,隨機抽出 1,000~1,100 人左右做電話訪問。在信心水準 95%、抽樣誤差 ±3%、比例 50% 下,需要的樣本數是 \(1.96^2 \times 0.25 \div 0.03^2 \approx 1067.1\)(約 1,068 人)。民調常寫「有效樣本 1,068 份」,原因就在這裡。這條公式也回答了「只問 1,000 人,真的能知道近 2,000 萬人的想法嗎?」這個疑問。
反過來,如果「支持度 45% 和 47% 的差距」落在抽樣誤差正負 3 個百分點以內,就能看出統計上還不能斷定兩者真的有差別。
「1,000 名會員要問幾個人才夠?」是會用到有限母體校正的典型例子。在信心水準 95%、抽樣誤差 ±5%、比例 50% 下,校正前的計算值 384.16 會減少到 \(384.16 \div (1 + 383.16 \div 1000) \approx 277.7\)(無條件進位後 278 人)。
在一再催促所有人填寫之前,先決定「收到多少份就足以達到需要的精確度」,就能用數字權衡調查的成本與精確度。
不必全數檢驗、就要估計大量生產的零件不良率時,也會用到這條公式。如果過去的紀錄顯示不良率約 10%,在信心水準 90%、抽樣誤差 ±4% 下,\(1.65^2 \times 0.1 \times 0.9 \div 0.04^2 \approx 153.1\),所以抽驗約 154 個就夠了。
從這個例子也能看出,比例離 50% 越遠,分散程度 \(\hat{p}(1-\hat{p})\) 越小,需要的個數也越少。
調查「某個地區有這種症狀的人占多少比例」的流行病學研究,在研究計畫階段就必須寫明需要多少受試者。如果過去的研究顯示盛行率約 20%,在信心水準 95%、抽樣誤差 ±3% 下,\(1.96^2 \times 0.2 \times 0.8 \div 0.03^2 \approx 683.0\),約 683 人是參考標準。
實際的臨床研究還會配合研究設計,併用更精密的方法(例如檢定力分析)。這條公式是這些方法的出發點、最基本的形式。
電視收視率不是調查每一戶,而是從一組樣本戶推估出來的。舉個簡化的例子(實際的收視率調查方法更複雜):假設樣本戶有 2,700 戶,某節目的收視率是 10%。在信心水準 95% 下,抽樣誤差是 \(1.96 \times \sqrt{0.1 \times 0.9 \div 2700} \approx 0.0113\)(約 ±1.1%)。
這樣就能看出「收視率 9.5% 和 10.5% 的差距,可能還在抽樣誤差的範圍內」,把新聞裡的數字讀得更深入一層。
公式
符號與用語解說
符號
| \(n\) | n | 樣本數。問卷調查就是實際收集回答的人數,檢驗就是要檢查的個數。 |
| \(n_0\) | n 下標 0 | 視母體為非常大時,需要的樣本數的計算值,也就是做有限母體校正之前的值。 |
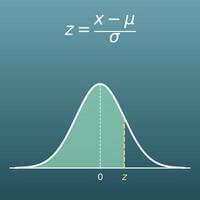
| \(z\) | z | 對應信心水準的 z 值(標準常態分布上的值)。慣用值是 95% 為 1.96、99% 為 2.58。 |
| \(\hat{p}\) | p hat | 母體比例(想調查的「是」的比例等)。求樣本數時代入「預估值」,求抽樣誤差時代入「調查實際得到的比例(樣本比例)」。以 0~1 的小數表示(50% 就是 0.5)。 |
| \(\varepsilon\) | epsilon | 抽樣誤差,也就是調查結果與真正的值之間容許的差距,會像「±5%」這樣加上 ± 表示。 |
| \(N\) | 大寫 N | 母體大小,也就是想調查的整個群體的人數或個數(例:全體員工 500 人)。 |
用語
| 母體 | 真正想了解的對象全體,例如「全國所有選民」「全體員工 500 人」。 |
| 樣本 | 為了實際調查,從母體中選出的一部分。樣本的人數或個數稱為樣本數(樣本大小)。 |
| 隨機抽樣 | 像抽籤一樣,讓母體中每個人被選中的機率都相同的選樣方式。本頁的公式以隨機抽樣為前提,不適用於「只有想回答的人才回答」的問卷(例如網路投票)。 |
| 母體比例 | 整個母體中「是」的比例等,真正想知道的比例。由樣本得到的比例稱為「樣本比例」,以示區別。 |
| 信心水準 | 可信的程度:同樣的調查重複做很多次時,結果有多少 % 會落在抽樣誤差的範圍內。最常用的是 95%。 |
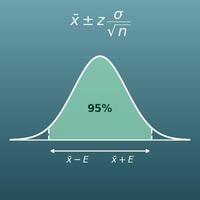
| 信賴區間 | 把調查結果像「52% ± 3%(49%~55%)」這樣帶著寬度表示時的那個範圍。本頁的抽樣誤差 ±ε 就是這個寬度。 |
| 抽樣誤差 | 調查結果與真正的值之間容許的差距(又稱容許誤差)。新聞報導民調時寫的「抽樣誤差正負 3 個百分點」就是這個。 |
| 有限母體校正 | 已知母體大小有限時,把需要的樣本數或抽樣誤差調小的校正。反映了「調查到的母體比例越大,結果越可靠」這件事。 |
建議先了解的基礎知識
為了能「理解意義」地使用本頁的計算,這裡整理了建議先了解的基礎知識。
| 比率與百分率(國小五年級,10~11 歲) |
|
| 平方根(國中八年級,13~14 歲) |
|
| 抽樣調查的概念(國中~高中) |
|
| 常態分布與統計推論(高中選修數學,17~18 歲) |
|
用 Excel 計算的方法
| z 值(信心水準 95% 為 1.96) | 1.96 |
| 預估的母體比例(%) | 50 |
| 抽樣誤差(%) | 5 |
| 計算值 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 需要的樣本數(無條件進位) | =ROUNDUP(B4,0) |
| z 值(信心水準 95% 為 1.96) | 1.96 |
| 預估的母體比例(%) | 50 |
| 抽樣誤差(%) | 5 |
| 母體大小 N | 500 |
| 校正前的計算值 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 需要的樣本數(校正+無條件進位) | =ROUNDUP(B5/(1+(B5-1)/B4),0) |
| z 值(信心水準 95% 為 1.96) | 1.96 |
| 調查得到的比例(%) | 60 |
| 樣本數 n | 100 |
| 抽樣誤差(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| z 值(信心水準 95% 為 1.96) | 1.96 |
| 調查得到的比例(%) | 30 |
| 樣本數 n | 200 |
| 母體大小 N | 1000 |
| 校正前的抽樣誤差(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| 校正後的抽樣誤差(%) | =B5*SQRT((B4-B3)/(B4-1)) |
第 1 個表格的 B4 會顯示 384.16,B5 會顯示 385。第 2 個表格的答案是 218,第 3 個約 9.60(%),第 4 個約 5.68(%)。
「^」是次方(平方),「SQRT」是平方根,「ROUNDUP」是無條件進位的函數。
另外,本頁的計算機在計算值剛好是整數時,為了保險也會多加 1,所以遇到剛好整除的計算值時,可能會和 Excel 的 ROUNDUP 差 1。
用 Google 試算表計算的方法
| z 值(信心水準 95% 為 1.96) | 1.96 |
| 預估的母體比例(%) | 50 |
| 抽樣誤差(%) | 5 |
| 計算值 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 需要的樣本數(無條件進位) | =ROUNDUP(B4,0) |
| z 值(信心水準 95% 為 1.96) | 1.96 |
| 預估的母體比例(%) | 50 |
| 抽樣誤差(%) | 5 |
| 母體大小 N | 500 |
| 校正前的計算值 n0 | =B1^2*(B2/100)*(1-B2/100)/(B3/100)^2 |
| 需要的樣本數(校正+無條件進位) | =ROUNDUP(B5/(1+(B5-1)/B4),0) |
| z 值(信心水準 95% 為 1.96) | 1.96 |
| 調查得到的比例(%) | 60 |
| 樣本數 n | 100 |
| 抽樣誤差(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| z 值(信心水準 95% 為 1.96) | 1.96 |
| 調查得到的比例(%) | 30 |
| 樣本數 n | 200 |
| 母體大小 N | 1000 |
| 校正前的抽樣誤差(%) | =B1*SQRT(B2/100*(1-B2/100)/B3)*100 |
| 校正後的抽樣誤差(%) | =B5*SQRT((B4-B3)/(B4-1)) |
用 Python 計算的方法
import math

# 信心水準(%)對應 z 值的速查表(慣用的近似值)
z_table = {80: 1.28, 85: 1.44, 90: 1.65, 95: 1.96, 98: 2.33, 99: 2.58}

# ---- 用法 1:求需要的樣本數 ----
confidence_level = 95    # 信心水準(%)
population_ratio = 50    # 預估的母體比例(%)
margin_of_error = 5      # 抽樣誤差(%)
population_size = None   # 母體大小(未知或非常大時為 None)

z = z_table[confidence_level]
p = population_ratio / 100
e = margin_of_error / 100

raw_size = z ** 2 * p * (1 - p) / e ** 2   # 校正前的值
if population_size is not None:
    raw_size = raw_size / (1 + (raw_size - 1) / population_size)   # 有限母體校正
required_size = math.floor(raw_size) + 1   # 大於計算值的最小整數(為了保險而進位)
print(f"需要的樣本數:{required_size}")

# ---- 用法 2:求抽樣誤差 ----
sample_size = 1000       # 實際調查的樣本數
sample_ratio = 50 / 100  # 調查得到的比例(50% 就是 0.5)

error_ratio = z * math.sqrt(sample_ratio * (1 - sample_ratio) / sample_size)
print(f"抽樣誤差:±{error_ratio * 100:.2f}%")
用 LaTeX 等數學式語言的寫法(可直接複製)
n₀ = z² × p̂(1 − p̂) ÷ ε²
n_0 = \dfrac{z^2 \, \hat{p}(1-\hat{p})}{\varepsilon^2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>n</mi><mn>0</mn></msub>
<mo>=</mo>
<mfrac>
<mrow>
<msup><mi>z</mi><mn>2</mn></msup>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<msup><mi>ε</mi><mn>2</mn></msup>
</mfrac>
</mrow>
</math>
n_0 = (z^2 hat(p)(1 - hat(p)))/(epsilon^2)
z^2*p*(1 - p)/err^2
n0 := z^2*p*(1 - p)/err^2;
n0 = z^2*p*(1 - p)/err^2;
n_0 = (z^2 p̂(1 − p̂))/ε^2
n = n₀ ÷ (1 + (n₀ − 1) ÷ N)
n = \dfrac{n_0}{1 + \dfrac{n_0 - 1}{N}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>n</mi>
<mo>=</mo>
<mfrac>
<msub><mi>n</mi><mn>0</mn></msub>
<mrow>
<mn>1</mn><mo>+</mo>
<mfrac>
<mrow><msub><mi>n</mi><mn>0</mn></msub><mo>−</mo><mn>1</mn></mrow>
<mi>N</mi>
</mfrac>
</mrow>
</mfrac>
</mrow>
</math>
n = n_0/(1 + (n_0 - 1)/N)
n0/(1 + (n0 - 1)/nPop)
n := n0/(1 + (n0 - 1)/N);
n = n0/(1 + (n0 - 1)/N);
n = n_0/(1 + (n_0 − 1)/N)
ε = z × √(p̂(1 − p̂) ÷ n)
\varepsilon = z \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<mi>z</mi>
<msqrt>
<mfrac>
<mrow>
<mover accent="true"><mi>p</mi><mo>^</mo></mover>
<mo>(</mo><mn>1</mn><mo>−</mo><mover accent="true"><mi>p</mi><mo>^</mo></mover><mo>)</mo>
</mrow>
<mi>n</mi>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = z sqrt((hat(p)(1 - hat(p)))/n)
z*Sqrt[p*(1 - p)/n]
err := z*sqrt(p*(1 - p)/n);
err = z*sqrt(p*(1 - p)/n);
ε = z√((p̂(1 − p̂))/n)
ε = ε₀ × √((N − n) ÷ (N − 1))
\varepsilon = \varepsilon_0 \sqrt{\dfrac{N-n}{N-1}}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>ε</mi>
<mo>=</mo>
<msub><mi>ε</mi><mn>0</mn></msub>
<msqrt>
<mfrac>
<mrow><mi>N</mi><mo>−</mo><mi>n</mi></mrow>
<mrow><mi>N</mi><mo>−</mo><mn>1</mn></mrow>
</mfrac>
</msqrt>
</mrow>
</math>
epsilon = epsilon_0 sqrt((N - n)/(N - 1))
err0*Sqrt[(nPop - n)/(nPop - 1)]
err := err0*sqrt((N - n)/(N - 1));
err = err0*sqrt((N - n)/(N - 1));
ε = ε_0 √((N − n)/(N − 1))
請 ChatGPT 幫忙計算的方法
你是統計調查的計算助理。請實際執行 Python 程式碼來完成以下計算,並只根據執行結果的數值回答(不要用心算或推測回答)。

某個有 1,000 名會員的服務要做滿意度調查。信心水準 95%(z 值 1.96),預估的母體比例 50%,抽樣誤差 ±5%。
請分別求出:
1. 視母體為非常大時,需要的樣本數(計算值,以及無條件進位後的人數)
2. 以母體 1,000 人做有限母體校正後,需要的樣本數
3. 如果只有 200 人回覆,抽樣誤差是多少(做有限母體校正,以 % 表示)

請列出使用的公式和執行結果的數值。
使用方法
-
1輸入數值在輸入欄中輸入要計算的數值
-
2計算按下「計算」按鈕
-
3查看結果計算結果會立即顯示。計算的思路和公式的解說,也都能在同一個頁面查看
DataChef 的特色

不需專業知識,操作直覺又簡單

無須登錄任何個人資料

按下「下載」後自動刪除檔案


無須標註來源出處

亦無須事先取得商用授權
相關功能
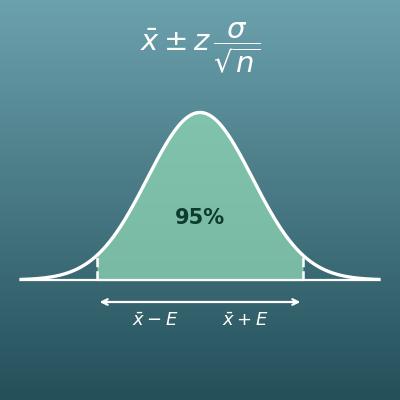
信賴區間計算機(母體平均數的區間估計)
計算平均數的信賴區間(例如 95% 信賴區間)
z 分數計算機(標準分數、z 值與機率互相換算)
由數值、平均數、標準差算出 z 分數,也能與機率互相換算
常態分布機率計算機(常態分配、範圍機率、z 分數)
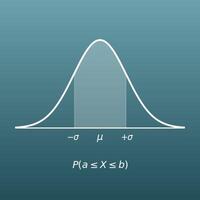
由平均數與標準差,計算落在指定範圍內的機率