






























































































































請把想調查關係的兩種資料,各自用逗號(,)分隔輸入。會算出相關係數 r、共變異數與迴歸直線的方程式,並在散布圖上疊畫迴歸直線。
這個頁面可以做什麼
- 只要輸入成對的 \(x\)、\(y\) 資料(兩個變量),馬上就能知道相關係數 \(r\) 與共變異數 \(s_{xy}\)
- 同時算出 \(x\)、\(y\) 各自的平均數、變異數、標準差,以及迴歸直線(最小平方法)\(y = ax + b\) 的方程式
- 在散布圖上疊畫迴歸直線與平均點,兩組資料的關係(往右上升、往右下降,還是散亂)一目了然
- 依相關係數的值,顯示「高度正相關」「幾乎沒有相關」等參考解讀
- 這個頁面還整理了公式的淺顯解說,以及可直接複製到 Excel、Google 試算表、Python 使用的公式
這個計算有什麼用?
用資料而不是憑感覺來確認「讀書時間增加,成績會不會進步」,是相關係數最具代表性的用法。用每個學生讀書時間與分數的成對資料算出 \(r\),一個數字就能看出關係有多強。
學校或補習班有時也會調查模擬考各科之間的相關(數學好的學生,自然科是不是也好等),作為教學的參考。不過要注意,有相關並不能證明「只要增加時間,成績一定會進步」這樣的因果。
冰淇淋和冷飲的銷售量和氣溫有正相關,關東煮和熱飲則和氣溫有負相關。便利商店和餐廳會從過去「氣溫與銷售數量」的資料確認相關,再依天氣預報調整進貨量和陳列。
再進一步求出迴歸直線,就能做出「明天預報最高氣溫 33 度,大約能賣出幾個」這樣具體的預估。
在投資的世界,股票、債券、黃金等資產之間價格走勢的相關係數,是分散投資的基本工具。組合相關性低(或負相關)的資產,當一方下跌時,另一方比較不容易跟著下跌,整體投資組合的起伏就會比較小。
退休基金和共同基金在決定資產配置之前,也一定會分析資產之間的相關性。
工廠的不良品增加時,調查「加工溫度」「濕度」「機器運轉時間」等條件與不良率之間的相關係數,就能縮小範圍,找出哪些條件和不良一起變動。這是非常基本的方法,用來分析的散布圖甚至是品質管理「QC 七大手法」之一。
找到相關性強的條件後,再用實驗改變條件來確認因果關係,依這樣的流程推動改善。
像「運動量與血壓」「吸菸量與罹患某種疾病的機率」這種調查生活習慣與健康關係的研究,也是從確認資料的相關開始。
同時,這也是訓練自己不要把「相關」草率當成「原因」的好機會。有名的例子是「冰淇淋的銷售量和溺水事故的件數有正相關」,其實兩者只是都因為氣溫這個共同因素而增加。醫學研究會用各種方法排除這種第三個因素的影響,以接近真正的因果關係。
公式與圖示
符號與用語解說
符號
| \(x_i,\ y_i\) | x 下標 i、y 下標 i | 第 \(i\) 組資料的 \(x\) 值與 \(y\) 值。(例:第 3 個人的讀書時間 \(x_3\) 與分數 \(y_3\))。\(i\) 是常用來表示編號(index)的文字。 |
| \(n\) | n | 資料組數,是英文 number(數)的第一個字母。(例:5 個人的成對資料,\(n = 5\)) |
| \(\bar{x},\ \bar{y}\) | x bar、y bar | \(x\)、\(y\) 各自的平均數。文字上方的橫線(bar)是表示「平均」的慣用符號。台灣高中課本也寫成 \(\mu_x,\ \mu_y\)。 |
| \(x_i - \bar{x}\) | x 下標 i 減 x bar | \(x\) 的離均差,表示每筆資料離 \(x\) 的平均數有多遠。\(y_i - \bar{y}\) 是 \(y\) 的離均差。 |
| \(s_{xy}\) | s 下標 xy | \(x\) 與 \(y\) 的共變異數,是離均差乘積的平均,表示兩組資料一起變動的傾向。\(s\) 是表示和標準差(standard deviation)同類統計量的慣用文字。 |
| \(s_x,\ s_y\) | s 下標 x、s 下標 y | \(x\)、\(y\) 各自的標準差(分散程度的大小),是變異數的平方根。台灣高中課本也寫成 \(\sigma_x,\ \sigma_y\)。 |
| \(s_x^2,\ s_y^2\) | s 下標 x 平方、s 下標 y 平方 | \(x\)、\(y\) 各自的變異數,是離均差平方的平均(除以 \(n\))。 |
| \(r\) | r | 相關係數,據說來自英文 correlation(相關)或 relation(關係)的 \(r\)。一定介於 \(-1\) 到 \(1\) 之間。 |
| \(\sum\) | sigma(連加符號) | 表示「全部加起來」的符號。\(\sum_{i=1}^{n}\) 讀作「從 \(i = 1\) 加到 \(n\)」。 |
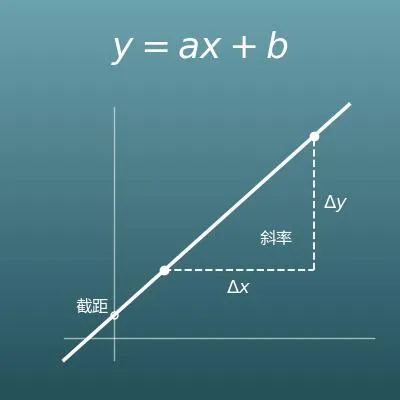
| \(a,\ b\) | a、b | 迴歸直線 \(y = ax + b\) 的斜率與截距,和一次函數的符號相同。 |
用語
| 相關 | 一方增加時另一方也增加(或減少),兩組資料之間直線關係的傾向。關係越強,散布圖上的點越接近排成一條直線。 |
| 正相關 | \(x\) 增加時 \(y\) 也增加的傾向。散布圖往右上升,相關係數為正。 |
| 負相關 | \(x\) 增加時 \(y\) 減少的傾向。散布圖往右下降,相關係數為負。 |
| 相關係數 | 用 \(-1\) 到 \(1\) 的一個數值表示相關強度與方向的指標(也稱為皮爾森相關係數)。由共變異數除以 \(x\)、\(y\) 的標準差的乘積求出。因為不受單位影響,不同的資料之間也能比較強弱。 |
| 共變異數 | \(x\) 的離均差與 \(y\) 的離均差乘積的平均。為正表示往右上升的傾向,為負表示往右下降的傾向。本頁和台灣高中課本一樣除以組數 \(n\)。 |
| 散布圖 | 把成對資料 \((x,\ y)\) 當作坐標平面上的點畫出來的圖。從點的排列方式,一眼就能看出相關的方向與強弱。 |
| 變量 | 像身高、分數、氣溫這樣,當作資料來測量的量。本頁調查 \(x\) 與 \(y\) 這「兩個變量」的關係。 |
| 離均差 | 每筆資料與平均數的差。正數表示比平均數大,負數表示比平均數小。共變異數、變異數、標準差都是由離均差算出來的。 |
| 變異數 | 離均差平方的平均,表示資料分散程度的大小。出現在迴歸直線斜率的分母。 |
| 標準差 | 變異數的平方根。單位和資料相同,很適合當作分散程度的參考。出現在相關係數的分母。 |
| 迴歸直線 | 最符合散布圖上一群點的直線 \(y = ax + b\),也稱為最適直線。用來由 \(x\) 的值預測 \(y\) 的值。 |
| 最小平方法 | 讓每個點與直線之間的垂直誤差平方後加起來的值最小,以此決定直線斜率與截距的方法。迴歸直線就是用這個方法決定的直線。 |
| 離群值 | 和其他點相差很遠的值。相關係數很容易受離群值影響,所以基本上要搭配散布圖一起確認。 |
| 相關關係 | 兩個量一起變動(一方增加時,另一方也增加或減少)的關係。即使有相關,也不一定是一方為原因、另一方為結果(因果關係),可能只是背後有共同的原因(第三個因素)。 |
| 因果關係 | 一方是原因、另一方是它的結果的關係。只有相關關係(一起變動),並不能說有因果關係,可能只是背後有共同的原因(第三個因素)。 |
建議先了解的基礎知識
為了讓您「真正理解意義」地使用這個頁面的計算,這裡整理了建議事先理解的基礎知識。
遇到卡關時,回頭複習這些內容是最快的捷徑。
| 平均數(國小高年級、國中七年級) |
|
| 正負數(國中七年級,12~13 歲) |
|
| 坐標與一次函數(國中七年級~八年級,12~14 歲) |
|
| 平方根(國中八年級,13~14 歲) |
|
| 數據分析(高一「一維數據分析」「二維數據分析」,15~16 歲) |
|
用 Excel 計算的方法
| 第 1 組的 x | 1 |
| 第 2 組的 x | 2 |
| 第 3 組的 x | 3 |
| 第 4 組的 x | 4 |
| 第 5 組的 x | 5 |
| 第 1 組的 y | 2 |
| 第 2 組的 y | 4 |
| 第 3 組的 y | 4 |
| 第 4 組的 y | 4 |
| 第 5 組的 y | 6 |
| 共變異數 s_xy(除以 n) | =COVARIANCE.P(B1:B5,B6:B10) |
| (參考)除以 n−1 的樣本共變異數 | =COVARIANCE.S(B1:B5,B6:B10) |
| 第 1 組的 x | 1 |
| 第 2 組的 x | 2 |
| 第 3 組的 x | 3 |
| 第 4 組的 x | 4 |
| 第 5 組的 x | 5 |
| 第 1 組的 y | 2 |
| 第 2 組的 y | 4 |
| 第 3 組的 y | 4 |
| 第 4 組的 y | 4 |
| 第 5 組的 y | 6 |
| 相關係數 r | =CORREL(B1:B5,B6:B10) |
| (參考)用 PEARSON 函數也是相同的值 | =PEARSON(B1:B5,B6:B10) |
| 第 1 組的 x | 1 |
| 第 2 組的 x | 2 |
| 第 3 組的 x | 3 |
| 第 4 組的 x | 4 |
| 第 5 組的 x | 5 |
| 第 1 組的 y | 2 |
| 第 2 組的 y | 4 |
| 第 3 組的 y | 4 |
| 第 4 組的 y | 4 |
| 第 5 組的 y | 6 |
| 斜率 a | =SLOPE(B6:B10,B1:B5) |
| 截距 b | =INTERCEPT(B6:B10,B1:B5) |
| 第 1 組的 x | 1 |
| 第 2 組的 x | 2 |
| 第 3 組的 x | 3 |
| 第 4 組的 x | 4 |
| 第 5 組的 x | 5 |
| 第 1 組的 y | 2 |
| 第 2 組的 y | 4 |
| 第 3 組的 y | 4 |
| 第 4 組的 y | 4 |
| 第 5 組的 y | 6 |
| x 的平均數 x̄ | =AVERAGE(B1:B5) |
| y 的平均數 ȳ | =AVERAGE(B6:B10) |
| x 的變異數 s_x² | =VARP(B1:B5) |
| x 的標準差 s_x | =STDEVP(B1:B5) |
| y 的變異數 s_y² | =VARP(B6:B10) |
| y 的標準差 s_y | =STDEVP(B6:B10) |
第 1 個表格的共變異數是 1.6(樣本共變異數是 2),第 2 個表格的相關係數約為 0.8944,第 3 個表格算出斜率 0.8、截距 1.6。
請注意,共變異數的函數有 2 種。COVARIANCE.P 是「除以 n」的共變異數(和本計算機、台灣高中課本相同),COVARIANCE.S 是「除以 n − 1」的樣本共變異數。在舊版 Excel(2007 以前),請改用 COVAR 代替 COVARIANCE.P。
CORREL 和 PEARSON 算出的相關係數相同(r 不論除以 n 或 n − 1 都一樣,所以不必選擇)。
SLOPE 和 INTERCEPT 的引數順序是「y 的範圍,x 的範圍」(注意 x 不是放在前面)。
想改變資料組數時,請增加(或減少)數值的列數,再把公式中的「B1:B5」「B6:B10」改成實際的資料範圍。
用 Google 試算表計算的方法
| 第 1 組的 x | 1 |
| 第 2 組的 x | 2 |
| 第 3 組的 x | 3 |
| 第 4 組的 x | 4 |
| 第 5 組的 x | 5 |
| 第 1 組的 y | 2 |
| 第 2 組的 y | 4 |
| 第 3 組的 y | 4 |
| 第 4 組的 y | 4 |
| 第 5 組的 y | 6 |
| 共變異數 s_xy(除以 n) | =COVAR(B1:B5,B6:B10) |
| 第 1 組的 x | 1 |
| 第 2 組的 x | 2 |
| 第 3 組的 x | 3 |
| 第 4 組的 x | 4 |
| 第 5 組的 x | 5 |
| 第 1 組的 y | 2 |
| 第 2 組的 y | 4 |
| 第 3 組的 y | 4 |
| 第 4 組的 y | 4 |
| 第 5 組的 y | 6 |
| 相關係數 r | =CORREL(B1:B5,B6:B10) |
| 第 1 組的 x | 1 |
| 第 2 組的 x | 2 |
| 第 3 組的 x | 3 |
| 第 4 組的 x | 4 |
| 第 5 組的 x | 5 |
| 第 1 組的 y | 2 |
| 第 2 組的 y | 4 |
| 第 3 組的 y | 4 |
| 第 4 組的 y | 4 |
| 第 5 組的 y | 6 |
| 斜率 a | =SLOPE(B6:B10,B1:B5) |
| 截距 b | =INTERCEPT(B6:B10,B1:B5) |
在 Google 試算表中,「除以 n」的共變異數用 COVAR 函數求出(和本計算機的定義相同;用 COVARIANCE.P 這個名稱也能呼叫同一個函數)。相關係數和 Excel 一樣用 CORREL。
用 Python 計算的方法
import statistics

xs = [1, 2, 3, 4, 5]      # x 的資料(例:讀書時間)
ys = [2, 4, 4, 4, 6]      # y 的資料(例:小考分數)

n = len(xs)
mean_x = statistics.mean(xs)      # x 的平均數
mean_y = statistics.mean(ys)      # y 的平均數

# 共變異數 s_xy(母體的式子:除以 n)
covariance = sum((x - mean_x) * (y - mean_y) for x, y in zip(xs, ys)) / n

sd_x = statistics.pstdev(xs)      # x 的標準差(除以 n)
sd_y = statistics.pstdev(ys)      # y 的標準差(除以 n)

r = covariance / (sd_x * sd_y)    # 相關係數

slope = covariance / statistics.pvariance(xs)   # 迴歸直線的斜率 a
intercept = mean_y - slope * mean_x             # 迴歸直線的截距 b

print(f"共變異數 s_xy:{covariance}")
print(f"相關係數 r:{r}")
# 截距可能出現浮點數誤差(1.5999...),所以四捨五入到有效數字 10 位
print(f"迴歸直線:y = {slope:.10g}x + {intercept:.10g}")
用 LaTeX 等數學式語言的寫法(可直接複製)
s_xy = {(x₁ − x̄)(y₁ − ȳ) + … + (xₙ − x̄)(yₙ − ȳ)} ÷ n
s_{xy} = \dfrac{1}{n}\sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y})
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
<mo>=</mo>
<mfrac><mn>1</mn><mi>n</mi></mfrac>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>1</mn></mrow>
<mi>n</mi>
</munderover>
<mrow>
<mo>(</mo><msub><mi>x</mi><mi>i</mi></msub><mo>−</mo><mover><mi>x</mi><mo>¯</mo></mover><mo>)</mo>
<mo>(</mo><msub><mi>y</mi><mi>i</mi></msub><mo>−</mo><mover><mi>y</mi><mo>¯</mo></mover><mo>)</mo>
</mrow>
</mrow>
</math>
s_(xy) = (1/n) sum_(i=1)^n (x_i - bar x)(y_i - bar y)
Covariance[xdata, ydata]*(Length[xdata] - 1)/Length[xdata] (* Covariance 是除以 n-1,所以換算成除以 n 的值 *)
s_xy := add((x[i] - x_bar)*(y[i] - y_bar), i = 1 .. n)/n;
s_xy = mean((x - mean(x)).*(y - mean(y)));
s_xy = (1/n) ∑_(i=1)^n (x_i − x̄)(y_i − ȳ)
r = s_xy ÷ (s_x × s_y)
r = \dfrac{s_{xy}}{s_x\, s_y}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>r</mi>
    <mo>=</mo>
    <mfrac>
      <msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
      <mrow><msub><mi>s</mi><mi>x</mi></msub><msub><mi>s</mi><mi>y</mi></msub></mrow>
    </mfrac>
  </mrow>
</math>
r = s_(xy) / (s_x s_y)
Correlation[xdata, ydata]
r := s_xy/(s_x*s_y);
R = corrcoef(x, y); r = R(1, 2);
r = s_xy/(s_x s_y)
y = ax + b, a = s_xy ÷ s_x², b = ȳ − a·x̄
y = ax + b, \quad a = \dfrac{s_{xy}}{s_x^{2}}, \quad b = \bar{y} - a\bar{x}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>y</mi><mo>=</mo><mi>a</mi><mi>x</mi><mo>+</mo><mi>b</mi>
<mo>,</mo><mspace width="1em"/>
<mi>a</mi><mo>=</mo>
<mfrac>
<msub><mi>s</mi><mrow><mi>x</mi><mi>y</mi></mrow></msub>
<msubsup><mi>s</mi><mi>x</mi><mn>2</mn></msubsup>
</mfrac>
<mo>,</mo><mspace width="1em"/>
<mi>b</mi><mo>=</mo>
<mover><mi>y</mi><mo>¯</mo></mover>
<mo>−</mo>
<mi>a</mi><mover><mi>x</mi><mo>¯</mo></mover>
</mrow>
</math>
y = a x + b, a = s_(xy)/s_x^2, b = bar y - a bar x
lm = LinearModelFit[Transpose[{xdata, ydata}], t, t]; lm["BestFitParameters"]
a := s_xy/s_x^2; b := y_bar - a*x_bar;
p = polyfit(x, y, 1); % p(1) 為斜率 a,p(2) 為截距 b
y = ax + b, a = s_xy/s_x^2, b = ȳ − ax̄
請 ChatGPT 幫忙計算的方法
你是統計計算的助理。請務必實際執行 Python 程式碼來進行下列計算,並只以執行結果的數值作為回答的依據(請不要用心算或猜測回答)。

請針對下列成對資料,分別求出以下各值。
x:1, 2, 3, 4, 5
y:2, 4, 4, 4, 6
1. x 和 y 的平均數,以及除以 n 的變異數與標準差
2. 共變異數 s_xy(離均差乘積的總和除以組數 n;不要除以 n − 1)
3. 相關係數 r
4. 迴歸直線 y = ax + b(最小平方法)的斜率 a 與截距 b

請列出計算時使用的公式,以及執行結果的數值。
使用方法
-
1輸入數值在輸入欄中輸入要計算的數值
-
2計算按下「計算」按鈕
-
3查看結果計算結果會立即顯示。計算的思路和公式的解說,也都能在同一個頁面查看
DataChef 的特色

不需專業知識,操作直覺又簡單

無須登錄任何個人資料

按下「下載」後自動刪除檔案


無須標註來源出處

亦無須事先取得商用授權
相關功能
標準差計算機(母體標準差、樣本標準差)
從用逗號分隔的數值,一次算出標準差、變異數與離均差平方和
四分位數計算機(Q1、Q2、Q3、四分位距、盒狀圖、離群值)
由資料算出四分位數 Q1、Q2、Q3 與四分位距,並畫出盒狀圖