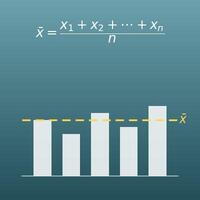































































































































請用逗號(,)分隔,輸入資料的數值。會把平均數(算術平均數)、中位數、眾數、全距這 4 個指標,和由小到大排列的資料一起算出來。
這個頁面可以做什麼
- 只要用逗號(,)分隔輸入數值,就能一次知道平均數(算術平均數)、中位數、眾數、全距這 4 個指標
- 眾數(出現最多次的值)會自動數出來。眾數有 2 個以上時(雙峰、多峰),以及所有的值都只出現 1 次、「沒有眾數」時,也會正確判斷
- 同時會顯示由小到大排列的資料、最大值、最小值、總和與個數,可以直接驗算中位數和全距
- 這個頁面還整理了「平均數、中位數、眾數該怎麼分開使用?」的淺顯解說,以及可直接複製到 Excel、Google 試算表、Python 使用的公式
這個計算有什麼用?
假設某一天賣出的 7 雙鞋,尺寸是 24.5, 25, 24.5, 26, 25, 24.5, 27(cm)。平均數約 25.2 cm,但店家應該多進貨的是「賣最多的尺寸」=眾數 24.5 cm(3 雙)。
像尺寸、顏色、型號這種依「哪一個最常賣出」來決定的進貨與庫存判斷,實務上的主角不是平均數,而是眾數。
例如 5 個家庭的存款是 300 萬、300 萬、400 萬、500 萬、4,000 萬元,平均數是 1,100 萬元,但中位數是 400 萬元,眾數是 300 萬元。
存款、年收入這類分布偏斜的資料,一部分很大的值會拉高平均數,所以比較接近「中間實際感受」的是中位數或眾數。實際上,在台灣,行政院主計總處的家庭收支調查也同時公布可支配所得的平均數和中位數。看新聞的「平均」時,知道這種分開使用的方式,就不會被數字誤導。
全班 30 人投票選最受歡迎的營養午餐,咖哩飯 12 票、雞腿飯 10 票、炒麵 8 票,代表菜色就是眾數「咖哩飯」。菜色的平均或中位數根本無從計算。
像這樣,能用在不是數值的資料(類別資料)上的代表值只有眾數。從商品問卷的回答分析到選舉的得票統計,它是用得最多的「統計基本功」。
工廠會定期抽出幾個產品量尺寸或重量,記錄它們的全距(最大值−最小值)來監控,這種「R 管制圖」的方法被廣泛使用(管制圖是品質管理 QC 七大手法之一)。
全距突然變大,就是機器鬆動或材料不均等異常的訊號。「減一次就知道分散程度」的簡便,是它每天在現場被使用的原因。
即使全班平均是 60 分,如果分成「考得好的一群(80 分左右)」和「卡住的一群(40 分左右)」,就可能幾乎沒有人考 60 分左右(雙峰分布)。
不要只看平均數判斷,一起看眾數、中位數和分數的分散程度(全距),就能擬出符合班級實際狀況的對策。
公式
符號與用語解說
符號
| \(x_1, x_2, \ldots, x_n\) | x 下標 1、x 下標 2、…、x 下標 n | 每一筆資料。(例:5 次考試的分數) |
| \(n\) | n | 資料的個數。(例:5 次的資料就是 \(n = 5\)) |
| \(\bar{x}\) | x bar | 平均數(算術平均數)。在字母上方加一條橫線的符號,是統計中表示「平均數」的標準寫法。母體全體的平均數則另外寫成 \(\mu\)(讀作 mu)。 |
| \(\tilde{x}\) | x tilde | 中位數。課本中常不用符號,直接用文字寫「中位數」,也有寫成 Me 的。 |
| \(M_o\) | M 下標 o(mode) | 眾數。取自英文 Mode 的符號,也有寫成 Mo 的。課本中一般不用符號,直接用文字寫。 |
| \(f(x)\) | f of x | 值 \(x\) 在資料中出現的次數(次數)。(例:70 出現 2 次,就是 \(f(70) = 2\)) |
| \(f_{\max}\) | f max | 次數的最大值(最多的出現次數)。眾數就是次數等於這個值的值。 |
| \(x_{(k)}\) | x 下標括號 k | 把資料由小到大排列後的第 \(k\) 個值。(例:\(x_{(1)}\) 是最小值) |
| \(x_{\max},\ x_{\min}\) | x max、x min | 資料的最大值與最小值。是全距公式的材料。 |
| \(R\) | R | 全距。最大值減去最小值的值,取自 Range 的字首。 |
用語
| 代表值 | 用 1 個數表示整體資料特徵的值(表示資料的集中趨勢)。平均數、中位數、眾數這 3 個最具代表性,台灣在國中七年級的統計單元學到。 |
| 算術平均數 | 把所有資料加起來,再除以資料個數的值。一般說「平均」就是指這個。因為所有的值都用來計算,所以容易被離群值拉走。 |
| 中位數 | 把資料由小到大排列後,正中間的值。偶數個時取中間 2 個值的平均。是不容易受離群值影響的代表值。 |
| 眾數 | 資料中出現次數最多的值。次數最大的值有好幾個時,它們全都是眾數;所有的值都只出現 1 次時,就沒有眾數。是唯一也能用在類別資料上的代表值。 |
| 全距 | 最大值減去最小值的值。是資料分散程度最簡便的參考。 |
| 次數 | 某個值(或某一組)在資料中出現的次數。眾數就是「次數最大的值」。 |
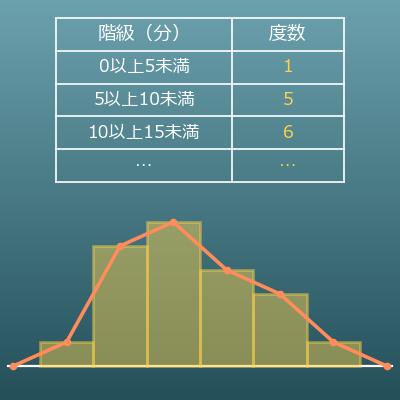
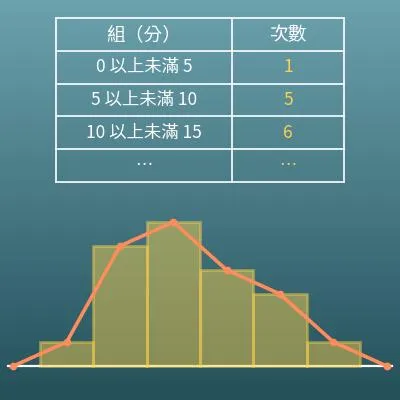
| 次數分配表 | 把資料分成像「60 以上、未滿 70」這樣的區間(組),數出每組次數的表。像身高這種分散得很細的資料,眾數要用次數最多的組來思考。 |
| 組 | 次數分配表中,把資料分開的像「60 以上、未滿 70」這樣的區間。組的正中間的值稱為組中點,分散得很細的資料,眾數要用次數最多那一組的組中點來思考。 |
| 雙峰分布 (多峰分布) |
資料的分布有 2 個(或更多)山峰。眾數有好幾個就是這種情形的訊號,可能混有性質不同的 2 個群體。 |
| 離群值 | 和其他的值相差極遠的值。平均數和全距很容易被離群值拉走,但中位數和眾數不容易受影響。 |
建議先了解的基礎知識
為了讓您「真正理解意義」地使用這個頁面的計算,這裡整理了建議事先理解的基礎知識。
| 加法、減法與除法(國小三~四年級,8~10 歲) |
|
| 平均(國小高年級,10~12 歲) |
|
| 統計與代表值(國中七年級,12~13 歲) |
|
| 次數分配表與直方圖(國中七年級,12~13 歲) |
|
用 Excel 計算的方法
| 第 1 個數 | 60 |
| 第 2 個數 | 70 |
| 第 3 個數 | 70 |
| 第 4 個數 | 80 |
| 第 5 個數 | 95 |
| 眾數 | =MODE.SNGL(B1:B5) |
| 第 1 個數 | 60 |
| 第 2 個數 | 70 |
| 第 3 個數 | 70 |
| 第 4 個數 | 80 |
| 第 5 個數 | 95 |
| 總和 | =SUM(B1:B5) |
| 個數 | =COUNT(B1:B5) |
| 平均數(算術平均數) | =AVERAGE(B1:B5) |
| 第 1 個數 | 60 |
| 第 2 個數 | 70 |
| 第 3 個數 | 70 |
| 第 4 個數 | 80 |
| 第 5 個數 | 95 |
| 中位數 | =MEDIAN(B1:B5) |
| 第 1 個數 | 60 |
| 第 2 個數 | 70 |
| 第 3 個數 | 70 |
| 第 4 個數 | 80 |
| 第 5 個數 | 95 |
| 最大值 | =MAX(B1:B5) |
| 最小值 | =MIN(B1:B5) |
| 全距(最大值−最小值) | =B6-B7 |
第 1 個表格的 B6 會顯示眾數 70;第 2 個表格的 B6 會顯示總和 375、B7 顯示個數 5、B8 顯示平均數 75;第 3 個表格的 B6 會顯示中位數 70;第 4 個表格的 B8 會顯示全距 35。
眾數的 MODE.SNGL,在眾數有好幾個時只會傳回第 1 個。想一次知道全部時,請使用「=MODE.MULT(B1:B5)」(結果會溢出顯示在多個儲存格)。所有的值都只出現 1 次時會出現「#N/A」錯誤,意思就是沒有眾數。
想改變資料個數時,請先增加(或減少)數值的列數,再把公式中的「B1:B5」改成實際的資料範圍(例如 7 個數就改成 B1:B7)。
用 Google 試算表計算的方法
| 第 1 個數 | 60 |
| 第 2 個數 | 70 |
| 第 3 個數 | 70 |
| 第 4 個數 | 80 |
| 第 5 個數 | 95 |
| 眾數 | =MODE(B1:B5) |
| 第 1 個數 | 60 |
| 第 2 個數 | 70 |
| 第 3 個數 | 70 |
| 第 4 個數 | 80 |
| 第 5 個數 | 95 |
| 總和 | =SUM(B1:B5) |
| 個數 | =COUNT(B1:B5) |
| 平均數(算術平均數) | =AVERAGE(B1:B5) |
| 第 1 個數 | 60 |
| 第 2 個數 | 70 |
| 第 3 個數 | 70 |
| 第 4 個數 | 80 |
| 第 5 個數 | 95 |
| 中位數 | =MEDIAN(B1:B5) |
| 第 1 個數 | 60 |
| 第 2 個數 | 70 |
| 第 3 個數 | 70 |
| 第 4 個數 | 80 |
| 第 5 個數 | 95 |
| 最大值 | =MAX(B1:B5) |
| 最小值 | =MIN(B1:B5) |
| 全距(最大值−最小值) | =B6-B7 |
把表格整個複製、貼到 A1 儲存格,再把 B1~B5 改成自己的數值即可。
用 Python 計算的方法
import statistics

numbers = [10, 2, 38, 23, 38, 23, 21]  # 要調查的資料

mean_value = statistics.mean(numbers)        # 平均數(算術平均數)
median_value = statistics.median(numbers)    # 中位數
mode_values = statistics.multimode(numbers)  # 眾數(有好幾個時全部放進串列)
value_range = max(numbers) - min(numbers)    # 全距(最大值−最小值)

print(f"平均數:{mean_value}")
print(f"中位數:{median_value}")
print(f"眾數:{mode_values}")
print(f"全距:{value_range}")
print(f"由小到大:{sorted(numbers)}")
用 LaTeX 等數學式語言的寫法(可直接複製)
Mo = x (f(x) = f_max)
M_o = x \quad \bigl(\, f(x) = f_{\max} \,\bigr)
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <msub><mi>M</mi><mi>o</mi></msub>
    <mo>=</mo>
    <mi>x</mi>
    <mspace width="1em"/>
    <mrow>
      <mo>(</mo>
      <mi>f</mi><mo>(</mo><mi>x</mi><mo>)</mo>
      <mo>=</mo>
      <msub><mi>f</mi><mi>max</mi></msub>
      <mo>)</mo>
    </mrow>
  </mrow>
</math>
M_o = x (f(x) = f_(max))
Commonest[{x1, x2, x3}]
Statistics:-Mode([x1, x2, x3]);
M = mode(x);
M_o = x (f(x) = f_max)
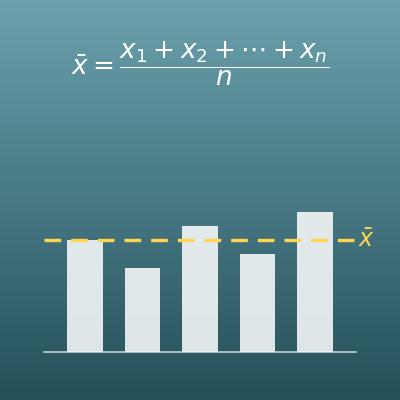
x̄ = (x₁ + x₂ + ⋯ + xₙ) ÷ n
\bar{x} = \frac{x_1 + x_2 + \cdots + x_n}{n} = \frac{1}{n}\sum_{i=1}^{n} x_i
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mover accent="true"><mi>x</mi><mo>¯</mo></mover>
<mo>=</mo>
<mfrac>
<mrow>
<msub><mi>x</mi><mn>1</mn></msub>
<mo>+</mo>
<msub><mi>x</mi><mn>2</mn></msub>
<mo>+</mo>
<mo>⋯</mo>
<mo>+</mo>
<msub><mi>x</mi><mi>n</mi></msub>
</mrow>
<mi>n</mi>
</mfrac>
</mrow>
</math>
bar x = (x_1 + x_2 + cdots + x_n) / n
Mean[{x1, x2, x3}]
xbar := add(x[i], i = 1 .. n)/n;
xbar = mean(x);
x̄ = (x_1 + x_2 + ⋯ + x_n)/n
\tilde{x} = \begin{cases} x_{(\,(n+1)/2\,)} & (n:\ \mathrm{odd}) \\[6pt] \dfrac{x_{(n/2)} + x_{(n/2+1)}}{2} & (n:\ \mathrm{even}) \end{cases}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mover accent="true"><mi>x</mi><mo>~</mo></mover>
<mo>=</mo>
<mrow>
<mo>{</mo>
<mtable columnalign="center left">
<mtr>
<mtd><msub><mi>x</mi><mrow><mo>(</mo><mo>(</mo><mi>n</mi><mo>+</mo><mn>1</mn><mo>)</mo><mo>/</mo><mn>2</mn><mo>)</mo></mrow></msub></mtd>
<mtd><mrow><mo>(</mo><mi>n</mi><mo>:</mo><mtext>odd</mtext><mo>)</mo></mrow></mtd>
</mtr>
<mtr>
<mtd><mfrac>
<mrow>
<msub><mi>x</mi><mrow><mo>(</mo><mi>n</mi><mo>/</mo><mn>2</mn><mo>)</mo></mrow></msub>
<mo>+</mo>
<msub><mi>x</mi><mrow><mo>(</mo><mi>n</mi><mo>/</mo><mn>2</mn><mo>+</mo><mn>1</mn><mo>)</mo></mrow></msub>
</mrow>
<mn>2</mn>
</mfrac></mtd>
<mtd><mrow><mo>(</mo><mi>n</mi><mo>:</mo><mtext>even</mtext><mo>)</mo></mrow></mtd>
</mtr>
</mtable>
</mrow>
</mrow>
</math>
tilde x = {(x_(((n+1)/2)), if n odd), ((x_((n/2)) + x_((n/2+1)))/2, if n even):}
Median[{x1, x2, x3}]
Statistics:-Median([x1, x2, x3]);
med = median(x);
x̃ = (x_((n/2)) + x_((n/2+1)))/2(資料為偶數個時。奇數個時為 x̃ = x_(((n+1)/2)))
R = xₘₐₓ − xₘᵢₙ
R = x_{\max} - x_{\min}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>R</mi>
<mo>=</mo>
<msub><mi>x</mi><mi>max</mi></msub>
<mo>−</mo>
<msub><mi>x</mi><mi>min</mi></msub>
</mrow>
</math>
R = x_(max) - x_(min)
Max[{x1, x2, x3}] - Min[{x1, x2, x3}]
R := max(L) - min(L);
R = max(x) - min(x);
R = x_max − x_min
請 ChatGPT 幫忙計算的方法
你是統計計算的助理。請務必實際執行 Python 程式碼來進行下列計算,並只以執行結果的數值作為回答的依據(請不要用心算或猜測回答)。

請針對下列資料,分別求出以下各值。
資料:10, 2, 38, 23, 38, 23, 21
1. 平均數(算術平均數)
2. 中位數
3. 眾數。有好幾個時請全部列出,所有的值都只出現 1 次時請回答「沒有眾數」
4. 全距(最大值−最小值)
5. 由小到大排列的資料

請列出計算時使用的公式,以及執行結果的數值。
使用方法
-
1輸入數值在輸入欄中輸入要計算的數值
-
2計算按下「計算」按鈕
-
3查看結果計算結果會立即顯示。計算的思路和公式的解說,也都能在同一個頁面查看
DataChef 的特色

不需專業知識,操作直覺又簡單

無須登錄任何個人資料

按下「下載」後自動刪除檔案


無須標註來源出處

亦無須事先取得商用授權
相關功能
平均數計算機(算術平均數)
以平均數(算術平均數)為主,一次算出總和、個數、幾何平均數等
標準差計算機(母體標準差、樣本標準差)
以母體與樣本兩種方式,計算資料分散程度的大小(標準差、變異數)
常態分布機率計算機(常態分配、範圍機率、z 分數)
由平均數與標準差,計算落在指定範圍內的機率