






























































































































請依照想調查的內容選擇模式,再輸入調查結果。「捉放法」推估池塘魚數等的總數;「推估母體中的個數」推估全體中符合條件的個數(不良品的總數等)。
這個頁面可以做什麼
- 像池塘裡的魚這樣「無法全部數完的群體」,可以用捉放法(做上標記後放回,再捕捉一次,看有標記的比率)推估總數
- 已知母體的總個數時(例:產品 3,000 個),可以由隨機抽出的樣本結果(例:100 個中有 2 個不良品),推估母體中符合條件的個數(全部的不良品數)
- 和國中課本一樣,附比例式(內項乘積 = 外項乘積)的計算過程。答案同時以除法的精確值(分數)和「約 ○」的概數表示
- 可以用帶狀圖比較「樣本中的比率」和「母體中的比率」,看出兩者相同
這個計算有什麼用?
調查池塘裡的魚、山上的鹿、湖裡的外來魚等「無法全部數完的生物數量」時,實際上就會用到本頁的捉放法。在漁業資源管理和外來種移除中,族群數量的推估值是決定捕撈上限和移除規模的基本資料。
這個方法的前提是:標記不會脫落、調查期間個體的進出(出生、死亡、移動)很少,以及有標記的個體會和其他個體充分混合。實際調查時,會在時間和方法上下工夫,盡量接近這些前提。
像電池的壽命測試、罐頭內容物的檢查這種「一檢查產品就會損壞、不能再賣」的檢驗,無法做全面調查。這時會隨機抽出樣本檢查,再由樣本中的不良品比率推估全部的不良品數。
由樣本 100 個中有 2 個不良品,推估「全部約 60 個」,是品質管理最基本的工具之一。
「總統施政滿意度」等民意調查,並不是調查全台灣所有的選舉人,而是從隨機選出的一千人到數千人規模的樣本,推估全體的比率。電視收視率也是由樣本戶推估出全體觀眾的比率。
抽樣調查的威力在於:只要樣本是隨機選出的,即使樣本不多,也能相當準確地推估全體(誤差的大小取決於樣本數)。實際的調查還會加上加權等步驟,避免地區或年齡層的偏差,但基礎就是「由樣本的比率推估全體」這個想法。
選舉開票時,只開出一部分的票,就能大致看出各候選人的得票率走向,這是因為把已開出的票當作樣本,推估全體得票的比率。
把樣本中的比率套用到全體,和本頁的比例式是同樣的想法。不過,先開出的票常常集中在某些地區,並不是隨機抽樣,所以開票初期的比率可能會有很大的偏差。這也說明了「樣本要沒有偏差」有多重要。
公式與圖表
符號與用語解說
符號
| \(x\) | x | 用來表示還不知道的數(未知數)的文字。本頁把想求的推估值(「整個池塘的魚數」「母體中符合的個數」)設為 \(x\) 來列比例式。用 \(x\) 表示未知數的習慣,可以追溯到 17 世紀的數學書。 |
| \(m\) | m | 本頁中指「第 1 次捕捉並做標記的數量」。記成英文「標記」mark 的字首就容易想起來。也常和 \(n\) 成對,用來表示個數。 |
| \(n\) | n | 樣本的個數(第 2 次捕捉的數量、抽出來調查的個數)。取自 number(數)的字首,是表示個數的常用文字。統計上習慣把樣本數寫成 \(n\)。 |
| \(k\) | k | 樣本中符合的個數(有標記的數量、不良品數等)。和 \(n\)、\(m\) 一樣,是常用來表示個數或編號的文字。 |
| \(N\) | 大寫 N | 母體的總個數。為了和樣本個數 \(n\)(小寫)區分,統計上習慣把較大的群體寫成大寫。 |
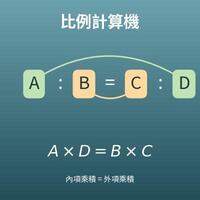
| \(a : b\) | a 比 b | 表示比的寫法。「:」是比的符號,讀作「比」。像 \(a : b = c : d\) 這樣,用等號連接兩個比的式子就是比例式。 |
| \(\approx\) | 約等於 | 表示「幾乎相等」的符號,也可以讀作「約」「大約」。抽樣調查的答案是推估值,所以不用等號,而是用這個符號或「約」來表示。 |
用語
| 抽樣調查 | 只調查母體的一部分(樣本),來推估全體情況的調查。用在無法全部數完、或一調查就會損壞的東西上。 |
| 普查 | 把母體全部一個不漏地調查的方式(全面調查)。行政院主計總處每 10 年辦理的人口及住宅普查、學校的健康檢查都是例子。全部調查雖然準確,但太花時間或費用、或檢驗會損壞產品時,就改用抽樣調查。 |
| 母體 | 想調查的整個群體,例如池塘裡所有的魚、工廠生產的所有產品、全台灣的選舉人等。 |
| 樣本 | 從母體中抽出、實際調查的一部分。 |
| 樣本數 | 樣本中包含的個數(樣本大小)。樣本數越大,推估的誤差就越小。 |
| 隨機抽樣 | 像抽籤一樣,讓每一個被選中的機率都相同來抽出樣本。沒有人刻意挑選,是抽樣調查的推估能夠成立的大前提。 |
| 捉放法 | 替捕到的個體做上標記(記號)後放回,隔一段時間再捕捉一次,由有標記的比率推估總數的方法,又稱標記重捕法。國中自然(生物)在估算族群數量時會學到,實際上也用在魚類和野生動物的數量調查。 |
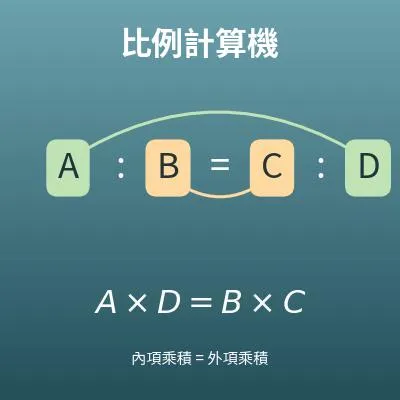
| 比例式 | 像 \(a : b = c : d\) 這樣,表示兩個比相等的式子。有「內項乘積 = 外項乘積」的性質,可以用來求未知的數。 |
| 內項 | 比例式 \(a : b = c : d\) 內側的 \(b\) 和 \(c\)。內項乘積和外項乘積相等。 |
| 外項 | 比例式 \(a : b = c : d\) 外側的 \(a\) 和 \(d\)。內項乘積和外項乘積相等。 |
| 比率 | 某部分在全體中所占的大小,用比較量除以基準量求出。抽樣調查建立在「比率在母體和樣本中都相同」這個想法上。 |
| 概數 | 大約的數。用四捨五入等方法取到方便的位數。抽樣調查的答案是推估值,所以一般會用「約 250」這樣的概數回答。 |
| 四捨五入 | 取到某一位的概數時,看下一位的數字:4 以下就捨去,5 以上就進位。 |
| 推估 | 由已知的部分資訊估計全體的情況。抽樣調查求出的答案,就是在這個意義上稱為「推估值」。 |
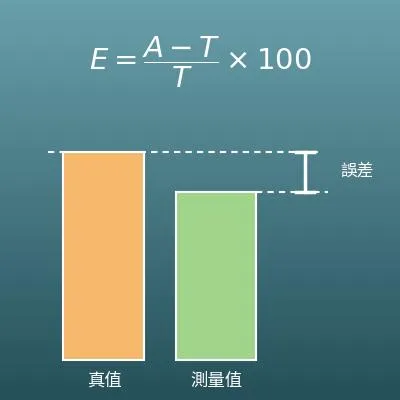
| 誤差 | 推估值與實際值之間的差距。抽樣調查的結果一定有誤差,樣本數越大,誤差就越小。 |
建議先了解的基礎知識
為了能「理解意義」地使用本頁的計算,這裡整理了建議先了解的基礎知識。
遇到卡關時,回頭複習表格中的內容是最快的方法。
| 比率與百分率(國小五年級,10~11 歲) |
|
| 比與比例式(國小六年級~國中七年級,11~13 歲) |
|
| 代數式與一元一次方程式(國中七年級,12~13 歲) |
|
| 概數與四捨五入(國小四年級,9~10 歲) |
|
用 Excel 計算的方法
| 第 1 次做標記的數量 m | 50 |
| 第 2 次捕捉的數量 n | 30 |
| 其中有標記的數量 k | 6 |
| 總數的推估值 x = m×n÷k | =B1*B2/B3 |
| 小數第一位四捨五入的概數 | =ROUND(B4,0) |
| 外項 a(總數,池塘例子的答案) | 250 |
| 內項 b(做標記的數量) | 50 |
| 內項 c(第 2 次捕捉的數量) | 30 |
| 外項 d(其中有標記的數量) | 6 |
| 內項乘積 b×c | =B2*B3 |
| 外項乘積 a×d | =B1*B4 |
| 母體總個數 N | 3000 |
| 抽出的樣本個數 n | 100 |
| 樣本中符合的個數 k | 2 |
| 符合個數的推估值 x = N×k÷n | =B1*B3/B2 |
| 小數第一位四捨五入的概數 | =ROUND(B4,0) |
第 1 個表格是池塘魚數的例子(標記 50 條、第 2 次捕捉 30 條中有 6 條有標記),答案是 250。除不盡時 B4 會顯示小數,請把經過 ROUND 函數的 B5 當作「約 ○」的答案。
第 2 個表格把答案 250 代入比例式 x : 50 = 30 : 6 的 x,確認內項乘積(B5)和外項乘積(B6)都是 1500,兩者相等。
第 3 個表格是 3,000 個產品、樣本 100 個中有 2 個不良品的例子,答案是 60。
用 Google 試算表計算的方法
| 第 1 次做標記的數量 m | 50 |
| 第 2 次捕捉的數量 n | 30 |
| 其中有標記的數量 k | 6 |
| 總數的推估值 x = m×n÷k | =B1*B2/B3 |
| 小數第一位四捨五入的概數 | =ROUND(B4,0) |
| 外項 a(總數,池塘例子的答案) | 250 |
| 內項 b(做標記的數量) | 50 |
| 內項 c(第 2 次捕捉的數量) | 30 |
| 外項 d(其中有標記的數量) | 6 |
| 內項乘積 b×c | =B2*B3 |
| 外項乘積 a×d | =B1*B4 |
| 母體總個數 N | 3000 |
| 抽出的樣本個數 n | 100 |
| 樣本中符合的個數 k | 2 |
| 符合個數的推估值 x = N×k÷n | =B1*B3/B2 |
| 小數第一位四捨五入的概數 | =ROUND(B4,0) |
用 Python 計算的方法
from fractions import Fraction

# 捉放法:推估整個池塘的魚數
marked_first = 50       # 第 1 次捕捉並做標記的數量 m
caught_second = 30      # 第 2 次捕捉的數量 n
marked_in_second = 6    # 第 2 次捕捉中有標記的數量 k

estimated_total = Fraction(marked_first * caught_second, marked_in_second)
# 加上 Fraction(1, 2) 再捨去小數部分,0.5 一定會進位
approx_total = int(estimated_total + Fraction(1, 2))
print(f"總數的推估值(分數):{estimated_total}")
print(f"總數的推估值(概數):約 {approx_total}")

# 推估母體中符合的個數
population = 3000       # 母體總個數 N
sample_size = 100       # 抽出的樣本個數 n
sample_hits = 2         # 樣本中符合的個數 k

estimated_count = Fraction(population * sample_hits, sample_size)
approx_count = int(estimated_count + Fraction(1, 2))
print(f"符合個數的推估值(分數):{estimated_count}")
print(f"符合個數的推估值(概數):約 {approx_count}")
用 LaTeX 等數學式語言的寫法(可直接複製)
x = m × n ÷ k
x = \dfrac{m \times n}{k}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>x</mi>
<mo>=</mo>
<mfrac>
<mrow><mi>m</mi><mo>×</mo><mi>n</mi></mrow>
<mi>k</mi>
</mfrac>
</mrow>
</math>
x = (m*n)/k
(m*n)/k
x := m*n/k;
x = m*n/k;
x = (m×n)/k
a : b = c : d ⇔ a × d = b × c
a : b = c : d \iff ad = bc
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>a</mi><mo>:</mo><mi>b</mi>
<mo>=</mo>
<mi>c</mi><mo>:</mo><mi>d</mi>
<mo>⇔</mo>
<mi>a</mi><mi>d</mi>
<mo>=</mo>
<mi>b</mi><mi>c</mi>
</mrow>
</math>
a : b = c : d <=> a*d = b*c
a*d == b*c
a*d = b*c;
a*d == b*c
a : b = c : d ⇔ a×d = b×c
x = N × k ÷ n
x = \dfrac{N \times k}{n}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>x</mi>
<mo>=</mo>
<mfrac>
<mrow><mi>N</mi><mo>×</mo><mi>k</mi></mrow>
<mi>n</mi>
</mfrac>
</mrow>
</math>
x = (N*k)/n
(N*k)/n
x := N*k/n;
x = N*k/n;
x = (N×k)/n
請 ChatGPT 幫忙計算的方法
你是數學計算助理(國中的抽樣調查)。請實際執行 Python 程式碼來完成以下計算,並只根據執行結果的數值回答(不要用心算或推測回答)。

用捉放法推估池塘裡魚的總數。
先捕捉 50 條魚,做上標記後放回池中。幾天後捕捉 30 條魚,其中 6 條有標記。
請分別列出:
1. 設總數為 x 的比例式(x:做標記的數量 = 第 2 次捕捉的數量:其中有標記的數量)
2. 用「內項乘積 = 外項乘積」求解的過程
3. 整個池塘魚數的推估值(除不盡時,同時寫出最簡分數,以及小數第一位四捨五入的概數)

在 Python 中請用標準函式庫的 fractions 模組精確計算,並列出使用的公式和執行結果的數值。
使用方法
-
1輸入數值在輸入欄中輸入要計算的數值
-
2計算按下「計算」按鈕
-
3查看結果計算結果會立即顯示。計算的思路和公式的解說,也都能在同一個頁面查看
DataChef 的特色

不需專業知識,操作直覺又簡單

無須登錄任何個人資料

按下「下載」後自動刪除檔案


無須標註來源出處

亦無須事先取得商用授權
相關功能
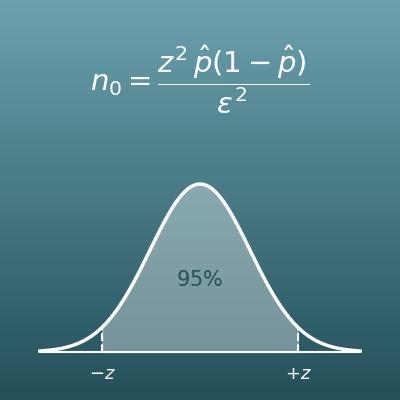
樣本數計算機(問卷樣本數、抽樣誤差)
求出問卷等調查為了把誤差控制在一定範圍內所需的樣本數。這是抽樣前「設計調查」用的計算機(本頁則是由抽出的樣本結果推估母體)
比例計算機(解比例式、比的放大與縮小)
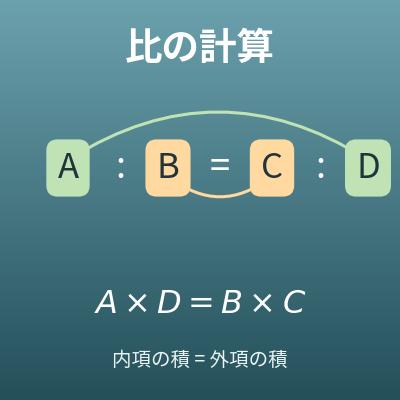
計算比例式 a : b = x : c 的未知數 x(內項乘積 = 外項乘積),以及化簡比,附計算過程
百分比計算機(百分率、比較量、基準量)
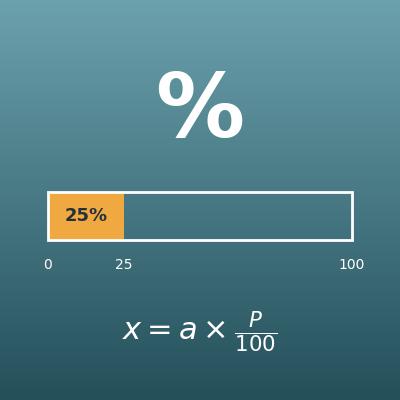
基準量、比較量、百分率三者的關係,輸入其中兩個就能求出另一個