






























































































































請選擇輸入方式。「由原始資料製作」會從貼上的一串資料自動製作次數分配表;「直接輸入次數分配表」則是把現有表格中每一組的下限、上限與次數直接輸入。
這個頁面可以做什麼
- 貼上身高、考試分數、通學時間等原始資料(用逗號或空格分隔),只要決定組距和第一組的下限,就能自動製作次數分配表(組別、組中點、次數、相對次數、累積次數、累積相對次數)
- 也可以直接輸入現有的次數分配表(每一組的下限、上限與次數)來計算
- 由組中點估計平均數(「(組中點 × 次數)的總和 ÷ 次數的總和」),同時以最簡分數(精確值)和小數表示。也會求出眾數,以及中位數所在的組
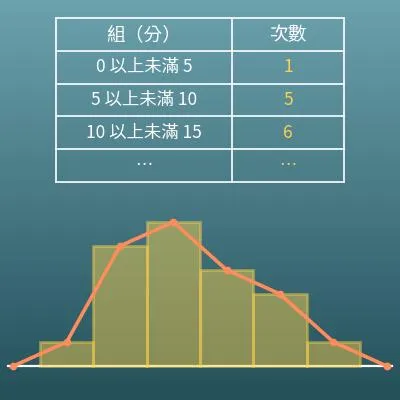
- 自動畫出直方圖與次數分配折線圖,可以儲存為 PNG 或 SVG
- 這個頁面還整理了「組距、次數、相對次數」等國中統計用語的淺顯解說,以及可直接複製到 Excel、Google 試算表、Python 使用的公式
這個計算有什麼用?
把考試分數每 10 分分成一組的次數分配表或直方圖,是成績資料的常客。同樣平均 60 分,是「60 分左右只有一個高峰」,還是「30 幾分和 90 幾分有兩個高峰」,班上的狀況完全不同。
換成相對次數,就連人數不同的班級或年級,也能公平比較分布。模擬考成績單上顯示「自己的分數落在哪個區間」的圖,也是用次數分配的概念做出來的。
直方圖是製造業品質管理的基本工具「QC 七大手法」之一。把產品的尺寸或重量量好、做成次數分配,就能看出變異的中心和範圍,以及「是否有超出規格上限或下限的傾向」。
如果分布的高峰分成兩個,可能代表「兩台機器的設定不一樣」,可以當作找出不良原因的線索。
在台灣,內政部的人口統計會按年齡(每 5 歲一組)公布人數,主計總處的薪資統計也會按薪資級距公布人數分布,這些都是次數分配表的形式。像所得這種偏斜很大的資料,平均數容易被少數很大的值拉高、比中位數還高,只看「平均○○萬元」這個數字,可能會誤解實際情形。
用次數分配表,還能看到「哪一組的人最多(眾數所在的組)」「正中間的人在哪一組(中位數所在的組)」,可以從分布的全貌來判斷。
在氣象領域,會把觀測到的雨量和氣溫資料分組整理,例如「一年中有幾天達到中央氣象署『大雨』的標準(24 小時累積雨量 80 毫米以上)」。做成次數分配後,就能比較各年、各地區趨勢的差異,以及極端那幾組出現頻率的變化。
防災計畫的基礎,就是「多強的現象、多常發生」這種分布的資訊。
學校的體適能檢測(坐姿體前彎、立定跳遠、仰臥起坐、心肺耐力跑走等)會對照教育部體育署的常模,用「百分等級」表示成績,例如「贏過同年齡 75% 的學生」。常模是從許多學生成績的分布整理出來的,而百分等級和累積相對次數是同樣的概念:某個值以下的資料占全體的比例。
健康檢查的身高、體重、血壓等「參考值範圍」,出發點也是調查許多人資料的分布。
公式與圖表
符號與用語解說
符號
| \(n\) | n | 表示次數的總和(全部資料的個數)的文字,是英文 number(數)的第一個字母。 |
| \(f\) | f | 表示次數(落在該組的資料個數)的文字,是英文 frequency(次數)的第一個字母。 |
| \(r\) | r | 本頁可複製的公式中用來表示相對次數的文字,是英文 relative frequency(相對次數)的第一個字母。 |
| \(a,\ b\) | a、b | 組的下限(「○以上」的○)與上限(「未滿○」的○)。表示「固定的數」時,習慣用字母開頭的 \(a,\ b,\ c\)。 |
| \(m\) | m | 本頁用來表示組中點(每組正中間的值)的文字,是英文 middle(中間)或 midpoint(中點)的第一個字母。 |
| \(\bar{x}\) | x bar | 表示平均數的符號。在代表資料值的文字 \(x\) 上方加一條表示平均的橫線(bar),是統計上廣泛使用的寫法。 |
用語
| 次數分配表 | 把資料分成幾組(區間),數出每組有幾筆資料(次數)並整理成的表格,是掌握資料整體樣貌(分布)的基本統計工具。 |
| 組 | 把資料分開的每一個區間。例如通學時間,一般會用相同寬度、沒有空隙地分成「0 分以上未滿 5 分」「5 分以上未滿 10 分」……。 |
| 組距 | 每一組區間的大小。「10 分以上未滿 15 分」的組距是 5 分。改變組距,表格和直方圖的樣子也會跟著改變。 |
| 組中點 | 該組正中間的值,用(下限+上限)÷ 2 求出。「10 分以上未滿 15 分」的組中點是 12.5 分。由次數分配表估計平均數時,用它來代表這一組。 |
| 次數 | 落在該組的資料個數,用人數、次數、個數等所數東西的單位表示。 |
| 相對次數 | 該組的次數占全體的比例,用次數 ÷ 次數的總和求出,通常寫成小數。所有組的相對次數加起來等於 1。 |
| 累積次數 | 從第一組到該組的次數全部加起來的值,可以馬上知道「未滿○的資料有幾個」。 |
| 累積相對次數 | 從第一組到該組的相對次數全部加起來的值(累積次數 ÷ 次數的總和),可以知道「未滿○的資料占全體的幾成」。到最後一組時等於 1。 |
| 下限 | 一組的起點,「10 以上」包含 10。這個規則讓人不必煩惱分界上的資料該放哪一組:「10 以上未滿 15」這一組,包含剛好是 10 的資料。 |
| 上限 | 一組的終點,「未滿 15」不包含 15。所以剛好是 15 的資料不會放進「10 以上未滿 15」,而是放進上一組「15 以上未滿 20」。 |
| 直方圖 | 把次數分配表畫成柱狀的統計圖。橫軸是組別、縱軸是次數,長方形的柱子緊密相連、中間沒有空隙。資料的分散情形(分布的形狀)一目了然。 |
| 次數分配折線圖 | 依序連接直方圖每根柱子上緣中點(組中點的位置)的折線圖。兩端假設各有一組次數為 0,把線畫到橫軸。適合把兩個分布重疊比較。 |
| 分布 | 資料在哪裡多、在哪裡少的「分散方式」。次數分配表和直方圖就是用來看分布的工具。 |
| 集中趨勢量數 | 用一個數值代表整組資料特徵的值,常用的有平均數、中位數、眾數。 |
| 平均數 | 把資料的值全部加起來,再除以資料個數的值。由次數分配表則用(組中點 × 次數)的總和 ÷ 次數的總和來估計。 |
| 中位數 | 資料由小到大排列時,正中間的值。資料個數為偶數時,取中間兩個值的平均。用次數分配表時,要用累積次數找出中位數在哪一組。 |
| 眾數 | 出現最多次的值。用次數分配表時,把次數最大的那一組的組中點當作眾數。 |
| 原始資料 | 尚未統計整理、測量後原封不動的每一筆資料。把原始資料整理成次數分配表,整體樣貌比較容易看出來,但每一筆資料的個別數值就看不到了。 |
建議先了解的基礎知識
為了讓您「真正理解意義」地使用這個頁面的計算,這裡整理了建議事先理解的基礎知識。
遇到卡關時,回頭複習這些內容是最快的捷徑。
| 以上、未滿(國小中高年級) |
|
| 平均數(國小高年級、國中七年級) |
|
| 比率與百分率(國小五年級,10~11 歲) |
|
| 分數與小數(國小五年級~六年級,10~12 歲) |
|
| 集中趨勢量數(國中,12~15 歲) |
|
用 Excel 計算的方法
| 某一組的次數 f | 6 |
| 次數的總和 n | 20 |
| 相對次數 r = f ÷ n | =B1/B2 |
| 該組的下限 a | 10 |
| 該組的上限 b | 15 |
| 組中點 m = (a + b) ÷ 2 | =(B1+B2)/2 |
| 組中點 1(0 以上未滿 5) | 2.5 |
| 組中點 2(5 以上未滿 10) | 7.5 |
| 組中點 3(10 以上未滿 15) | 12.5 |
| 組中點 4(15 以上未滿 20) | 17.5 |
| 組中點 5(20 以上未滿 25) | 22.5 |
| 組中點 6(25 以上未滿 30) | 27.5 |
| 次數 1 | 1 |
| 次數 2 | 5 |
| 次數 3 | 6 |
| 次數 4 | 4 |
| 次數 5 | 3 |
| 次數 6 | 1 |
| (組中點 × 次數)的總和 | =SUMPRODUCT(B1:B6,B7:B12) |
| 次數的總和 n | =SUM(B7:B12) |
| 平均數的估計值 | =B13/B14 |
| 資料 1 | 3 |
| 資料 2 | 5 |
| 資料 3 | 8 |
| 資料 4 | 12 |
| 資料 5 | 14 |
| 資料 6 | 17 |
| 資料 7 | 22 |
| 資料 8 | 26 |
| 0 以上未滿 5 的次數 | =COUNTIFS(B1:B8,">=0",B1:B8,"<5") |
| 5 以上未滿 10 的次數 | =COUNTIFS(B1:B8,">=5",B1:B8,"<10") |
| 10 以上未滿 15 的次數 | =COUNTIFS(B1:B8,">=10",B1:B8,"<15") |
第 1 個表格是相對次數的例子,答案是 0.3。第 2 個表格是組中點的例子,答案是 12.5。
第 3 個表格估計本頁計算機範例(20 人的通學時間)的平均數。SUMPRODUCT 是「把對應的儲存格相乘再相加」的函數,可以一次算出(組中點 × 次數)的總和,答案是 14。
第 4 個表格由原始資料數出每一組的次數。COUNTIFS 是「計算符合條件的儲存格個數」的函數,把「10 以上」和「未滿 15」兩個條件並列,就能數出這一組的次數。
用 Google 試算表計算的方法
| 某一組的次數 f | 6 |
| 次數的總和 n | 20 |
| 相對次數 r = f ÷ n | =B1/B2 |
| 該組的下限 a | 10 |
| 該組的上限 b | 15 |
| 組中點 m = (a + b) ÷ 2 | =(B1+B2)/2 |
| 組中點 1(0 以上未滿 5) | 2.5 |
| 組中點 2(5 以上未滿 10) | 7.5 |
| 組中點 3(10 以上未滿 15) | 12.5 |
| 組中點 4(15 以上未滿 20) | 17.5 |
| 組中點 5(20 以上未滿 25) | 22.5 |
| 組中點 6(25 以上未滿 30) | 27.5 |
| 次數 1 | 1 |
| 次數 2 | 5 |
| 次數 3 | 6 |
| 次數 4 | 4 |
| 次數 5 | 3 |
| 次數 6 | 1 |
| (組中點 × 次數)的總和 | =SUMPRODUCT(B1:B6,B7:B12) |
| 次數的總和 n | =SUM(B7:B12) |
| 平均數的估計值 | =B13/B14 |
| 資料 1 | 3 |
| 資料 2 | 5 |
| 資料 3 | 8 |
| 資料 4 | 12 |
| 資料 5 | 14 |
| 資料 6 | 17 |
| 資料 7 | 22 |
| 資料 8 | 26 |
| 0 以上未滿 5 的次數 | =COUNTIFS(B1:B8,">=0",B1:B8,"<5") |
| 5 以上未滿 10 的次數 | =COUNTIFS(B1:B8,">=5",B1:B8,"<10") |
| 10 以上未滿 15 的次數 | =COUNTIFS(B1:B8,">=10",B1:B8,"<15") |
用 Python 計算的方法
from fractions import Fraction

# 原始資料(例:20 名學生的通學時間,單位為分鐘)
data_values = [5, 12, 8, 14, 3, 22, 15, 9, 11, 26,
               7, 14, 19, 6, 13, 24, 10, 16, 21, 18]
class_width = Fraction(5)   # 組距
first_lower = Fraction(0)   # 第一組的下限

data_values = [Fraction(v) for v in data_values]
class_count = max(int((v - first_lower) / class_width) for v in data_values) + 1

# 把每筆資料分到各組(含下限、不含上限)
freqs = [0] * class_count
for v in data_values:
    freqs[int((v - first_lower) / class_width)] += 1

total = sum(freqs)
mid_times_freq_sum = Fraction(0)
print("組別 / 組中點 / 次數 / 相對次數")
for i, f in enumerate(freqs):
    lower = first_lower + i * class_width
    upper = lower + class_width
    midpoint = (lower + upper) / 2
    mid_times_freq_sum += midpoint * f
    print(f"{lower} 以上未滿 {upper} / {float(midpoint)} / {f} / {float(Fraction(f, total))}")

estimated_mean = mid_times_freq_sum / total
print(f"平均數的估計值(分數):{estimated_mean}")
print(f"平均數的估計值(小數):{float(estimated_mean)}")
print(f"原始資料的平均數:{float(sum(data_values) / len(data_values))}")
用 LaTeX 等數學式語言的寫法(可直接複製)
r = f ÷ n
r = \dfrac{f}{n}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>r</mi>
    <mo>=</mo>
    <mfrac><mi>f</mi><mi>n</mi></mfrac>
  </mrow>
</math>
r = f/n
r = f/n
r := f/n;
r = f/n;
r = f/n
m = (a + b) ÷ 2
m = \dfrac{a + b}{2}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
  <mrow>
    <mi>m</mi>
    <mo>=</mo>
    <mfrac>
      <mrow><mi>a</mi><mo>+</mo><mi>b</mi></mrow>
      <mn>2</mn>
    </mfrac>
  </mrow>
</math>
m = (a + b)/2
m = (a + b)/2
m := (a + b)/2;
m = (a + b)/2;
m = (a + b)/2
x̄ = (m₁×f₁ + m₂×f₂ + … + mₖ×fₖ) ÷ n
\bar{x} = \dfrac{m_1 f_1 + m_2 f_2 + \cdots + m_k f_k}{n}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mover><mi>x</mi><mo>¯</mo></mover>
<mo>=</mo>
<mfrac>
<mrow>
<msub><mi>m</mi><mn>1</mn></msub><msub><mi>f</mi><mn>1</mn></msub>
<mo>+</mo>
<msub><mi>m</mi><mn>2</mn></msub><msub><mi>f</mi><mn>2</mn></msub>
<mo>+</mo><mo>⋯</mo><mo>+</mo>
<msub><mi>m</mi><mi>k</mi></msub><msub><mi>f</mi><mi>k</mi></msub>
</mrow>
<mi>n</mi>
</mfrac>
</mrow>
</math>
bar x = (m_1 f_1 + m_2 f_2 + cdots + m_k f_k)/n
Total[m*f]/Total[f]
xbar := add(m[i]*f[i], i = 1..k)/n;
xbar = sum(m.*f)/sum(f);
x̄ = (m_1 f_1 + m_2 f_2 + … + m_k f_k)/n
請 ChatGPT 幫忙計算的方法
你是統計的計算助理。請務必實際執行 Python 程式碼來進行下列計算,並只以執行結果的數值作為回答的依據(請不要用心算或猜測回答)。

請用下列資料製作次數分配表,第一組的下限為 0、組距為 5(每一組「含下限、不含上限」,也就是「以上、未滿」)。
資料:5, 12, 8, 14, 3, 22, 15, 9, 11, 26, 7, 14, 19, 6, 13, 24, 10, 16, 21, 18
請分別列出:
1. 次數分配表(組別、組中點、次數、相對次數、累積次數、累積相對次數)
2. 由組中點估計的平均數(最簡分數與小數兩種寫法)
3. 眾數,以及中位數所在的組
4. 直接用原始資料算出的平均數,以及和估計值的差距

請在 Python 中使用標準函式庫的 fractions 模組精確計算,並列出使用的公式與執行結果的數值。
使用方法
-
1輸入數值在輸入欄中輸入要計算的數值
-
2計算按下「計算」按鈕
-
3查看結果計算結果會立即顯示。計算的思路和公式的解說,也都能在同一個頁面查看
DataChef 的特色

不需專業知識,操作直覺又簡單

無須登錄任何個人資料

按下「下載」後自動刪除檔案


無須標註來源出處

亦無須事先取得商用授權
相關功能
平均數、中位數、眾數、全距計算機(代表值)
從原始資料一次算出平均數、中位數、眾數、全距 4 個量數,並解說如何區分使用
四分位數計算機(Q1、Q2、Q3、四分位距、盒狀圖、離群值)
用四分位數與盒狀圖表示資料的分散情形,是和直方圖並列的「看分布」工具