






























































































































請輸入試驗次數 n、每次成功的機率 p、成功次數 k。會一次顯示恰好 k 次的機率、k 次以下與 k 次以上的累積機率、期望值、變異數、標準差,以及整個分布的長條圖。
目錄
這個頁面可以做什麼
- 只要輸入 3 個數值,馬上就能算出「機率為 \(p\) 的事重複 \(n\) 次,恰好發生 \(k\) 次的機率」\(P(X = k) = {}_{n}\mathrm{C}_{k}\, p^{k} (1-p)^{n-k}\)
- 答案同時以 \(\dfrac{3}{8}\) 這樣約分後的最簡分數(精確值),以及小數、百分率顯示。也能看到組合數 \({}_{n}\mathrm{C}_{k}\) 的計算過程
- 「\(k\) 次以下的機率 \(P(X \le k)\)」「\(k\) 次以上的機率 \(P(X \ge k)\)」等累積機率也會同時算出來
- 也會顯示期望值 \(E(X) = np\)、變異數 \(\mathrm{Var}(X) = np(1-p)\)、標準差 \(\sigma\),以及能否用常態分布近似的判斷
- 把發生次數從 0 次到 \(n\) 次的整個分布畫成長條圖,「大約幾次最容易發生」一目瞭然
這個計算有什麼用?
機率 1% 的抽卡抽 100 次時,中獎次數服從二項分布 \(B(100,\ 0.01)\)(前提是公布的機率每次都相同且互相獨立)。一次都沒中的機率高達 \(0.99^{100} \approx 36.6\%\),從分布就能看出「就算只有 1%,抽 100 次也幾乎一定會中」這個直覺有多危險。
規劃課金預算時「期望值 \(np\) 次+分散程度」的估算,正是這個頁面的計算。
工廠常用「從一批產品中抽出 \(n\) 個,不良品在 \(c\) 個以下就允收」的抽樣檢驗,取代全數檢驗。不良率 \(p\) 的這批產品被允收的機率,就是二項分布的累積機率 \(P(X \le c)\)。例如從不良率 1% 的一批產品抽 20 個,規定不良品 0 個才允收,允收的機率是 \(0.99^{20} \approx 81.8\%\)。
「不良率在多少以內要高機率允收、品質差的批次要能剔除」,這種檢驗標準的設計就會用到這個計算。
20 題 4 選 1 的選擇題全部用猜的,答對的題數服從二項分布 \(B(20,\ 0.25)\),期望值是 \(20 \times 0.25 = 5\) 題。矇對 8 題以上的機率只有約 10%,用機率就能證明「只靠猜很難達到及格線」。
出題的一方也會考慮這個分布來決定題數和標準,讓人不容易靠矇的超過及格線。
罰球命中率 70% 的球員投 10 球,恰好投進 7 球的機率只有 \({}_{10}\mathrm{C}_{7} \times 0.7^{7} \times 0.3^{3} \approx 26.7\%\)(假設每球互相獨立、命中率固定)。「七成的球員 10 球投進 7 球」其實並不理所當然,投進 6 球或 8 球也很常見。
要分辨看起來手感好或手感差的表現,有多少只是「機率上正常的波動」,就會用到二項分布。
「支持度」「收視率」等調查,會把 \(n\) 位受訪者中符合條件的人數,視為服從二項分布。台灣的民調報導常寫「抽樣誤差正負幾個百分點」,這個誤差就是由標準差 \(\sqrt{np(1-p)}\) 與常態近似算出來的。
「要訪問多少人,誤差才能縮小到多少」這種樣本數的設計,正是以二項分布的性質為依據。
公式與圖表
符號與用語解說
符號
| \(X\) | X | 表示「發生次數」的隨機變數。由機率決定的數,習慣用字母表後段的大寫字母 \(X,\ Y,\ Z\) 表示。 |
| \(P(X = k)\) | P of X 等於 k | 發生次數 \(X\) 恰好為 \(k\) 次的機率。\(P\) 是 probability(機率)的第一個字母。 |
| \({}_{n}\mathrm{C}_{k}\) | n 取 k 的組合數 | 從 \(n\) 個中選 \(k\) 個的組合數。\(C\) 是 combination(組合)的第一個字母。台灣的高中教科書寫成 \(C^{n}_{k}\),大學或國外的書也寫成 \(\dbinom{n}{k}\),意思都相同。 |
| \(n\) | n | 試驗次數(重複的次數)。表示次數或個數時,常用 number(數)的第一個字母 \(n\)。 |
| \(p\) | p | 每次試驗成功的機率。是 probability(機率)的第一個字母,小寫常用來表示「每一次的機率」。 |
| \(1 - p\) | 1 減 p | 每次試驗失敗的機率(不成功的機率)。成功和失敗一定會發生其中一個,所以就是全體的 \(1\) 減去 \(p\)。也常寫成 \(q\)。 |
| \(k\) | k | 成功次數,是 \(0\) 到 \(n\) 的整數。指定「發生幾次」時常用 \(k\)。 |
| \(P(X \le k)\) | P of X 小於或等於 k | 發生次數在 \(k\) 次以下(0 次~\(k\) 次其中之一)的機率。把「恰好的機率」加到 \(k\) 次為止的累積機率。 |
| \(P(X \ge k)\) | P of X 大於或等於 k | 發生次數在 \(k\) 次以上(\(k\) 次~\(n\) 次其中之一)的機率。用全體的 \(1\) 減去 \(P(X \le k-1)\)(餘事件),就能少做很多加法。 |
| \(E(X)\) | E of X | 期望值(平均發生的次數)。\(E\) 是 expectation(期望值)的第一個字母。二項分布的 \(E(X) = np\)。 |
| \(\mathrm{Var}(X)\) | Var of X | 變異數(分散程度的大小)。Var 來自 variance(變異數)。二項分布的 \(\mathrm{Var}(X) = np(1-p)\)。 |
| \(\sigma\) | sigma | 標準差。希臘字母的小寫 sigma,相當於 standard deviation 的 s。是變異數的平方根 \(\sigma = \sqrt{\mathrm{Var}(X)}\),表示離期望值偏離程度的參考。 |
| \(B(n,\ p)\) | B n p | 試驗次數 \(n\)、成功機率 \(p\) 的二項分布。\(B\) 是 binomial(二項的)的第一個字母。「\(X\) 服從二項分布」寫成 \(X \sim B(n,\ p)\)。 |
| \(N(\mu,\ \sigma^2)\) | N mu sigma 平方 | 平均數 \(\mu\)、變異數 \(\sigma^2\) 的常態分布。\(N\) 是 normal distribution(常態分布)的第一個字母。括號內習慣依「平均數、變異數」的順序書寫。 |
| \(\approx\) | 約等於 | 表示大約相等的符號。這個頁面用它來表示「二項分布可以大致換成常態分布」。 |
用語
| 二項分布 | 「機率為 \(p\) 的事重複 \(n\) 次時,會發生幾次」的機率分布。名稱來自公式中的 \({}_{n}\mathrm{C}_{k}\) 和二項係數(二項式定理的係數)相同。台灣在高中選修數學的「隨機變數」單元學到。 |
| 隨機變數 | 值由機率決定的變數。在這個頁面,「發生次數」就是隨機變數,會以各自固定的機率,取 0 次到最多 n 次的值。 |
| 試驗 | 像丟硬幣、抽一次籤這樣,結果由偶然決定的實驗或觀察,做一次就是一次試驗。 |
| 重複試驗 | 把同一個試驗以每次相同的機率、互不影響地(獨立地)重複進行,也稱為獨立重複試驗。二項分布就是重複試驗中「成功次數」的分布。 |
| 獨立 | 某次試驗的結果不會影響另一次試驗的結果。擲骰子的第 1 次和第 2 次是獨立的;但抽出的籤不放回、繼續抽的話就不是獨立的(因為前一次的結果會改變剩下的中獎籤數量)。 |
| 組合 | 從 \(n\) 個中「不考慮順序」選出 \(k\) 個的選法,總數是 \({}_{n}\mathrm{C}_{k}\)。在二項分布中,它表示「\(n\) 次中在哪幾次成功」的選法數。 |
| 累積機率 | 把「恰好 \(k\) 次」的機率加到某個次數為止的機率。「\(k\) 次以下的機率」\(P(X \le k)\) 就是代表。 |
| 餘事件 | 某件事「不發生」的那一方的事件。機率的總和一定是 1,所以像「\(k\) 次以上」這樣的機率,用 1 減去相反那一側(\(k-1\) 次以下)的機率就能輕鬆求出。 |
| 期望值 | 把該試驗做很多次時的平均值。在二項分布中就是「平均發生幾次」,公式很簡單,就是 \(np\)。 |
| 變異數 | 表示實際的值離期望值有多容易偏離(分散程度)的量。定義為偏離量平方的平均。 |
| 標準差 | 變異數的平方根。變異數的單位會變成「平方」,所以開根號、讓單位回到原本的(這個頁面是次數),作為分散程度的參考。 |
| 常態分布 | 平均數附近最容易發生、離平均越遠越不容易發生,左右對稱的鐘形分布。身高、測量誤差等生活中許多量都接近這個形狀,二項分布在 \(n\) 很大時也會接近常態分布。 |
| 常態近似 | \(n\) 很大時,把二項分布換成常態分布 \(N(np,\ np(1-p))\) 來計算。\(np \ge 5\) 且 \(n(1-p) \ge 5\) 是代表性的判斷標準。 |
建議先了解的基礎知識
為了讓您「真正理解意義」地使用這個頁面的計算,這裡整理了建議事先理解的基礎知識。
遇到卡關時,回頭複習這張表的內容是最快的捷徑。
| 機率的基礎(國中九年級,14~15 歲) |
|
| 分數的計算(國小五年級~國中七年級,10~13 歲) |
|
| 次方與指數(國中七年級~高一,12~16 歲) |
|
| 排列與組合(高一,15~16 歲) |
|
| 獨立重複試驗的機率與餘事件(高中,15~17 歲) |
|
| 隨機變數與期望值、變異數(高中選修數學,17~18 歲) |
|
| 常態分布(高中選修數學,17~18 歲) |
|
用 Excel 計算的方法
| 試驗次數 n | 4 |
| 每次成功的機率 p | 0.5 |
| 成功次數 k | 2 |
| 恰好發生 k 次的機率 P(X=k) | =BINOM.DIST(B3,B1,B2,FALSE) |
| 試驗次數 n | 4 |
| 每次成功的機率 p | 0.5 |
| 成功次數 k | 2 |
| k 次以下的機率 P(X≤k) | =BINOM.DIST(B3,B1,B2,TRUE) |
| k 次以上的機率 P(X≥k) | =1-BINOM.DIST(B3-1,B1,B2,TRUE) |
| 試驗次數 n | 30 |
| 每次成功的機率 p | =1/6 |
| 期望值 E(X) = np | =B1*B2 |
| 變異數 Var(X) = np(1-p) | =B1*B2*(1-B2) |
| 標準差 σ | =SQRT(B4) |
| 試驗次數 n | 20 |
| 每次成功的機率 p | 0.5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| 是否符合判斷標準 | =AND(B3>=5,B4>=5) |
BINOM.DIST 是二項分布的函數,引數依序是「成功次數,試驗次數,成功機率,是否累積」。最後一個設為 FALSE 是「恰好的機率」,設為 TRUE 是「該次數以下的累積機率」。
第 1 個表格是丟硬幣 4 次恰好出現 2 次正面的例子,答案是 0.375(= 3/8)。
第 2 個表格的答案都是 0.6875。「k 次以上」是用 1 減去「k−1 次以下」求出的(k 輸入 0 時這個公式會出現錯誤,但 0 次以上的機率一定是 1)。
第 3 個表格是擲骰子 30 次擲出 1 點次數的例子,期望值 5、變異數 4.1667、標準差 2.0412。
第 4 個表格在 np 和 n(1−p) 都在 5 以上時顯示 TRUE(符合常態近似的判斷標準),否則顯示 FALSE。
用 Google 試算表計算的方法
| 試驗次數 n | 4 |
| 每次成功的機率 p | 0.5 |
| 成功次數 k | 2 |
| 恰好發生 k 次的機率 P(X=k) | =BINOMDIST(B3,B1,B2,FALSE) |
| 試驗次數 n | 4 |
| 每次成功的機率 p | 0.5 |
| 成功次數 k | 2 |
| k 次以下的機率 P(X≤k) | =BINOMDIST(B3,B1,B2,TRUE) |
| k 次以上的機率 P(X≥k) | =1-BINOMDIST(B3-1,B1,B2,TRUE) |
| 試驗次數 n | 30 |
| 每次成功的機率 p | =1/6 |
| 期望值 E(X) = np | =B1*B2 |
| 變異數 Var(X) = np(1-p) | =B1*B2*(1-B2) |
| 標準差 σ | =SQRT(B4) |
| 試驗次數 n | 20 |
| 每次成功的機率 p | 0.5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| 是否符合判斷標準 | =AND(B3>=5,B4>=5) |
「k 次以上」的公式在 k 輸入 0 時會出現錯誤,這點也和 Excel 相同(0 次以上的機率一定是 1)。
用 Python 計算的方法
from fractions import Fraction
from math import comb, sqrt

trial_count = 4                  # 試驗次數 n
success_prob = Fraction(1, 2)    # 每次成功的機率 p(也可以用 0.3 這樣的小數)
success_count = 2                # 成功次數 k

failure_prob = 1 - success_prob

# 恰好發生 k 次的機率 P(X=k) = nCk × p^k × (1−p)^(n−k)
exact_prob = (comb(trial_count, success_count)
              * success_prob ** success_count
              * failure_prob ** (trial_count - success_count))
print(f"恰好 {success_count} 次的機率:{exact_prob} = {float(exact_prob)}")

# 累積機率(k 次以下、k 次以上)
prob_le = sum(comb(trial_count, i) * success_prob ** i * failure_prob ** (trial_count - i)
              for i in range(success_count + 1))
prob_ge = 1 - prob_le + exact_prob
print(f"{success_count} 次以下的機率:{prob_le} = {float(prob_le)}")
print(f"{success_count} 次以上的機率:{prob_ge} = {float(prob_ge)}")

# 期望值、變異數、標準差
mean = trial_count * success_prob
variance = mean * failure_prob
print(f"期望值:{mean}  變異數:{variance}  標準差:{sqrt(variance)}")
用 LaTeX 等數學式語言的寫法(可直接複製)
P(X = k) = nCk pᵏ (1 − p)ⁿ⁻ᵏ
P(X = k) = \binom{n}{k} p^{k} (1 - p)^{n - k}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>=</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>k</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>k</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>k</mi></mrow>
</msup>
</mrow>
</math>
P(X = k) = C(n,k) p^k (1-p)^(n-k)
PDF[BinomialDistribution[n, p], k]
binomial(n, k)*p^k*(1-p)^(n-k);
binopdf(k, n, p)
P(X=k) = C(n,k) p^k (1-p)^(n-k)
P(X ≤ k) = Σ[i=0→k] nCi pⁱ (1 − p)ⁿ⁻ⁱ
P(X \le k) = \sum_{i=0}^{k} \binom{n}{i} p^{i} (1 - p)^{n - i}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>≤</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>0</mn></mrow>
<mi>k</mi>
</munderover>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>i</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>i</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>i</mi></mrow>
</msup>
</mrow>
</math>
P(X <= k) = sum_(i=0)^k C(n,i) p^i (1-p)^(n-i)
CDF[BinomialDistribution[n, p], k]
add(binomial(n, i)*p^i*(1-p)^(n-i), i = 0..k);
binocdf(k, n, p)
P(X≤k) = Σ_(i=0)^k C(n,i) p^i (1-p)^(n-i)
E(X) = np, Var(X) = np(1 − p), σ = √(np(1 − p))
E(X) = np, \quad \mathrm{Var}(X) = np(1 - p), \quad \sigma = \sqrt{np(1 - p)}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo><mi>n</mi><mi>p</mi>
<mo>,</mo>
<mi>Var</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>,</mo>
<mi>σ</mi><mo>=</mo>
<msqrt><mi>n</mi><mi>p</mi><mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow></msqrt>
</mrow>
</math>
E(X) = np, Var(X) = np(1-p), sigma = sqrt(np(1-p))
{Mean[BinomialDistribution[n, p]], Variance[BinomialDistribution[n, p]], StandardDeviation[BinomialDistribution[n, p]]}
n*p; n*p*(1-p); sqrt(n*p*(1-p));
[m, v] = binostat(n, p); s = sqrt(v);
E(X) = np, Var(X) = np(1-p), σ = √(np(1-p))
B(n, p) ≈ N(np, np(1 − p))
B(n,\ p) \approx N(np,\ np(1 - p))
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>B</mi><mo>(</mo><mi>n</mi><mo>,</mo><mi>p</mi><mo>)</mo>
<mo>≈</mo>
<mi>N</mi><mo>(</mo><mi>n</mi><mi>p</mi><mo>,</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>)</mo>
</mrow>
</math>
B(n, p) ~~ N(np, np(1-p))
NormalDistribution[n p, Sqrt[n p (1 - p)]]
Normal(n*p, sqrt(n*p*(1-p)));
pd = makedist('Normal', 'mu', n*p, 'sigma', sqrt(n*p*(1-p)));
B(n, p) ≈ N(np, np(1-p))
請 ChatGPT 幫忙計算的方法
你是數學(機率、統計)計算的助理。請務必實際執行 Python 程式碼來進行下列計算,並只以執行結果的數值作為回答的依據(請不要用心算或猜測回答)。

抽中獎機率為 1/6 的籤 10 次時,請針對中獎次數的二項分布求出下列各項。
1. 恰好中獎 2 次的機率 P(X=2)(請同時以最簡分數和小數表示)
2. 中獎 2 次以下的機率 P(X≤2),以及 2 次以上的機率 P(X≥2)
3. 期望值 E(X)、變異數 Var(X)、標準差 σ
4. 是否符合常態近似的判斷標準 np ≥ 5 且 n(1−p) ≥ 5

在 Python 中請使用標準函式庫的 fractions 與 math.comb 精確計算,並列出計算時使用的公式與執行結果的數值。
使用方法
-
1輸入數值在輸入欄中輸入要計算的數值
-
2計算按下「計算」按鈕
-
3查看結果計算結果會立即顯示。計算的思路和公式的解說,也都能在同一個頁面查看
DataChef 的特色

不需專業知識,操作直覺又簡單

無須登錄任何個人資料

按下「下載」後自動刪除檔案


無須標註來源出處

亦無須事先取得商用授權
相關功能
重複試驗的機率(連續 n 次、至少 1 次)
計算連續 n 次都發生、至少發生 1 次、一次都沒發生的機率
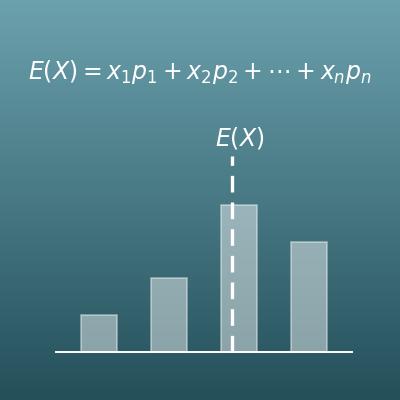
期望值計算機(隨機變數的平均數、變異數、標準差)
由機率分布表計算期望值 E(X)、變異數 Var(X) 與標準差。適用於二項分布以外的一般分布
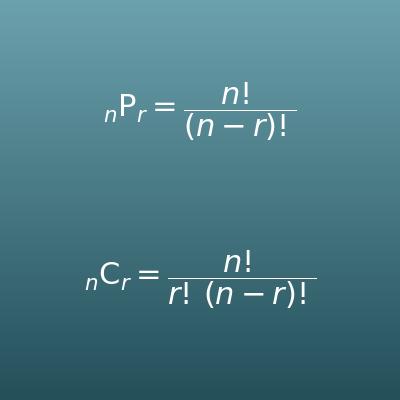
排列組合計算機(排列 nPr、組合 nCr)
可單獨計算二項分布公式中出現的組合數 nCr(nCk),附計算過程