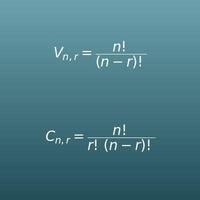
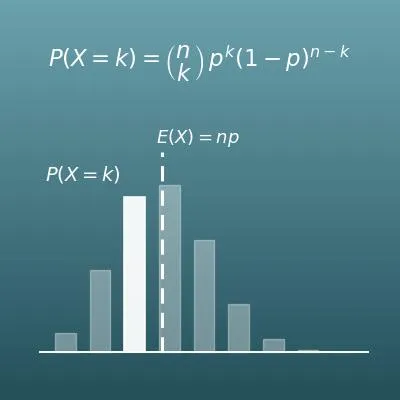
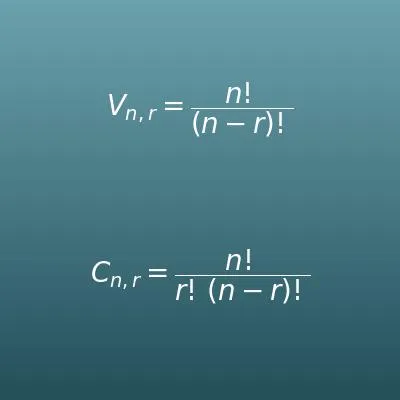
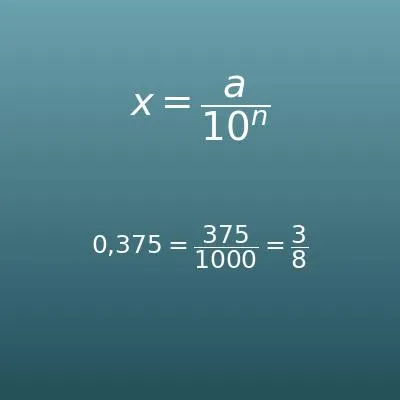

Introduce el número de pruebas n, la probabilidad de éxito en cada prueba p y el número de éxitos k. Obtienes la probabilidad de exactamente k éxitos, las probabilidades acumuladas de k o menos y de k o más, la media, la varianza y la desviación típica, y un diagrama de barras de toda la distribución.
Índice
-
Qué puedes hacer en esta página
-
¿Para qué sirve este cálculo?
-
Cómo usar
-
Fórmulas y gráficas
-
Símbolos y términos
-
Conviene saber antes de empezar
-
Cómo calcularlo en Excel
-
Cómo calcularlo en Hojas de cálculo de Google
-
Cómo calcularlo en Python
-
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
-
Cómo pedirle el cálculo a ChatGPT
-
Las ventajas de DataChef
-
Funciones relacionadas
-
Lista de calculadoras de NumberChef
Qué puedes hacer en esta página
- Introduce solo 3 números y obtienes al momento «la probabilidad de que algo con probabilidad \(p\) ocurra exactamente \(k\) veces en \(n\) intentos», \(P(X = k) = \dbinom{n}{k}\, p^{k} (1-p)^{n-k}\)
- El resultado aparece como fracción irreducible (el valor exacto), por ejemplo \(\dfrac{3}{8}\), y también como decimal y porcentaje. También puedes ver los pasos del número combinatorio \(\dbinom{n}{k}\)
- Calcula a la vez las probabilidades acumuladas «\(k\) veces o menos», \(P(X \le k)\), y «\(k\) veces o más», \(P(X \ge k)\)
- Muestra la media (esperanza) \(E(X) = np\), la varianza \(V(X) = np(1-p)\) y la desviación típica \(\sigma\), y comprueba la regla práctica para usar la aproximación normal
- Dibuja toda la distribución, de 0 a \(n\) éxitos, en un diagrama de barras, así que ves de un vistazo qué números de éxitos son los más probables
¿Para qué sirve este cálculo?
Si abres 100 cajas de botín con un 1 % de probabilidad de objeto raro, el número de objetos raros sigue la distribución binomial \(B(100;\ 0{,}01)\) (suponiendo, como se publica, que cada intento tiene la misma probabilidad y es independiente). La probabilidad de no conseguir nada es \(0{,}99^{100} \approx 36{,}6\,\%\), así que la distribución muestra que la intuición «100 intentos al 1 % es casi seguro» es arriesgada.
Estimar «el valor esperado \(np\) más la dispersión» cuando planeas cuánto gastar es justo el cálculo de esta página.
En lugar de revisar todas las piezas, las fábricas usan el muestreo de aceptación: «se toman \(n\) piezas de un lote, y el lote se acepta si hay \(c\) defectuosas o menos». La probabilidad de aceptar un lote con una tasa de defectos \(p\) es justo la probabilidad acumulada binomial \(P(X \le c)\). Por ejemplo, si tomas 20 piezas de un lote con un 1 % de defectos y solo lo aceptas con 0 defectuosas, la probabilidad de aceptarlo es \(0{,}99^{20} \approx 81{,}8\,\%\).
Este cálculo sirve para diseñar reglas de inspección que acepten los lotes buenos con mucha probabilidad y rechacen los malos.
Si respondes al azar las 20 preguntas de un test con 4 opciones cada una, el número de aciertos sigue la distribución binomial \(B(20;\ 0{,}25)\) y el valor esperado es \(20 \times 0{,}25 = 5\) preguntas. La probabilidad de acertar 8 o más por suerte es solo de un 10 % aproximadamente, lo que confirma con números que contestando al azar rara vez se llega al aprobado.
Quienes preparan exámenes también tienen en cuenta esta distribución al fijar el número de preguntas y la nota de corte, para que sea difícil aprobar por suerte (y por eso muchos tests restan puntos por cada fallo).
Cuando un jugador con un 70 % de acierto en tiros libres lanza 10 tiros, la probabilidad de meter exactamente 7 es solo \(\dbinom{10}{7} \times 0{,}7^{7} \times 0{,}3^{3} \approx 26{,}7\,\%\) (tratando cada tiro como independiente con un porcentaje de acierto fijo). Que un tirador del 70 % meta exactamente 7 de 10 no es tan normal como parece; meter 6 u 8 pasa continuamente.
La distribución binomial te ayuda a distinguir qué parte de una «racha» o de un «bache» es simple variación aleatoria.
En las encuestas de intención de voto y en las mediciones de audiencia de televisión, se considera que el número de personas, de las \(n\) encuestadas, que dan una respuesta concreta sigue una distribución binomial. El margen de error de «más o menos unos puntos» se calcula con la desviación típica \(\sqrt{np(1-p)}\) y la aproximación por la normal.
Decidir a cuántas personas hay que encuestar para bajar el margen de error al tamaño deseado se basa directamente en las propiedades de la distribución binomial.
Fórmulas y gráficas
Símbolos y términos
Símbolos
| \(X\) | X | La variable aleatoria que cuenta el número de éxitos. Por costumbre, los números que dependen del azar se escriben con mayúsculas del final del alfabeto, como \(X\), \(Y\) o \(Z\). |
| \(P(X = k)\) | P de X igual a k | La probabilidad de que el número de éxitos \(X\) sea exactamente \(k\). La \(P\) es la inicial de «probabilidad». |
| \(\dbinom{n}{k}\) | n sobre k | El número combinatorio: el número de combinaciones de \(k\) elementos elegidos entre \(n\). También se escribe \(C_{n,k}\) o \({}_{n}\mathrm{C}_{k}\), como en las calculadoras (nCr). |
| \(n\) | ene | El número de pruebas (cuántas veces se repite). Para contar se suele usar la letra \(n\), de «número». |
| \(p\) | pe | La probabilidad de éxito en una prueba. Viene de «probabilidad», y la minúscula se suele usar para la probabilidad de un solo intento. |
| \(1 - p\) | uno menos pe | La probabilidad de fracaso en una prueba (no tener éxito). Siempre ocurre o el éxito o el fracaso, así que es lo que queda al restar \(p\) del total \(1\). También se escribe \(q\). |
| \(k\) | ka | El número de éxitos, un número entero entre \(0\) y \(n\). La letra \(k\) se usa mucho para indicar «cuántas veces». |
| \(P(X \le k)\) | P de X menor o igual que k | La probabilidad de \(k\) éxitos o menos (cualquiera de 0 a \(k\)). Es una probabilidad acumulada: las probabilidades exactas sumadas hasta \(k\). |
| \(P(X \ge k)\) | P de X mayor o igual que k | La probabilidad de \(k\) éxitos o más (cualquiera de \(k\) a \(n\)). Restando \(P(X \le k-1)\) del total \(1\) (el suceso contrario) la suma se acorta. |
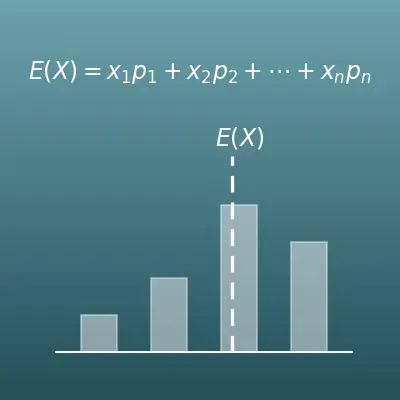
| \(E(X)\) | E de X | El valor esperado o esperanza (el número medio de éxitos). La \(E\) es la inicial de «esperanza». En la distribución binomial, \(E(X) = np\). También se llama media y se escribe \(\mu\). |
| \(V(X)\) | V de X | La varianza (cuánto se dispersan los resultados). La \(V\) es la inicial de «varianza». En la distribución binomial, \(V(X) = np(1-p)\). También se escribe \(\mathrm{Var}(X)\) o \(\sigma^2\). |
| \(\sigma\) | sigma | La desviación típica. Es la sigma minúscula griega, la «s» griega. Es la raíz cuadrada de la varianza, \(\sigma = \sqrt{V(X)}\), e indica la distancia típica al valor esperado. |
| \(B(n,\ p)\) | B de n y p | La distribución binomial con \(n\) pruebas y probabilidad de éxito \(p\). La \(B\) es la inicial de «binomial». «\(X\) sigue una distribución binomial» se escribe \(X \sim B(n,\ p)\). |
| \(N(\mu,\ \sigma^2)\) | N de mu y sigma al cuadrado | La distribución normal de media \(\mu\) y varianza \(\sigma^2\). La \(N\) es la inicial de «normal». En esta página el orden dentro del paréntesis es «media, varianza»; muchos libros de Bachillerato escriben \(N(\mu,\ \sigma)\), con la desviación típica. |
| \(\approx\) | aproximadamente igual a | El símbolo de «aproximadamente igual». En esta página indica que la distribución binomial se puede sustituir aproximadamente por la distribución normal. |
Términos
| distribución binomial | La distribución de probabilidad de «cuántas veces ocurre en \(n\) intentos algo con probabilidad \(p\)». El nombre viene de que el \(\dbinom{n}{k}\) de la fórmula es el mismo coeficiente que aparece en el binomio de Newton. En España se estudia en 2.º de Bachillerato (17-18 años). |
| variable aleatoria | Variable cuyo valor depende del azar. En esta página, la variable aleatoria es el número de éxitos, que toma los valores de 0 a n, cada uno con su probabilidad. |
| prueba | Cada repetición de un experimento u observación cuyo resultado decide el azar, como lanzar una moneda una vez o sacar una papeleta. |
| pruebas repetidas | Repetir la misma prueba con la misma probabilidad cada vez, sin que los resultados se influyan entre sí (de forma independiente). También se llaman pruebas de Bernoulli. La distribución binomial es la distribución del número de éxitos en pruebas repetidas. |
| sucesos independientes | Cuando el resultado de una prueba no influye en el de otra. La primera y la segunda tirada de un dado son independientes, pero sacar papeletas sin devolverlas no lo es (los resultados anteriores cambian cuántas papeletas premiadas quedan). |
| combinación | Forma de elegir \(k\) de \(n\) elementos sin que importe el orden. El número total de combinaciones es el número combinatorio \(\dbinom{n}{k}\). En la distribución binomial cuenta las formas de elegir cuáles de las \(n\) pruebas son éxitos. |
| probabilidad acumulada | Las probabilidades exactas sumadas hasta un cierto número. El ejemplo típico es la probabilidad de \(k\) o menos, \(P(X \le k)\). Vista como función de \(k\), es la función de distribución. |
| suceso contrario | El suceso de que algo no ocurra. Las probabilidades siempre suman 1, así que una probabilidad como «\(k\) o más» se calcula fácilmente restando de 1 la del lado contrario (\(k-1\) o menos). |
| valor esperado | El valor medio cuando repites las pruebas muchas veces, también llamado esperanza o media. En la distribución binomial es el número medio de éxitos, con la sencilla fórmula \(np\). |
| varianza | Medida de cuánto suelen alejarse los valores reales del valor esperado (la dispersión). Se define como la media de las diferencias al cuadrado. |
| desviación típica | La raíz cuadrada de la varianza. La varianza está en unidades al cuadrado, así que al hacer la raíz se vuelve a la unidad original (aquí, el número de éxitos) como medida de la dispersión. También se llama desviación estándar. |
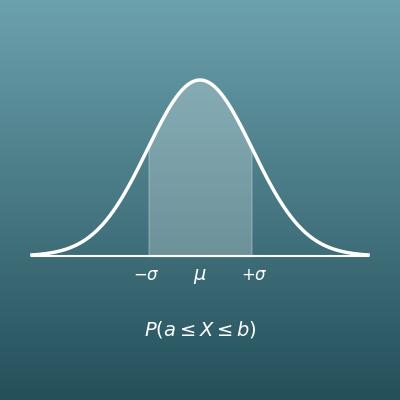
| distribución normal | Distribución simétrica en forma de campana en la que los valores cercanos a la media son los más probables y los más alejados, menos. Muchas magnitudes reales, como la estatura o los errores de medida, se acercan a esta forma, y la distribución binomial también se acerca a ella cuando \(n\) es grande. |
| aproximación normal | Sustituir la distribución binomial por la distribución normal \(N(np,\ np(1-p))\) cuando \(n\) es grande. La regla práctica habitual es \(np \ge 5\) y \(n(1-p) \ge 5\). |
Conviene saber antes de empezar
Esto es lo que te ayuda a usar el cálculo de esta página entendiendo lo que haces, y no solo pulsando el botón.
Si te atascas, repasar los temas de esta tabla es la forma más rápida de avanzar.
| Probabilidad básica (2.º-3.º de ESO, 13-15 años) |
|
| Cálculo con fracciones (5.º de Primaria a 1.º de ESO, 10-13 años) |
|
| Potencias y exponentes (1.º-3.º de ESO, 12-15 años) |
|
| Combinatoria y combinaciones (4.º de ESO y 1.º de Bachillerato, 15-17 años) |
|
| Probabilidad de pruebas repetidas y suceso contrario (4.º de ESO y 1.º de Bachillerato, 15-17 años) |
|
| Variables aleatorias, valor esperado y varianza (2.º de Bachillerato, 17-18 años) |
|
| La distribución normal (2.º de Bachillerato, 17-18 años) |
|
Cómo calcularlo en Excel
| Número de pruebas n | 4 |
| Probabilidad de éxito p | 0,5 |
| Número de éxitos k | 2 |
| Probabilidad de exactamente k P(X=k) | =DISTR.BINOM.N(B3;B1;B2;FALSO) |
| Número de pruebas n | 4 |
| Probabilidad de éxito p | 0,5 |
| Número de éxitos k | 2 |
| Probabilidad de k o menos P(X≤k) | =DISTR.BINOM.N(B3;B1;B2;VERDADERO) |
| Probabilidad de k o más P(X≥k) | =1-DISTR.BINOM.N(B3-1;B1;B2;VERDADERO) |
| Número de pruebas n | 30 |
| Probabilidad de éxito p | =1/6 |
| Media E(X) = np | =B1*B2 |
| Varianza V(X) = np(1-p) | =B1*B2*(1-B2) |
| Desviación típica σ | =RAIZ(B4) |
| Número de pruebas n | 20 |
| Probabilidad de éxito p | 0,5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| ¿Cumple la regla práctica? | =Y(B3>=5;B4>=5) |
DISTR.BINOM.N es la función de la distribución binomial. Sus argumentos son, por orden, «número de éxitos; número de pruebas; probabilidad de éxito; acumulado o no». FALSO al final da la probabilidad exacta, y VERDADERO da la probabilidad acumulada de ese número o menos.
La primera tabla es el ejemplo de exactamente 2 caras en 4 lanzamientos de una moneda, y el resultado es 0,375 (= 3/8).
Los dos resultados de la segunda tabla son 0,6875. «k o más» se calcula restando de 1 «k−1 o menos» (esta fórmula da error si k es 0, pero la probabilidad de 0 o más siempre es 1).
La tercera tabla es el número de unos en 30 tiradas de un dado: media 5, varianza 4,1667 y desviación típica 2,0412.
La cuarta tabla muestra VERDADERO cuando np y n(1−p) son los dos 5 o más (se cumple la regla práctica de la aproximación por la normal), y FALSO si no.
Cómo calcularlo en Hojas de cálculo de Google
| Número de pruebas n | 4 |
| Probabilidad de éxito p | 0,5 |
| Número de éxitos k | 2 |
| Probabilidad de exactamente k P(X=k) | =DISTR.BINOM(B3;B1;B2;FALSO) |
| Número de pruebas n | 4 |
| Probabilidad de éxito p | 0,5 |
| Número de éxitos k | 2 |
| Probabilidad de k o menos P(X≤k) | =DISTR.BINOM(B3;B1;B2;VERDADERO) |
| Probabilidad de k o más P(X≥k) | =1-DISTR.BINOM(B3-1;B1;B2;VERDADERO) |
| Número de pruebas n | 30 |
| Probabilidad de éxito p | =1/6 |
| Media E(X) = np | =B1*B2 |
| Varianza V(X) = np(1-p) | =B1*B2*(1-B2) |
| Desviación típica σ | =RAIZ(B4) |
| Número de pruebas n | 20 |
| Probabilidad de éxito p | 0,5 |
| np | =B1*B2 |
| n(1-p) | =B1*(1-B2) |
| ¿Cumple la regla práctica? | =Y(B3>=5;B4>=5) |
Igual que en Excel, la fórmula de «k o más» da error si k es 0 (la probabilidad de 0 o más siempre es 1).
Cómo calcularlo en Python
from fractions import Fraction
from math import comb, sqrt

trial_count = 4                  # número de pruebas n
success_prob = Fraction(1, 2)    # probabilidad de éxito p (también vale un decimal como 0.3)
success_count = 2                # número de éxitos k

failure_prob = 1 - success_prob

# probabilidad de exactamente k éxitos P(X=k) = C(n,k) × p^k × (1−p)^(n−k)
exact_prob = (comb(trial_count, success_count)
              * success_prob ** success_count
              * failure_prob ** (trial_count - success_count))
print(f"Probabilidad de exactamente {success_count}: {exact_prob} = {float(exact_prob)}")

# probabilidades acumuladas (k o menos, k o más)
prob_le = sum(comb(trial_count, i) * success_prob ** i * failure_prob ** (trial_count - i)
              for i in range(success_count + 1))
prob_ge = 1 - prob_le + exact_prob
print(f"Probabilidad de {success_count} o menos: {prob_le} = {float(prob_le)}")
print(f"Probabilidad de {success_count} o más: {prob_ge} = {float(prob_ge)}")

# media, varianza y desviación típica
mean = trial_count * success_prob
variance = mean * failure_prob
print(f"Media: {mean}  Varianza: {variance}  Desviación típica: {sqrt(variance)}")
Cómo escribirla en LaTeX y otros lenguajes de fórmulas (para copiar y pegar)
P(X = k) = C(n,k) pᵏ (1 − p)ⁿ⁻ᵏ
P(X = k) = \binom{n}{k} p^{k} (1 - p)^{n - k}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>=</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>k</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>k</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>k</mi></mrow>
</msup>
</mrow>
</math>
P(X = k) = C(n,k) p^k (1-p)^(n-k)
PDF[BinomialDistribution[n, p], k]
binomial(n, k)*p^k*(1-p)^(n-k);
binopdf(k, n, p)
P(X=k) = C(n,k) p^k (1-p)^(n-k)
P(X ≤ k) = Σ[i=0→k] C(n,i) pⁱ (1 − p)ⁿ⁻ⁱ
P(X \le k) = \sum_{i=0}^{k} \binom{n}{i} p^{i} (1 - p)^{n - i}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>P</mi><mo>(</mo><mi>X</mi><mo>≤</mo><mi>k</mi><mo>)</mo>
<mo>=</mo>
<munderover>
<mo>∑</mo>
<mrow><mi>i</mi><mo>=</mo><mn>0</mn></mrow>
<mi>k</mi>
</munderover>
<mrow>
<mo>(</mo>
<mfrac linethickness="0"><mi>n</mi><mi>i</mi></mfrac>
<mo>)</mo>
</mrow>
<msup><mi>p</mi><mi>i</mi></msup>
<msup>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mrow><mi>n</mi><mo>−</mo><mi>i</mi></mrow>
</msup>
</mrow>
</math>
P(X <= k) = sum_(i=0)^k C(n,i) p^i (1-p)^(n-i)
CDF[BinomialDistribution[n, p], k]
add(binomial(n, i)*p^i*(1-p)^(n-i), i = 0..k);
binocdf(k, n, p)
P(X≤k) = Σ_(i=0)^k C(n,i) p^i (1-p)^(n-i)
E(X) = np, V(X) = np(1 − p), σ = √(np(1 − p))
E(X) = np, \quad V(X) = np(1 - p), \quad \sigma = \sqrt{np(1 - p)}
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>E</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo><mi>n</mi><mi>p</mi>
<mo>,</mo>
<mi>V</mi><mo>(</mo><mi>X</mi><mo>)</mo><mo>=</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>,</mo>
<mi>σ</mi><mo>=</mo>
<msqrt><mi>n</mi><mi>p</mi><mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow></msqrt>
</mrow>
</math>
E(X) = np, V(X) = np(1-p), sigma = sqrt(np(1-p))
{Mean[BinomialDistribution[n, p]], Variance[BinomialDistribution[n, p]], StandardDeviation[BinomialDistribution[n, p]]}
n*p; n*p*(1-p); sqrt(n*p*(1-p));
[m, v] = binostat(n, p); s = sqrt(v);
E(X) = np, V(X) = np(1-p), σ = √(np(1-p))
B(n, p) ≈ N(np, np(1 − p))
B(n,\ p) \approx N(np,\ np(1 - p))
<math xmlns="http://www.w3.org/1998/Math/MathML" display="block">
<mrow>
<mi>B</mi><mo>(</mo><mi>n</mi><mo>,</mo><mi>p</mi><mo>)</mo>
<mo>≈</mo>
<mi>N</mi><mo>(</mo><mi>n</mi><mi>p</mi><mo>,</mo>
<mi>n</mi><mi>p</mi>
<mrow><mo>(</mo><mn>1</mn><mo>−</mo><mi>p</mi><mo>)</mo></mrow>
<mo>)</mo>
</mrow>
</math>
B(n, p) ~~ N(np, np(1-p))
NormalDistribution[n p, Sqrt[n p (1 - p)]]
Normal(n*p, sqrt(n*p*(1-p)));
pd = makedist('Normal', 'mu', n*p, 'sigma', sqrt(n*p*(1-p)));
B(n, p) ≈ N(np, np(1-p))
Cómo pedirle el cálculo a ChatGPT
Eres un asistente de cálculo de matemáticas (probabilidad y estadística). Haz el siguiente cálculo ejecutando de verdad código de Python y basa tu respuesta solo en los números del resultado de la ejecución (no respondas calculando de cabeza ni a ojo).

Participas 10 veces en un sorteo y en cada participación la probabilidad de ganar es 1/6. Para la distribución binomial del número de premios, calcula:
1. La probabilidad de ganar exactamente 2 veces, P(X=2) (como fracción irreducible y como decimal)
2. La probabilidad de ganar 2 veces o menos, P(X≤2), y 2 veces o más, P(X≥2)
3. La media E(X), la varianza V(X) y la desviación típica σ
4. Si se cumple la regla práctica de la aproximación por la normal, np ≥ 5 y n(1−p) ≥ 5

En Python, calcula de forma exacta con fractions y math.comb de la biblioteca estándar, y muestra las fórmulas que has usado y los números del resultado de la ejecución.
Cómo usar
-
1Introduce los datosEscribe en las casillas los números con los que quieres calcular
-
2CalculaPulsa el botón «Calcular»
-
3Consulta el resultadoEl resultado aparece al instante. En la misma página tienes también la idea del cálculo y la explicación de la fórmula
Las ventajas de DataChef

Sin conocimientos técnicos: fácil e intuitivo
Sin necesidad de dar datos personales
Los archivos se borran automáticamente tras la descarga
Sin necesidad de atribución
Sin necesidad de pedir permiso
Funciones relacionadas
Probabilidad de experimentos repetidos (n veces seguidas, al menos una vez)
Calcula la probabilidad de que algo ocurra n veces seguidas, al menos una vez o nunca
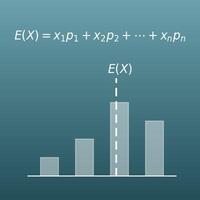
Calculadora de valor esperado (esperanza, varianza y desviación típica)
Calcula el valor esperado E(X), la varianza y la desviación típica a partir de una tabla de distribución de probabilidad. Sirve para cualquier distribución, no solo la binomial
Calculadora de combinaciones y variaciones (nCr, nPr)
Calcula por separado, paso a paso, el número combinatorio que aparece en la fórmula de la binomial